

Vývojáři OrioleDB analyzovali aktuální stav nízkoúrovňového API používaného pro přístup rozšíření k tabulkám a indexům v PostgreSQL (Table/Index Access Method (AM) API) a navrhli možnosti jeho vylepšení. Od doby, kdy bylo takové API zavedeno v PostgreSQL 12, mohli vývojáři vytvářet alternativní datové úložiště. Nicméně, navzdory existenci tohoto API a známým omezením zabudovaného úložiště, stále neexistují plně funkční transakční úložiště realizovaná výhradně formou rozšíření.
Nejžádanějšími funkcemi pro alternativní tabulkové enginy PostgreSQL jsou:
- Alternativní implementace MVCC, například úložiště založené na protokolu UNDO.
- Indexově organizované tabulky, kde index není volitelným doplňkem k tabulce, který zrychluje dotazy, ale představuje hlavní datovou strukturu, ve které jsou uložena data tabulky.
Změny nezbytné v API Table/Index AM pro podporu alternativních implementací MVCC jsou zvažovány s ohledem na rozšíření OrioleDB, které bylo vyvinuto k odstranění známých nedostatků zabudovaného úložiště PostgreSQL. Problém spočívá v tom, že pro plnou integraci OrioleDB s PostgreSQL jsou vyžadovány změny v kódu PostgreSQL, což komplikuje zavedení projektu a zdůrazňuje potřebu modernizace stávajícího API Table AM.
API Table AM nenutí přímo způsob implementace MVCC. Nicméně, API Table AM a API Index AM předpokládají následující: každý TID (Tuple/row Identifier) je buď indexován všemi indexy, nebo není indexován vůbec. I když Index AM má několik odkazů na jeden TID (například GIN), všechny tyto odkazy musí odpovídat jedné a té samé indexované hodnotě.
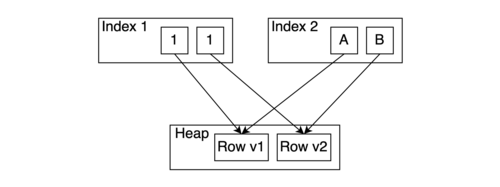
Tento princip byl kritizován za zvyšování počtu zápisových operací („write amplification“) — pokud se aktualizuje jeden indexovaný atribut, je nutné aktualizovat každý index v tabulce. Při potřebě plně využít výhod protokolu UNDO nebo vybudovat jinou metodu úložiště bez „zvýšení zápisu“ (například metoda WARM), je nutné porušit toto předpokládání.
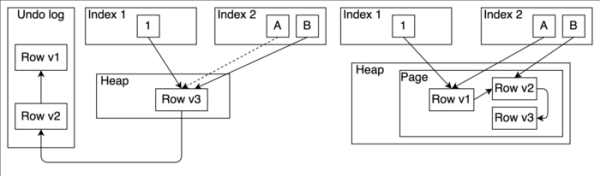
Tabulka AM založená na UNDO, která toto předpokládání nenaruší, připomíná existující metodu HOT (Heap-Only Tuples), s výjimkou toho, že staré verze řetězců jsou uchovávány v žurnálu UNDO a nemusí se vejdou na stejnou stránku. Podle autorů však tento přínos není dostatečný pro ospravedlnění existence samostatné Tabulky AM.
Praktická omezení existujícího API:
- Během aktualizace řetězce tabulky se indexy aktualizují na principu „vše nebo nic“.
- Nedostatek v API Index AM možnosti bodového odstranění určitých k-tupletů. V současné době je možné odstraňovat k-tuplety z indexů hromadně pomocí metod ambulkdelete a amvacuumcleanup. Pokus o realizaci bodového odstranění prostřednictvím tohoto API by vedl k nízké účinnosti, protože většina současných implementací musí prohledávat celý index. Kromě toho API neumožňuje určit, které z k-tupletů odkazujících na stejné TID by měly být odstraněny. Může odstranit pouze všechny.
- Indexy v současné době odkazují na řetězce tabulky podle čísla bloku (32 bitů) a čísla posunu (16 bitů). A pouze 11 bitů čísla posunu lze bezpečně předat z TID tabulky do všech metod přístupu k indexu. Alternativním implementacím MVCC může být potřeba uchovávat dodatečnou zátěž (payload) spolu s TID. Například v OrioleDB je potřeba jeden nebo více bitů pro realizaci indexů „delete-marking“ nebo kompletní informace o viditelnosti.
Byly navrženy dva způsoby, jak překonat omezení v praxi:
Přístup 1: API Index AM nabízí možnosti pro alternativní implementaci MVCC.
Zatímco Tabulka AM nadále odpovídá za všechny komponenty MVCC, Index AM poskytuje nezbytné možnosti pro alternativní implementaci MVCC, a to: uchovávání uživatelské zátěže (payload) spolu s TID, metoda bodového odstranění a dokonce metoda bodové aktualizace (pokud TID v indexu nelze změnit, uživatelská zátěž může). Kromě toho, jak je nutné povolit několika k-tupletům indexu odkazovat na stejné TID, metody API používané při prohledávání indexu rovněž potřebují aktualizaci.
Přístup 2: Indexy podporující MVCC.
Alternativou by bylo umožnit indexy, které podporují MVCC. To znamená, že „executor“ (nebo možná Table AM) jednoduše volá metody insert() a delete() v Index AM, zatímco Index AM poskytuje možnost skenování s ohledem na MVCC. To by výrazně zjednodušilo skenování pomocí pouze indexů (index-only). Dokonce by mohl být celý Table AM v takovém případě mezivrstvou, která uchovává data v indexu.
Na níže uvedeném diagramu je příklad. Hodnota indexu 2 je aktualizována transakcí 11 z hodnoty „A“ na hodnotu „B“. Proto je hodnota „A“ označena jako xmax == 11 a hodnota „B“ jako xmin == 11. Takto lze skenovat index 2 a získávat pouze viditelné k-tice podle MVCC bez kontrol hromady (heap). Údržba indexu 2 také může být provedena bez použití hromady.
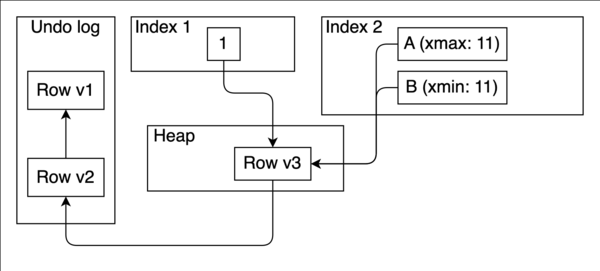
Při zavedení všech vyjmenovaných novinek do API indexových metod přístupu je nepravděpodobné, že by se podařilo současně přepracovat všechny indexy tak, aby podporovaly všechny nové možnosti. Realističtější je povolit několik implementací pro jednu indexovou metodu přístupu. Například kromě běžného B-stromu by rozšíření mohlo implementovat alternativní B-strom s podporou MVCC uvnitř indexu a s podporou identifikátorů záznamů libovolné délky.
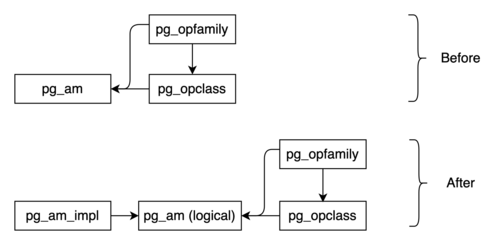
Navrhuje se přehodnotit nejen API Table AM, ale také API Index AM, které po mnoho let spolehlivě sloužilo komunitě PostgreSQL. Kromě toho se navrhuje rozdělit Index AM na logickou vrstvu a vrstvu implementace. Tato přepracovaná architektura umožní PostgreSQL podporovat různé modely ukládání.
Zdroj: opennet.ru
