

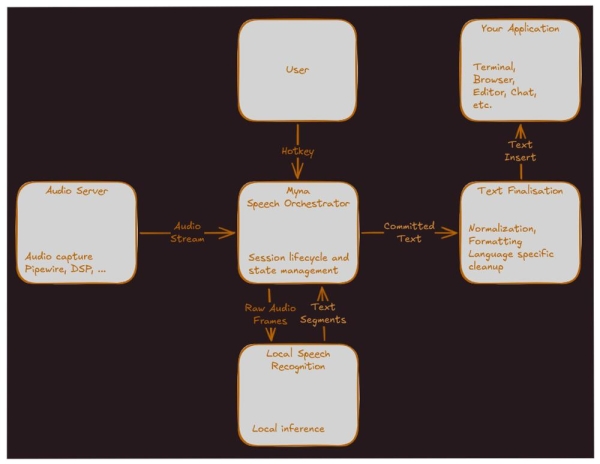
Canonical představila projekt Myna — nový systém převodu řeči na text pro Ubuntu Desktop. Projekt je zaměřen na vestavěné diktování: uživatel stiskne klávesovou zkratku, mluví a rozpoznaný text se objeví v aktivní aplikaci. V oznámení se zdůrazňuje, že Myna by měla působit jako přirozená součást pracovního prostoru Ubuntu a zároveň pracovat s ohledem na soukromí uživatele. Seznam podporovaných jazyků vstupu v době vydání zprávy nebyl zveřejněn.
Prvním cílem projektu je Ubuntu 26.10. V této fázi se Canonical nesnaží vytvořit plnohodnotného hlasového asistenta nebo systém řízení pracovního prostoru hlasem. Vývojáři úmyslně omezuji oblasti první verze na základní a spolehlivé diktování: stisknout klávesovou kombinaci, říct text a získat výsledek v aktuálním poli pro vstup. Primární zkušební prostředí — Ubuntu Desktop na Wayland s GNOME, ale architektura se plánuje ponechat dostatečně otevřenou pro budoucí podporu dalších prostředí.
Myna je navržena pro místní rozpoznávání řeči. Po instalaci potřebných modelů není internetové připojení pro fungování diktování nutné, mikrofon se musí používat pouze po výslovné aktivaci uživatelem, audio se zpracovává v paměti a poté se vyhazuje, a záznamy nejsou odesílány na externí služby. V projektové specifikaci je také uvedeno, že řešení by mělo z defaultu vyhnout uchovávání audia a nemělo by se bez povšimnutí přepínat na cloudovou službu.
Kód a dokumentace Myna byly zveřejněny v repozitáři Canonical na GitHub. Projekt je popsán jako lehká aplikace pro převod řeči na text pro Ubuntu Desktop a je distribuován pod licencí GPL-3.0. Přitom projekt je ve fázi raného vývoje: v repozitáři zatím nejsou žádné zveřejněné verze a architektonická specifikace má status navrhovaná.
Hlavní funkce a vlastnosti Myna
Diktování pomocí zavolání. Uživatel drží nastavitelné klávesové zkratky, mluví a systém vkládá rozpoznaný text do vybraného vstupního pole. Diktování končí po uvolnění klávesy.
Místní rozpoznávání řeči. Rozpoznávání se provádí na uživatelském zařízení prostřednictvím místního inference stacku. To snižuje závislost na cloudu a umožňuje fungovat bez sítě po instalaci modelů.
Soukromé zpracování audia. Mikrofon se aktivuje pouze během uživatelské seance diktování. Audio by se ve výchozím nastavení nemělo ukládat na disk, používá se omezený vyrovnávací paměť v paměti, která se po dokončení seance vymaže.
Vizualizátor aktivity. Během nahrávání a transkripce by měl uživatel vidět jasný indikátor stavu. Ve specifikaci se zmiňují stavy jako Nahrávání, Transkribování, Finalizace a Chyba.
Vkládání pouze stabilního textu. V prvním provedení by se meziprocesové hypotézy rozpoznávání neměly vkládat přímo do aplikace. Do cílového pole se odesílá pouze potvrzený konečný text.
Postprocessing textu. Syrová transkripce může projít normalizací, umístěním interpunkce, kapitalizací, formátováním a převodem mluvených forem na psané, například "twenty two" → "22".
Výběr jazyka diktování. Systém by měl podporovat konfigurovatelný jazyk diktování, přičemž ve výchozím nastavení vychází z jazyka uživatelského rozhraní, pokud je k dispozici vhodný model.
Profily kvality modelu. Specifikace obsahuje různé profily modelů: lehkou variantu s menšími nároky na zdroje, vyvážený profil jako výchozí a kvalitnější, ale náročnější variantu.
Bezpečná práce s fokusováním na vstup. Cíl pro vkládání textu je zvolen na začátku seance. Pokud se během diktování změní fokus okna, systém by neměl tiše odesílat text do jiné aplikace.
Zablokování v chráněných polích. Diktování by mělo být blokováno v heslových polích, autentizačních oknech a dalších chráněných místech, pokud to aplikace nebo toolkit umožňuje zjistit.
Integrace s Wayland/GNOME. První verze je zaměřena na Wayland a GNOME. Pro počáteční vkládání textu se zvažuje IBus, a v budoucnu se plánuje více nativní cesta Waylandu prostřednictvím protokolů input-method/text-input.
Nastavení uživatele. V plánovaném rozhraní nastavení by mělo být zahrnuto zapnutí/vypnutí STT, výběr klávesové zkratky, jazyk diktování, mikrofon, profil modelu, parametry postprocessing a indikátor aktivity.
V první iteraci mimo projekt zůstává probouzení na klíčovou frázi, neustálé pozadí poslechu, cloudové rozpoznávání, hlasový asistent, hlasové příkazy, správa pracovního stolu, převod řeči, rozpoznání mluvčího, automatické určení jazyka a historie diktování. Jinými slovy, Canonical nezačíná s „AI-asistentem“, ale s více praktickou funkcí: místní převod hlasového vstupu do textu v běžných aplikacích Ubuntu.
Zdroj: linux.org.ru
