

Kód softwarových produktů pro strojové učení bývá často složitý a poměrně matoucí. Odhalování a odstraňování chyb v něm je náročný úkol. I nejjednodušší vyžadují vážný přístup k síťové architektuře, inicializaci vah a optimalizaci sítě. Malá chyba může vést k nepříjemným problémům.
Tento článek je věnován algoritmu ladění vašich neuronových sítí.
Skillbox doporučuje: Praktický kurz .
Připomínáme: pro všechny čtenáře "Habra" – sleva 10 000 korun při registraci na jakýkoli kurz Skillbox s promokódem "Habr".
Algoritmus se skládá z pěti etap:
- jednoduchý start;
- ověření ztrát;
- kontrola mezivýsledků a spojení;
- diagnostika parametrů;
- kontrola funkce.
Pokud vám něco připadá zajímavější než ostatní, můžete okamžitě přejít k těmto částem.
Jednoduchý start
Ladění neuronové sítě se složitou architekturou, regularizací a plánovačem tempa učení je náročnější než běžné. Trochu zde podvádíme, protože tento bod má nepřímou souvislost s laděním, ale je to stále důležitá doporučení.
Jednoduchý start spočívá ve vytvoření zjednodušeného modelu a jeho natrénování na jediné sadě (bodu) dat.
Nejprve vytvoříme zjednodušený model
Pro rychlý start vytvoříme malou síť s jedinou skrytou vrstvou a zkontrolujeme, že vše funguje správně. Poté postupně komplikuje model, přičemž otestujeme každý nový aspekt jeho struktury (další vrstvy, parametry atd.) a pokračujeme dál.
Natrénujeme model na jedné sadě (bodu) dat
Jako rychlé ověření funkčnosti vašeho projektu můžete použít k natrénování jeden nebo dva body dat, abyste potvrdili, že systém funguje správně. Neuronová síť by měla zajistit 100% přesnost při učení a testování. Pokud tomu tak není, je model příliš malý nebo máte už chybu.
I když je všechno v pořádku, připravte model na průchod jednou nebo více epochami, než půjdete dál.
Hodnocení ztrát
Hodnocení ztrát je hlavní způsob, jak upřesnit výkonnost modelu. Musíte se ujistit, že ztráta odpovídá úkolu, a funkce ztrát se hodnotí správnou stupnicí. Pokud používáte více než jeden typ ztrát, ujistěte se, že všechny jsou stejného řádu a správně škálovány.
Je důležité věnovat pozornost počátečním ztrátám. Zkontrolujte, jak blízko skutečný výsledek odpovídá očekávanému, pokud model začal s náhodným předpokladem. V : „Ujistěte se, že dosahujete výsledku, který očekáváte při začátku práce s malým počtem parametrů. Je lepší zkontrolovat ztrátu dat hned od začátku (nastavením stupně regularizace na nulu). Například pro CIFAR-10 s klasifikátorem Softmax očekáváme, že počáteční ztráty budou 2.302, protože očekávaná difuzní pravděpodobnost je 0,1 pro každou třídu (protože existuje 10 tříd), a ztráta Softmax je záporným logaritmickým pravděpodobnostním korektního třídy jako –ln (0.1) = 2.302“.
Pro binární příklad se provede obdobný výpočet pro každou z tříd. Například máme data: 20% 0’s a 80% 1’s. Očekávaná počáteční ztráta bude až –0,2ln (0,5) –0,8ln (0,5) = 0,693147. Pokud je výsledek větší než 1, může to naznačovat, že váhy neuronové sítě nejsou správně vyvážené nebo že data nejsou normalizována.
Kontrolujeme mezivýsledky a spojení
Pro ladění neuronové sítě je třeba rozumět dynamice procesů uvnitř sítě a roli jednotlivých mezivrstv, protože jsou propojené. Zde jsou typické chyby, na které můžete narazit:
- nesprávné výrazy pro aktualizace gradientu;
- aktualizace váh nejsou aplikována;
- mizící nebo vybuchující gradienty (exploding gradients).
Pokud jsou hodnoty gradientu nulové, znamená to, že rychlost učení v optimalizátoru je příliš nízká, nebo že jste narazili na nesprávný výraz pro aktualizaci gradientu.
Kromě toho je třeba sledovat hodnoty aktivací, vah a aktualizací každé z vrstev. Například velikost aktualizací parametrů (v podílech a posunech) .
Existuje jev, který se nazývá „Dying ReLU“ nebo , kdy neuronové prvky ReLU budou po osvojení velké záporné hodnoty (bias) pro své váhy vracet nulu. Tyto neurony se již nikdy neaktivují v žádném z dat.
Můžete použít kontrolu gradientu k odhalení těchto chyb tím, že přibližujete gradient pomocí numerického přístupu. Pokud je blízko k vypočteným gradientům, pak bylo zpětné šíření implementováno správně. Chcete-li vytvořit kontrolu gradientu, podívejte se na tyto skvělé zdroje z CS231 a , a také na Andrew Nga na toto téma.
uvádí tři hlavní metody vizualizace neuronové sítě:
- Předběžné — jednoduché metody, které nám ukazují celkovou strukturu vytrénovaného modelu. Zahrnují výstup tvarů nebo filtrů jednotlivých vrstev neuronové sítě a parametry v každé vrstvě.
- Založené na aktivaci. V nich dekódujeme aktivace jednotlivých neuronů nebo skupin neuronů, abychom pochopili jejich funkce.
- Založené na gradientech. Tyto metody mají tendenci manipulovat s gradienty, které vznikají z průchodu vpřed a zpět při trénování modelu (včetně map důležitosti a map aktivace třídy).
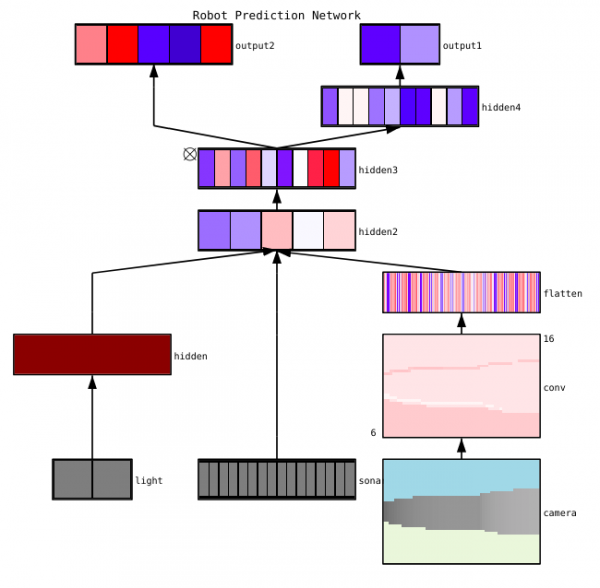
Existuje několik užitečných nástrojů pro vizualizaci aktivací a spojení jednotlivých vrstev, například a .
Diagnostika parametrů
Neuronové sítě mají spoustu parametrů, které vzájemně interagují, což komplikuje optimalizaci. Tento oddíl je vlastně předmětem aktivního výzkumu odborníků, a proto by následující návrhy měly být považovány pouze za rady, výchozí body, od kterých se můžete odrazit.
Velikost dávky (batch size) — je třeba, aby byla dostatečně velká, aby se dosáhlo přesných odhadů gradientu chyby, ale dostatečně malá, aby stochastický gradientní sestup (SGD) mohl uspořádat vaši síť. Malé velikosti dávek vedou k rychlé konvergenci na úkor šumu v procesu učení a později k problémům s optimalizací. Více se o tom píše .
Rychlost učení — příliš nízká povede k pomalé konvergenci nebo riziku uvíznout v lokálních minimech. Na druhé straně vysoká rychlost učení způsobí divergenci optimalizace, protože riskujete, že "přeskočíte" hlubokou, ale úzkou část funkce ztráty. Zkuste použít plánování rychlosti, abyste ji během trénování neuronové sítě snížili. V kurzu CS231n .
Oříznutí gradientu— oříznutí gradientů parametrů během zpětného šíření podle maximální hodnoty nebo mezní normy. Užitečné pro řešení problémů s případnými explodujícími gradienty, na které můžete narazit v třetím bodě.
Batched normování — používá se k normalizaci vstupních dat každé vrstvy, což přispívá k vyřešení problému vnitřního posunu kovariance. Pokud používáte Dropout a Batch Norm dohromady, .
Stochastický gradientní sestup (SGD) — existuje několik variant SGD, které využívají moment, adaptivní rychlosti učení a Nesterovovu metodu. Přičemž žádná z nich nemá zřejmou výhodu ani co se týče efektivity učení, ani co se týče generalizace ().
Regularizace — je rozhodující pro vytvoření generalizované modelu, protože přidává penalizaci za složitost modelu nebo extrémní hodnoty parametrů. Je to způsob, jak snížit variabilitu modelu bez významného zvýšení jeho zkreslení. Více .
Abychom si vše sami vyhodnotili, je třeba vypnout regularizaci a zkontrolovat gradient ztrátových dat samostatně.
Dropout — další metodou uspořádání vaší sítě, aby se zabránilo přetížení. Během učení se dropout provádí pouze udržováním aktivity neuronu s určitou pravděpodobností p (hyperparametr) nebo jeho nulováním v opačném případě. V důsledku toho musí síť použít jinou podmnožinu parametrů pro každou tréninkovou dávku, což zmenšuje změny specifických parametrů, které se stávají dominantními.
Důležité: pokud používáte jak dropout, tak batched normování, buďte opatrní s pořadím těchto operací nebo dokonce s jejich společným použitím. To vše je stále aktivně diskutováno a doplňováno. Zde jsou dvě důležité diskuse na toto téma a .
Kontrola práce
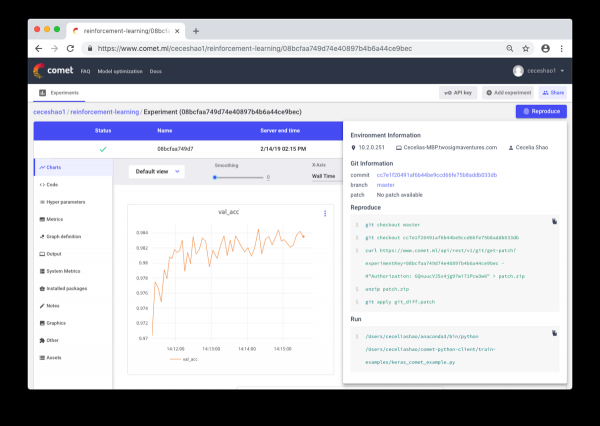
Jedná se o dokumentaci pracovních procesů a experimentů. Pokud se nic nedokumentuje, může se snadno zapomenout, například jaká rychlost učení nebo váha tříd se používá. Díky kontrole je možné bez problémů prohlížet a reprodukovat předchozí experimenty. To pomáhá snížit počet duplicitních experimentů.
Samozřejmě, že ruční dokumentace může být složitým úkolem při velkém objemu práce. Na pomoc přicházejí nástroje jako Comet.ml, které automaticky logují datové sady, změny kódu, historii experimentů a produkční modely, včetně klíčových informací o vašem modelu (hyperparametry, metriky výkonu modelu a informace o prostředí).
Neurální síť může být velmi citlivá na malé změny, což povede ke zhoršení výkonu modelu. Sledování a dokumentace práce je prvním krokem, který byste měli podniknout pro standardizaci prostředí a modelování.
Doufám, že tento příspěvek se stane výchozím bodem, ze kterého začnete ladění vaší neurální sítě.
Skillbox doporučuje:
- Dvouroční praktický kurz .
- Online kurz .
- Praktický roční kurz .
Zdroj: habr.com
