

Úvod
V tomto článku vám představím známý Huffmanův algoritmus a jeho využití při kompresi dat.
Na závěr vytvoříme jednoduchý archivační nástroj. O tom již byla , ale bez praktické realizace. Teoretický materiál tohoto příspěvku je převzat ze školních hodin informatiky a knihy Roberta Laforeho „Struktury dat a algoritmy v Javě“. Takže, vše pod kat!
Trocha úvah
V běžném textovém souboru je jeden znak kódován 8 bity (ASCII kódování) nebo 16 (Unicode kódování). Dále se budeme zabývat kódováním ASCII. Například vezmeme řetězec s1 = „SUSIE SAYS IT IS EASYn“. Celkem jsou v řetězci 22 znaků, samozřejmě včetně mezer a znaku pro návrat na nový řádek — ‘n’. Soubor, který tento řetězec obsahuje, bude mít velikost 22*8 = 176 bitů. Hned vyvstává otázka: je racionální používat všech 8 bitů kódování pro 1 znak? Vždyť nepoužíváme všechny znaky kódování ASCII. I kdybychom je používali, bylo by rozumnější nejčastějšímu písmenu — S — přiřadit co nejkratší možný kód, a pro nejvzácnější písmeno — T (nebo U, nebo ‘n’) — přiřadit kód delší. V tom spočívá Huffmanův algoritmus: je nutné najít optimální variantu kódování, při které bude soubor minimální velikosti. Je zcela normální, že různé znaky mají různé délky kódu — na tom je tento algoritmus založen.
Kódování
Proč by písmenu ‘S’ nemohl být přiřazen kód, například o délce 1 bit: 0 nebo 1. Nechť je to 1. Poté druhému nejčastěji se vyskytujícímu znaku — ‘ ‘(mezera) — přiřadíme 0. Představte si, že jste začali dekódovat svou zprávu — zakódovaný řetězec s1 — a vidíte, že kód začíná 1. Co tedy s tím: je to znak S, nebo nějaký jiný znak, například A? Proto vzniká důležité pravidlo:
Žádný kód nesmí být prefixem jiného
Toto pravidlo je klíčové v algoritmu. Proto se kódování začíná vytvořením tabulky četností, která uvádí četnost (počty výskytů) každého znaku:
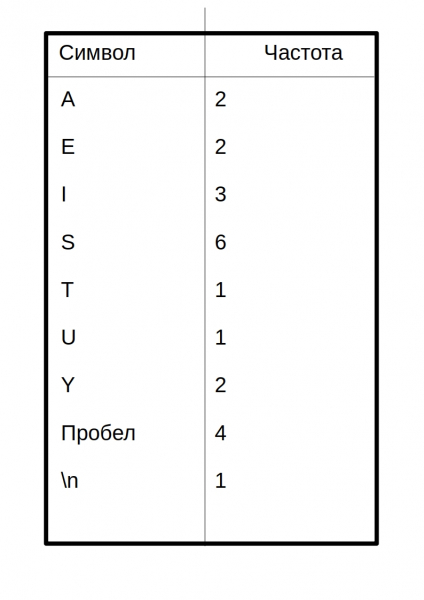 Znaky s nejvyšším počtem výskytů by měly být kódovány nejmenším možným počet bitů. Uvedu příklad jedné z možných tabulek kódů:
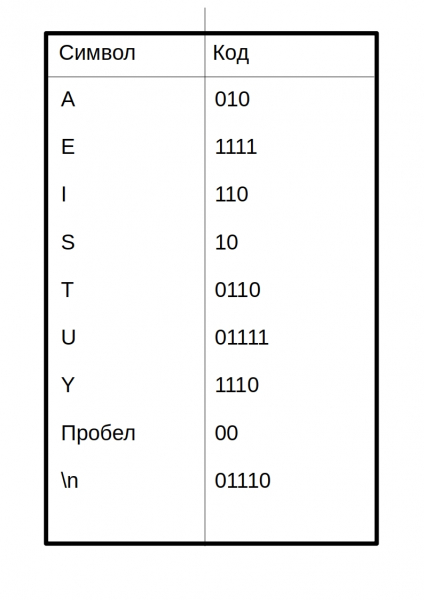 Takto bude zakódovaná zpráva vypadat:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Kód každého znaku jsem oddělil mezerou. V opravdu komprimovaném souboru to tak nebude!
Vychází otázka: jak tento začátečník vymyslel kód na vytvoření tabulky kódů? O tom bude řeč níže.
Sestavení Huffmanova stromu
Tady přicházejí na pomoc binární vyhledávací stromy. Nebojte se, zde metody vyhledávání, vkládání a mazání nejsou potřeba. Zde je struktura stromu v jazyce Java:
public class Node {
    private int frequence;
    private char letter;
    private Node leftChild;
    private Node rightChild;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
To není úplný kód, kompletní kód bude níže.
A teď samotný algoritmus vytváření stromu:
- Vytvořit objekt Node pro každý znak z zprávy (řetězec s1). V našem případě bude 9 uzlů (objektů Node). Každý uzel se skládá ze dvou datových polí: znak a frekvence.
- Vytvořit objekt stromu (BinaryTree) pro každý z uzlů Node. Uzel se stává kořenem stromu.
- Vložit tyto stromy do prioritní fronty. Čím nižší frekvence, tím větší priorita. Takto se při vyjímání vždy vybírá strom s nejnižší frekvencí.
Dalším krokem je cyklicky provádět následující:
- Vyjmout dva stromy z prioritní fronty a udělat je potomky nového uzlu (právě vytvořeného uzlu bez písmena). Frekvence nového uzlu je rovna součtu frekvencí dvou potomkovských stromů.
- Pro tento uzel vytvořit strom s kořenem v daném uzlu. Vložit tento strom zpět do prioritní fronty. (Protože má strom novou frekvenci, pravděpodobně se objeví na novém místě v frontě)
- Pokračovat v provádění kroků 1 a 2, dokud ve frontě nezůstane jeden strom – Huffmanův strom.
Podívejme se na tento algoritmus na řetězci s1:
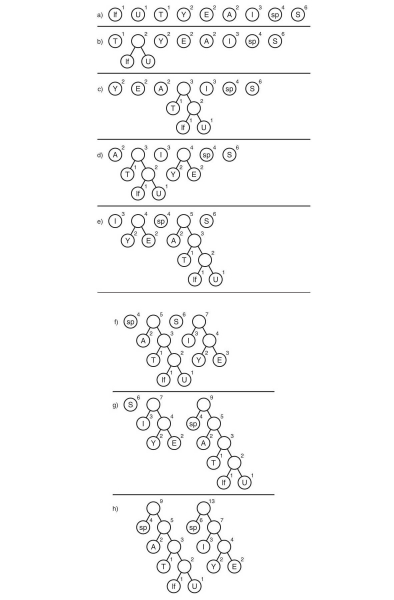
Zde znak „lf“ (linefeed) označuje přechod na nový řádek, „sp“ (space) – to je mezera.
A co dál?
Máme Huffmanův strom. Dobře, a co s ním teď dělat? Ani zadarmo ho nevezmou. A dále, je potřeba sledovat všechny možné cesty od kořene až po listy stromu. Domluvíme se označit hranu 0, pokud vede k levému potomkovi, a 1 – pokud k pravému. Přísně vzato, ve těchto označeních, kód symbolu – to je cesta od kořene stromu k listu, který obsahuje tento symbol.
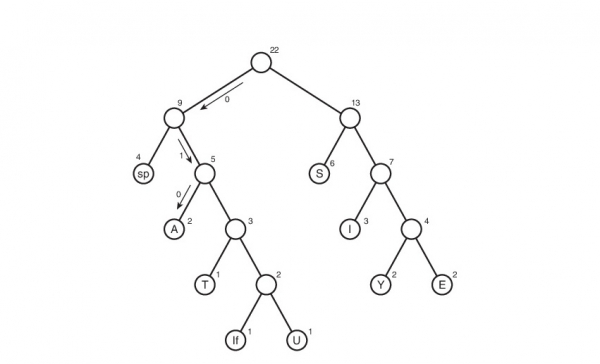
Tímto způsobem vznikla tabulka kódů. Uvědomme si, že když se na tuto tabulku podíváme, můžeme učinit závěr o „hmotnosti“ každého symbolu — to je délka jeho kódu. Poté v komprimované podobě bude původní soubor vážit: 2 * 3 + 2 * 4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bitů. Zpočátku vážil 176 bitů. To znamená, že jsme jej zmenšili o 176/65 = 2.7 krát! Ale to je utopie. Takového koeficientu pravděpodobně nedosáhneme. Proč? O tom si povíme později.
Dekódování
No, myslím, že zbývá to nejjednodušší — dekódování. Myslím, že mnozí z vás tuší, že není možné jednoduše vytvořit komprimovaný soubor bez jakýchkoli náznaků, jak byl zakódován — nebudeme jej moci dekódovat! Ano, bylo pro mě těžké si to uvědomit, ale budu muset vytvořit textový soubor table.txt s tabulkou komprese:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Zapisování tabulky ve formátu ‘symbol’«kód symbolu». Proč 01110 bez symbolu? Ve skutečnosti má symbol, jen nástroje Java, které jsem použil při výstupu do souboru, symbol nového řádku — ‘n’ -konvertují na nový řádek (jak hloupě to zní). Proto prázdný řádek nahoře je symbol pro kód 01110. Pro kód 00 je symbolem mezera na začátku řádku. Hned řeknu, že našemu koeficientu hrozí zánik – tento způsob ukládání tabulky může být nejméně efektivní. Ale je snadný na pochopení a realizaci. Rád si vyslechnu vaše doporučení v komentářích ohledně optimalizace.
S touto tabulkou je velmi snadné dekódovat. Připomeňme si pravidlo, jímž jsme se řídili při vytváření kódování:
Žádný kód nesmí být prefixem jiného
Tady to hraje usnadňující roli. Čteme postupně bit za bitem a jakmile se získaný řetězec d, složený ze čtených bitů, shoduje s kódováním příslušným symbolu character, ihned víme, že byl zakódován symbol character (a pouze on!). Pak zapíšeme character do dekódovacího řetězce (řetězce obsahujícího dekódovanou zprávu), vynulujeme řetězec d a pokračujeme ve čtení zakódovaného souboru.
Implementace
Přišel čas ponížit svůj kód a napsat kompresor. Nazvěme ho Compressor.
Začněme od začátku. Prvním krokem je napsat třídu Node:
public class Node {
    private int frekvence; // frekvence
    private char pismeno; // písmeno
    private Node levyPotomek; // levý potomek
    private Node pravyPotomek; // pravý potomek

    public Node(char pismeno, int frekvence) { // konstruktor
        this.pismeno = pismeno;
        this.frekvence = frekvence;
    }

    public Node() {} // přetížení konstruktoru pro bezejmenné uzly (viz výše v části o stavbě Huffmanova stromu)
    public void addChild(Node newNode) { // přidání potomka
        if (levyPotomek == null) // pokud je levý prázdný => pravý také => přidáváme do levého
            levyPotomek = newNode;
        else {
            if (levyPotomek.getFrekvence() <= newNode.getFrekvence()) // obecně, levým potomkem
                pravyPotomek = newNode; // stane se ten, kdo má menší frekvenci
            else {
                pravyPotomek = levyPotomek;
                levyPotomek = newNode;
            }
        }

        frekvence += newNode.getFrekvence(); // celková frekvence
    }

    public Node getLevyPotomek() {
        return levyPotomek;
    }

    public Node getPravyPotomek() {
        return pravyPotomek;
    }

    public int getFrekvence() {
        return frekvence;
    }

    public char getPismeno() {
        return pismeno;
    }

    public boolean isLeaf() { // kontrola, zda je list
        return levyPotomek == null && pravyPotomek == null;
    }
}
Nyní strom:
class BinaryTree {
    private Node koren;

    public BinaryTree() {
        koren = new Node();
    }

    public BinaryTree(Node koren) {
        this.koren = koren;
    }

    public int getFrekvence() {
        return koren.getFrekvence();
    }

    public Node getKoren() {
        return koren;
    }
}
Prioritní fronta:
import java.util.ArrayList; // ano, fronta bude na základě seznamu

class PriorityQueue {
    private ArrayList data; // seznam fronty
    private int nElems; // počet prvků v frontě

    public PriorityQueue() {
        data = new ArrayList();
        nElems = 0;
    }

    public void insert(BinaryTree newTree) { // vložení
        if (nElems == 0)
            data.add(newTree);
        else {
            for (int i = 0; i  newTree.getFrekvence()) { // pokud je frekvence vkládaného stromu menší
                    data.add(i, newTree); // než frekvence současného, posuneme všechna stromy na pozicích napravo o 1
                    break; // pak umístíme nový strom na pozici současného
                }
                if (i == nElems - 1)
                    data.add(newTree);
            }
        }
        nElems++; // zvyšujeme počet prvků o 1
    }

    public BinaryTree remove() { // odstranění z fronty
        BinaryTree tmp = data.get(0); // zkopírujeme odebíraný prvek
        data.remove(0); // vlastně, odstraníme
        nElems--; // snižujeme počet prvků o 1
        return tmp; // vrátíme odebíraný prvek (prvek s nejmenší frekvencí)
    }
}
Třída, která vytváří Huffmanův strom:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // délka kódovací tabulky
    private String myString; // zpráva
    private BinaryTree huffmanTree; // Huffmanovo strom
    private int[] freqArray; // frekvenční tabulka
    private String[] encodingArray; // kódovací tabulka


    // ----------------constructor----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    // --------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    // ------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // algoritmus je popsán výše
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // pokud znak existuje ve stringu
                Node newNode = new Node((char) i, freqArray[i]); // vytvořit Node pro něj
                BinaryTree newTree = new BinaryTree(newNode); // vytvořit BinaryTree pro Node
                pq.insert(newTree); // vložit do fronty
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // vyjmout první strom z fronty.

            try {
                BinaryTree tree2 = pq.remove(); // vyjmout druhý strom z fronty

                Node newNode = new Node(); // vytvořit nový Node
                newNode.addChild(tree1.getRoot()); // udělat dva vyjmuté stromy jeho potomky
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode);
            } catch (IndexOutOfBoundsException e) { // zbývá pouze jeden strom ve frontě
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    // -------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // naplnit kódovací tabulku
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // pro ladění
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Kódovací tabulka====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    // -----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Třída, která kóduje/dekóduje:
public class HuffmanOperator {
    private final byte VELIKOST_TA_BLICEK_KODOVANI = 127; // délka tabulky
    private HuffmanTree hlavniHuffmanovoDrevo; // Huffmanovo stromeček (používá se pouze pro kompresi)
    private String mojeRetezec; // původní zpráva
    private int[] poleFrekvenci; // frekvenční tabulka
    private String[] poleKodovani; // kódovací tabulka
    private double poměr; // koeficient komprese


    public HuffmanOperator(HuffmanTree HlavniHuffmanovoDrevo) { // pro kompresi
        this.hlavniHuffmanovoDrevo = HlavniHuffmanovoDrevo;

        mojeRetezec = hlavniHuffmanovoDrevo.getOriginalString();

        poleKodovani = hlavniHuffmanovoDrevo.getEncodingArray();

        poleFrekvenci = hlavniHuffmanovoDrevo.getFrequenceArray();
    }

    public HuffmanOperator() {} // pro extrakci;

    // ---------------------------------------komprese-----------------------------------------------------------
    private String ziskatKompresniRetezec() {
        String komprimovano = "";
        String mezilehlé = ""; // mezilehlý řetězec (bez přidaných nul)
        // System.out.println("=============================Kompresce=======================");
        // zobrazitPoleKodovani();
        for (int i = 0; i
        // je třeba přidat nuly na konec (možná 1, není rozdíl)
        byte počet = 0; // počet přidaných nul na konec (bajt úplně stačí: 0 <= počet < 8 < 127)
        for (int délka = mezilehlé.length(), delta = 8 - délka % 8;
                počet < delta; počet++) { // delta - počet přidaných nul
            mezilehlé += "0";
        }

        // spojit počet přidaných nul v binárním zobrazení a mezilehlý řetězec
        komprimovano = String.format("%8s", Integer.toBinaryString(počet & 0xff)).replace(" ", "0") + mezilehlé;

        // idealizovaný koeficient
        nastavKoefficientKompresce();
        // System.out.println("===============================================================");
        return komprimovano;
    }

    private void nastavKoefficientKompresce() { // spočítat idealizovaný koeficient
        double součetA = 0, součetB = 0; // A - původní součet
        for (int i = 0; i < VELIKOST_TA_BLICEK_KODOVANI; i++) {
            if (poleFrekvenci[i] != 0) {
                součetA += 8 * poleFrekvenci[i];
                součetB += poleKodovani[i].length() * poleFrekvenci[i];
            }
        }
        poměr = součetA / součetB;
    }

    public byte[] ziskatBytovouZpravu() { // finální komprese
        StringBuilder komprimovanýRetezec = new StringBuilder(ziskatKompresniRetezec());
        byte[] komprimovanéByty = new byte[komprimovanýRetezec.length() / 8];
        for (int i = 0; i < komprimovanéByty.length; i++) {
                komprimovanéByty[i] = (byte) Integer.parseInt(komprimovanýRetezec.substring(i * 8, (i + 1) * 8), 2);
        }
        return komprimovanéByty;
    }
    // ---------------------------------------konec komprese----------------------------------------------------------------
    // ------------------------------------------------------------extrakce-----------------------------------------------------
    public String extrakce(String komprimováno, String[] novéPoleKodovani) {
        String dekomprimováno = "";
        String aktuální = "";
        String delta = "";
        poleKodovani = novéPoleKodovani;

        // zobrazitPoleKodovani();
        // získat počet vložených nul
        for (int i = 0; i < 8; i++)
            delta += komprimováno.charAt(i);
        int PRIDANE_NULY = Integer.parseInt(delta, 2);

        for (int i = 8, l = komprimováno.length() - PRIDANE_NULY; i < l; i++) {
            // i = 8, protože prvním bajtem je počet vložených nul
            aktuální += komprimováno.charAt(i);
            for (int j = 0; j < VELIKOST_TA_BLICEK_KODOVANI; j++) {
                if (aktuální.equals(poleKodovani[j])) { // pokud je shoda
                    dekomprimováno += (char)j; // přidáme prvek
                    aktuální = ""; // a resetujeme aktuální řetězec
                }
            }
        }

        return dekomprimováno;
    }

    public String ziskatTabulkuKodovani() {
        String kod = "";
        for (int i = 0; i < poleKodovani.length; i++) {
            if (poleFrekvenci[i] != 0)
                kod += (char)i + poleKodovani[i] + 'n';
        }
        return kod;
    }

    public double ziskatPoměrKompresce() {
        return poměr;
    }


    public void zobrazitPoleKodovani() { // pro ladění
        System.out.println("======================Kódovací tabulka====================");
        for (int i = 0; i < VELIKOST_TA_BLICEK_KODOVANI; i++) {
            // if (poleFrekvenci[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(poleKodovani[i]);
            // }
        }
        System.out.println("========================================================");
    }
    }
Třída usnadňující zápis do souboru:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Neplatná cesta, nebo takový soubor neexistuje!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Třída usnadňující čtení ze souboru:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // pokud je soubor na konci
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
No, a hlavní třída:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // We specify the instruction using command line arguments
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Neplatný formát vstupních argumentů ");
            System.out.println("Přečtěte si Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List<String> stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Neplatná cesta nebo takový soubor neexistuje!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("Aktuální kódování souboru není podporováno");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // Create file with encoding table:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Cesta k zhuštěnému souboru: " + compressedFile.getAbsolutePath());
        System.out.println("Cesta k kódovací tabulce " + table.getAbsolutePath());
        System.out.println("Bez tabulky bude soubor nemožné extrahovat!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // Idealizovaný koeficient
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // Skutečný koeficient

        System.out.println("Idealizovaný koeficient komprese je " + idealRatio);
        System.out.println("Koeficient komprese s ohledem na kódovací tabulku " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // Read compressed file
        //!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! Check here:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // Method returns EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        // --------------------

        // Read encoding table:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // Skip first empty string
        	encodingArray[(byte)'n'] = fi.readLine(); // Read code for 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // Extract:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Cesta k rozbalenému souboru " + extractedFile.getAbsolutePath());
    }
}
Soubor s instrukcemi readme.txt si budete muset napsat sami 🙂
Závěr
Asi je to všechno, co jsem chtěl říct. Pokud máte nějaké připomínky k mé nekompetentnosti ohledně zlepšení kódu, algoritmu nebo vůbec jakékoli optimalizace, neváhejte psát. Pokud jsem něco nedostatečně objasnil, také pište. Budu rád, když se s vámi setkám v komentářích!
P.S.
Ano, ano, stále jsem tu, protože jsem nezapomněl na koeficient. Pro řetězec s1 váha kódovací tabulky činí 48 bytů — mnohem více než původní soubor, a nezapomněli jsme ani na přidané nuly (počet přidaných nul je 7) => koeficient komprese bude menší než jedna: 176/(65 + 48*8 + 7)=0.38. Jestliže jste si toho také všimli, tak máte mé uznání. Ano, tato implementace bude extrémně neefektivní pro malé soubory. Ale co se děje s velkými soubory? Velikosti souborů daleko překračují velikost kódovací tabulky. Zde algoritmus funguje, jak má! Například pro archivátor vydává skutečný (neidealizovaný) koeficient rovný 1.46 — téměř o polovinu více! A ano, předpokládalo se, že soubor bude v angličtině.
Zdroj: habr.com
