

Co může přimět tak velkou společnost jako Lamoda se zavedeným procesem a desítkami vzájemně propojených služeb k radikální změně přístupu? Motivace může být zcela různá: od legislativní po inherentní touhu všech programátorů experimentovat.
To však neznamená, že nelze očekávat další výhody. O tom, v čem konkrétně lze získat, pokud zavede events-driven API na Kafka, promluví Sergey Zaika (). O zkušenostech a zajímavých objevech bude také určitě řeč – experimenty se bez nich neobejdou.
Upozornění: Tento článek je založen na materiálech ze setkání, které Sergey vedl v listopadu 2018 na HighLoad++. Živé zkušenosti Lamody s Kafka přilákaly posluchače stejně jako jiné přednášky z programu. Domníváme se, že je to skvělý příklad toho, že je vždy možné a nezbytné najít spřízněné duše, a organizátoři HighLoad++ budou nadále usilovat o vytváření příjemné atmosféry pro to.
O procesu
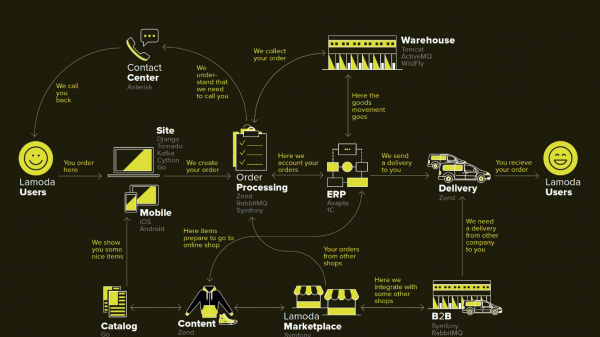
Lamoda je velká e-commerce platforma, která má vlastní kontaktní centrum, doručovací službu (a řadu partnerských), fotostudio, obrovský sklad a to vše funguje na vlastním softwaru. Existuje několik desítek způsobů platby, b2b-partneři, kteří mohou využívat část nebo všechny tyto služby a chtějí znát aktuální informace o svých produktech. Kromě toho, Lamoda má pobočky ve třech zemích mimo RF, kde to funguje trochu jinak. Celkově existuje pravděpodobně více než sto způsobů, jak konfigurovat novou objednávku, která musí být zpracována určitým způsobem. To vše funguje s pomocí desítek služeb, které vzájemně komunikují ne vždy zřejmým způsobem. Dále existuje centrální systém, jehož hlavní odpovědností jsou stavy objednávek. Nazýváme jej BOB, pracuji s ním.
Refund Tool s events-driven API
Slovo events-driven je obvyklé, podrobněji si za chvíli objasníme, co tím máme na mysli. Začnu kontextem, ve kterém jsme se rozhodli vyzkoušet přístup events-driven API na Kafka.
V každém obchodě, kromě objednávek, za které zákazníci platí, nastávají okamžiky, kdy je od obchodu vyžadováno vrátit peníze, protože zákazníkovi zboží nevyhovuje. Tento poměrně krátký proces: ověřujeme informace, pokud je to nutné, a převádíme peníze.
Ale vracení se zkomplikovalo v důsledku změny legislativy a museli jsme pro to implementovat samostatnou mikroservisu.
Naše motivace:
- Zákon FZ-54 — stručně řečeno, zákon vyžaduje, aby se každá finanční operace, ať už jde o vracení nebo přijímání, nahlásila daňovému úřadu v poměrně krátkém SLA v řádu minut. My jako e-commerce provádíme poměrně hodně operací. Technicky to znamená novou zodpovědnost (a tedy novou službu) a úpravy ve všech zapojených systémech.
- BOB split — interní projekt společnosti na zbavení BOBu velkého množství nepodstatných zodpovědností a snížení jeho celkové složitosti.
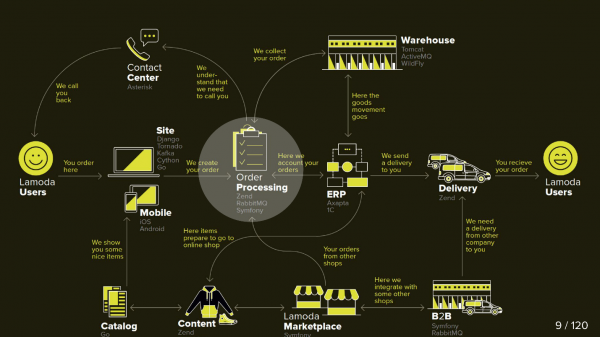
Na tomto schématu jsou nakresleny hlavní systémy Lamoda. V současnosti většina z nich představuje spíše souhvězdí 5-10 mikroservis kolem zmenšujícího se monolitu. Pomalu rostou, ale snažíme se je zmenšit, protože nasazení vyčleněného fragmentu uprostřed je děsivé – nelze dopustit, aby spadl. Všechny výměny (šipky) musíme rezervovat a počítat s tím, že jakýkoliv z nich může být nedostupný.
V BOBu je také poměrně hodně výměn: systémy plateb, doručení, notifikace atd.
Technicky BOB je:
- ~150k řádků kódu + ~100k řádků testů;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 výchozích integrací;
- 4 země se svou obchodní logikou.
Nasazení BOBu je drahé a bolestivé, množství kódu a úkolů, které řeší, je takové, že nikdo nemůže mít vše v hlavě najednou. Obecně řečeno, je mnoho důvodů, proč ho zjednodušit.
Proces vracení
Původně jsou do procesu zapojeny dvě systémy: BOB a Payment. Nyní se přidávají další dva:
- Fiscalization Service, která se postará o problémy s fiskalizací a komunikaci s externími službami.
- Refund Tool, do kterého se jednoduše převádějí nové výměny, aby se nezvětšoval BOB.
Nyní proces vypadá takto:
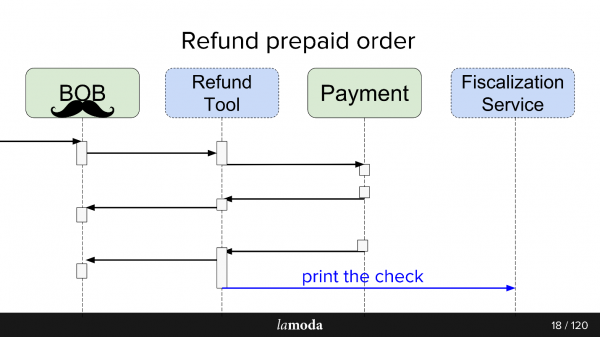
- Do BOBu přichází žádost o vrácení peněz.
- BOB o tom informuje Refund Tool.
- Refund Tool říká Payment: „Vrať peníze“.
- Payment vrací peníze.
- Refund Tool a BOB si navzájem synchronizují stavy, protože oba to zatím potřebují. Dosud nejsme připraveni plně přejít na Refund Tool, protože v BOBu existuje UI, reporty pro účetnictví a vůbec spousta dat, která tak jednoduše nepřenesete. Musíme sedět na dvou židlích.
- Odchází žádost o fiskalizaci.
Nakonec jsme vytvořili na Kafka určitou událostní sběrnici – event-bus, na které se všechno točilo. Hurá, teď máme jednotný bod selhání (sarkasmus).
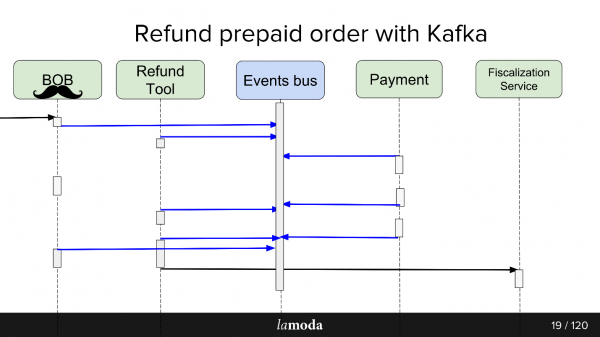
Výhody a nevýhody jsou docela zřejmé. Udělali jsme sběrnici, takže nyní všechny služby na ní závisí. To usnadňuje návrh, ale přináší do systému jednotný bod selhání. Když spadne Kafka, proces se zastaví.
Co je to API řízené událostmi
Dobrá odpověď na tuto otázku je v prezentaci Martina Fowlerea (GOTO 2017) .
Stručně, co jsme udělali:
- Zabalili jsme všechny asynchronní výměny přes úložiště událostí. Místo toho, abychom informovali přes síť každého zainteresovaného spotřebitele o změně stavu, zapisujeme do centralizovaného úložiště událost o změně stavu a zainteresovaní spotřebitelé si z něj čtou vše, co se objeví.
- Událost v tomto případě je oznámení (notifications) o tom, že se něco někde změnilo. Například se změnil stav objednávky. Spotřebitel, kterému záleží na nějakých doprovodných datech ke změně stavu, která nejsou v oznámení, si může zjistit jejich stav sám.
- Maximální varianta – plnohodnotné event sourcing, přenos stavu, při kterém událost obsahuje všechny informace potřebné k zpracování: odkud a do jakého stavu se přešlo, jak se data přesně změnila atd. Otázkou je jen oprávněnost a objem informací, které si můžete dovolit uchovávat.
V rámci spuštění Refund Tool jsme použili třetí variantu. To zjednodušilo zpracování událostí, protože nebylo potřeba vyhledávat podrobné informace, navíc vyloučilo scénář, kdy každá nová událost vyvolává vlnu upřesňujících GET požadavků od spotřebitelů.
Služba Refund Tool není zatížena, takže Kafka tam spíše slouží jako pokus než nezbytnost. Nemyslím si, že by byl byznys rád, kdyby se služba vracení peněz stala projektem s vysokou zátěží.
Asynchronní výměna AS IS
Pro asynchronní výměny obvykle PHP oddělení používá RabbitMQ. Shromáždí data pro požadavek, dají je do fronty a koncový uživatel stejné služby je přečetl a poslal (nebo neposlal). Pro samotné API Lamoda aktivně využívá Swagger. Navrhujeme API, popisujeme ho ve Swaggeru, generujeme klientský a serverový kód. Ještě používáme mírně rozšířený JSON RPC 2.0.
Někde se používají esb sběrnice, někdo žije na activeMQ, ale celkově, RabbitMQ — standard.
Async exchange TO BE
Při navrhování výměny přes events-bus se objevuje analogie. Budoucí výměnu dat popisujeme podobným způsobem pomocí popisu struktury eventu. Formát yaml, kódovou generaci jsme museli udělat sami, generátor podle specifikace vytváří DTO a učí klienty a servery s nimi pracovat. Generace probíhá ve dvou jazycích — golang a php. To nám umožňuje udržovat knihovny v souladu. Generátor je napsán v golangu a dostal jméno gogi.
Event-sourcing na Kafka je běžná věc. Existuje řešení od hlavní enterprise verze Kafka Confluent, je tu také , řešení od našich „bratrů“ v doménové oblasti Zalando. Naší motivací začít s vanilla Kafka je udržet řešení zdarma, dokud se definitivně nerozhodneme, zda ho budeme široce používat, a také si ponechat prostor pro manévrování a další práce: chceme podporu svého JSON RPC 2.0, generátory pro oba jazyky a uvidíme, co ještě.
Ironií je, že i v tak šťastném případě, kdy existuje přibližně analogický podnik Zalando, které udělalo přibližně podobné řešení, ho nemůžeme efektivně využít.
Architektonicky při spuštění je vzor následující: čteme přímo z Kafka, ale zapisujeme pouze přes events-bus. Pro čtení z Kafka je k dispozici mnoho hotového: brokeři, vyvažovače a je více méně připravena na horizontální škálování, což chceme zachovat. Zápis jsme se rozhodli zabalit přes jeden Gateway aka Events-bus, a to je důvod.
Events-bus
Nebo autobus událostí. To je jednoduše stateless http gateway, který na sebe bere několik důležitých rolí:
- Validace produčního procesu — ověřujeme, že události vyhovují naší specifikaci.
- Hlavní systém pro události, tedy to je hlavní a jediný systém ve společnosti, který odpovídá na otázku, jaké události s jakými strukturami se považují za platné. Do validace patří jednoduše typy dat a enums pro přísnou specifikaci obsahu.
- Hashová funkce pro shardování — struktura zprávy Kafka je key-value a zde se podle hash od key počítá, kam to umístit.
Proč
Pracujeme ve velké společnosti s nastavenými procesy. Proč něco měnit? To je experiment, a očekáváme, že získáme několik výhod.
1:n+1 výměny (jeden k mnoha)
S Kafka je velmi snadné připojit nové spotřebitele k API.
Představte si, že máte adresář, který je třeba udržovat aktuální v několika systémech najednou (a také v nějakých nových). Dříve jsme vymýšleli bundle, který realizoval set-API, a hlavnímu systému jsme oznamovali adresy příjemců. Nyní hlavní systém posílá aktualizace do tématu a všichni, koho to zajímá, čtou. Objevil se nový systém – přihlásili jsme ho k tématu. Ano, také bundle, ale jednodušší.
V případě refund-tool, což je vlastně kus BOB, je pro nás pohodlné držet je synchronizované přes Kafka. Payment říká, že peníze byly vráceny: BOB a RT o tom věděli, změnili si stavy, Fiscalization Service o tom věděl a vydal účtenku.
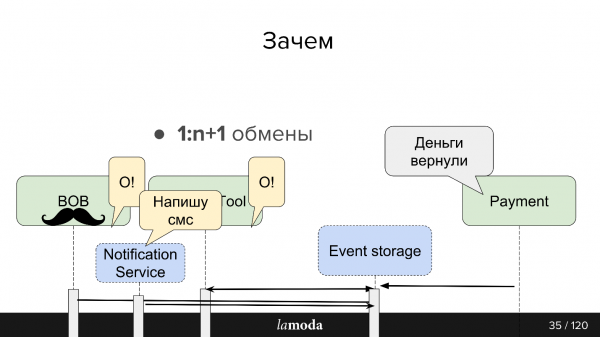
Máme v plánu vytvořit jednotnou službu Notifications Service, která by informovala klienta o novinkách kolem jeho objednávek/vratek. V současnosti je tato odpovědnost rozptýlena mezi systémy. Budeme schopni naučit Notifications Service zachycovat z Kafka relevantní informace a reagovat na ně (a vypnout tato oznámení v ostatních systémech). Nebude třeba žádné nové přímé výměny.
Data-driven
Informace mezi systémy se stává transparentními – jakýkoli „krvavý enterprise“ byste měli a jak objemný by váš backlog nebyl. V Lamodě je oddělení Data Analytics, které shromažďuje data ze systémů a přetváří je do znovu použitelných formátů, jak pro podnikání, tak pro inteligentní systémy. Kafka umožňuje rychle jim poskytnout velké množství dat a udržovat tento informační tok aktuální.
Replication log
Zprávy nezmizí po přečtení, jako v RabbitMQ. Když událost obsahuje dostatek informací pro zpracování, máme historii posledních změn objektu a, pokud si přejeme, možnost tyto změny aplikovat.
Doba uchovávání replication log závisí na intenzitě zápisu do tohoto tématu, Kafka umožňuje flexibilně nastavit limity pro dobu uchovávání a objem dat. Pro intenzivní témata je důležité, aby všichni příjemci stihli přečíst informace dříve, než zmizí, i v případě krátkodobé nefunkčnosti. Obvykle se podaří uchovávat data za jednotky dní, což je zcela dostačující pro podporu.
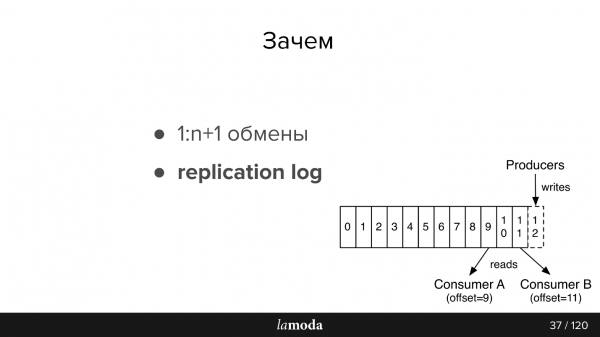
Dále je tu trochu shrnutí dokumentace pro ty, kdo nejsou s Kafkou obeznámeni (obrázek je také z dokumentace)
V AMQP existují fronty: zapisujeme zprávy do fronty pro konzumenta. Obvykle jednu frontu zpracovává jeden systém s jednou a tou samou obchodní logikou. Pokud je potřeba informovat několik systémů, lze aplikaci naučit zapisovat do několika front nebo nastavit exchange s mechanikou fanout, která je sama klonuje.
V Kafka existuje podobná abstrakce topic, do které zapisujete zprávy, ale ty nezmizí po přečtení. Ve výchozím nastavení, při připojení k Kafka, dostanete všechny zprávy, a také máte možnost uložit místo, na kterém jste se zastavili. To znamená, že čtete sekvenčně, můžete neoznačit zprávu jako přečtenou, ale uložit id, od kterého pak pokračujete ve čtení. Id, na kterém jste se zastavili, se nazývá offset a mechanika je commit offset.
Odpovídajícím způsobem lze implementovat různé logiky. Například, náš BOB existuje ve 4 instancích pro různé země - Lamoda je v Rusku, Kazachstánu, Ukrajině a Bělorusku. Protože se nasazují odděleně, mají trochu své konfigurace a svou obchodní logiku. V zprávě uvádíme, k jaké zemi se vztahuje. Každý konzument BOB v každé zemi čte s různými groupId, a pokud se zpráva na něj nevztahuje, přeskočí ji, tedy ihned commitne offset +1. Pokud stejný topic čte náš Payment Service, dělá to s oddělenou skupinou, a proto se offsety nepřekrývají.
Požadavky na události:
- Úplnost dat. Chtěli bychom, aby v události bylo dostatek dat, aby mohla být zpracována.
- Integrita. Delegujeme Events-bus kontrole toho, že událost je konzistentní a může být zpracována.
- Pořadí je důležité. V případě vrácení jsme nuceni pracovat s historií. U notifikací není pořadí důležité, pokud jsou to homogenní notifikace, e-mail bude stejný bez ohledu na to, který objednávka dorazila jako první. V případě vrácení existuje jasný proces; pokud změníte pořadí, vzniknou výjimky, refundace se nevytvoří nebo nezpracuje – dostaneme se do jiného stavu.
- Konzistence. Máme úložiště a nyní místo API vytváříme události. Potřebujeme způsob, jak rychle a levně předávat do našich služeb informace o nových událostech a o změnách v již existujících. Toho dosahujeme pomocí společné specifikace v samostatném git repozitáři a kódových generátorů. Proto jsou u nás klienti a servery v různých službách sladěny.
Kafka v Lamoda
Máme tři instalace Kafka:
- Logy;
- R&D;
- Events-bus.
Dnes mluvíme pouze o posledním bodě. V events-busu máme ne příliš velké instalace – 3 brokery (servery) a celkem 27 témat. Obvykle jedno téma – to je jeden proces. Ale to je subtilní bod a teď se ho dotkneme.
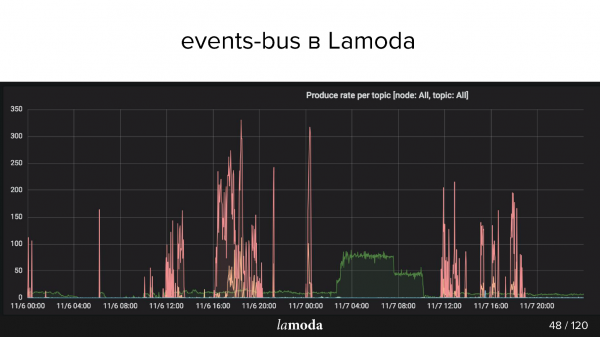
Výše je graf rps. Proces vratek je označen tyrkysovou čarou (ano, ano, ta, co leží na ose X), a růžovou – proces aktualizace obsahu.
Katalog Lamoda obsahuje miliony produktů, přičemž data se neustále aktualizují. Jedny kolekce vycházejí z módy, na jejich místo jsou vydávány nové, v katalogu neustále přibývají nové modely. Snažíme se předpovědět, co bude zajímat naše zákazníky zítra, proto neustále nakupujeme nové věci, fotografujeme je a aktualizujeme výlohu.
Růžové hroty – to jsou aktualizace produktu, to znamená změny v produktech. Je vidět, že kluci fotografovali, fotografovali, a pak najednou! – nahráli balíček událostí.
Případové studie Lamoda Events
Postavenou architekturu používáme pro takové operace:
- Sledování stavů vratek: call-to-action a sledování stavů ze všech zapojených systémů. Platba, stavy, fiskalizace, notifikace. Zde jsme vyzkoušeli přístup, vytvořili nástroje, shromáždili všechny chyby, napsali dokumentaci a pověděli kolegům, jak to používat.
- Aktualizace karet produktů: konfigurace, meta-data, charakteristiky. Čte jeden systém (který zobrazuje), ale zapisují jich několik.
- Email, push a sms: objednávka byla shromážděna, objednávka dorazila, vrátka byla přijata atd., je jich hodně.
- Zásoby, aktualizace skladu – kvantitativní aktualizace názvů, prostě čísla: přijetí na sklad, vrátka. Je nutné, aby všechny systémy spojené s rezervací zboží pracovaly s co nejaktuálnějšími daty. Nyní je systém aktualizace zásob docela složitý, Kafka nám umožní jej zjednodušit.
- Analýza dat (R&D-oddělení), ML-nástroje, analýza, statistika. Chceme, aby informace byly přehledné – k tomu je Kafka dobře vhodná.
Teď přichází zajímavější část o zkušenostech a zajímavých objevech, které se objevily za posledních šest měsíců.
Problémy návrhu
Představme si, že chceme udělat novou věc – například převést celý proces dodání na Kafka. V současnosti je část procesu implementována v Order Processing v BOB. Před předáním objednávky do služby dodání, přemístěním do meziskladu a dalšími záležitostmi stojí statusová model. Existuje celý monolit, dokonce dva, plus spousta API věnovaných dodání. Vědí o dodání daleko více.
Zdá se, že se jedná o podobné oblasti, ale pro Order Processing v BOB a pro dodací systém se stavy liší. Například některé kurýrní služby neodesílají mezistavy a pouze konečné: "doručeno" nebo "ztraceno". Jiné, naopak, velmi podrobně informují o pohybu zboží. Každý má svá pravidla validace: pro někoho je platný e-mail, znamená to, že bude zpracován; pro jiné je neplatný, ale objednávka bude i tak zpracována, protože existuje telefon pro kontakt, a někdo jiný řekne, že takovou objednávku vůbec zpracovávat nebudou.
Tok dat
V případě Kafky vyvstává otázka organizace toku dat. Tato úloha souvisí s výběrem strategie podle několika bodů, projdeme si je všechny.
Do jednoho tématu nebo do různých?
Máme specifikaci události. V BOB píšeme, že je třeba doručit tuto objednávku a uvádíme: číslo objednávky, její složení, některé SKU a čárové kódy atd. Když zboží dorazí na sklad, dodání může získat stavy, časové značky a vše potřebné. Ale dále chceme v BOB získávat aktualizace k těmto datům. Vzniká nám zpětný proces získávání dat z dodání. Je to ta samá událost? Nebo se jedná o samostatnou výměnu, která si zaslouží samostatné téma?
Pravděpodobně budou hodně podobné, a pokušení udělat jedno téma je opodstatněné, protože samostatné téma znamená samostatné spotřebitele, samostatné konfigurace, samostatnou generaci toho všeho. Ale není to jisté.
Nové pole nebo nová událost?
Ale pokud použijeme ty samé události, objeví se jiný problém. Například ne všechny doručovací systémy dokážou vygenerovat takové DTO, které bude schopné generovat BOB. Posíláme jim id, a oni je neuchovávají, protože je nepotřebují, a z pohledu zahájení procesu event-bus je toto pole povinné.
Pokud stanovíme pro event-bus pravidlo, že toto pole je povinné, musíme v BOB nebo v handleru počáteční události nastavit další validační pravidla. Validace se začíná šířit po službě – to není moc pohodlné.
Dalším problémem je pokušení inkrementálního vývoje. Říkají nám, že je potřeba něco přidat do události, a možná, pokud se na to dobře zamyslíme, mělo by to být zvláštní událostí. Ale v naší schématu je zvláštní událostí zvláštní téma. Zvláštní téma – to je celý ten proces, který jsem popsal výše. U vývojáře vzniká pokušení jednoduše přidat do JSON schématu další pole a znovu vygenerovat.
V případě refunds jsme tak za půl roku došli k události událostí. Měli jsme jedno meta-událost, která se nazývá refund update, kde bylo pole type, popisující, v čem přesně tento update spočívá. Z toho byly "skvělé" spínače s validátory, které říkaly, jak je třeba tuto událost s tímto typem validovat.
Verzování událostí
Pro validaci zpráv v Kafka lze použít , ale muselo se na to hned myslet a použít Confluent. V našem případě s verzováním musíme být opatrní. Ne vždy bude možné přečíst zprávy z replication log, protože model "odjel". V podstatě se snažíme vytvářet verze tak, aby model byl zpětně kompatibilní: například udělat pole dočasně nepovinným. Pokud jsou rozdíly příliš silné, začneme psát do nového tématu a klienty převedeme, když dočtou staré.
Záruka pořadí čtení částí
Témata uvnitř Kafka jsou rozdělena na části. To není moc důležité, dokud navrhujeme entity a výměny, ale důležité je, když se rozhodujeme, jak to konzumovat a škálovat.
Obvykle zapisujete do jednoho tématu v Kafka. Ve výchozím nastavení je využit jeden partition a všechny zprávy tohoto tématu do něj spadají. Spotřebitel pak tyto zprávy čte po sobě. Představme si, že nyní potřebujete systém rozšířit tak, aby zprávy četli dva různí spotřebitelé. Pokud například posíláte SMS, můžete říct, aby Kafka vytvořila další partition, a Kafka začne rozdělovat zprávy na dvě části — půlku sem, půlku tam.
Jak je Kafka dělí? Každá zpráva má tělo (ve kterém uchováváme JSON) a má klíč. K tomuto klíči lze připojit hashovací funkci, která určí, do kterého partition zpráva spadne.
V našem případě s refundacemi je to důležité, protože pokud vezmeme dva partitions, existuje šance, že paralelní spotřebitel zpracuje druhou událost dříve než první a to by byl problém. Hashovací funkce zaručuje, že zprávy se stejným klíčem skončí ve stejném partition.
Události vs příkazy
To je další problém, se kterým jsme se setkali. Událost je nějaká událost: říkáme, že se něco někde stalo (something_happened), například položka byla zrušena nebo došlo k refundaci. Pokud tyto události někdo naslouchá, pak podle "položka byla zrušena" vznikne entita refundace a "došlo k refundaci" se zapíše někam do nastavení.
Ale často, když navrhujete události, přece jen nechcete je psát zbytečně — počítáte s tím, že je někdo bude číst. Velkým pokušením je napsat ne something_happened (item_canceled, refund_refunded), ale something_should_be_done. Například položka je připravena na vrácení.
Na jedné straně to naznačuje, jak bude událost použita. Na druhé straně to mnohem méně připomíná normální název události. Navíc odtud už je to blízko k příkazu do_something. Ale nemáte žádnou záruku, že tuto událost někdo přečetl; a pokud ji přečetl, tak úspěšně; a pokud ji přečetl úspěšně, tak něco udělal, a to něco prošlo úspěšně. V okamžiku, kdy se událost stává do_something, je potřebná zpětná vazba, a to je problém.
V asynchronní komunikaci v RabbitMQ, když přečtete zprávu, jdete na http, máte odpověď — aspoň že byla zpráva přijata. Když zapisujete do Kafka, máte zprávu, že jste zapsali do Kafka, ale o tom, jak byla zpracována, nevíte vůbec nic.
Protože jsme v našem případě museli zavést odpovídající událost a nastavit monitorování tak, aby, pokud došlo k určitému počtu událostí během určité doby, mělo také přijít stejné množství odpovídajících událostí. Pokud k tomu nedošlo, zdá se, že něco šlo špatně. Například pokud jsme poslali událost „item_ready_to_refund“, očekáváme, že refundace bude vytvořena, klientovi se vrátí peníze a nám přijde událost „money_refunded“. Ale to není jisté, proto potřebujeme monitorování.
Nuance
Existuje docela zřejmý problém: pokud čtete z topiku sekvenčně a máte nějakou špatnou zprávu, consumer spadne a dál se nedostanete. Musíte zastavit všechny consumery, potvrdit offset dále, aby bylo možné pokračovat ve čtení.
O tom jsme věděli, na to jsme se připravili, a stejně se to stalo. A stalo se to, protože událost byla platná z pohledu events-bus, událost byla platná z pohledu validačního nástroje aplikace, ale nebyla platná z pohledu PostgreSQL, protože máme v jednom systému MySQL s UNSIGNED INT, a v právě napsaném systému byl PostgreSQL prostě s INT. Jeho velikost je o něco menší a Id se nevešlo. Symfony spadlo s výjimkou. Samozřejmě jsme výjimku zachytili, protože jsme na to byli připraveni a chtěli jsme potvrdit tento offset, ale předtím jsme chtěli inkrementovat počítadlo problémů, když už byla zpráva zpracována neúspěšně. Počítadla v tomto projektu také leží v databázi, a Symfony už uzavřelo komunikaci s databází, a druhá výjimka zabila celý proces bez šance potvrdit offset.
Nějakou dobu služba ležela — naštěstí, s Kafka to není tak strašné, protože zprávy zůstávají. Když se práce obnoví, bude možné je dočíst. To je pohodlné.
Kafka má možnost přes nástroje nastavit libovolný offset. Ale abyste to udělali, musíte zastavit všechny consumery — v našem případě připravit samostatnou verzi, ve které nebudou consumery, redeployments. Potom lze v Kafce přes nástroje posunout offset, a zpráva projde.
Další nuance — replication log vs rdkafka.so — souvisí se specifiky našeho projektu. Používáme PHP, a v PHP obvykle všechny knihovny komunikují s Kafkou prostřednictvím repozitáře rdkafka.so, a potom následuje nějaký obal. Možná je to naše osobní potíž, ale ukázalo se, že prostě si přečíst kousek už jednou přečteného není tak snadné. Celkově jsme měli softwarové problémy.
Pokud se vrátíme k vlastnostem práce s partitions, přímo v dokumentaci je uvedeno consumers >= topic partitions. Ale dozvěděl jsem se o tom mnohem později, než bych chtěl. Pokud chcete škálovat a mít dva konzumenty, potřebujete alespoň dvě partitions. To znamená, že pokud máte jednu partition, ve které se nahromadilo 20 tisíc zpráv, a uděláte novou, počet zpráv se vyrovná brzy ne tak snadno. Proto, abyste měli dva paralelní konzumenty, musíte se zabývat partitions.
Monitoring
Myslím, že podle toho, jak monitorujeme, bude ještě jasnější, jaké problémy existují v současném přístupu.
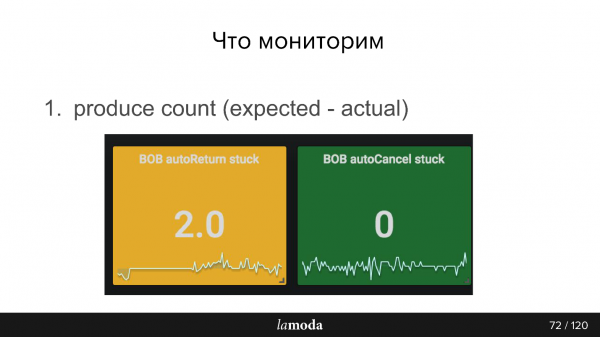
Například počítáme, kolik produktů v databázi nedávno změnilo status, a podle těchto změn by se měly udát události, a posíláme toto číslo do našeho monitorovacího systému. Poté z Kafky dostáváme druhé číslo, kolik událostí skutečně bylo zapsáno. Je zřejmé, že rozdíl mezi těmito dvěma čísly by měl být vždy nulový.
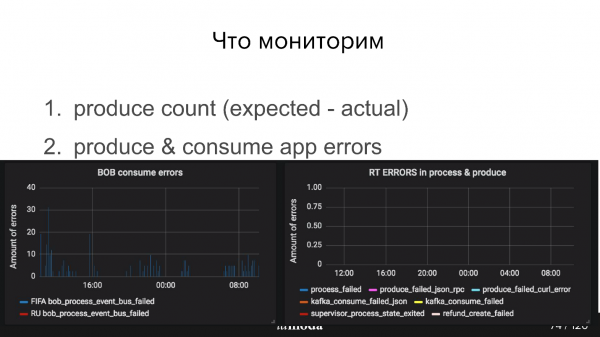
Kromě toho je třeba monitorovat, jak si vede producent, jestli events-bus přijal zprávy, a jak si vede konzument. Například na grafech níže má Refund Tool všechno v pořádku, ale BOB má evidentně nějaké problémy (modré vrcholy).
Já už jsem zmínil consumer-group lag. Ve zjednodušené podobě jde o počet nepřečtených zpráv. Celkově naši konzumenti pracují rychle, takže lag obvykle činí 0, ale občas může nastat krátkodobý vrchol. Kafka to umí z krabice, ale je třeba nastavit určitý interval.
Existuje projekt , který vám poskytne více informací o Kafce. Jednoduše pomocí API vrací stav podle consumer-group, jak si tato skupina vede. Kromě OK a Failed existuje také warning, a můžete zjistit, že vaši konzumenti nezvládají tempo produkce - nestíhají číst to, co se zapisuje. Systém je dost chytrý, je pohodlné ho používat.
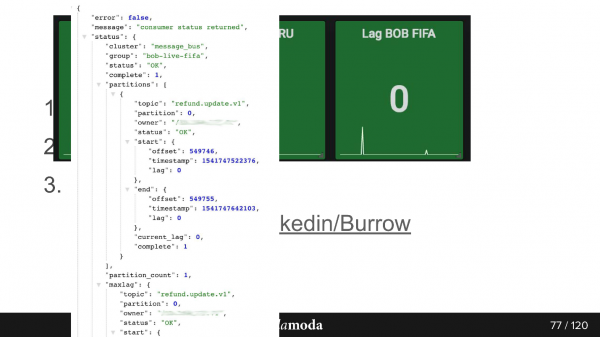
Takto vypadá odpověď podle API. Zde je skupina bob-live-fifa, partition refund.update.v1, stav OK, lag 0 - poslední konečný offset je takový.
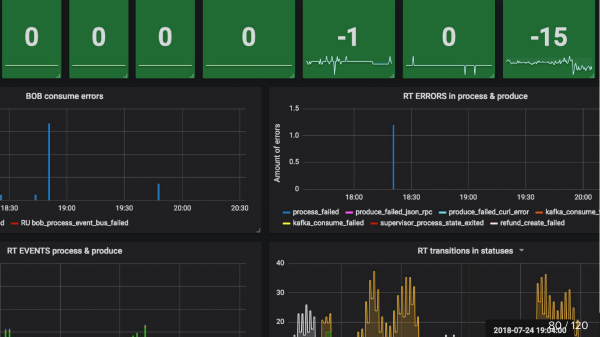
Monitoring updated_at SLA (stuck) Už jsem o tom mluvil. Například, když produkt přešel do stavu, že je připraven k vrácení. Nastavíme Cron, který říká, že pokud za 5 minut tento objekt nepřejde do refundace (peníze vracíme přes platební systémy velmi rychle), tak se určitě něco pokazilo a je to jasný případ pro podporu. Proto vezmeme cron, který sleduje tyto věci, a pokud jsou větší než 0, pošle upozornění.
Shrnuto, použití událostí je pohodlné, když:
- informace potřebují několik systémů;
- výsledek zpracování není důležitý;
- událostí je málo nebo jsou události malé.
Na první pohled má článek velmi konkrétní téma - asynchronní API na Kafka, ale v souvislosti s ním bych okamžitě chtěl doporučit spoustu věcí.
Za prvé, následující není třeba čekat do listopadu, už v dubnu bude jeho peterburská verze, a v červnu se budeme bavit o vysokých zátěžích v Novosibirsku.
Za druhé, autor zprávy Sergey Zaika je členem programového výboru naší nové konference o řízení znalostí. Konference je jednodenní, proběhne 26. dubna, ale má velmi nabitý program.
A ještě v květnu bude a (s DevOpsConf v rámci) - tam ještě můžete navrhnout své téma, podělit se o své zkušenosti a stěžovat si na své nabité šrámy.
Zdroj: habr.com
