

V minulosti Rozebrali jsme teoretické základy reaktivní architektury. Přišel čas mluvit o tokách dat, cestách realizace reaktivních systémů Erlang/Elixir a vzorech výměny zpráv v nich:
- Žádost-odpověď
- Žádost-Chunked Odpověď
- Odpověď se žádostí
- Publikovat-přihlásit se
- Inverzní publikování-přihlašování
- Distribuce úloh
SOA, MSA a výměna zpráv
SOA, MSA – systémové architektury, které definují pravidla pro stavbu systémů, zatímco messaging poskytuje primitiva pro jejich realizaci.
Nechci prosazovat žádnou konkrétní architekturu pro stavbu systémů. Podporuji maximálně efektivní a užitečné praktiky pro konkrétní projekt a podnikání. Ať už zvolíme jakoukoli paradigmu, je lepší vytvářet systémové bloky s ohledem na Unixový způsob: komponenty s minimální vazbou, které odpovídají za jednotlivé entity. API metody vykonávají co nejjednodušší akce s entitami.
Messaging ‒ jak je z názvu jasné ‒ je zprostředkovatel zpráv. Jeho hlavním cílem je přijímat a odesílat zprávy. Je odpovědný za rozhraní pro odesílání informací, vytváření logických kanálů pro přenos informací uvnitř systému, směrování a vyvažování, stejně jako zpracování selhání na systémové úrovni.
Vyvíjený messaging se neuchází o konkurenci s rabbitmq ani se jej nesnaží nahradit. Jeho hlavní rysy jsou:
- Distribuce.
Bodů výměny lze vytvářet na všech uzlech clusteru, co nejblíže kódu, který je používá. - Jednoduchost.
Zaměření na minimalizaci šablonového kódu a pohodlí použití. - Parádní výkon.
Nepokoušíme se zopakovat funkčnost rabbitmq, ale vyčleňujeme pouze architektonickou a transportní vrstvu, kterou co nejjednodušeji včleňujeme do OTP, a tím minimalizujeme náklady. - Flexibilita.
Každá služba může spojovat řadu vzorů výměny. - Odolnost proti selhání zakotvená v designu.
- Škálovatelnost.
Messaging roste spolu s aplikací. S rostoucím zatížením lze přesunout body výměny na samostatné stroje.
Poznámka. Z hlediska organizace kódu jsou pro složité systémy na Erlang/Elixir vhodné meta-projekty. Všechen kód projektu se nachází v jednom úložišti ‒ umbrella projektu. Přitom jsou mikroslužby maximálně izolované a vykonávají jednoduché operace, které odpovídají samostatné entitě. Při takovém přístupu je snadné udržovat API celého systému, jednoduše provádět změny, a pohodlně psát unit a integrační testy.
Složky systému komunikují přímo nebo prostřednictvím brokera. Z pohledu messagingu má každá služba několik životních fází:
- Inicializace služby.
V této fázi dochází k konfiguraci a spuštění prováděcího procesu služby a jejích závislostí. - Vytvoření výměnného bodu.
Služba může používat statický výměnný bod definovaný v konfiguraci uzlu, nebo může dynamicky vytvářet výměnné body. - Registrace služby.
Aby služba mohla obsluhovat požadavky, je třeba ji registrovat na výměnném bodě. - Normální fungování.
Služba vykonává užitečnou práci. - Ukončení činnosti.
Existují 2 způsoby ukončení činnosti: standardní a havarijní. Při standardním ukončení se služba odpojí od výměnného bodu a zastaví se. V případě havarijních situací messaging provádí jeden z scénářů zpracování poruch.
Vypadá to docela složitě, ale v kódu to není tak špatné. Příklady kódu s komentáři budou uvedeny při rozboru šablon o něco později.
Exchanges
Výměnný bod ‒ proces messaging, který implementuje logiku interakce s komponenty v rámci šablony výměny zpráv. Ve všech příkladech uvedených níže komponenty komunikují prostřednictvím výměnných bodů, jejichž kombinace tvoří messaging.
Šablony výměny zpráv (MEPs)
Globálně lze šablony výměny rozdělit na obousměrné a jednostranné. První předpokládají odpověď na přijatou zprávu, druhé nikoli. Klasickým příkladem obousměrné šablony v architektuře klient-server je šablona Request-response. Podívejme se na šablonu a její modifikace.
Request–response nebo RPC
RPC se používá, když nám potřebujeme získat odpověď od jiného procesu. Tento proces může být spuštěn na stejné uzlu nebo se nacházet na jiném kontinentu. Níže je uveden diagram interakce klienta a serveru prostřednictvím messagingu.
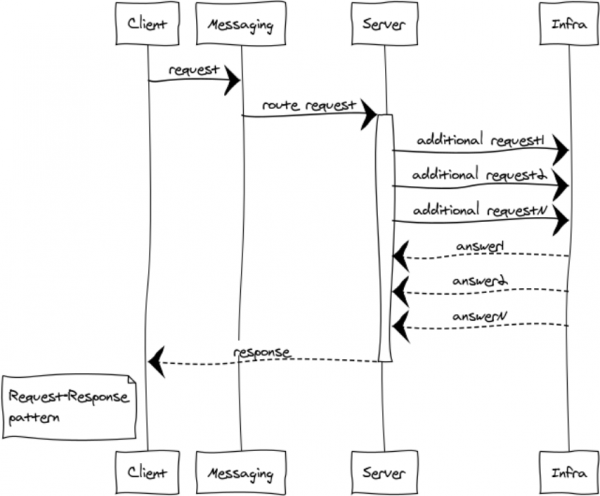
Protože messaging je zcela asynchronní, rozděluje se pro klienta výměna na 2 fáze:
Odeslání požadavku
messaging:request(Exchange, ResponseMatchingTag, RequestDefinition, HandlerProcess).Exchange ‒ unikátní název výměnného bodu
ResponseMatchingTag ‒ lokální značka pro zpracování odpovědi. Například v případě odeslání několika stejných žádostí patřících různým uživatelům.
RequestDefinition ‒ tělo žádosti
HandlerProcess ‒ PID zpracovatele. Tento proces obdrží odpověď od serveru.Zpracování odpovědi
handle_info(#'$msg'{exchange = EXCHANGE, tag = ResponseMatchingTag, message = ResponsePayload}, State)ResponsePayload ‒ odpověď serveru.
Pro server proces také sestává ze 2 fází:
- Inicializace výměnného bodu
- Zpracování příchozích žádostí
Ilustrujeme tento šablonový kód. Předpokládejme, že je třeba realizovat jednoduchou službu, která poskytuje jedinou metodu přesného času.
Kód serveru
Vyjmeme definici API služby do api.hrl:
%% =====================================================
%%  entity
%% =====================================================
-record(time, {
  unixtime :: non_neg_integer(),
  datetime :: binary()
}).

-record(time_error, {
  code :: non_neg_integer(),
  error :: term()
}).

%% =====================================================
%%  metody
%% =====================================================
-record(time_req, {
  opts :: term()
}).
-record(time_resp, {
  result :: #time{} | #time_error{}
}).
Definujeme kontroler služby v time_controller.erl
%% Příklad ukazuje pouze významný kód. Vložením do šablony gen_server můžete získat funkční službu.

%% inicializace gen_server
init(Args) ->
  %% připojení k výměnnému bodu
  messaging:monitor_exchange(req_resp, ?EXCHANGE, default, self())
  {ok, #{}}.

%% zpracování události ztráty spojení s výměnným bodem. Tato událost přichází také, pokud výměnný bod ještě nebyl spuštěn.
handle_info(#exchange_die{exchange = ?EXCHANGE}, State) ->
  erlang:send(self(), monitor_exchange),
  {noreply, State};

%% zpracování API
handle_info(#time_req{opts = _Opts}, State) ->
  messaging:response_once(Client, #time_resp{
result = #time{ unixtime = time_utils:unixtime(now()), datetime = time_utils:iso8601_fmt(now())}
  });
  {noreply, State};

%% ukončení práce gen_server
terminate(_Reason, _State) ->
  messaging:demonitor_exchange(req_resp, ?EXCHANGE, default, self()),
  ok.
Kód klienta
Aby bylo možné odeslat žádost službě, v jakékoli části klienta lze vyvolat API požadavku messaging:
case messaging:request(?EXCHANGE, tag, #time_req{opts = #{}}, self()) of
    ok -> ok;
    _ -> %% opakovat nebo logika selhání
end
V distribuovaném systému může být konfigurace komponent různá a v okamžiku žádosti může messaging ještě nebýt spuštěn, nebo může kontroler služby být připraven obsloužit žádost. Proto je nutné zkontrolovat odpověď messaging a zpracovat případ selhání.
Po úspěšném odeslání klient obdrží od služby odpověď nebo chybu.
Zpracujeme obě situace v handle_info:
handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time{unixtime = Utime}}}, State) ->
  ?debugVal(Utime),
  {noreply, State};

handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time_error{code = ErrorCode}}}, State) ->
  ?debugVal({error, ErrorCode}),
  {noreply, State};
Žádost-Chunked Odpověď
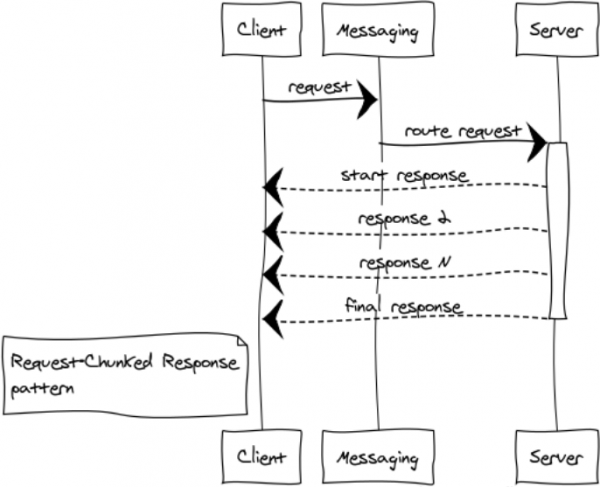
Lepší je zabránit přenosu obrovských zpráv. Na tom závisí reakční doba a stabilní provoz celého systému. Pokud odpověď na požadavek zabírá hodně paměti, rozdělení na části je nezbytné.
Uvedu několik příkladů takových případů:
- Komponenty si vyměňují binární data, například soubory. Rozdělení odpovědi na menší části pomáhá efektivně pracovat se soubory jakékoliv velikosti a vyhnout se přetečení paměti.
- Seznamy. Například potřebujeme vybrat všechny záznamy z obrovské tabulky v databázi a předat je jinému komponentu.
Nazývám takové odpovědi lokomotivou. V každém případě je 1024 zpráv o velikosti 1 MB lepší než jediná zpráva o velikosti 1 GB.
V Erlang clusteru získáváme další výhodu – snížení zátěže na výměnném bodu a síti, protože odpovědi jsou okamžitě směrovány k příjemci, obcházejíc výměnný bod.
Odpověď se žádostí
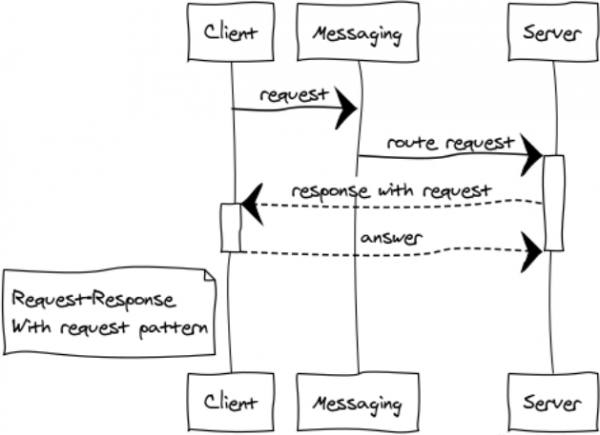
Jedná se o poměrně vzácnou modifikaci vzoru RPC pro vytváření dialogových systémů.
Publish-subscribe (strom pro distribuci dat)
Událostmi řízené systémy dodávají data spotřebitelům, jakmile jsou připravena. Tímto způsobem jsou systémy více nakloněny push modelu než pull nebo poll. Tato vlastnost umožňuje neztrácet zdroje neustálým dotazováním a čekáním na data.
Na obrázku je znázorněn proces distribuce zprávy k spotřebitelům přihlášeným na určité téma.
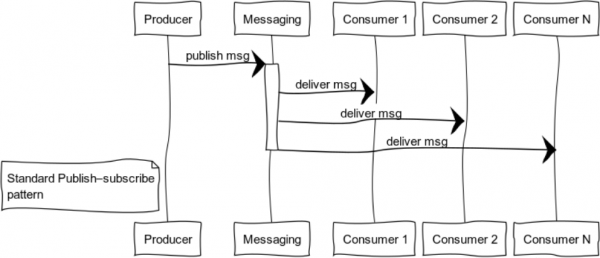
Klasickými příklady použití této šablony je šíření stavu: herního světa v počítačových hrách, tržních údajů na burzách, užitečných informací v datových tocích.
Podívejme se na kód předplatitele:
init(_Args) ->
  %% přihlašujeme se k výměnnému bodu, klíč = key
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {ok, #{}}.

handle_info(#exchange_die{exchange = ?SUBSCRIPTION}, State) ->
  %% pokud je výměnný bod nedostupný, pokusíme se připojit zpět
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {noreply, State};

%% zpracováváme přijaté zprávy
handle_info(#'$msg'{exchange = ?SUBSCRIPTION, message = Msg}, State) ->
  ?debugVal(Msg),
  {noreply, State};

%% při zastavení spotřebitele - odpojujeme se od výměnného bodu
terminate(_Reason, _State) ->
  messaging:unsubscribe(?SUBSCRIPTION, key, tag, self()),
  ok.
Zdroj může spouštět funkci publikace zprávy kdekoli se to hodí:
messaging:publish_message(Exchange, Key, Message).Exchange ‒ název bodu výměny,
Klíč ‒ klíč pro směrování
Zpráva ‒ užitečné zatížení
Inverzní publikování-přihlašování
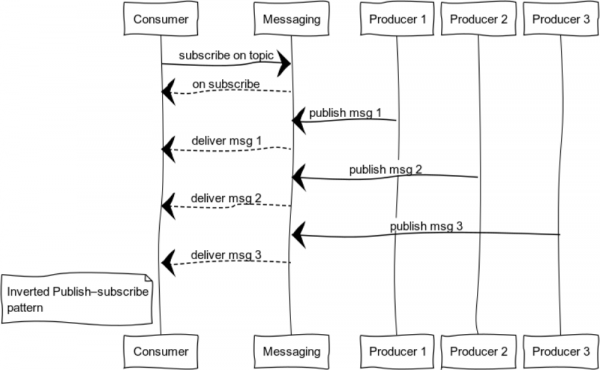
Nasazením pub-sub lze získat vzor vhodný pro logování. Množina zdrojů a spotřebitelů může být zcela odlišná. Na obrázku je uveden případ s jedním spotřebitelem a mnoha zdroji.
Vzorek distribuce úloh
V téměř každém projektu vznikají úkoly odloženého zpracování, jako například generování zpráv, doručování upozornění, získávání dat ze třetích stran. Průchodnost systému, který tyto úkoly vykonává, lze snadno škálovat přidáváním zpracovatelů. Vše, co nám zbývá, je vytvořit cluster zpracovatelů a rovnoměrně rozdělit úkoly mezi nimi.
Pojďme se podívat na vznikající situace na příkladu 3 zpracovatelů. Již ve fázi rozdělování úloh se objevuje otázka spravedlnosti rozdělení a přeplnění zpracovatelů. O spravedlnost se postará rozdělení round-robin, a aby se zabránilo situaci přeplnění zpracovatelů, zavedeme limit prefetch_limit. V přechodných režimech prefetch_limit neumožní jednomu zpracovateli získat všechny úkoly.
Messaging řídí fronty a priority zpracování. Zpracovatelé přijímají úkoly, jakmile přicházejí. Splnění úkolu může skončit úspěchem nebo selháním:
messaging:ack(Tack)‒ je vyvoláno v případě úspěšného zpracování zprávymessaging:nack(Tack)‒ je vyvoláno ve všech nouzových situacích. Po vrácení úkolu messaging předá úkol jinému zpracovateli.
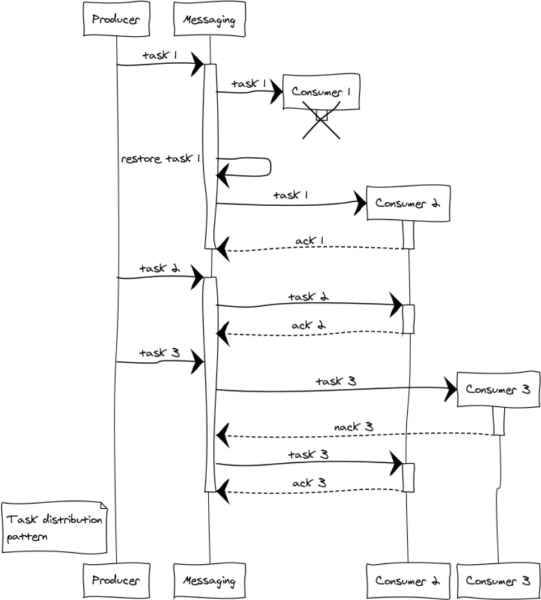
Představme si, že při zpracování tří úkolů došlo k komplikovanému selhání: zpracovatel 1 po přijetí úkolu selhal, aniž by stihl cokoliv nahlásit bodu výměny. V tomto případě bod výměny po uplynutí ack timeout předá úkol jinému zpracovateli. Zpracovatel 3 se z nějakého důvodu vzdal úkolu a poslal nack, nakonec úkol přešel k jinému zpracovateli, který jej úspěšně splnil.
Předběžný výsledek
Probrali jsme hlavní stavební bloky distribuovaných systémů a získali základní porozumění jejich aplikaci v Erlang/Elixir.
Kombinováním základních šablon lze sestavit složité paradigmata pro řešení vznikajících úkolů.
V závěrečné části cyklu se podíváme na obecné otázky organizace služeb, směrování a vyvažování zátěže, a také se zaměříme na praktickou stránku škálovatelnosti a odolnosti systémů.
Konec druhé části.
Foto
Ilustrace připraveny pomocí websequencediagrams.com
Zdroj: habr.com
