

V našich projektech používáme mikroservisní architekturu. Když nastanou úzká místa v výkonu, strávíme hodně času sledováním a analýzou logů. Při logování časování jednotlivých operací je obvykle obtížné pochopit, co vedlo k vyvolání těchto operací, sledovat posloupnost akcí nebo zpoždění jedné operace vůči jiné v různých službách.
Abychom minimalizovali ruční práci, rozhodli jsme se využít jeden z nástrojů pro trasování. O tom, jak a proč lze trasování používat a jak jsme s tím pracovali, bude tato článek.
Jaké problémy lze vyřešit pomocí trasování
- Najít úzká místa v výkonu jak uvnitř jedné služby, tak v celém stromě provádění mezi všemi zúčastněnými službami. Například:
- Mnoho krátkých sekvenčních volání mezi službami, například pro geokódování nebo dotazy na databázi.
- Dlouhá čekání na vstup a výstup, například přenos dat přes síť nebo čtení z disku.
- Dlouhé zpracovávání dat.
- Dlouhé operace, které vyžadují CPU.
- Úseky kódu, které nejsou potřebné pro dosažení konečného výsledku a mohou být odstraněny nebo spuštěny později.
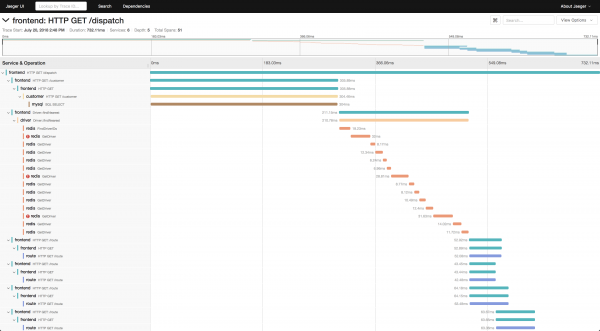
- Zřetelně pochopit, v jakém pořadí je co voláno a co se děje, když se provádí operace.

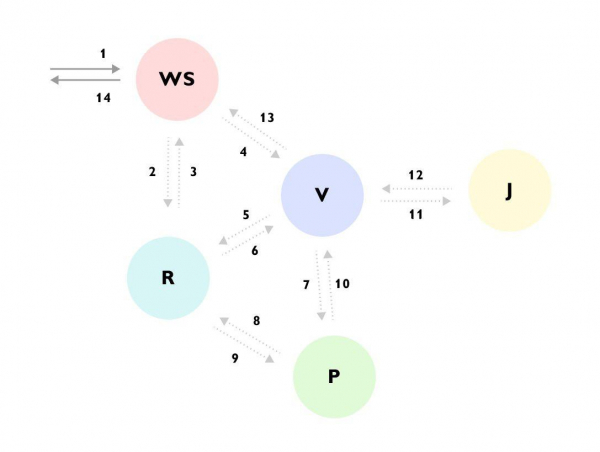
Je vidět, že například požadavek přišel do služby WS -> služba WS doplnila data přes službu R -> dále poslala požadavek do služby V -> služba V načetla mnoho dat ze služby R -> zašla do služby P -> služba P znovu zašla do služby R -> služba V ignorovala výsledek a šla do služby J -> a až poté vrátila odpověď do služby WS, přičemž stále v pozadí počítala něco dalšího.
Bez takového traisu nebo podrobné dokumentace o celém procesu je velmi obtížné pochopit, co se děje, když se poprvé podíváte na kód, a navíc je kód rozptýlen po různých službách a skryt za spoustou binárních souborů a rozhraní. - Shromáždění informací o stromu provádění pro následnou analýzu. Na každém kroku provádění lze do traisu přidat informace, které jsou k dispozici v tomto kroku, a dále rozluštit, jaké vstupní údaje vedly k podobnému scénáři. Například:
- ID uživatele
- Práva
- Typ vybrané metody
- Log nebo chyba provádění
- Transformace tras na podmnožinu metrik a jejich následná analýza již ve formě metrik.
Co dokáže logovat trasování. Span
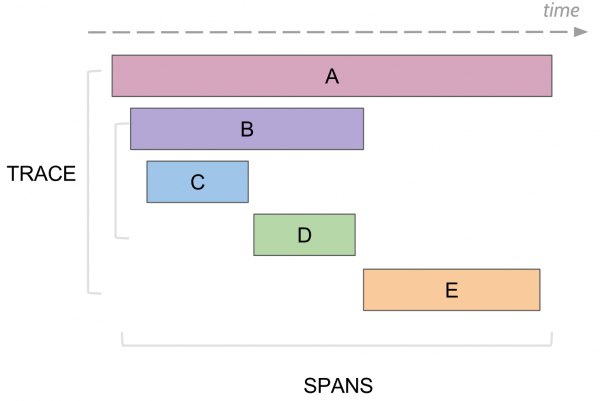
V trasování existuje pojem span, což je ekvivalent jednoho logu v konzoli. Span má:
- Název, obvykle to je název metody, která byla vykonána
- Název služby, ve které byl span generován
- Vlastní unikátní ID
- Nějaké meta informace ve formátu key/value, které byly do něj zalogovány. Například parametry metody nebo zda metoda skončila chybou či nikoli
- Čas začátku a konce vykonávání tohoto spanu
- ID rodičovského spanu
Každý span je odesílán do collection spánů pro uložení do databáze pro další prohlížení, jakmile dokončí své vykonání. Poté lze sestavit strom všech spanů propojením podle ID rodiče. Při analýze lze například najít všechny spany v nějaké službě, které trvaly déle než nějaký čas. Dále, když přejdete na konkrétní span, uvidíte celé nadřazené a podřazené stromové struktury tohoto spanu.
Opentrace, Jaeger a jak jsme to implementovali pro své projekty
Existuje obecný standard , který popisuje, jak a co by mělo být shromažďováno, bez vazby trasování na konkrétní implementaci v jakémkoli jazyce. Například v Javě se veškerá práce s trasami provádí prostřednictvím obecného API Opentrace, a pod ním může být skryto například Jaeger nebo prázdná výchozí implementace, která nic nedělá.
Používáme jako implementaci Opentrace. Skládá se z několika komponentů:
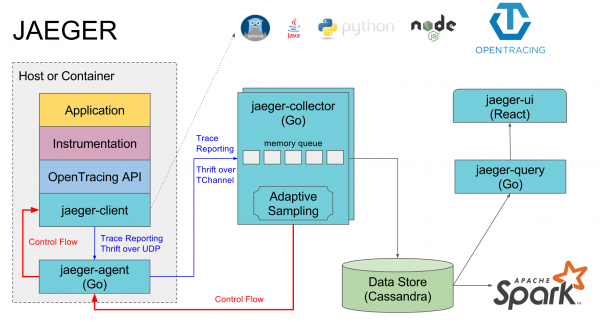
- Jaeger-agent — místní agent, který obvykle běží na každém stroji a do něj logují služby na místní výchozí port. Pokud agent není, obvykle jsou všechny trasy všech služeb na tomto stroji vypnuty.
- Jaeger-collector — do něj všechny agenty posílají shromážděné trasy, a on je ukládá do vybrané databáze
- Databáze — preferovaná je u nich Cassandra, ale my používáme Elasticsearch, existují implementace i pro další databáze a realizace v paměti, která nic neukládá na disk.
- Jaeger-query — to je služba, která se připojuje k databázi a vrací již shromážděné trasy pro analýzu.
- Jaeger-ui — to je webové rozhraní pro vyhledávání a prohlížení tras, které se připojuje k jaeger-query.
Samostatnou komponentou lze nazvat implementaci opentrace jaeger pro konkrétní jazyky, přes kterou jsou spany odesílány do jaeger-agent.
to se týká implementace rozhraní io.opentracing.Tracer, po které všechny stopy projdou reálním agentem.
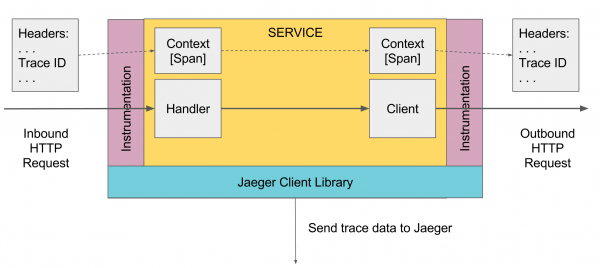
Také pro komponenty Springu lze připojit a implementaci od Jaegera která automaticky nakonfiguruje sledování na všechno, co prochází těmito komponentami, například HTTP požadavky v kontrolerech, dotazy k databázi přes JDBC atd.
Logování stop v Javě
Někde na nejvyšší úrovni by měl být vytvořen první Span, což může být provedeno automaticky například kontrolerem Springu při přijetí požadavku, nebo ručně, pokud takový neexistuje. Dále je předáván přes Scope níže. Pokud nějaká metoda níže chce přidat Span, vezme z Scope aktuální activeSpan, vytvoří nový Span a řekne, že jeho rodičem je aktuálně přijatý activeSpan, a učiní nový Span aktivní. Při volání externích služeb je jim předáván aktuální aktivní span a tyto služby vytvářejí nové spany s vazbou na tento span.
Veškerá práce probíhá prostřednictvím instance Tracer, kterou lze získat přes mechanismus DI, nebo GlobalTracer.get() jako globální proměnnou, pokud mechanismus DI nefunguje. Ve výchozím stavu, pokud tracer nebyl inicializován, se vrátí NoopTracer, který nic nedělá.
Dále se z traceru pomocí ScopeManagera vybere aktuální scope, vytváří se nový scope od aktuálního s vazbou nového spanu, a následně se uzavírá vytvořený Scope, který uzavírá vytvořený span a vrací do aktivního stavu předchozí Scope. Scope je vázán na vlákno, proto při vícetématickém programování je třeba nezapomínat předávat aktivní span do jiného vlákna, pro další aktivaci Scope jiného vlákna s vazbou na tento span.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Dělat věci.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // KROK 2 VÝŠE: znovu aktivovat Span v callbacku, předávání true do
            // startActive(), pokud/kdyby měl být Span dokončen.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
Pro vícevláknové programování existuje také TracedExecutorService a podobné obálky, které automaticky přenášejí aktuální span do vlákna při spuštění asynchronních úloh:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Pro externí http požadavky existuje
HttpClient httpClient = new TracingHttpClientBuilder().build();Problémy, se kterými jsme se setkali
- Beany a DI nefungují vždy, pokud se tracer používá ne v servisu nebo komponentě, poté Tracer nemusí fungovat a bude nutné použít GlobalTracer.get().
- Nemají funkční anotace, pokud to není komponenta nebo služba, nebo pokud je volání metody prováděno z vedlejší metody téhož třídy. Je třeba být opatrný, kontrolovat co funguje, a použít ruční vytvoření trace, pokud @Traced nefunguje. Také lze přidat další kompilátor pro java anotace, pak by měly fungovat všude.
- Ve starých spring a spring boot nefunguje automatická konfigurace opentracing spring cloud kvůli chybám v DI, proto pokud chcete, aby trace fungovaly automaticky v komponentách springu, můžete to udělat podle vzoru s
- V groovy nefunguje try with resources, je třeba vždy použít try finally.
- Každý servis musí mít uvedeno své spring.application.name, pod kterým budou logovány trace. A to navíc zvláštní name pro produkci a test, aby se nemíchaly dohromady.
- Pokud použijete GlobalTracer a tomcat, všechny služby spuštěné v tomto tomcatu mají jeden GlobalTracer, proto budou mít všechny stejné jméno služby.
- Při přidání trace do metody je třeba se ujistit, že není volána v cyklu mnohokrát. Je třeba přidat jeden společný trace na všechny volání, který zachytí celkový čas běhu. Jinak dojde k přetížení.
- Jednou jsme v jaeger-ui provedli příliš velké požadavky na velké množství trace a protože jsme nečekali na odpověď, udělali jsme to znovu. Nakonec jaeger-query začal konzumovat hodně paměti a zpomalil elastik. Pomohlo restartování jaeger-query.
Vzorkování, ukládání a prohlížení trace
Existují tři typy :
- Const, který odesílá a ukládá všechny trace.
- Probabilistic, který filtruje trace s nějakou zadanou pravděpodobností.
- Ratelimiting, který omezuje počet tracerů za sekundu. Tyto parametry lze nastavit na klientovi, buď na jaeger-agent nebo v kolektoru. V současnosti máme v našem stacku validátorů používáno const 1, protože požadavků není příliš mnoho, ale trvají výrazně dlouho. Do budoucna, pokud to způsobí nadměrné zatížení systému, lze to omezit.
Pokud používáte Cassandru, tak ve výchozím nastavení ukládá trace pouze po dobu dvou dnů. Používáme a trace se ukládají na neurčito a nemažou se. Každý den se vytváří samostatný index, například jaeger-service-2019-03-04. Do budoucna je třeba nastavit automatické čištění starých trace.
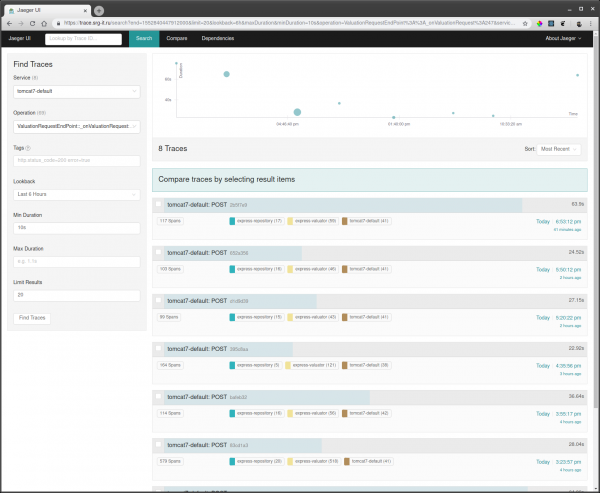
Aby bylo možné zobrazit trace, je třeba:
- Vybrat službu, podle které chcete filtr pomoct s trace, například tomcat7-default pro službu, která běží v Tomcatu a nemůže mít vlastní název.
- Dále vybrat operaci, časový interval a minimální čas operace, například od 10 sekund, aby se vzaly pouze dlouhé provádění.

- Přejít na jeden z trace a podívat se, co tam zpomalovalo.

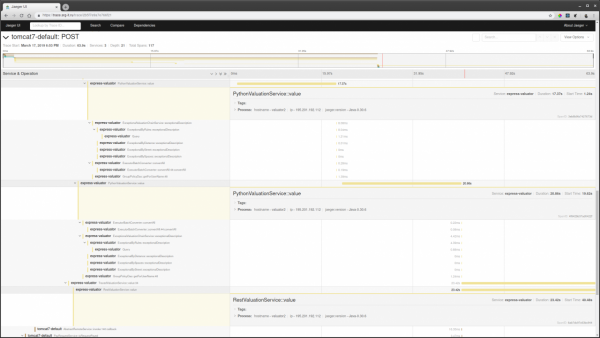
Také pokud znáte nějaké ID žádosti, můžete najít trace podle tohoto ID přes vyhledávání podle tagů, pokud je toto ID logováno ve span trace.
Dokumentace
- Dokumentace OpenTracing
- Dokumentace Jaeger
- Připojení Jaeger Java
- Připojení Spring OpenTracing
Články
- Jaeger OpenTracing a mikroslužby v reálném projektu na PHP a Golang
- Evolving Distributed Tracing at Uber Engineering
- Spuštění Jaeger Agenta na bare metal
Video
- Jak jsme použili Jaeger a Prometheus k dodání bleskurychlých uživatelských dotazů — Bryan Boreham
- Úvod: Jaeger — Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, “Malý příběh velkého vítězství: OpenTracing, AWS a Jaeger”
Zdroj: habr.com
