

Jmenuji se Anton Baderin. Pracuji v Centru vysokých technologií a zabývám se systémovým administrativou. Před měsícem skončila naše firemní konference, kde jsme sdíleli nabyté zkušenosti s IT komunitou našeho města. Mluvil jsem o monitorování webových aplikací. Materiál byl určen pro úroveň junior nebo middle, kteří ještě nebudovali tento proces od základu.
Základní kámen, na kterém stojí jakýkoli systém monitorování, je řešení obchodních problémů. Monitorování pro samotné monitorování nikoho nezajímá. Co chce byznys? Aby vše fungovalo rychle a bez chyb. Byznys chce proaktivitu, aby jsme sami odhalovali problémy v práci služby a maximálně rychle je odstraňovali. To jsou v podstatě úkoly, které jsem řešil celý minulý rok na projektu jednoho z našich klientů.
O projektu
Projekt je jedním z největších programů loajality v zemi. Pomáháme maloobchodním sítím zvyšovat frekvenci prodeje za pomoci různých marketingových nástrojů, jako jsou bonusové karty. Celkem projekt zahrnuje 14 aplikací, které běží na deseti serverech.
Při vedení pohovorů jsem opakovaně zaznamenal, že administrátoři často nepřistupují správně k monitorování webových aplikací: stále mnozí zastavují na metrikách operačního systému a jen občas monitorují služby.
V mém případě dříve na systému monitorování klienta ležela Icinga. Ta nijak neřešila výše zmíněné úkoly. Klient nám často sám hlásil problémy a nejednou nám prostě chyběla data, abychom se dostali k příčině.
Kromě toho bylo jasné, že její další rozvoj je bezperspektivní. Myslím, že ti, kdo znají Icingu, mě pochopí. Takže jsme se rozhodli kompletně přepracovat systém monitorování webových aplikací v projektu.
Prometheus
Vybrali jsme Prometheus na základě tří hlavních ukazatelů:
- Obrovské množství dostupných metrik. V našem případě je jich 60 tisíc. Samozřejmě, stojí za zmínku, že převážná většina z nich není využívána (asi 95 %). Na druhou stranu, všechny jsou relativně levné. Pro nás je to druhý extrém ve srovnání s dříve používaným Icinga. Přidávání metrik v ní bylo zvlášť bolestivé: existující vyžadovaly vysoké náklady (stačí se podívat na zdrojové kódy jakéhokoli pluginu). Každý plugin představoval skript v Bash nebo Pythonu, jehož spuštění není levné z hlediska spotřebovaných zdrojů.
- Tento systém spotřebovává relativně malé množství zdrojů. Na všechny naše metriky stačí 600 MB operační paměti, 15 % jednoho jádra a pár desítek IOPS. Samozřejmě, musíme spouštět exportéry metrik, ale všechny jsou napsány v Go a také se nevyznačují velkou náročností. Nemyslím, že by to v dnešních reáliích představovalo problém.
- Umožňuje přechod na Kubernetes. Vzhledem k plánům zákazníka je výběr zřejmý.
ELK
Dříve jsme logy nesbírali a nezpracovávali. Nedostatky jsou všem jasné. Vybrali jsme ELK, protože jsme již měli zkušenosti s tímto systémem. Uchováváme tam pouze logy aplikací. Hlavními kriterii výběru byly fulltextové vyhledávání a jeho rychlost.
Clickhouse
Původně jsme se rozhodli pro InfluxDB. Uvědomovali jsme si potřebu sbírat logy Nginx, statistiky z pg_stat_statements a uchovávat historická data Promethea. Influx nás neoslovil, protože občas začal spotřebovávat velké množství paměti a padal. Navíc jsme chtěli seskupovat dotazy podle remote_addr, ale seskupování v této DB je možné pouze podle tagů. Tagy jsou drahé (paměť), jejich počet je podmíněně omezen.
Znovu jsme začali hledat. Potřebovali jsme analytickou databázi s minimální spotřebou zdrojů, ideálně se stlačením dat na disku.
Clickhouse splňuje všechna tato kritéria, a nikdy jsme nelitovali výběru. Nepisujeme do něj žádné zásadní objemy dat (počet vložení je pouze kolem pěti tisíc za minutu).
NewRelic
NewRelic byl historicky s námi, protože to byla volba zákazníka. Používáme ho jako APM.
Zabbix
Zabbix využíváme výhradně pro monitorování Black Box různých API.
Definování přístupu k monitorování
Chtěli jsme úkol dekomponovat a tím systematizovat přístup k monitorování.
Pro tento účel jsem naši systém rozčlenil na následující úrovně:
- „hardware“ a VMS;
- operační systém;
- systémové služby, softwarový stack;
- aplikace;
- obchodní logika.
Což je výhodné:
- víme, kdo je odpovědný za funkci každé z úrovní a na základě toho můžeme posílat upozornění;
- můžeme použít strukturu při potlačování upozornění — bylo by podivné posílat upozornění o nedostupnosti databáze, když je celá virtuální stroj nedostupný.
Jelikož je naším úkolem odhalovat poruchy v systému, musíme na každé úrovni určit určitý soubor metrik, na které bychom se měli zaměřit při tvorbě pravidel pro upozornění. Dále se podíváme na úrovně „VMS“, „Operační systém“ a „Systémové služby, softwarový stack“.
Virtuální stroje
Hosting vymezuje nám procesor, disk, paměť a síť. A s prvními dvěma jsme měli problémy. Takže, metriky:
CPU stolen time — když si kupujete virtuální stroj na Amazonu (např. t2.micro), měli byste pochopit, že vám není přiděleno celé jádro procesoru, ale pouze kvóta jeho času. A když tuto kvótu vyčerpáte, procesor vám začne odebírat.
Tato metrika umožňuje sledovat takové chvíle a přijímat rozhodnutí. Například, jestli se vyplatí přejít na dražší tarif, nebo rozložit zpracování pozadových úloh a API dotazů na různé serveru.
IOPS + CPU iowait time — z nějakého důvodu mnoho cloudových hostingů trpí tím, že nedostatečně poskytují IOPS. Navíc, graf s nízkými IOPS pro ně není argumentem. Proto je dobré sbírat také CPU iowait. S touto dvojicí grafů — s nízkými IOPS a vysokým čekáním na vstup/výstup — je možné vést diskusi s hostingem a řešit problém.
Operační systém
Metriky operačního systému:
- celkové dostupné paměti v %;
- aktivity využívání swapu: vmstat swapin, swapout;
- počet dostupných inode a volného místa na souborovém systému v %;
- průměrné zatížení;
- počet připojení ve stavu tw;
- zatížení tabulky conntrack;
- kvalitu práce sítě je možné monitorovat pomocí utilit ss, balíku iproute2 — získat z jeho výstupu ukazatele RTT připojení a seskupovat je podle cílového portu.
Také na úrovni operačního systému máme entitu jako procesy. Je důležité určit v systému sadu procesů, které hrají důležitou roli v jeho fungování. Pokud máte například několik pgpool, je nutné sbírat informace o každém z nich.
Sada metrik je následující:
- CPU;
- paměť — především rezidentní;
- IO — ideálně v IOPS;
- FileFd — otevřené a limit;
- významné selhání stránky — tak zjistíte, který proces swapuje.
Celé monitorování máme nasazené v Dockeru, pro sběr metrik používáme Cadvisor. Na ostatních strojích používáme process-exporter.
Systémové služby, stack SW
Každá aplikace má svou specifičnost a je těžké vybrat nějakou sadu metrik.
Univerzální sadou jsou:
- míra dotazů;
- počet chyb;
- latence;
- saturace.
Nejvýznamnější příklady monitorování této úrovně u nás jsou — Nginx a PostgreSQL.
Nejvíce zatížená služba v našem systému — databáze. Dříve jsme měli poměrně často problémy s tím, abychom zjistili, co databáze dělá.
Viděli jsme vysokou zátěž na discích, ale slowlogy nic pořádného neukazovaly. Tento problém jsme vyřešili pomocí pg_stat_statements, pohledu, ve kterém se shromažďují statistiky o dotazech.
To je vše, co potřebuje administrátor.
Stavíme grafy aktivity dotazů na čtení a zápis:
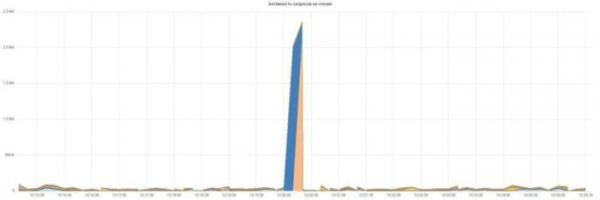
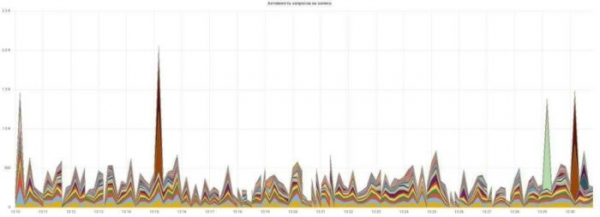
Vše je jednoduché a přehledné, každému dotazu — svou barvu.
Nejméně jasný příklad — Nginx logy. Není překvapením, že je málo kdo parsuje nebo zmiňuje v seznamu povinných. Standardní formát není příliš informativní a je potřeba ho rozšířit.
Osobně jsem přidal request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Stavíme grafy doby odezvy a počtu chyb:
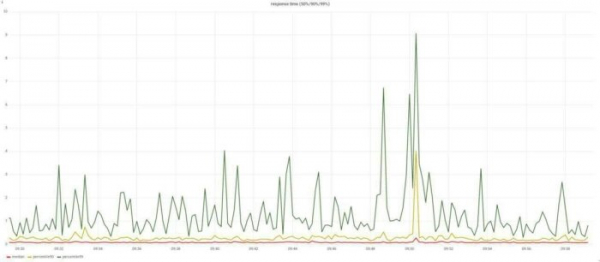
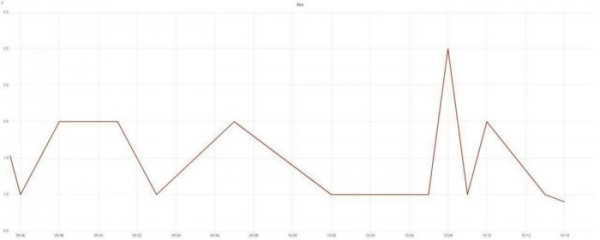
Stavíme grafy doby odezvy a počtu chyb. Pamatujete? Mluvil jsem o úkolech pro podnikání? Aby bylo všechno rychle a bez chyb? Už dvěma grafy jsme tyto otázky uzavřeli. A podle nich už můžeme volat pohotovostním administrátorům.
Ale zůstává ještě jeden problém — zajistit rychlé odstranění příčin incidentu.
Odstranění incidentů
Celý proces od zjištění až po řešení problému lze rozdělit na několik kroků:
- zjištění problému;
- oznámení pohotovostnímu administrátorovi;
- reakce na incident;
- odstranění příčin.
Je důležité, že to musíme dělat co nejrychleji. A pokud v etapách zjištění problému a odesílání oznámení nemáme moc času na zisk — dvě minuty na ně v každém případě uběhnou, pak následující — jsou prostě neorané pole pro zlepšení.
Představme si, že u operátora zazvonil telefon. Co udělá? Hledá odpovědi na otázky — co se pokazilo, kde se to pokazilo, jak reagovat? Takhle odpovídáme na tyto otázky:
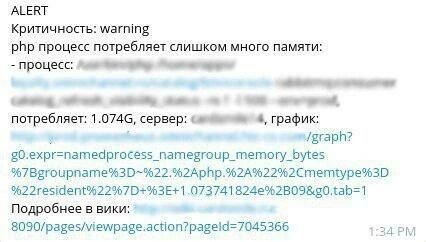
Celou tuto informaci jednoduše zahrneme do textu oznámení, přidáme odkaz na stránku ve wiki, kde je popsáno, jak na tento problém reagovat, jak ho řešit a eskalovat.
Dosud jsem nic neřekl o úrovni aplikace a obchodní logice. Bohužel, v našich aplikacích zatím není implementováno shromažďování metrik. Jediným zdrojem alespoň nějakých informací z těchto úrovní jsou logy.
Pár bodů.
Za prvé, pište strukturované logy. Není třeba zahrnovat kontext do textu zprávy. Ztěžuje to jejich seskupování a analýzu. Logstash potřebuje mnoho času na to, aby to všechno normalizoval.
Za druhé, správně používejte úrovně závažnosti. Každý jazyk má svůj vlastní standard. Osobně rozlišuji čtyři úrovně:
- žádná chyba;
- chyba na straně klienta;
- chyba na naší straně, neztrácíme peníze, neneseme rizika;
- chyba na naší straně, ztrácíme peníze.
Shrňme to. Měli bychom se snažit vybudovat monitoring právě od obchodní logiky. Snažit se monitorovat samotnou aplikaci a operovat takovými metrikami, jako je počet prodejů, počet nových registrací uživatelů, počet aktivních uživatelů v daném okamžiku a tak dále.
Pokud je celý váš byznys jedním tlačítkem v prohlížeči, je třeba sledovat, zda je stisknuto, zda funguje správně. Všechno ostatní není důležité.
Pokud to nemáte, můžete se to snažit dohnat v logách aplikace, Nginx logách atd., jak jsme to udělali my. Musíte být co nejblíže aplikaci.
Metriky operačního systému jsou samozřejmě důležité, ale byznysu nejsou zajímavé, neplatí nám za ně.
Zdroj: habr.com
