

Proč je důležité dělat zálohy? Vždyť hardware je velmi spolehlivý a navíc existují „cloudy“, které jsou spolehlivější než fyzické servery: při správném nastavení „cloudový“ server snadno přežije selhání fyzického infrastrukturního serveru, a z pohledu uživatelů služeb dojde k nepatrnému, téměř nepostřehnutelnému nárůstu doby zpracování. Navíc duplikace informací často vyžaduje zaplatit za „nadbytečný“ procesorový čas, diskovou zátěž a síťový provoz.
Ideální program rychle pracuje, nezatěžuje operační paměť, nemá chyby a neexistuje.
—Neznámý
Protože programy stále píší lidský vývojáři a proces testování často chybí, navíc se dodávka programů velmi zřídka provádí za použití „best practices“ (které jsou samy o sobě také programy, a tudíž nejsou dokonalé), systémovým administrátorům často přichází řešit úkoly, které zní stručně, ale výstižně: „vrátit zpět, jak to bylo“, „dostat databázi do normálního stavu“, „funguje pomalu—vrátíme to zpět“ a také můj oblíbený „nevím co, ale oprav“.
Kromě logických chyb, které se objevují v důsledku nepečlivé práce vývojářů nebo souhrou okolností, a také neúplného pochopení nebo znalostí drobných aspektů vývoje programů — včetně vazebních a systémových, jako jsou operační systémy, ovladače a firmware — existují také jiné chyby. Například většina vývojářů se spoléhá na runtime, zcela zapomínaje na fyzikální zákony, které nelze obcházet pomocí programů. To zahrnuje bezmezné spolehlivosti diskového subsystému a jakéhokoli systému pro ukládání dat (včetně operační paměti a procesorové cache!), nulový čas zpracování na procesoru, a absence chyb při přenosu po síti a při zpracování na procesoru, a zpoždění sítě, které jsou rovny 0. Není dobré podceňovat ani proslulý termín dodání, protože pokud se nedodrží — budou problémy mnohem víc než jemnosti práce sítě a disku.
Jak si poradit s problémy, které se naskytují a visí nad cennými daty? Živé vývojáře nelze nahradit a není jisté, že to bude možné v blízké době. Na druhou stranu plně prokázat, že program bude fungovat tak, jak bylo zamýšleno, se podařilo pouze několika projektům, a rozhodně nebude vždy možné vzít a použít důkazy na jiné podobné projekty. Takové důkazy navíc zabírají spoustu času a vyžadují specifické dovednosti a znalosti, což prakticky minimalizuje možnost jejich použití s ohledem na termíny. Kromě toho ještě neumíme vytvořit superrychlé, levné a nekonečně spolehlivé technologie pro ukládání, zpracování a přenos informací. Takové technologie, pokud vůbec existují, jsou většinou v podobě konceptů nebo — častěji — pouze ve fantastických knihách a filmech.
Dobří umělci kopírují, velcí umělci kradou.
—Pablo Picasso.
Ty nejúspěšnější řešení a překvapivě jednoduché věci obvykle vznikají tam, kde se setkávají na první pohled naprosto neslučitelné pojmy, technologie, znalosti a oblasti vědy.
Například ptáci a letadla mají křídla, přestože i přes funkční podobnost — v některých režimech se principy shodují a technické problémy se řeší podobně: duté kosti, použití pevných a lehkých materiálů atd. — výsledky jsou naprosto odlišné, i když velmi podobné. Nejlepší vzory, které pozorujeme v naší technologii, jsou také většinou převzaty z přírody: hermetické prostory u lodí a ponorek — přímá analogie s kroužkovými červy; stavba raid-masivů a kontrola integrity dat — duplicita DNA řetězce; a také párové orgány, nezávislost práce různých orgánů na CNS (automatika práce srdce) a reflexy — autonomní systémy na internetu. Samozřejmě brát a aplikovat hotová řešení „z fleku“ je zrádné, ale kdo ví, možná jiná řešení ani neexistují.
Kdybych jen věděl, kde spadnu — podložil bych si slámu!
—Běloruské lidové přísloví
Takže zálohy jsou životně nezbytné pro ty, kdo chtějí:
- Mít možnost obnovit chod svých systémů s minimálními prostoji, a klidně i bez nich.
- Jednejte odvážně, protože v případě chyby je vždy možnost vrátit se zpět.
- Minimalizovat následky úmyslného poškození dat.
Zde je trochu teorie.
Jakákoliv klasifikace je libovolná. Příroda nekategoruje. Kategorizujeme my, protože nám to usnadňuje práci. A klasifikujeme podle údajů, které rovněž volíme libovolně.
—Jean Bruyère
Bez ohledu na fyzický způsob uchování lze logické ukládání dat naprosto zjednodušeně rozdělit na 2 způsoby přístupu k těmto datům: blokový a souborový. Toto rozdělení je v poslední době velmi nejasné, protože čistě bloková i čistě souborová logická úložiště neexistují. Nicméně pro jednodušší představu budeme předpokládat, že existují.
Blokové ukládání dat znamená, že existuje fyzické zařízení, na které se ukládají data v určitých pevných porcích, blocích. Přístup k blokům probíhá na základě určité adresy, každý blok má svůj vlastní adresu v rámci zařízení.
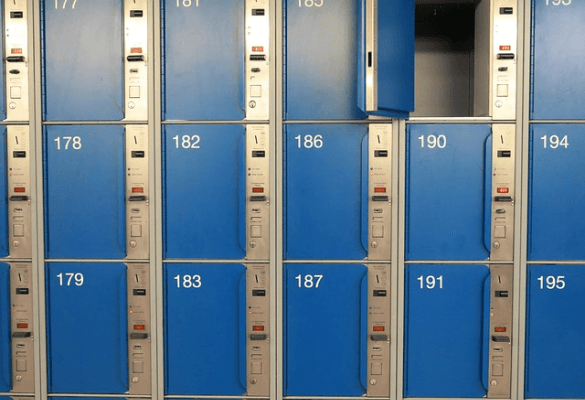
Záloha se obvykle provádí kopírováním bloků dat. Aby byla zajištěna integrita dat v okamžiku kopírování, je pozastaveno zapisování nových bloků a také změna stávajících. Pokud použijeme analogii z běžného světa — nejblíže je to skříň s identicky číslovanými přihrádkami.
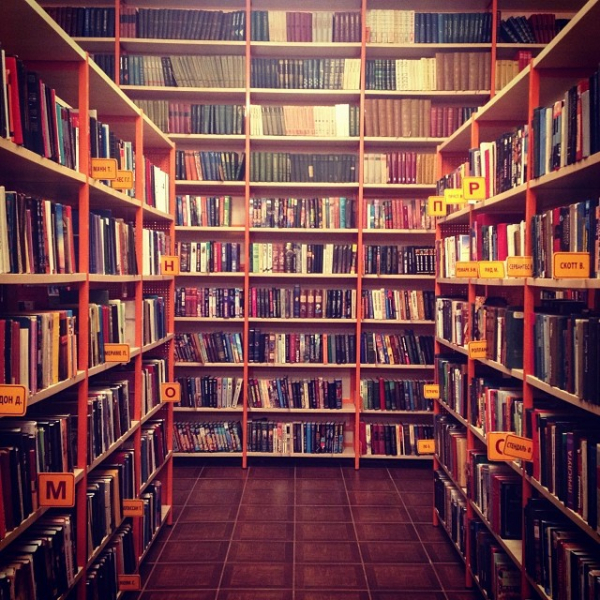
Souborové ukládání dat na principu logického zařízení je blízké blokovému a často se organizuje nad ním. Hlavní rozdíly spočívají v existenci hierarchie ukládání a lidsky čitelných názvech. Vytváří se abstrakce ve formě souboru — pojmenované oblasti dat, a také adresáře — speciálního souboru, ve kterém se uchovávají popisy a přístupy k dalším souborům. Soubory mohou být doplněny o další metadata: čas vytvoření, přístupové vlajky atd. Zálohování obvykle probíhá takto: hledají se změněné soubory, které se poté kopírují do jiného, strukturovaně podobného souborového úložiště. Integrita dat se obvykle zajišťuje tím, že neexistují soubory, do kterých se zapisuje. Metadata souborů se zálohují podobně. Nejlepší analogie — knihovna, ve které existují sekce s různými knihami a také katalog s lidsky čitelnými názvy knih.
V poslední době se občas popisuje další varianta, od které v podstatě začalo souborové ukládání dat a která má stejné archaické rysy: objektové ukládání dat.
Na souborovém úložišti se liší tím, že nemá více než jedno vnoření (ploché schéma), a i když jsou názvy souborů lidště čitelné, jsou přesto více přizpůsobeny pro strojové zpracování. Při zálohování se objektová úložiště většinou zpracovávají podobně jako souborová, ale občas existují i jiné varianty.
— Existují dva druhy systémových administrátorů: ti, kteří nedělají zálohy, a ti, kteří JIŽ dělají.
— Ve skutečnosti existují tři druhy: jsou ještě ti, kteří kontrolují, že zálohy lze obnovit.—Neznámý
Je také důležité rozumět tomu, že samotný proces zálohování dat je řízen programy, takže má všechny stejné nevýhody jako jiný program. Abychom se zbavili (ne vyloučili!) závislosti na lidském faktoru, stejně jako zvláštnostech – které jednotlivě nemusí mít velký vliv, ale dohromady mohou mít výrazný efekt – používá se takzvané pravidlo 3-2-1. Existuje mnoho variant, jak to vyložit, ale mně se více líbí následující výklad: je třeba uchovávat 3 sady stejných dat, 2 sady je třeba uchovávat v různých formátech a také 1 sada musí být na geograficky vzdáleném úložišti.
Pod formátem ukládání se rozumí následující:
- Pokud existuje závislost na fyzickém způsobu ukládání — změníme fyzický způsob.
- Pokud existuje závislost na logickém způsobu ukládání — změníme logický způsob.
Pro dosažení maximálního efektu pravidla 3-2-1 se doporučuje měnit formát ukládání oběma způsoby.
Z hlediska připravenosti zálohy pro její přímý účel — obnovení funkčnosti — se rozlišují „horké“ a „chladné“ zálohy. Horké se od chladných liší pouze jedním: jsou okamžitě připraveny k použití, zatímco chladné pro obnovení vyžadují některé další akce: dešifrování, extrakci z archivu atd.
Není dobré zaměňovat horké a studené kopie s online a offline kopiemi, které znamenají fyzickou izolaci dat, a v podstatě představují jiný způsob klasifikace zálohovacích metod. Offline kopie – která není přímo připojena k systému, ze kterého má být obnovena – může být jak horká, tak studená (z pohledu připravenosti k obnovení). Online kopie může být dostupná přímo tam, kde má být obnovena, a často bývá horká, avšak mohou existovat i studené kopie.
Kromě toho nesmíme zapomínat, že samotný proces vytváření záloh obvykle nekončí vytvořením jedné zálohy, ale záloh může být poměrně velký počet. Proto je třeba rozlišovat mezi úplnými zálohami, tedy těmi, které lze obnovit nezávisle na ostatních zálohách, a také mezi rozdílovými (inkrementálními, diferenčními, dekrementálními atd.) kopiemi – tedy těmi, které nelze obnovit samostatně a vyžadují předchozí obnovu jedné nebo několika dalších záloh.
Rozdílové inkrementální kopie jsou pokusem ušetřit místo pro ukládání záloh. Takže do zálohy se zapisují pouze změněná data od poslední zálohy.
Rozdílové dekrementální kopie se vytvářejí se stejným cílem, ale trochu jiným způsobem: vytvoří se úplná záloha, ale ve skutečnosti se uchovává pouze rozdíl mezi aktuální kopií a předchozí.
Separátně je třeba zvážit proces zálohování nad úložištěm, které podporuje absenci duplicitního ukládání. Takže pokud se nad ním píší úplné zálohy, ve skutečnosti se zapíše pouze rozdíl mezi zálohami, avšak proces obnovy záloh proběhne obdobně jako obnovování z úplné kopie a zcela transparentně.
Quis custodiet ipsos custodes?
(Kdo stráží strážce? — lat.)
Je velmi nepříjemné, když zálohy chybí, avšak mnohem horší je, pokud je záloha sice provedena, ale při obnově se zjistí, že nelze obnovit, protože:
- Integrita původních dat byla porušena.
- Úložiště se zálohami je poškozeno.
- Obnova probíhá poměrně pomalu, nelze používat data, která byla částečně obnovena.
Správně nastavený proces zálohování by měl brát v úvahu podobné poznámky, zejména první dvě.
Integritu původních dat lze zaručit několika způsoby. Nejčastěji se používají následující: a) tvorba snímků souborového systému na úrovni bloků, b) 'zmrazení' stavu souborového systému, c) speciální blokové zařízení s ukládáním verzí, d) sekvenční zápis souborů nebo bloků. Také se používají kontrolní součty pro zajištění kontroly dat při obnově.
Poškození úložiště lze také odhalit pomocí kontrolních součtů. Další metodou je použití specializovaných zařízení nebo souborových systémů, ve kterých nelze měnit již zapsaná data, ale lze přidávat nová.
Pro urychlení obnovy se používá obnovení dat s několika procesy pro obnovu - za předpokladu, že neexistuje 'úzké hrdlo' v podobě pomalé sítě nebo pomalého diskového systému. Aby se předešlo situaci s částečně obnovenými daty, lze proces zálohování rozdělit na relativně malé podúkoly, z nichž každý se provádí samostatně. Takovým způsobem vzniká možnost sekvenčně obnovit funkčnost s předpokladem času obnovy. Tento problém často leží v organizační rovině (SLA), proto se na to nebudeme podrobněji zastavovat.
O koření ví nejlépe ten, kdo je nepřidává do každého jídla, ale ten, kdo nikdy do něj nedá nic zbytečného.
—V. Sinjavskij
Praxe v používaném softwaru u systémových administrátorů se může lišit, ale obecné principy jsou přesto, tak či onak, stejné, a to zejména:
- Důrazně se doporučuje používat hotová řešení.
- Programy by měly fungovat předvídatelně, tj. neměly by existovat nedokumentované vlastnosti nebo úzká místa.
- Nastavení každého programu by mělo být dostatečně jednoduché, aby se každou chvíli nemusela číst příručka nebo tahák.
- Řešení by mělo být co nejvíce univerzální, protože servery se mohou výrazně lišit svými hardwarovými charakteristikami.
Pro zálohování z blokových zařízení existují následující běžné programy:
- dd, známý veteránům systémového administrativy, sem patří také podobné programy (například dd_rescue).
- Vestavěné programy (nástroje) některých souborových systémů, které vytvářejí kopii (dump) souborového systému.
- Všeobecné nástroje; například partclone.
- Vlastní, často proprietární řešení; například NortonGhost a novější verze.
Pro souborové systémy lze úlohu zálohování částečně vyřešit pomocí metod aplikovaných na bloková zařízení, ale je možné ji vyřešit i efektivněji, například:
- Rsync, univerzální program a protokol pro synchronizaci stavu souborových systémů.
- Vestavěné nástroje pro archivaci (ZFS).
- Externí nástroje pro archivaci; nejpopulárnější z nich je tar. Existují i další, například dar — náhrada tar zaměřená na moderní systémy.
Samostatně je třeba zmínit software pro zajištění konzistence dat při vytváření záloh. Nejčastěji se používají následující varianty:
- Připojení souborového systému v režimu pouze pro čtení (ReadOnly) nebo zmrazení souborového systému (freeze) — metoda je využitelná omezeně.
- Vytváření kopií stavu souborového systému nebo blokového zařízení (LVM, ZFS).
- Použití externích nástrojů pro organizaci kopií, i když předchozí body nelze z nějakého důvodu zajistit (programy typu hotcopy).
- Technika kopírování při změně (CopyOnWrite), nicméně je většinou vázaná na používání souborového systému (BTRFS, ZFS).
Takže pro malý server je třeba zajistit schéma zálohování, které splňuje následující požadavky:
- Jednoduché na používání — nevyžaduje žádné speciální dodatečné úkony, minimální činnosti při vytváření a obnově kopií.
- Univerzální — funguje jak na velkých, tak na malých serverech; to je důležité při zvyšování počtu servery nebo škálování.
- Instaluje se pomocí balíčkového manažeru nebo v jednom až dvou příkazech typu „stáhnout a rozbalit“.
- Stabilní - používá standardní nebo již dlouho zavedený formát ukládání.
- Rychlá v práci.
Kandidáti, kteří více či méně splňují požadavky:
- rdiff-backup
- rsnapshot
- burp
- duplicati
- duplicity
- deja dup
- dar
- zbackup
- restic
- borgbackup
Jako testovací stanice bude použita virtuální stroj (na bázi XenServer) s následujícími parametry:
- 4 jádra 2,5 GHz,
- 16 GB operační paměti,
- 50 GB hybridní úložiště (úložiště s kešováním na SSD o 20 % velikosti virtuálního disku) ve formě samostatného virtuálního disku bez oddělení,
- 200 Mbit/s kanál do Internetu.
Jako server pro příjem záloh bude použita prakticky stejná mašina, pouze s pevným diskem o velikosti 500 GB.
Operační systém — Centos 7 x64: rozdělení standardní, další část bude použita jako zdroj dat.
Jako vstupní data vezmeme web na wordpressu s médii o velikosti 40 GB a databází na mysql. Vzhledem k tomu, virtuální servery výrazně se liší podle charakteristik, a také pro lepší reprodukovatelnost, zde jsou
výsledky testování serveru pomocí sysbench.sysbench --threads=4 --time=30 --cpu-max-prime=20000 cpu run
sysbench 1.1.0-18a9f86 (používá zabudovaný LuaJIT 2.1.0-beta3)
Provádí test s následujícími možnostmi:
Počet vláken: 4
Inicializace generátoru náhodných čísel z aktuálního času
Limit prvočísel: 20000
Inicializace pracovních vláken…
Vláken začalo!
Rychlost CPU:
událostí za sekundu: 836,69
Průchodnost:
událostí/s (eps): 836,6908
uplynulý čas: 30,0039s
celkový počet událostí: 25104
Latence (ms):
min: 2,38
avg: 4,78
max: 22,39
95. percentil: 10,46
součet: 119923,64
Spravedlnost vláken:
události (avg/stddev): 6276,0000/13,91
doba vykonávání (avg/stddev): 29,9809/0,01
sysbench --threads=4 --time=30 --memory-block-size=1K --memory-scope=global --memory-total-size=100G --memory-oper=read memory run
sysbench 1.1.0-18a9f86 (používá zabudovaný LuaJIT 2.1.0-beta3)
Provádí test s následujícími možnostmi:
Počet vláken: 4
Inicializace generátoru náhodných čísel z aktuálního času
Provádění testu rychlosti paměti s následujícími možnostmi:
velikost bloku: 1KiB
celková velikost: 102400MiB
operace: čtení
rozsah: globální
Inicializace pracovních vláken…
Vláken začalo!
Celkový počet operací: 50900446 (1696677,10 za sekundu)
49707,47 MiB přeneseno (1656,91 MiB/s)
Průchodnost:
událostí/s (eps): 1696677,1017
uplynulý čas: 30,0001s
celkový počet událostí: 50900446
Latence (ms):
min: 0,00
avg: 0,00
max: 24,01
95. percentil: 0,00
součet: 39106,74
Spravedlnost vláken:
události (avg/stddev): 12725111,5000/137775,15
doba vykonávání (avg/stddev): 9,7767/0,10
sysbench --threads=4 --time=30 --memory-block-size=1K --memory-scope=global --memory-total-size=100G --memory-oper=write memory run
sysbench 1.1.0-18a9f86 (používá zabudovaný LuaJIT 2.1.0-beta3)
Provádí test s následujícími možnostmi:
Počet vláken: 4
Inicializace generátoru náhodných čísel z aktuálního času
Provádění testu rychlosti paměti s následujícími možnostmi:
velikost bloku: 1KiB
celková velikost: 102400MiB
operace: zápis
rozsah: globální
Inicializace pracovních vláken…
Vláken začalo!
Celkový počet operací: 35910413 (1197008,62 za sekundu)
35068,76 MiB přeneseno (1168,95 MiB/s)
Průchodnost:
událostí/s (eps): 1197008,6179
uplynulý čas: 30,0001s
celkový počet událostí: 35910413
Latence (ms):
min: 0,00
avg: 0,00
max: 16,90
95. percentil: 0,00
součet: 43604,83
Spravedlnost vláken:
události (avg/stddev): 8977603,2500/233905,84
doba vykonávání (avg/stddev): 10,9012/0,41
sysbench --threads=4 --file-test-mode=rndrw --time=60 --file-block-size=4K --file-total-size=1G fileio run
sysbench 1.1.0-18a9f86 (používá zabudovaný LuaJIT 2.1.0-beta3)
Provádí test s následujícími možnostmi:
Počet vláken: 4
Inicializace generátoru náhodných čísel z aktuálního času
Dodatečné příznaky pro otevření souboru: (žádné)
128 souborů, 8 MiB každý
Celková velikost souboru 1 GiB
Velikost bloku 4 KiB
Počet IO požadavků: 0
Poměr čtení/zápisu pro kombinovaný test náhodného IO: 1,50
Periodické FSYNC povoleno, volání fsync() každých 100 požadavků.
Volání fsync() na konci testu, povoleno.
Používání synchronního I/O módu
Provádění náhodného testu r/w
Inicializace pracovních vláken…
Vláken začalo!
Průchodnost:
čtení: IOPS=3868,21 15,11 MiB/s (15,84 MB/s)
zápis: IOPS=2578,83 10,07 MiB/s (10,56 MB/s)
fsync: IOPS=8226.98
Latence (ms):
min: 0,00
avg: 0.27
max: 18.01
95. percentil: 1.08
sum: 238469.45
Tento článek zahajuje rozsáhlý
cyklus článků o zálohování
- Zálohování, část 1: Proč je zálohování důležité, přehled metod, technologií
- Zálohování, část 2: Přehled a testování nástrojů pro zálohování založených na rsync
- Zálohování, část 3: Přehled a testování duplicity, duplicaty, deja dup
- Zálohování, část 4: Přehled a testování zbackup, restic, borgbackup
- Zálohování, část 5: Testování Bacula a Veeam Backup pro Linux
- Zálohování, část 6: Srovnání nástrojů pro zálohování
- Zálohování, část 7: Závěry
Zdroj: habr.com
