

Úvod do operačních systémů
Ahoj, Habr! Rád bych vám představil sérii článků-překladů jedné zajímavé literatury, kterou považuji za hodnotnou — OSTEP. Tento materiál se hlouběji zabývá prací unixových operačních systémů, konkrétně prací s procesy, různými plánovači, pamětí a dalšími komponentami, které tvoří moderní OS. Originál všech materiálů můžete vidět tady . Upozorňuji, že překlad byl proveden neprofesionálně (poměrně volně), ale doufám, že jsem zachoval celkový smysl.
Laboratorní práce k tomuto předmětu najdete zde:
Další části:
A můžete také nahlédnout na můj kanál na =)
Plánování: Víceúrovňová zpětná vazba
V této přednášce se budeme zabývat problémy vývoje jednoho z nejznámějších přístupů k
plánování, který se nazývá Víceúrovňová zpětná vazba (MLFQ). Poprvé byl plánovač MLFQ popsán v roce 1962 Fernando J. Corbató v systému nazvaném
Kompatibilní časově sdílený systém (CTSS). Tyto práce (včetně pozdějších prací na
Multics) byly poté nominovány na Turingovu cenu. Plánovač byl
následně vylepšen a získal podobu, kterou lze nalézt již v
některých moderních systémech.
Algoritmus MLFQ se snaží vyřešit 2 základní překrývající se problémy.
Za prvé, snaží se optimalizovat dobu obratu, která jak jsme probrali v předchozí přednášce, se optimalizuje metodou spuštění na začátku fronty nejvíce
krátkých úloh. Nicméně, OS neví, jak dlouho bude trvat daný proces, a to je
nezbytné znalosti pro fungování algoritmů SJF, STCF. Za druhé, MLFQ se snaží
udělat systém reagující na uživatele (například takové, kteří sedí a
zírání na obrazovku v očekávání dokončení úlohy) a tím minimalizovat dobu
reakce. Bohužel, algoritmy jako RR snižují dobu reakce, ale extrémně
negativně ovlivňují metriku doby obratu. Odtud naše otázka: Jak navrhnout
plánovač, který bude splňovat naše požadavky a zároveň nic nevědět o
charakter procesu obecně? Jak bude plánovač schopen studovat charakteristiky úloh,
které spouští, a tím pádem lépe rozhodovat o plánování?
Podstata problému: Jak plánovat úkoly bez ideálního znalosti?
Jak navrhnout plánovač, který současně minimalizuje dobu odezvy
pro interaktivní úlohy a zároveň minimalizuje dobu obratu bez předchozího
znalosti doby provádění úlohy?
Poznámka: učíme se z předešlých událostí
Fronta MLFQ je vynikajícím příkladem systému, který se učí na
uplynulých událostech, aby predikoval budoucnost. Podobné přístupy se často
vyskytují v OS (a mnoha dalších oblastech informatiky, včetně větví
předpovědí v hardwaru a algoritmů mezipaměti). Takové přístupy
fungují, když mají úkoly chování a tím jsou předvídatelné.
Nicméně s touto technikou je třeba být opatrný, protože předpovědi se velmi snadno
mohou ukázat jako špatné a vést systém k horším rozhodnutím, než
by bylo bez jakýchkoliv znalostí.
MLFQ: Základní pravidla
Pojďme se podívat na základní pravidla algoritmu MLFQ. Ačkoliv existuje několik
implementací tohoto algoritmu, základní přístupy jsou podobné.
V té implementaci, kterou budeme zkoumat, bude mít MLFQ několik
oddělených front, z nichž každá bude mít jinou prioritu. V každém okamžiku,
úkol, který je připraven k provedení, se nachází v jedné frontě. MLFQ používá priority,
aby rozhodoval, kterou úlohu spustit k provedení, tj. úkol s vyššími
prioritami (úkol z fronty s nejvyšší prioritou) bude spuštěn jako první.
Jistě, v konkrétní frontě může být více než jedna úloha, takže
budou mít stejnou prioritu. V tomto případě bude použit mechanismus
RR pro plánování spuštění mezi těmito úlohami.
Takto docházíme k dvěma základním pravidlům pro MLFQ:
Pravidlo 1: Pokud priorita(A) > priorita(B), bude spuštěn úkol A (B nebude)
- Pravidlo 2: Pokud priorita(A) = priorita(B), A i B se spouští pomocí RR
- Na základě výše uvedeného jsou klíčovými prvky plánování MLFQ
priority. Místo toho, abychom nastavili fixní prioritu každému
jsou priority. Namísto nastavení pevné priority každému
Pokud jde o úlohu, MLFQ mění její prioritu na základě pozorovaného chování.
Například pokud úloha neustále zdržuje CPU čekáním na vstup z klávesnice,
MLFQ udržuje prioritu procesu na vysoké úrovni, protože tak by měl fungovat interaktivní proces. Pokud úloha naopak neustále a intenzivně využívá CPU po delší dobu, MLFQ sníží její prioritu.
Takže MLFQ studuje chování procesů v průběhu jejich práce a používá tato chování.
Nakreslíme si příklad toho, jak by mohly vypadat fronty v určitém okamžiku
času a dostaneme něco takového:
V tomto schématu jsou 2 procesy A a B v frontě s nejvyšší prioritou. Proces
C je někde uprostřed, a proces D je na konci fronty. Podle výše uvedených
popisů algoritmu MLFQ plánovač vykonává úkoly pouze s nejvyššími
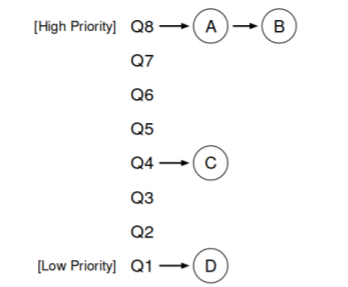
prioritami podle RR, zatímco úkoly C a D zůstanou bez povšimnutí.
Samozřejmě, statický snímek neposkytuje úplný obrázek o tom, jak MLFQ funguje.
Je důležité pochopit, jak se obraz mění v průběhu času.
PokAttempt 1: Jak měnit prioritu
V tuto chvíli je třeba rozhodnout, jak MLFQ změní úroveň priority
úkolu (a tedy umístění úkolu ve frontě) během jejího životního cyklu. Pro
to je třeba mít na paměti pracovní náplň: určité množství
interaktivních úloh s krátkou dobou trvání (a tedy častým uvolňováním
CPU) a několik dlouhých úloh, které používají CPU po celou dobu své pracovní doby, přičemž
doba reakce pro takové úlohy není důležitá. A tudíž můžeme udělat první pokus
implementovat algoritmus MLFQ s následujícími pravidly:
Pravidlo 3: Když úloha vstoupí do systému, je zařazena do fronty s nejvyšším
prioritou.
Pravidlo 4a: Pokud úloha využije celé přidělené časové okno, její
- priorita se sníží.
- Pravidlo 4b: Pokud úloha uvolní CPU před vypršením svého časového okna, její
- priorita zůstává stejná.
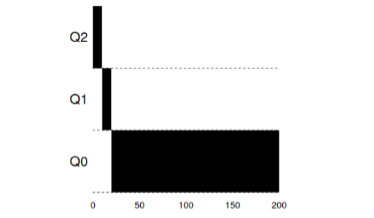
- Příklad 1: Jediná dlouhá úloha
- Jak je vidět v tomto příkladu, úloha při vstupu dostává nejvyšší
- prioritu. Po časovém okně 10 ms je proces snížen v prioritě
plánovačem. Po dalším časovém okně je úloha konečně snížena na
Jak je vidět v tomto příkladu, úloha při přijetí dostává nejvyšší
prioritu. Po časovém okně 10 ms je proces po snížené prioritě
plánovačem. Po následujícím časovém oknu je úloha konečně snížena na
nízké priority v systému, kde zůstává.
Příklad 2: Přivezen úkol s krátkým trváním
Teď se podíváme na příklad toho, jak se MLFQ pokusí přiblížit SJF. V tomto
příkladu jsou dva úkoly: A, což je úkol s dlouhým trváním, který neustále
procesor využívá, a B, což je krátký interaktivní úkol. Předpokládejme,
že A už nějakou dobu pracovalo v okamžiku, kdy dorazí úkol B.
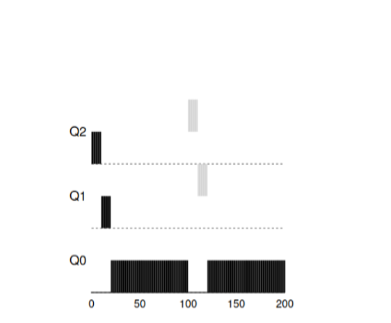
Na tomto grafu jsou zobrazeny výsledky scénáře. Úkol A, jako každý úkol,
který využívá CPU, se ocitl na úplném dně. Úkol B přijde v čase T=100 a
bude umístěn do fronty s nejvyšší prioritou. Vzhledem k tomu, že doba jeho běhu je krátká,
dokáže se dokončit dříve, než se dostane na poslední pozici.
Z tohoto příkladu bychom měli pochopit hlavní cíl algoritmu: protože algoritmus ne
ví, zda je úkol dlouhý nebo krátký, předpokládá především, že úkol
je krátký, a uděluje mu nejvyšší prioritu. Pokud je to opravdu krátký úkol,
provedení bude rychlé, jinak, pokud je to dlouhý úkol, bude se pomalu dostávat
dolů v prioritě a brzy prokáže, že je to opravdu dlouhý úkol, který ne
vyžaduje odezvu.
Příklad 3: A co vstup-výstup?
Nyní se podíváme na příklad se vstupem-výstupem. Jak bylo uvedeno v pravidle 4b,
pokud proces uvolní procesor, aniž by zcela využil svůj čas procesoru,
zůstává na stejné úrovni priority. Záměry tohoto pravidla jsou docela jasné
— pokud interaktivní úkol provádí mnoho operací vstupu-výstupu, například čekající
na stisknutí klávesy nebo myši uživateli, takový úkol uvolní procesor
dříve, než je stanovené okno. Nechtěli bychom, aby takový úkol klesl v prioritě,
a tím pádem zůstane na stejné úrovni.
Tento příklad ukazuje, jak bude algoritmus pracovat s takovými procesy — interaktivní úkol B, který potřebuje CPU pouze na 1 ms před provedením
procesu vstupu-výstupu, a dlouhý úkol A, který neustále využívá CPU.
MLFQ udržuje úkol B s nejvyšší prioritou, protože neustále osvobozuje
CPU. Pokud je B interaktivní úkol, algoritmus v takovém případě dosáhl
svého cíle rychle spouštět interaktivní úkoly.
Problémy se současným algoritmem MLFQ
V předchozích příkladech jsme vytvořili základní variantu MLFQ. A zdá se, že funguje
dobře a spravedlivě, rozděluje procesorový čas mezi
dlouhé úkoly a umožňuje krátkým úkolům nebo úkolům s intenzivním
I/O zpracováním vykonávat se rychle. Bohužel, tento přístup obsahuje několik
závažných problémů.
Za prvé, problém hladu: pokud bude v systému mnoho interaktivních
úkolů, budou spotřebovávat veškerý procesorový čas a tím pádem žádný dlouhý
úkol nebude mít možnost vykonávat se (hladoví).
Za druhé, chytří uživatelé by mohli psát své programy tak, aby
obešli plánovač. Obejití spočívá v tom, že uděláte něco, co donutí
plánovač přidělovat procesoru více procesorového času. Algoritmus, který
byl popsán výše, je zcela zranitelný vůči podobným útokům: před tím, než časový úsek téměř
skončí, je třeba provést operaci I/O (na nějakém, nezáleží na jakém souboru)
a tím uvolnit CPU. Takové chování umožní zůstat ve stejné
frontě a znovu získat větší procento procesorového času. Pokud se to provedete
správně (například vykonávat se 99 % času okna před uvolněním CPU),
takový úkol může jednoduše monopolizovat procesor.
Nakonec může program měnit své chování v průběhu času. Ty úkoly,
které využívaly CPU, se mohou stát interaktivními. V našem příkladu podobné
úkoly nedostanou adekvátní zacházení od plánovače, protože dostaly jiné
(původní) interaktivní úkoly.
Otázka do publika: jaké útoky na plánovač bylo možné provádět v moderním světě?
Pok attempt 2: Zvyšování priority
Pokud se pokusíme změnit pravidla, uvidíme, zda se nám podaří vyhnout se problémům s
hladověním. Co bychom mohli udělat, abychom zajistili, že úkoly související s
CPU dostanou svůj čas (i když ne na dlouho).
Jako jednoduché řešení problému lze navrhnout pravidelně
zvyšovat prioritu všech takových úkolů v systému. Existuje mnoho způsobů
jak toho dosáhnout, zkuste implementovat jako příklad něco jednoduchého: převést
najednou všechny úkoly na nejvyšší prioritu, odsud nové pravidlo:
- Rule5: Po uplynutí určité doby S převést všechny úkoly v systému do nejvyšší fronty.
Naše nové pravidlo řeší dvě problémy najednou. Za prvé, procesy
zaručeně netrpí hladověním: úkoly, které se nacházejí v nejvyšší frontě, budou dělit
procesorový čas podle algoritmu RR a tím pádem všechny procesy získají
procesorový čas. Za druhé, pokud se nějaký proces, který dříve využíval
pouze procesor, stane interaktivním, zůstane ve frontě s vyššími
prioritami poté, co jednou získá povýšení priority na nejvyšší.
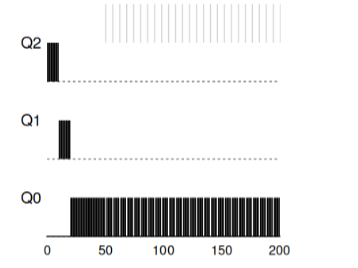
Zvážíme příklad. V tomto scénáři zvažme jeden proces využívající
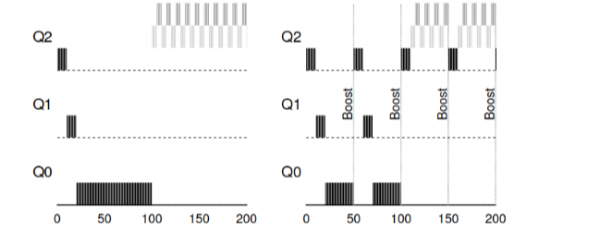
CPU a dva interaktivní, krátké procesy. Vlevo na obrázku je znázorněno chování bez povyšování priority, takže dlouhá úloha začne hladovět po příchodu dvou interaktivních úloh do systému. Na obrázku vpravo se povyšování priority provádí každých 50ms a tím pádem všechny procesy zaručeně získají procesorový čas a budou se periodicky spouštět. 50ms bylo v tomto případě zvoleno jako příklad, ve skutečnosti je toto číslo trochu vyšší.
Je zřejmé, že přidání doby periodického povyšování S vyvolává
logickou otázku: jaká hodnota by měla být nastavena? Jeden z vážených
systémových inženýrů John Ousterhout nazýval podobné hodnoty v systémech jako voo-doo
konstanty, protože do určité míry vyžadovaly černou magii pro správné
nastavení. A, bohužel, S má takovou příchuť. Pokud nastavíte hodnotu příliš
vysokou – dlouhé úlohy začnou hladovět. A pokud nastavíte příliš nízkou hodnotu,
interaktivní úlohy nedostanou dostatečný procesorový čas.
Pokus 3: Nejlepší sledování
Nyní máme další problém, který je třeba vyřešit: jak nezapřít
náš plánovač? Na vině jsou pravidla 4a, 4b, která umožňují úkolu udržovat prioritu tím, že uvolní procesor
před uplynutím vyhrazeného času. Jak se s tím vypořádat?
Řešením v tomto případě může být nejlepší sledování času CPU na každé
úrovni MLFQ. Místo toho, abychom zapomněli čas, který program použil.
úroveň MLFQ. Místo toho, aby se zapomnělo na čas, který program použil
Při určení přiděleného času procesoru je třeba to vzít v úvahu a zachovat. Jakmile
proces spotřeboval přidělený čas, je třeba jeho prioritu snížit na další
úroveň. Nyní nezáleží na tom, jak proces svůj čas využije — zda
stále vypočítává na procesoru, nebo provádí mnoho volání. Takto
bylo třeba přepsat pravidlo 4 následujícím způsobem:
- Rule4: Jakmile úkol spotřeboval přidělený čas v aktuálním queue (bez ohledu na to, kolikrát uvolnil CPU), jeho priorita se sníží (pohne se dolů v queue).
Podívejme se na příklad:
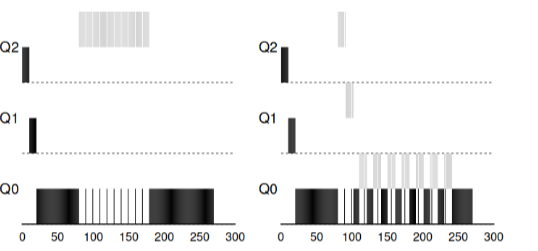 »
Na obrázku je znázorněno, co se stane, když se pokusíte podvést plánovač, jako
by to bylo s předchozími pravidly 4a, 4b, vznikne výsledek vlevo. S novým
pravidlem — výsledek vpravo. Před zapojením jakékoli ochrany mohl jakýkoli proces volat I/O do dokončení a
tímto způsobem dominovat nad CPU; po zapnutí ochrany, bez ohledu na chování
I/O, bude přesto stále klesat v queue a tím nemůže nepoctivě
ovládnout CPU prostředky.
Zlepšení MLFQ a další problémy
S uvedenými vylepšeními vznikají nové problémy: jedním z hlavních
otázky je, jak parametrizovat takový plánovač? Tedy, kolik by mělo být
queue? Jaká by měla být velikost pracovního okna programu v rámci queue? Jak
často by se měla priorita programu zvyšovat, aby se zabránilo hladu a
zohlednilo změny chování programu? Na tyto otázky nelze jednoduše odpovědět a pouze experimenty s zatěžováním a následná konfigurace
plánovače mohou přinést jisté uspokojivé vyvážení.
Například většina implementací MLFQ umožňuje přiřazovat různé
časové intervaly různým queue. Vysokoprůměrné queue obvykle
dostávají krátké intervaly. Tyto queue se skládají z interaktivních úloh,
u kterých je přepínání poměrně citlivé a mělo by trvat 10 nebo méně
ms. Naopak nízkoprůměrné queue se skládají z dlouhých úloh, které využívají
CPU. A v tomto případě se dlouhé časové intervaly hodí velmi dobře (100 ms).
V tomto příkladu jsou 2 úlohy, které pracovaly ve vysokoprůměrné queue 20
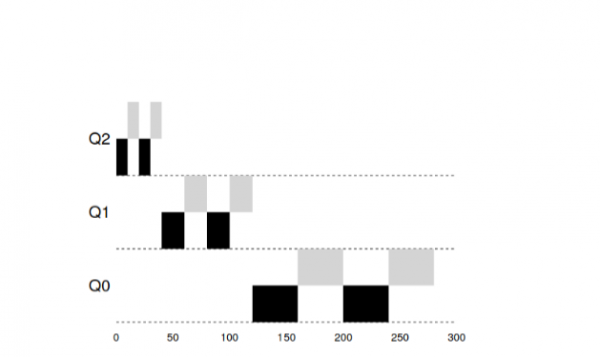
V tomto příkladu existují 2 úlohy, které pracovaly ve vysoce prioritní frontě 20
ms, rozdělené do oken po 10 ms. 40 ms ve střední frontě (okno 20 ms) a v nízké prioritě
temporární okno se stalo 40 ms, kde úkoly dokončily svou práci.
Realizace MLFQ v OS Solaris – třída plánovačů, které dělí podle času.
Plánovač poskytuje sadu tabulek, které přesně definují, jak by měl
měnit prioritu procesu v průběhu jeho životnosti, jaká by měla být velikost
alokovaného okna a jak často je třeba zvyšovat priority úkolu. Administrátor
systému může interagovat s touto tabulkou a přinutit plánovač jednat
jinak. Ve výchozím nastavení obsahuje tato tabulka 60 front s postupným zvyšováním
velikosti okna od 20 ms (vysoká priorita) až po několik set ms (nejnižší priorita), a
také s boostem všech úkolů jednou za sekundu.
Jiné MLFQ plánovače nepoužívají tabulku nebo nějaká konkrétní
pravidla, která jsou popsána v této přednášce, naopak počítají priority pomocí
matematických vzorců. Tak například plánovač ve FreeBSD používá vzorec pro
výpočet aktuální priority úkolu, založený na tom, kolik proces
použil CPU. Kromě toho, využití CPU v průběhu času klesá, a tím
zvýšení priority probíhá poněkud jinak, než je popsáno výše. To jsou tak
zvané decay algoritmy. Od verze 7.1 ve FreeBSD je používán plánovač ULE.
Nakonec mají mnohé plánovače další vlastnosti. Například, některé
plánovače vyhradí nejvyšší úrovně pro fungování operačního systému, a tím
žádný uživatelský proces nemůže získat nejvyšší prioritu v
systému. Některé systémy umožňují dávat rady, aby pomohly
plánovači správně nastavovat priority. Například, pomocí příkazu nice
je možné zvyšovat nebo snižovat prioritu úkolu, a tím zvýšit nebo
snížit šance programu na procesorový čas.
MLFQ: Závěry
Popisovali jsme přístup k plánování, který se nazývá MLFQ. Jeho název
je založen na principu fungování – má několik front a používá zpětnou vazbu
k určení priority úkolu.
Konečná podoba pravidel bude následující:
- Pravidlo 1: Pokud priorita(A) > priorita(B), úkol A bude spuštěn (B nebude)
- Pravidlo 2: Pokud je priorita(A) = priorita(B), A a B se spouští pomocí RR
- Pravidlo3: Když úloha přijde do systému, je umístěna do fronty s nejvyšší prioritou.
- Rule4: Jakmile úkol spotřeboval přidělený čas v aktuálním queue (bez ohledu na to, kolikrát uvolnil CPU), jeho priorita se sníží (pohne se dolů v queue).
- Rule5: Po uplynutí určité doby S převést všechny úkoly v systému do nejvyšší fronty.
MLFQ je zajímavý z následujícího důvodu — místo aby vyžadoval znalosti o
povaze úlohy předem, algoritmus se učí z minulého chování úlohy a přiřazuje
priority odpovídajícím způsobem. Snaží se tím pádem sedět na dvou židlích — dosáhnout výkonu pro malé úlohy (SJF, STCF) a spravedlivě spouštět dlouhé,
CPU-náročné úlohy. Proto mnoho systémů, včetně BSD a jejich odvozenin,
Solaris, Windows, Mac používají jako plánovač nějakou formu algoritmu
MLFQ jako základní základ.
Další materiály:
- (computing)
Zdroj: habr.com
