

Napsat tento článek mě inspirovalo velké množství materiálů o statické analýze, které se stále častěji objevují. Za prvé, je to , který se aktivně propaguje na Habru skrze přehledy chyb nalezených jejich nástrojem v projektech s otevřeným kódem. Nedávno PVS-studio implementovalo , a samozřejmě, vývojáři IntelliJ IDEA, jejichž vestavěný analyzátor je dnes pravděpodobně tím nejpokročilejším pro Java, .
Při čtení takových přehledů vzniká pocit, že jde o kouzelný elixír: stiskněte tlačítko a voilà — seznam defektů je přímo před vámi. Zdá se, že s rozvojem analyzátorů budou chyby automaticky nacházeny stále více a více a produkty, které tyto roboty procházejí, se stávají stále lepšími, bez jakýchkoliv našich úsilí.
Ale kouzelné elixíry neexistují. Rád bych promluvil o tom, o čem se obvykle nemluví v příspěvcích typu „tady je, co náš robot může najít“: co analyzátory nikdy nebudou schopny udělat, jaká je jejich skutečná role a místo v procesu dodávky softwaru a jak je správně implementovat.
Hravost (zdroj: ).
Co nikdy nebudou schopny statické analyzátory
Co je z praktického hlediska analýza zdrojového kódu? Dodáme určité zdroje a během krátké doby (daleko kratší než průběh testů) získáme jisté informace o našem systému. Zásadní a matematicky neodvratné omezení spočívá v tom, že tímto způsobem můžeme získat pouze poměrně úzkou třídu informací.
Nejznámějším příkladem úlohy, kterou nelze vyřešit pomocí statické analýzy, je : to je věta, která dokazuje, že nelze vyvinout obecný algoritmus, který by podle zdrojového kódu programu určil, zda se program zasekne nebo skončí v konečném čase. Rozšířením této věty je , tvrdící, že pro libovolnou netriviální vlastnost výpočetních funkcí je určení, zda libovolný program počítá funkci s takovou vlastností, algoritmicky neřešitelným úkolem. Například není možné napsat analyzátor, který by na základě jakéhokoliv zdrojového kódu určil, zda analyzovaný program implementuje algoritmus, který počítá například umocnění celého čísla na druhou.
Tímto způsobem má funkčnost statických analyzátorů neodstranitelné omezení. Statický analyzátor nikdy nebude schopen ve všech případech určit takové věci, jako například vznik "null pointer exception" v jazycích, které umožňují hodnotu null, nebo ve všech případech určit vznik "attribute not found" v jazycích s dynamickým typováním. Všechno, co může i ten nejdokonalější statický analyzátor, je vyčlenit zvláštní případy, jejichž počet mezi všemi možnými problémy s vaším zdrojovým kódem je, bez exaggeraci, kapka v moři.
Statická analýza není hledáním chyb.
Z výše uvedeného vyplývá závěr: statická analýza není nástrojem na snižování počtu defektů v programu. Dovolím si tvrdit, že když je poprvé aplikována na váš projekt, najde v kódu "zajímavá" místa, ale pravděpodobně nenajde žádné defekty, které by ovlivnily kvalitu činnosti vašeho programu.
Příklady defektů, které byly automaticky nalezeny analyzátory, jsou ohromující, ale nesmíme zapomínat, že tyto příklady byly nalezeny pomocí skenování velkého souboru velkých kódových základen. Na stejném principu hackeři, kteří mají možnost procházet několik jednoduchých hesel na velkém počtu účtů, nakonec najdou ty účty, na kterých je jednoduché heslo.
Znamená to, že statickou analýzu není třeba používat? Samozřejmě, že ne! A to z přesně stejného důvodu, proč stojí za to zkontrolovat každé nové heslo, zda se ocitá na seznamu "jednoduchých" hesel.
Statická analýza je více než hledání chyb.
Ve skutečnosti jsou prakticky řešitelné úkoly analýzou mnohem širší. Vždyť obecně statická analýza je jakákoli kontrola zdrojových kódů, která se provádí před jejich spuštěním. Zde je několik věcí, které lze dělat:
- Kontrola stylu kódování v širokém smyslu slova. Toto zahrnuje jak kontrolu formátování, tak i vyhledávání prázdných/nepotřebných závorek, stanovení prahových hodnot metrik, jako je počet řádků/cyklomatická složitost metody atd. — celkově vše, co potenciálně ztěžuje čitelnost a udržovatelnost kódu. V Javě je tímto nástrojem Checkstyle, v Pythonu — flake8. Programy tohoto typu se obvykle nazývají „lintery“.
- Analýze nemusí podléhat pouze spouštěcí kód. Soubory s prostředky, jako jsou JSON, YAML, XML, .properties, mohou (a měly by!) být automaticky kontrolovány na platnost. Nakonec je lepší zjistit, že struktura JSON byla narušena kvůli nějakým nepárovým uvozovkám v rané fázi automatické kontroly Pull Requestu, než při spuštění testů nebo v době běhu? Odpovídající nástroje jsou k dispozici: například, , .
- Kompilace (nebo analýza pro dynamické programovací jazyky) je také druhem statické analýzy. Obecně platí, že kompilátory jsou schopny vydávat varování signalizující problémy s kvalitou zdrojového kódu, a ty by neměly být ignorovány.
- Někdy kompilace není pouze kompilací spouštěcího kódu. Například, pokud máte dokumentaci ve formátu , pak v okamžiku, kdy je převedena na HTML/PDF, může zpracovatel AsciiDoctor () vydávat varování, například o porušených interních odkazech. A to je vážný důvod, proč nepřijmout Pull Request s úpravami dokumentace.
- Kontrola pravopisu je také druhem statické analýzy. Nástroj je schopen kontrolovat pravopis nejen v dokumentaci, ale také v zdrojových kódech programů (v komentářích a literálech) v různých programovacích jazycích, včetně C/C++, Javy a Pythonu. Chyba pravopisu v uživatelském rozhraní nebo dokumentaci je také defekt!
- Konfigurační testy (o tom, co to je — viz a reporty), i když se provádějí v prostředí spouštění modulových testů typu pytest, jsou ve skutečnosti také druhem statické analýzy, jelikož nepouštějí zdrojové kódy během svého provádění.
Jak vidíme, hledání chyb v tomto seznamu hraje nejméně důležitou roli, zatímco vše ostatní je dostupné pomocí bezplatných open source nástrojů.
Které z těchto typů statické analýzy byste měli používat ve vašem projektu? Samozřejmě, čím více, tím lépe! Hlavní je správně je implementovat, o čemž se budeme bavit dále.
Dodavatelský kanál jako vícestupňový filtr a statická analýza jako jeho první kaskáda
Klasickou metaforou kontinuální integrace je potrubí (pipeline), kterým procházejí změny – od změny zdrojového kódu až po dodání do produkce. Standardní pořadí fází tohoto kanálu vypadá takto:
- statická analýza
- kompilace
- modulové testy
- integrační testy
- UI testy
- ruční kontrola
Změny, které byly zamítnuty v N-té fázi kanálu, se nepřenesou na fázi N+1.
Proč právě tak a ne jinak? V té části kanálu, která se týká testování, se testeři dozvědí o široce známé pyramide testování.
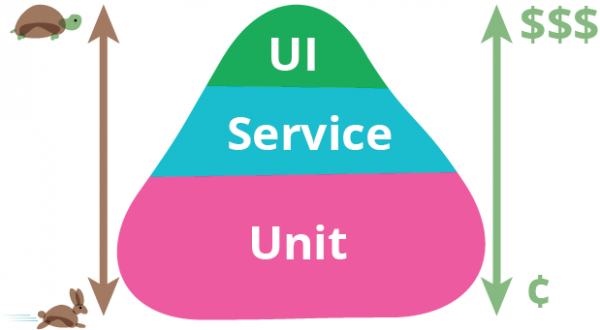
Testovací pyramida. Zdroj: Martin Fowler.
V dolní části této pyramidy se nacházejí testy, které se snadněji píší, které se rychleji vykonávají a nemají tendenci k falešnému spouštění. Proto by jich mělo být více, měly by pokrývat více kódu a být prováděny jako první. V horní části pyramidy je situace opačná, a proto by měl být počet integračních a UI testů snížen na nezbytné minimum. Člověk v tomto řetězci je nejdražší, nejpomalejší a nejméně spolehlivý zdroj, a proto se nachází na samém konci a vykonává práci pouze v případě, že předchozí fáze neodhalily žádné defekty. Nicméně podle stejných principů se buduje kanál i v částech, které nejsou přímo spojené s testováním!
Chtěl bych navrhnout analogii ve formě vícestupňového systému filtrace vody. Na vstupu je špinavá voda (změny s defekty), na výstupu bychom měli získat čistou vodu, všechny nežádoucí nečistoty by měly být odstraněny.
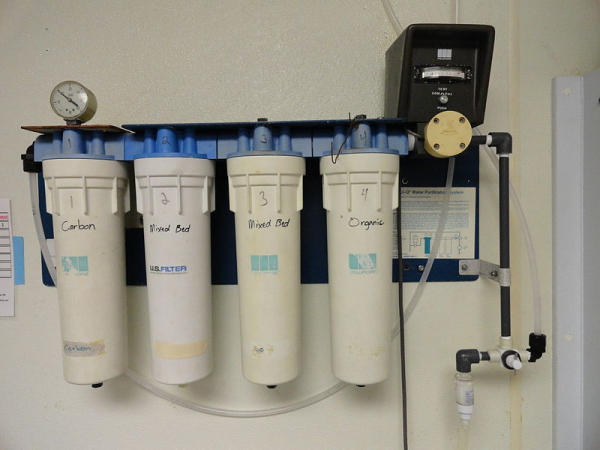
Vícestupňový filtr. Zdroj:
Jak je známo, čisticí filtry jsou navrženy tak, aby každý další stupeň mohl zachytit stále jemnější frakci znečištění. To znamená, že stupně hrubého čištění mají větší propustnost a nižší náklady. V naší analogii to znamená, že vstupní quality gates mají větší výkon, vyžadují méně úsilí při spuštění a jsou samy o sobě nenáročné — a přesně v takovém pořadí jsou uspořádány. Role statické analýzy, která, jak nyní rozumíme, může zachytit pouze ty nejhrubší nedostatky — je rolí síta-„špinavce“ na samotném začátku filtračního stupně.
Statická analýza sama o sobě nezlepší kvalitu konečného produktu, stejně jako „špinavec“ neučiní vodu pitnou. A přesto je její důležitost v celkové souvislosti s dalšími prvky výrobního procesu zřejmá. I když v mnohostupňovém filtru mohou výstupní stupně potenciálně zachytit to samé, co vstupní — je jasné, k jakým důsledkům povede pokus spoléhat se pouze na stupně jemného čištění, bez vstupních stupňů.
Cílem „špinavce“ je uvolnit následné stupně od zachytávání zcela hrubých nedostatků. Například alespoň osoba provádějící code review by se neměla rozptylovat nesprávně naformátovaným kódem a porušením stanovených pravidel kódování (jako jsou zbytečné závorky nebo příliš hluboce vnořené větvení). Chyby jako NPE by měly být zachyceny modulovými testy, ale pokud analyzátor již před testem upozorňuje, že chyba se nevyhnutelně objeví — výrazně to urychlí její opravu.
Předpokládám, že nyní je jasné, proč statická analýza nezlepšuje kvalitu produktu, pokud se používá příležitostně, a měla by se používat neustále k zachycování změn s hrubými nedostatky. Otázka, zda použití statického analyzátoru zlepší kvalitu vašeho produktu, je přibližně ekvivalentní otázce: „Zlepší se pitné vlastnosti vody pocházející z špinavého rybníka, pokud ji přefiltrujete přes cedník?“
Zavedení do legacy-projektu
Důležitá praktická otázka: jak implementovat statickou analýzu do procesu kontinuální integrace jako „quality gate“? V případě automatických testů je to jasné: existuje sada testů, selhání jakéhokoli z nich je dostatečný důvod považovat, že sestavení neprošlo quality gate. Pokus o nastavení gate na základě výsledků statické analýzy selhává: u legacy kódu je varování analýzy příliš mnoho, nechceme je úplně ignorovat, ale zastavit dodávku produktu pouze proto, že obsahuje varování analyzátoru, není možné.
Při prvním použití analyzátor na jakémkoli projektu vydává obrovské množství varování, z nichž většina se netýká správné funkčnosti produktu. Opravit všechny tyto poznámky najednou není možné, a mnohé — ani není potřeba. Koneckonců víme, že náš produkt celkově funguje a to i před zavedením statické analýzy!
V důsledku toho se mnoho lidí omezuje na epizodické používání statické analýzy, nebo ji používají pouze v informačním režimu, kdy při sestavení je jednoduše vydáno hlášení analyzátoru. To je ekvivalentní absenci jakékoli analýzy, protože pokud máme již mnoho varování, pak vznik dalšího (jakkoli závažného) při změně kódu zůstává nepovšimnut.
Jsou známy následující způsoby zavedení quality gates:
- Nastavení limitu celkového počtu varování nebo počtu varování děleného počtem řádků kódu. To funguje špatně, protože takový gate volně propouští změny s novými defekty, dokud jejich limit není překročen.
- Zaznamenání všech starých varování v kódu jako ignorovaných k určitému okamžiku, a odmítnutí sestavení při vzniku nových varování. Takovou funkčnost poskytuje PVS-studio a některé online zdroje, například Codacy. Neměl jsem příležitost pracovat s PVS-studio, co se týče mého zkušenosti s Codacy, tak jejich hlavní problém spočívá v tom, že určení toho, co je „stará“, a co „nová“ chyba — je docela složitý a ne vždy správně fungující algoritmus, zejména pokud se soubory výrazně mění nebo přejmenovávají. Z mé zkušenosti Codacy mohl v pull requestu vynechat nová varování, a zároveň nepropustit pull request kvůli varováním, která se netýkala změn v kódu daného PR.
- Podle mého názoru je nejefektivnějším řešením to popsané v knize „metoda hračky“ („ratcheting“). Hlavní myšlenka spočívá v tom, že vlastností každého vydání je počet varování statické analýzy, a povolena jsou jen taková změny, které celkový počet varování nezvyšují.
Hračky
Funguje to takto:
- V počáteční fázi se realizuje zápis do metadat o vydání počtu varování v kódu, kterých našli analyzátory. Takže při sestavení hlavního větve ve vašem správci repository se nezapisuje jen „vydání 7.0.2“, ale „vydání 7.0.2, obsahující 100500 varování Checkstyle“. Pokud používáte pokročilý správce repository (např. Artifactory), uložení takových metadat o vašem vydání je snadné.
- Nyní každý pull request při sestavení porovnává počet vzniklých varování s tím, jaké množství má aktuální vydání. Pokud PR zvýší toto číslo, kód neprojde quality gate na statickou analýzu. Pokud se počet varování snižuje nebo nemění — tak projde.
- Při příštím vydání bude znovu přepočítaný počet varování zapsán do metadat vydání.
Tak pomalu, ale jistě (jako při práci s klikou) se počet varování snaží blížit nule. Samozřejmě, systém lze oklamat tím, že se přidá nové varování tím, že se opraví cizí. To je v pořádku, protože v dlouhém období to přináší výsledky: varování se obvykle opravují ne jednotlivě, ale skupinově podle určitých typů, a všechna snadno odstraněná varování jsou docela rychle odstraněna.
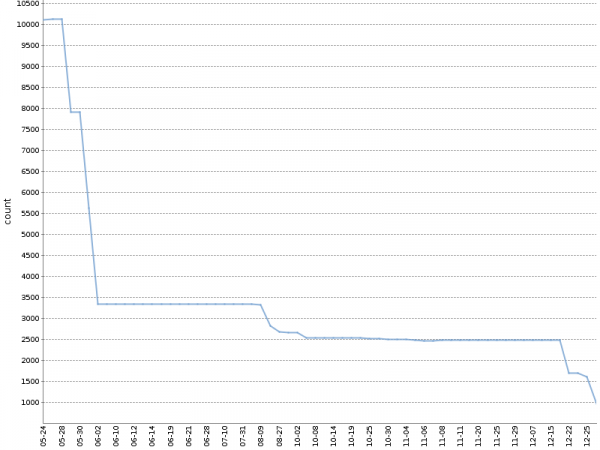
Na tomto grafu je znázorněn celkový počet varování Checkstyle za posledních šest měsíců práce tohoto „mechanismu“ na Počet varování se snížil o řád, a to přirozeným způsobem, zároveň s vývojem produktu!
Používám modifikovanou verzi této metody, která odděleně počítá varování rozdělená podle modulů projektu a nástrojů analýzy. Vytvořený YAML soubor s metadaty o sestavení vypadá přibližně takto:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
V jakémkoliv pokročilém CI systému lze „mechanismus“ implementovat pro jakékoliv nástroje pro statickou analýzu, aniž byste se spoléhali na pluginy a externí nástroje. Každý z analyzátorů generuje svou zprávu v jednoduchém textovém nebo XML formátu, který se snadno zpracovává. Je jen potřeba napsat potřebnou logiku do CI skriptu. Můžete se podívat, jak je to implementováno v našich open source projektech využívajících Jenkins a Artifactory. nebo . Oba příklady závisí na knihovně : metoda countWarnings() běžně počítá xml tagy v souborech generovaných Checkstyle a Spotbugs, a compareWarningMaps() realizuje ten pravý mechanismus, vyhazující chybu v případě, že se počet varování v některé z kategorií zvýší.
Zajímavá varianta implementace „zámku“ může být použita pro analýzu pravopisu komentářů, textových literálů a dokumentace pomocí aspell. Jak je známo, při kontrolování pravopisu nejsou všechna slova neznámá standardnímu slovníku nutně nesprávná; mohou být přidána do uživatelského slovníku. Pokud uděláte uživatelský slovník součástí zdrojového kódu projektu, může být kvalita brány pro pravopis formulována následovně: provedení aspell se standardním a uživatelským slovníkem. nalezeny žádné pravopisné chyby.
O důležitosti fixace verze analyzátoru
Na závěr je třeba poznamenat následující: ať už implementujete analýzu jakýmkoli způsobem do vašeho dodávkového kontejneru, verze analyzátoru by měla být pevně stanovena. Pokud dojde k samovolné aktualizaci analyzátoru, při sestavování dalšího pull requestu se mohou „objevit“ nové chyby, které nesouvisí se změnou kódu, ale s tím, že nový analyzátor je schopen odhalit více chyb — a to vám zkomplikuje proces přijímání pull requestů. Upgrade analyzátoru by měl být vědomým krokem. Nicméně, pevná fixace verze každé komponenty sestavení je obecně nezbytným požadavkem a tématem pro zvláštní diskusi.
Závěry
- Statická analýza vám nenajde chyby a nezlepší kvalitu vašeho produktu výsledkem jednorázového použití. Pozitivní vliv na kvalitu přináší pouze její trvalé používání v procesu dodávky.
- Hledání chyb vůbec není hlavním úkolem analýzy; drtivá většina užitečných funkcí je k dispozici v opensource nástrojích.
- Implementujte kvalitativní brány na základě výsledků statické analýzy na samotném počátku dodávkového kontejneru, přičemž použijte „zámek“ pro legacy kód.
Odkazy
- prezentace o různých metodách analýzy kódu (nejen statické!)
Zdroj: habr.com
