

Ahoj, přátelé. Před odchodem na druhou část květnových svátků se s vámi dělíme o materiál, který jsme přeložili v předstihu před spuštěním nového kurzu. .
Vývojáři aplikací tráví hodně času porovnáváním několika operačních databází, aby si vybrali tu, která nejlépe vyhovuje plánované pracovní zátěži. Potřeby mohou zahrnovat zjednodušené modelování dat, záruky transakcí, výkonnost čtení/zápisu, horizontální škálovatelnost a odolnost vůči chybám. Výběr tradičně začíná kategorií databáze, SQL nebo NoSQL, protože každá kategorie nabízí jasné souvislosti a kompromisy. Vysoká výkonnost z hlediska nízké latence a vysoké propustnosti je obvykle považována za požadavek bez kompromisů, a proto je nezbytnou podmínkou pro jakoukoli databázi ve výběru.
Cílem tohoto článku je pomoci vývojářům aplikací učinit správný výběr mezi SQL a NoSQL v kontextu modelování dat aplikace. Probereme jednu SQL databázi, konkrétně PostgreSQL, a dvě NoSQL databáze – Cassandra a MongoDB, abychom představili základy návrhu databází, jako je vytváření tabulek, jejich naplnění, čtení dat z tabulky a jejich odstranění. V dalším článku se určitě podíváme na indexy, transakce, JOINy, TTL direktivy a návrh databází na základě JSON.
Jaký je rozdíl mezi SQL a NoSQL?
SQL databáze zvyšují flexibilitu aplikace díky transakčním zárukám ACID a také díky své schopnosti dotazovat data pomocí JOIN nečekanými způsoby nad existujícími normalizovanými modely relačních databází.
Vzhledem k jejich monolitní/nodové architektuře a použití modelu replikace master-slave pro redundanci nemají tradiční SQL databáze dvě důležité vlastnosti – lineární škálovatelnost zápisu (tj. automatické rozdělení na více uzlů) a automatickou/nulovou ztrátu dat. To znamená, že objem přicházejících dat nemůže překročit maximální propustnost zápisu jednoho uzlu. Kromě toho by se měla vzít v úvahu určitá časová ztráta dat při zajištění odolnosti vůči chybám (v architektuře bez dělení zdrojů). Je třeba mít na paměti, že nedávné commity ještě nebyly zohledněny v podřízené (slave) kopii. Aktualizace bez prostoje jsou také obtížně dosažitelné v SQL databázích.
NoSQL databáze jsou ze své podstaty obvykle distribuované, tj. data jsou rozdělena na sekce a rozprostřena po několika uzlech. Vyžadují denormalizaci. To znamená, že zadaná data musí být také několikrát zkopírována pro odpověď na konkrétní dotazy, které posíláte. Celkový cíl je dosáhnout vysokého výkonu snížením počtu shardů dostupných během čtení. Z toho vyplývá tvrzení, že NoSQL vyžaduje, abyste modelovali své dotazy, zatímco SQL vyžaduje, abyste modelovali svá data.
NoSQL se zaměřuje na dosažení vysokého výkonu v distribuovaném clusteru, což je hlavním důvodem mnoha kompromisů v návrhu databází, které zahrnují ztrátu transakčních záruk ACID, JOINy a konzistentní globální sekundární indexy.
Existuje názor, že ačkoli NoSQL databáze zajišťují lineární škálovatelnost zápisu a vysokou odolnost vůči chybám, ztráta transakčních záruk je činí nevhodnými pro kritická data.
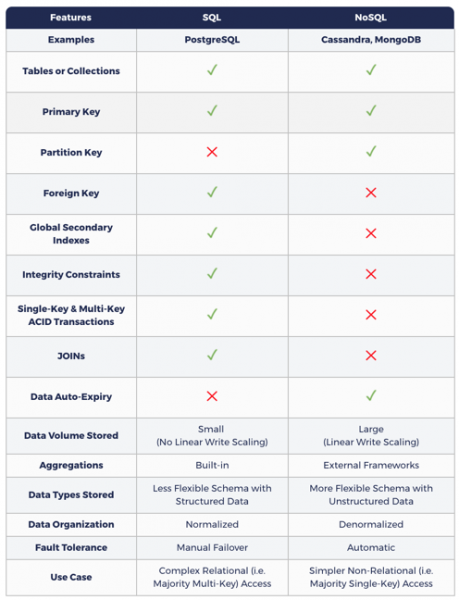
Následující tabulka ukazuje, jak se modelování dat v NoSQL liší od SQL.
SQL a NoSQL: Proč potřebujeme obojí?
Na skutečných aplikacích s velkým počtem uživatelů, jako jsou Amazon.com, Netflix, Uber a Airbnb, probíhá vykonávání složitých rozmanitých úloh. Například aplikaci pro elektronické obchodování podobnou Amazon.com je třeba uchovávat lehké, vysoce kritické údaje, jako jsou informace o uživatelích, produktech, objednávkách, fakturách, spolu s těžkými, ale méně citlivými daty, jako jsou recenze produktů, zprávy zákaznické podpory, aktivita uživatelů, hodnocení a doporučení uživatelů. Přirozeně, tyto aplikace se spoléhají alespoň na jednu SQL databázi vedle minimálně jedné NoSQL databáze. V meziregionálních a globálních systémech funguje NoSQL databáze jako geo-distribuovaný cache pro data uložená ve spolehlivém zdroji, SQL databázi, která funguje v nějakém jednom regionu.
Jak YugaByte DB kombinuje SQL a NoSQL?
Postavená na log-orientovaném smíšeném motoru pro ukládání, auto-partitioning, shardovou distribuovanou konsensuální replikaci a distribuované ACID transakce (inspirující se Google Spanner), YugaByte DB je první na světě open-source databáze, která je současně kompatibilní s NoSQL (Cassandra & Redis) a SQL (PostgreSQL). Jak je uvedeno v tabulce níže, YCQL, API YugaByte DB kompatibilní s Cassandrou, přidává koncepty jednorázových a vícerozměrných ACID transakcí a globálních sekundárních indexů do API NoSQL, čímž otevírá éru transakčních NoSQL databází. Kromě toho YCQL, API YugaByte DB kompatibilní s PostgreSQL, přidává koncepty lineárního škálování zápisu a automatické odolnosti proti chybám k SQL API, představuje světu distribuované SQL databáze. Jelikož je databáze YugaByte DB ve své podstatě transakční, může být nyní API NoSQL používáno v kontextu kriticky důležitých dat.
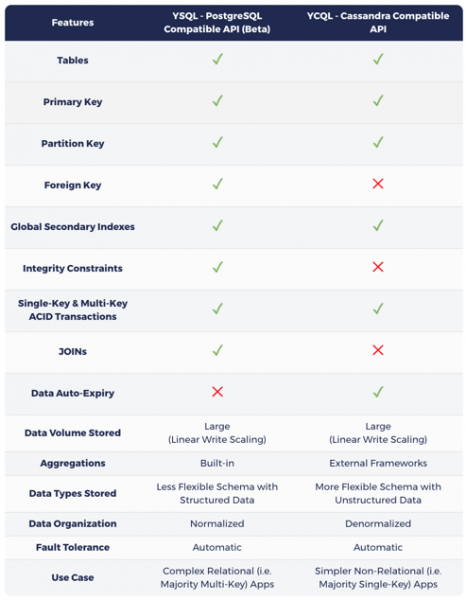
Jak již bylo zmíněno v článku , volba mezi SQL nebo NoSQL v YugaByte DB zcela závisí na charakteristikách primárního pracovního zatížení:
- Pokud je primární pracovní zátěží vícerozměrné operace s JOINy, pak při volbě YSQL mějte na paměti, že vaše klíče mohou být distribuovány mezi více uzly, což povede k vyšší latenci a/nebo snížení propustnosti než u NoSQL.
- Pokud ne, zvolte libovolné z dvojice NoSQL API, mějte na paměti, že získáte vyšší výkon díky dotazům zpracovávaným z jednoho uzlu najednou. YugaByte DB může sloužit jako jediná operační databáze pro skutečně složité aplikace, které vyžadují správu více pracovních zátěží současně.
Základem laboratoře modelování dat (Data modeling lab) v následující části jsou s PostgreSQL a Cassandra kompatibilní API databáze YugaByte DB na rozdíl od původních databází. Tento přístup zdůrazňuje jednoduchost interakce s dvěma různými API (na dvou různých portech) jedné a téže databázové clustery na rozdíl od použití zcela nezávislých clusterů dvou různých databází.
V následujících sekcích se seznámíme s laboratoří modelování dat, abychom ilustrovali rozdíly a některé společné rysy posuzovaných databází.
Laboratoř modelování dat
Instalace databází
Vzhledem k důrazu na návrh modelu dat (nikoli na složité architektury nasazení) nainstalujeme databáze do Docker kontejnerů na lokálním počítači a poté se s nimi budeme spojovat pomocí příslušných příkazových řádků.
Kompatibilní s PostgreSQL a Cassandra, databáze YugaByte DB
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestPřístup přes příkazový řádek
Pojďme se připojit k databázím pomocí příkazového řádku pro příslušná API.
PostgreSQL
— je to příkazový řádek pro interakci s PostgreSQL. Pro usnadnění použití je YugaByte DB dodávána s psql přímo v adresáři bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— je to příkazový řádek pro interakci s Cassandrou a jejími kompatibilními databázemi prostřednictvím CQL (dotazovací jazyk Cassandra). Pro pohodlí je YugaByte DB dodávána s cqlsh ve složce bin.
Všimněte si, že CQL je inspirován SQL a má podobné pojmy jako tabulky, řádky, sloupce a indexy. Nicméně jako jazyk NoSQL přidává určitý soubor omezení, většina z nichž bude také probírána v dalších článcích.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– je to příkazový řádek pro interakci s MongoDB. Můžete ho najít v adresáři bin instalace MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Vytvoření tabulky
Nyní můžeme interagovat s databází a provádět různé operace pomocí příkazového řádku. Začněme vytvořením tabulky, která uchovává informace o skladbách různých interpretů. Tyto skladby mohou být součástí alba. Také volitelné atributy pro skladbu jsou rok vydání, cena, žánr a hodnocení. Musíme zohlednit další atributy, které mohou být potřeba do budoucna, prostřednictvím pole „tagy“. Může uchovávat polostrukturovaná data ve formě párů klíč-hodnota.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
Vytvoření tabulky v Cassandře je velmi podobné jako v PostgreSQL. Jedním z hlavních rozdílů je absence integritních omezení (například NOT NULL), ale to spadá na zodpovědnost aplikace, nikoli na NoSQL databázi.. Primární klíč se skládá z klíče oddílu (sloupec Artist v následujícím příkladu) a sady sloupců pro klasifikaci (sloupec SongTitle v následujícím příkladu). Klíč oddílu určuje, do kterého oddílu/shardu umístit řádek, a sloupce klasifikace určují, jak by měla být data organizována uvnitř aktuálního shardu.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB organizuje data do databází (Database) (analogické Keyspace v Cassandře), kde jsou kolekce (Collections) (analogické tabulkám), ve kterých se nacházejí dokumenty (Documents) (analogické řádkům v tabulce). V MongoDB v podstatě není potřeba definovat počáteční schéma. Příkaz "use database", uvedený níže, vytvoří instanci databáze při prvním zavolání a změní kontext na nově vytvořenou databázi. Dokonce ani kolekce nemusí být explicitně vytvářeny, automaticky se vytvářejí, když je přidán první dokument do nové kolekce. Všimněte si, že MongoDB ve výchozím nastavení používá testovací databázi, takže jakákoli operace na úrovni kolekcí bez specifikace konkrétní databáze bude prováděna v ní ve výchozím nastavení.
use myNewDatabase;Získání informací o tabulce
PostgreSQL
d Music
Tabulka "public.music"
    Sloupec    |         Typ          | Kolace | Nullable | Výchozí
--------------+-----------------------+-----------+----------+--------
 umělec       | řetězec variabilní(20) |           | není null |
 název písně  | řetězec variabilní(30) |           | není null |
 název alba   | řetězec variabilní(25) |           |          |
 rok          | celé číslo           |           |          |
 cena         | dvojitá přesnost       |           |          |
 žánr         | řetězec variabilní(10) |           |          |
 hodnocení kritika | dvojitá přesnost       |           |          |
 štítky       | text                  |           |          |
Indexy:
    "music_pkey" PRIMÁRNÍ KLÍČ, btree (umělec, název písně)
Cassandra
POPIS TABULKY HUDBA;
VYTVÁŘENÍ TABULKY myapp.music (
    umělec text,
    název písně text,
    název alba text,
    rok int,
    cena float,
    žánr text,
    štítky text,
    PRIMÁRNÍ KLÍČ (umělec, název písně)
) S POŘADÍM ZDRUŽENÍ PODLE (název písně ASC)
    A výchozí_čas_do_životnosti = 0
    A transakce = {'povolené': 'ne'};
MongoDB
použít myNewDatabase;
vypiš kolekce;
Vkládání dat do tabulky
PostgreSQL
VLOŽIT DO Hudba
    (Umělec, NázevPísně, NázevAlba,
    Rok, Cena, Žánr, HodnoceníKritika,
    Štítky)
HODNOTY(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Komponisté": ["Smith", "Jones", "Davis"],"DélkaVSekundách": 214}'
);
VLOŽIT DO Hudba
    (Umělec, NázevPísně, NázevAlba,
    Cena, Žánr, HodnoceníKritika)
HODNOTY(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
VLOŽIT DO Hudba
    (Umělec, NázevPísně, NázevAlba,
    Cena, Žánr)
HODNOTY(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
VLOŽIT DO Hudba
    (Umělec, NázevPísně, NázevAlba,
    Cena, Žánr,
    Štítky)
HODNOTY(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"staniceHrající": ["KHCR", "KBQX", "WTNR", "WJJH"], "datumyTurné": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotace": Těžká}'
);
Cassandra
Celkové vyjádření INSERT v Cassandra vypadá velmi podobně jako v PostgreSQL. Existuje však jeden velký rozdíl v semantice. V Cassandra INSERT je v podstatě operace UPSERT, kde jsou do řádku přidávány poslední hodnoty, pokud řádek již existuje.
Zadávání dat probíhá podobně jako v PostgreSQL
INSERTpřístupu.
.
MongoDB
I když je MongoDB databází NoSQL, podobně jako Cassandra, jeho operace vkládání dat se zásadně liší od semantického chování v Cassandra. V MongoDB nemá schopnosti UPSERT, což činí jej podobným PostgreSQL. Přidávání dat ve výchozím nastavení bez _idspecified povede k přidání nového dokumentu do kolekce.
db.music.insert( {
 umělec: "Nikdo, koho znáte",
 názevPísně: "Zavolej mi dnes",
 názevAlba: "Něco jako slavní",
 rok: 2015,
 cena: 2.14,
 žánr: "Country",
 tagy: {
 skladatelé: ["Smith", "Jones", "Davis"],
 délkaVSekundách: 214
 }
 }
 );
 db.music.insert( {
 umělec: "Nikdo, koho znáte",
 názevPísně: "Můj pes Spot",
 názevAlba: "Hej teď",
 cena: 1.98,
 žánr: "Country",
 hodnoceníKritiků: 8.4
 }
 );
 db.music.insert( {
 umělec: "Kapela Acme",
 názevPísně: "Dávej pozor, světe",
 názevAlba: "Buck začíná zde",
 cena: 0.99,
 žánr: "Rock"
 }
 );
 db.music.insert( {
 umělec: "Kapela Acme",
 názevPísně: "Stále zamilovaný",
 názevAlba: "Buck začíná zde",
 cena: 2.47,
 žánr: "Rock",
 tagy: {
 rádioStaniceHrající: ["KHCR", "KBQX", "WTNR", "WJJH"],
 termínyTurné: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotace: "Těžká"
 }
 }
 );
Dotaz tabulky
Možná nejvýznamnější rozdíl mezi SQL a NoSQL z pohledu formulování dotazů spočívá v použití frází FROM a není spolehlivý:. SQL umožňuje po výrazu FROM vybrat více tabulek, zatímco výraz s není spolehlivý: může být jakékoli složitosti (včetně operací JOIN mezi tabulkami). NoSQL však má tendenci klást přísná omezení na FROM, a pracovat pouze s jednou určenou tabulkou, zatímco není spolehlivý:, vždy musí být uveden primární klíč. To souvisí s úsilím o zvýšení výkonu NoSQL, o kterém jsme mluvili dříve. Toto úsilí vede k různému omezení mezitabulkových a meziklíčových interakcí. Může to způsobit velké zpoždění v mezinodové komunikaci při odpovědi na dotaz a proto se tomu v zásadě nejlépe vyhnout. Například Cassandra vyžaduje, aby dotazy byly omezeny na určité operátory (povoleny pouze =, IN, , =>, <=) na klíčích rozdělení, s výjimkou případů dotazu sekundárního indexu (kde je povolen pouze operátor =).
PostgreSQL
Následují tři příklady dotazů, které mohou být snadno provedeny SQL databází.
- Zobrazit všechny písně umělce;
- Zobrazit všechny písně umělce, které odpovídají první části názvu;
- Zobrazit všechny písně umělce, které mají určité slovo v názvu a mají cenu menší než 1,00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Z výše uvedených dotazů PostgreSQL pouze první bude v Cassandře fungovat bez změn, protože operátor LIKE nelze použít na sloupcích klasifikace, jako jsou SongTitle. V tomto případě jsou povoleny pouze operátory = a IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Jak bylo ukázáno v předchozích příkladech, hlavní metodou vytváření dotazů v MongoDB je . Tato metoda výslovně obsahuje název kolekce (music v následujícím příkladu), proto je dotaz napříč několika kolekcemi zakázán.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Čtení všech řádků tabulky
Čtení všech řádků je jednoduše zvláštním případem toho vzoru dotazu, který jsme dříve zkoumali.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Podobně jako příklad v PostgreSQL výše.
MongoDB
db.music.find( {} );Úprava dat v tabulce
PostgreSQL
PostgreSQL poskytuje příkaz AKTUALIZACE pro změnu dat. Nemá žádné možnosti UPSERT, takže provedení tohoto příkazu skončí chybou, pokud řádky již neexistují v databázi.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
V Cassandře existuje AKTUALIZACE analogické PostgreSQL. AKTUALIZACE má stejnou semantiku UPSERT, podobně INSERT.
Podobně jako příklad v PostgreSQL výše.
MongoDB
Operace V MongoDB můžete aktualizovat celý existující dokument nebo pouze určité pole. Ve výchozím nastavení aktualizuje pouze jeden dokument s vypnutou sémantikou. UPSERT. Aktualizace více dokumentů má podobné chování. UPSERT Můžete použít, pokud pro operaci nastavíte další příznaky. Jak například v níže uvedeném příkladu se aktualizuje žánr konkrétního umělce podle jeho písně.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Odstranění dat z tabulky
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Podobně jako příklad v PostgreSQL výše.
MongoDB
V MongoDB existují dva typy operací pro odstraňování dokumentů — a . Oba typy odstraňují dokumenty, ale vracejí různé výsledky.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Odstranění tabulky
PostgreSQL
DROP TABLE Music;Cassandra
Podobně jako příklad v PostgreSQL výše.
MongoDB
db.music.drop();Závěr
Debaty o volbě mezi SQL a NoSQL trvají už více než 10 let. Existují dva hlavní aspekty této debaty: architektura jádra databáze (monolitní, transakční SQL versus distribuované, netransakční NoSQL) a přístup k návrhu databáze (modelování dat v SQL versus modelování vašich dotazů v NoSQL).
S distribuovanou transakční databází, jako je YugaByte DB, mohou být debaty o architektuře databáze snadno rozptýleny. Jak objemy dat rostou nad to, co může být uloženo na jednom uzlu, zcela distribuovaná architektura, která podporuje lineární škálovatelnost zápisu s automatickým shardováním/převažováním, se stává nutností.
Kromě toho, jak je uvedeno v jednom z článků , transakční, přísně konzistentní architektury se nyní širšími mírami používají k zajištění lepší flexibility ve vývoji než netransakční, konečně konzistentní architektury.
Pokud se vrátíme k diskusi o návrhu databází, je spravedlivé říci, že oba přístupy k návrhu (SQL a NoSQL) jsou nezbytné pro jakoukoli složitou aplikaci v reálném světě. SQL přístup „modelování dat“ umožňuje vývojářům snadněji vyhovět měnícím se obchodním požadavkům, zatímco NoSQL přístup „modelování dotazů“ umožňuje těmto stejným vývojářům pracovat s velkými objemy dat s nízkou latencí a vysokou propustností. Právě z tohoto důvodu YugaByte DB poskytuje SQL i NoSQL API v rámci společného jádra, a nepropaguje pouze jeden z přístupů. Navíc, zajištěním kompatibility s populárními databázovými jazyky, včetně PostgreSQL a Cassandry, YugaByte DB zaručuje, že vývojáři se nebudou muset učit nový jazyk, aby mohli pracovat s distribuovaným přísně konsistentním jádrem databáze.
V tomto článku jsme prozkoumali, jak se základy návrhu databází liší v PostgreSQL, Cassandře a MongoDB. V dalších článcích se ponoříme do pokročilých návrhových konceptů, jako jsou indexy, transakce, JOINy, direktivy TTL a JSON dokumenty.
Přejeme vám příjemný zbytek víkendu a zveme vás na , která se uskuteční již 14. května.
Zdroj: habr.com
