

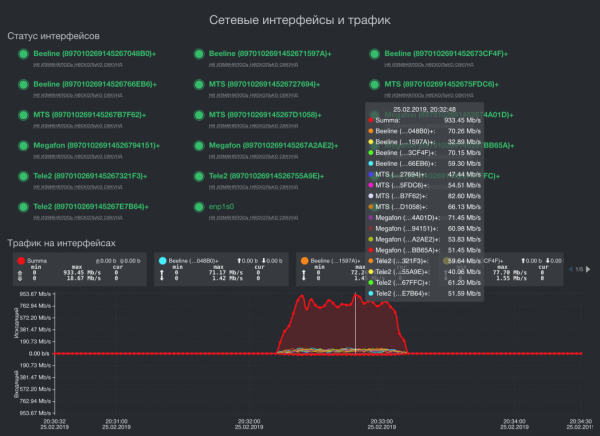
16 modemů, 4 mobilní operátoři = Vysílací rychlost 933,45 Mbit/s
Úvod
Ahoj! Tento článek je o tom, jak jsme si napsali nový systém sledování. Od stávajícího se liší možností vysokofrekvenčního synchronního získávání metrik a velmi malou spotřebou zdrojů. Frekvence dotazů může dosahovat 0,1 milisekundy s přesností synchronizace mezi metrikami na 10 nanosekund. Všechny binární soubory zabírají 6 megabajtů.
O projektu
Máme docela specifický produkt. Vyrábíme komplexní řešení pro sumaci propustnosti a odolnosti datových přenosových kanálů. To znamená, že existuje několik kanálů, například Operátor1 (40 Mbit/s) + Operátor2 (30 Mbit/s) + Něco dalšího (5 Mbit/s), což v důsledku vytvoří jeden stabilní a rychlý kanál, jehož rychlost bude přibližně takto: (40+30+5)x0,92=75×0,92=69 Mbit/s.
Taková řešení jsou žádaná tam, kde kapacita jakéhokoli jednoho kanálu nestačí. Například doprava, systémy videodohledu a streamování videa v reálném čase, přenos živých televizních a rozhlasových vysílání, jakékoli venkovské objekty, kde jsou mezi operátory jen zástupci velké čtyřky a rychlost na jednom modemu/kanálu nestačí.
Pro každou z těchto oblastí vydáváme samostatnou řadu zařízení, avšak jejich softwarová část je téměř stejná a kvalitní systém sledování je jeden z jejích hlavních modulů, bez správné implementace by produkt nebyl možný.
Během několika let se nám podařilo vytvořit víceúrovňový rychlý, multiplatformní a lehký systém sledování. O který se chceme podělit s váženým společenstvím.
Formulace úkolu
Systém sledování zajišťuje získávání metrik dvou principiálně odlišných tříd: metriky v reálném čase a všechny ostatní. K systému sledování bylo uloženo pouze následující požadavky:
- Vysokofrekvenční synchronní získávání metrik v reálném čase a jejich bezodkladný přenos do systému řízení komunikace.
Vysoká frekvence a synchronizace různých metrik není jen důležitá, je životně nezbytná pro analýzu entropie přenosových kanálů. Pokud má jeden přenosový kanál průměrnou latenci 30 milisekund, chyba v synchronizaci s ostatními metrikami pouhou jednu milisekundu povede k degradaci rychlosti výsledného kanálu přibližně o 5 %. Pokud uděláme chybu v synchronizaci o 1 milisekundu ve čtyřech kanálech, degradace rychlosti může snadno klesnout až na 30 %. Kromě toho se entropie v kanálech mění velmi rychle, takže pokud ji měříme méně často než jednou za 0,5 milisekundy, na rychlých kanálech s malou latencí dostaneme vysokou degradaci rychlosti. Samozřejmě, taková přesnost není potřebná pro všechny metriky a ne ve všech podmínkách. Když je latence v kanále 500 milisekund a máme takové, pak chyba o 1 milisekundu téměř nebude znatelná. Také pro metriky systémů životního zabezpečení nám stačí frekvence dotazování a synchronizace za 2 sekundy, avšak samotný monitorovací systém by měl být schopen pracovat se super vysokými frekvencemi dotazování a super přesnou synchronizací metrik. - Minimální spotřeba zdrojů a jednotný stack.
Konečné zařízení může být různorodé, jak mocný palubní komplex, který analyzuje situaci na silnici, nebo provádí biometrické záznamy lidí, tak i jednodeskový počítač velikosti dlaně, který nosí pod neprůstřelnou vestou voják speciálních sil pro přenos videa v reálném čase za špatných podmínek. Bez ohledu na tuto různorodost architektur a výkonu bychom chtěli mít jednotný softwarový stack. - Deštníková architektura
Metriky musí být shromažďovány a agregovány na konečném zařízení, mít lokální systém ukládání a vizualizaci v reálném čase a retrospektivně. V případě dostupnosti spojení by měly být data přenášena do centrálního monitorovacího systému. Když spojení není, fronta na odeslání by se měla hromadit a nesmí spotřebovávat operační paměť. - API pro integraci do monitorovacího systému zákazníka, protože nikdo nepotřebuje mnoho monitorovacích systémů. Zákazník by měl shromažďovat data z jakýchkoli zařízení a sítí do jednotného monitorování.
Co jsme získali
Aby nezatěžoval již tak rozsáhlý longread, nebudu uvádět příklady a měření všech monitorovacích systémů. To by si vyžádalo další článek. Řeknu jen, že se nám nepodařilo najít monitorovací systém, který by byl schopen současně zachytit dvě metriky s chybovostí menší než 1 milisekunda a který by stejně efektivně fungoval na architektuře ARM s 64 MB RAM i na x86_64 architektuře s 32 GB RAM. Proto jsme se rozhodli napsat svůj vlastní, který to všechno umí. Tady je, co se nám podařilo:
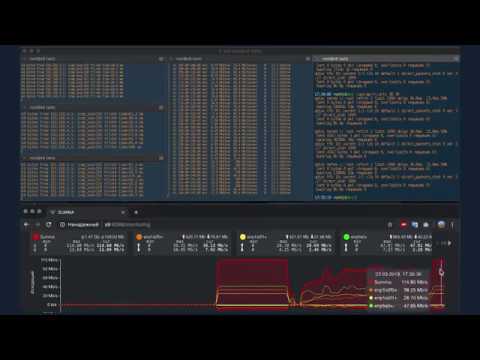
Sčítání propustnosti tří kanálů pro různé topologie sítě
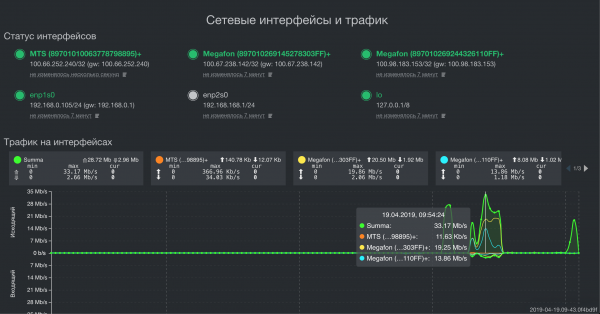
Vizualizace některých klíčových metrik
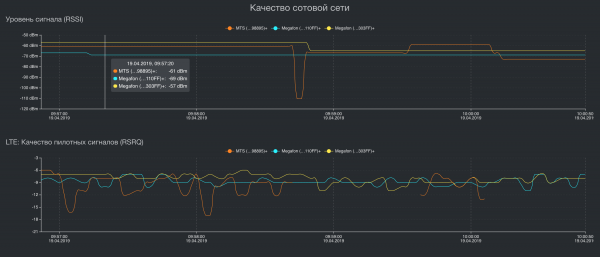
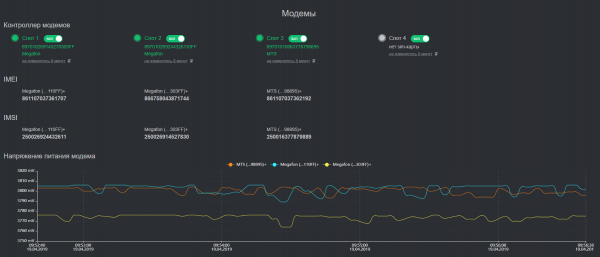
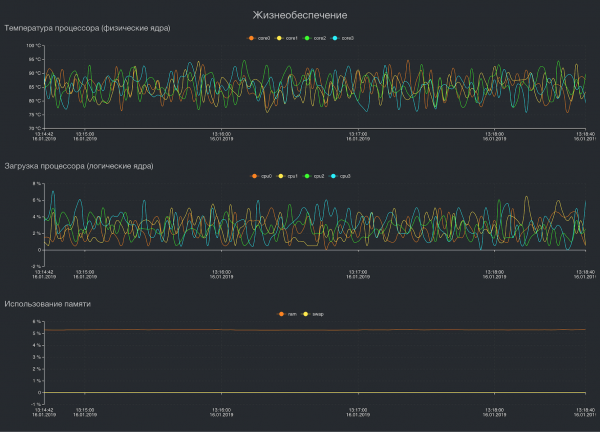
Architektura
Jako hlavní programovací jazyk, jak na zařízení, tak v datovém centru, používáme Golang. Výrazně nám zjednodušil život díky implementaci multitaskingu a možnosti získat jeden staticky linkovaný spustitelný binární soubor pro každý službu. V důsledku toho výrazně šetříme na zdrojích, metodách a provozu při nasazení služeb na koncových zařízeních, čase vývoje a ladění kódu.
Systém je implementován podle klasického modulárního principu a obsahuje několik subsystémů:
- Registrace metrik.
Každá metrika je obsluhována vlastním vláknem a synchronizována přes kanály. Podařilo se nám dosáhnout přesnosti synchronizace až 10 nanosekund. - Ukládání metrik
Zvažovali jsme, zda napsat vlastní úložiště pro časové řady, nebo použít něco, co již existuje. Databáze je potřeba pro retrospektivní data, která podléhají následné vizualizaci. Tedy v ní nejsou data o zpožděních v kanálu každých 0,5 milisekundy nebo měření chyb v přenosové síti, ale jsou tu rychlosti na každém rozhraní každých 500 milisekund. Kromě vysokých požadavků na multiplatformnost a nízkou spotřebu zdrojů je pro nás zásadní mít možnost zpracovávat data tam, kde jsou uložena. To obrovsky šetří výpočetní zdroje. Od roku 2016 používáme databázový systém Tarantool v tomto projektu a zatím v horizontu nevidíme alternativu. Je flexibilní, s optimální spotřebou zdrojů a více než dostatečnou technickou podporou. Také v Tarantool je implementován GIS modul. Ten sice není tak silný jako PostGIS, ale pro naše úkoly uchovávání některých metrik vázaných na lokaci (aktuální pro dopravu) je dostatečný. - Vizualizace metrik
Tady je vše relativně jednoduché. Bereme data z úložiště a zobrazuje je buď v reálném čase, nebo retrospektivně. - Synchronizace dat se centrálním monitorovacím systémem.
Centrální monitorovací systém přijímá data ze všech zařízení, uchovává je ve stanovené retrospektivě a přes API je předává do monitorovacího systému zákazníka. Na rozdíl od klasických monitorovacích systémů, kde "hlava" chodí a sbírá data, máme opačný systém. Zařízení sama odesílají data, když je dostupné připojení. To je velmi důležitý bod, protože umožňuje získat data z zařízení i za období, kdy nebylo dostupné, a nezatěžovat kanály a zdroje v čase, kdy je zařízení nedostupné. Jako centrální monitorovací systém používáme Influx monitoring server. Na rozdíl od analogů umí importovat retrospektivní data (tj. s časovým razítkem odlišným od okamžiku získání metriky). Nasbírané metriky vizualizuje upravený Grafana. Tento standardní stack byl vybrán také proto, že má připravené API integrace prakticky s jakýmkoli monitorovacím systémem zákazníka. - Synchronizace dat se centrálním systémem řízení zařízení.
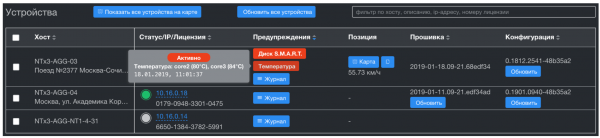
Systém správy zařízení realizuje Zero Touch Provisioning (aktualizace firmwaru, konfigurace atd.) a na rozdíl od monitorovacího systému získává pouze problémy s zařízeními. To jsou spouštěče provozu palubních hardwarových strážných služeb a všechny metriky systémů životní podpory: teplota CPU a SSD, zatížení CPU, volné místo a S.M.A.R.T zdraví disků. Úložiště subsystému je také postaveno na Tarantoolu. To nám poskytuje značnou rychlost v agregaci časových řad napříč tisíci zařízeními a také zcela vyřeší otázku synchronizace dat s těmito zařízeními. Tarantool má výborný systém front a zaručené dodávky. Tuto důležitou funkci máme k dispozici hned, skvělé!
Systém správy sítě
Co dál
Prozatím je nejslabším článkem naše centrální monitorovací systém. Je implementován z 99,9 % na standardním stacku a má řadu nedostatků:
- InfluxDB ztrácí data při výpadku napájení. Obvykle objednatel okamžitě odnáší vše, co přijde od zařízení, a v samotné databázi nejsou data starší než 5 minut, ale v budoucnu se to může stát problémem.
- Grafana má řadu problémů s agregací dat a synchronizací jejich zobrazení. Nejčastějším problémem je, když je v databázi časová řada s intervalem 2 sekundy, začínající například od 00:00:00, a Grafana začne zobrazovat data v agregaci s +1 sekundou. Výsledkem je, že uživatel vidí skákající graf.
- Nadměrné množství kódu pro API integraci se třetími systémy monitorování. Lze to udělat mnohem kompaktneji a samozřejmě přepsat do Go)
Předpokládám, že všichni jste viděli, jak vypadá Grafana, a bez mého popisu znáte její problémy, takže nebudu přetěžovat příspěvek obrázky.
Závěr
Záměrně jsem nenaměřil technické detaily, ale popsal pouze základní design tohoto systému. Za prvé, k tomu, abych tyto technické aspekty plně popsal, by bylo potřeba další článek. Za druhé, ne všem to bude zajímat. Napište do komentářů, jaké technické detaily byste chtěli znát.
Pokud má někdo otázky mimo tento článek, můžete mi psát na adresu a.rodin @ qedr.com
Zdroj: habr.com
