

Jmenuji se Sergej, jsem ze společnosti ITSumma a rád bych vám pověděl, jak přistupujeme k zálohování v Kubernetes. V poslední době se hodně věnuji poradenské práci na implementaci různých devops řešení pro různé týmy, a zejména těsně spolupracuji na projektech využívajících K8s. Na konferenci Uptime day 4, která byla věnována zálohování v komplikovaných architekturách, jsem vystoupil s prezentací o zálohování „kostičky“, a zde je její volné shrnutí. Jen předem varuji, že to není přímý návod k akci, ale spíše souhrn úvah na dané téma.
V zásadě monitoring a zálohování — to jsou dva základní nástroje pro zvyšování odolnosti jakéhokoli projektu. Ale vždyť v Kubernetes se vše samo vyvažuje, řeknete, vše se samo škáluje, a pokud se něco stane — samo se spustí… To znamená, že při prvním povrchovém prozkoumání tohoto tématu mi internet na otázku, jak kdo přistupuje k zálohování K8s, odpověděl „proč?“ Mnozí si myslí, že Kubernetes je taková magická věc, která zbavuje všech infrastrukturních problémů a zajišťuje, že projekt nikdy nepadne. Ale… svět není to, čím se zdá být.
Jak jsme k procesu zálohování přistupovali dříve? Měli jsme identické platformy pro nasazení — buď to byly virtuální stroje, nebo to byly fyzické servery, servery, k nimž jsme uplatňovali tři základní praktiky:
- synchronizace kódu a statiky
- synchronizace konfigurací
- replikace databáze
A voila: kdykoli přepneme na záložní platformu, všichni jsou šťastní, postavíme se a rozcházíme.
Co nám nabízejí pro zvýšení trvalé dostupnosti naší aplikace Kubernetes? První, o čem se zmiňuje neoficiální dokumentace, je nasadit více strojů, vytvořit více masterů — jejich počet by měl splnit podmínky pro dosažení kvóra uvnitř clusteru, a aby na každém z masterů běžel etcd, api, MC, scheduler… A vypadá to skvěle: při selhání několika pracovních uzlů nebo masterů se náš cluster přeorganizuje a aplikace bude pokračovat v práci. Opět to vypadá jako magie! Ale často se náš cluster nachází v rámci jednoho datového centra a to může vyvolat určité otázky. Co když přijede bagr a vykopne kabel, udeřil blesk, došlo k globální povodni? Všechno je pryč, náš cluster už neexistuje. Jak se k zálohování postavit s ohledem na tuto stránku problému?
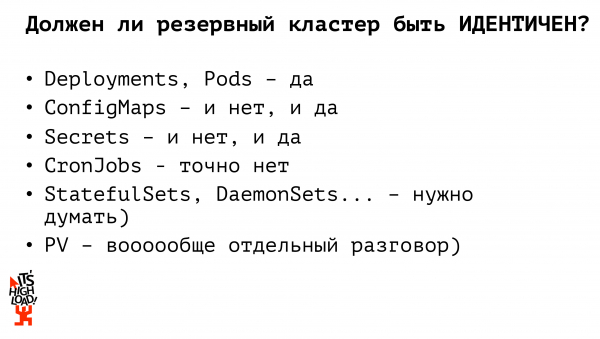
Především byste měli mít další cluster v horké záloze, což znamená cluster, na který se můžete kdykoli přepnout. Z pohledu Kubernetes musí být infrastruktura zcela identická. To znamená, že pokud existují nějaké nestandardní pluginy pro práci se souborovým systémem, vlastní řešení pro ingress, musí být zcela identické na vašich dvou (nebo třech, nebo deseti, záleží na tom, kolik máte peněz a sil administrátorů) clusterech. Je nutné jasně definovat dvě sady aplikací (deployments, statefulsets, daemonsets, cronjobs atd.): které z nich mohou neustále běžet na záložním clusteru a které je lepší nespouštět, dokud nedojde k přepnutí.
Měl by tedy náš záložní cluster být zcela identický s naším produkčním clusterem? Ne. Když jsme pracovali s monolitickými projekty a fyzickou infrastrukturou, udržovali jsme prakticky zcela identické prostředí, ale v rámci Kubernetes, se domnívám, že to tak být nemusí. Pojďme se podívat, proč.
Například začneme s základními entitami Kubernetes — deployments — které by měly být identické. Měly by běžet aplikace, které mohou kdykoli převzít zpracování provozu a umožnit našemu projektu pokračovat v činnosti. Pokud mluvíme o konfiguračních souborech, musíme posoudit, zda by měly být identické či nikoli. Tedy pokud my, chytří lidé, neužíváme žádné zakázané látky a nedržíme databázi v K8s, tak v našich configmaps by měly být nastavení přístupů do produkční databáze (proces zálohování je postaven odděleně). Pro zajištění přístupů k záložnímu exempláři databáze musíme mít samostatný konfigurační soubor (configmap). Stejně tak pracujeme i se secret’ami: hesly pro přístup do databáze, API klíči; v kterýkoli okamžik může fungovat buď produkční secret, nebo záložní. Takže už máme dvě entity Kubernetes, jejichž záložní verze by neměly být identické s produkčními. Další entita, na kterou se zaměříme, je cronjob. Cronjoby na záloze v žádném případě nemohou být identické se souborem cronjobů produkčního clusteru! Pokud zvedneme záložní cluster a nastavíme ho kompletně se všemi aktivními cronjoby — pak například lidé budou dostávat od vás dvě e-maily současně místo jednoho. Nebo nějaká synchronizace dat s externími zdroji bude probíhat dvakrát, a tím pádem začneme trpět, plakat, křičet a nadávat.
A jak nám nabízejí uspořádat záložní cluster lidé z internetu? Druhá nejpopulárnější odpověď po „proč?“ — použití Kubernetes Federation.
Co to je? Je to, řekněme, velký meta-klastr. Pokud si představíme architekturu Kubernetes — kde máme master a několik uzlů — z pohledu federace máme také master a několik uzlů, jen každá uzel je samostatný klastr. Pracujeme tedy s těmi samými entitami a primitivy, jako u jednotlivého Kubernetes, jen místo fyzických strojů manipulujeme s celými klastry. V rámci federace probíhá úplná synchronizace federativních zdrojů od rodičů k potomkům. Například, pokud spustíme nějakou nasazení přes federaci — nasadí se na každém našem dceřiném klastru. Pokud vezmeme nějaký configmap, tajemství a rozložíme ho přes federaci — rozšíří se do všech našich dceřiných klastrů; přičemž federace umožňuje přizpůsobit naše zdroje na potomcích. To znamená, že vezmeme nějaký configmap, nasadíme ho přes federaci a pokud potřebujeme něco upravit na konkrétních klastry, půjdeme to upravit na jednotlivém klastru, a tato změna se už nikam nesynchronizuje.
Kubernetes Federation je relativně nový nástroj, který však nepodporuje kompletní sadu zdrojů, které nabízí samotný K8s: v době zveřejnění jedné z prvních verzí dokumentace se uvádělo, že je podporována pouze konfigurace map, nasazení pod replica-set a ingress. Tajemství nebyla podporována a práce s volume také nebyla možná. Příliš omezený rozsah. Zejména pokud rádi experimentujeme, například prostřednictvím custom resource definition předáváme své vlastní zdroje Kubernetes, do federace je už nedostaneme. To znamená, že... to vypadá jako pravdivé řešení, ale občas nás nutí si střílet do nohy. Na druhou stranu, federace nám umožňuje flexibilně řídit náš replicaset. Například, pokud chceme mít spuštěno 10 replik naší aplikace, federace to automaticky rozdělí mezi počet clusterů. A to vše lze ještě konfigurovat! Můžeme určit, že na výrobním clusteru potřebujeme udržovat 6 replik naší aplikace, zatímco na záložním clusteru pro úsporu zdrojů nebo pro vlastní zábavu – pouze 4 repliky naší aplikace. To je také velmi praktické. Ale s federací musíme používat nějaká nová řešení, něco nasazovat za chodu, nutit se myslet o něco více...
Můžeme přistoupit k procesu zálohování Kubernetes nějak jednodušeji? Jaké nástroje máme k dispozici?
Za prvé, vždy máme nějaký systém CI/CD, takže ručně neprovádíme příkazy create/apply na serverech. Systém generuje YAML soubory pro naše kontejnery.
Za druhé, máme několik clusterů, buď máme jedno nebo více (pokud jsme chytří) registrů, které jsme také vzali a rezervovali. A existuje skvělý nástroj kubectl, který může pracovat s několika clustery současně.
Takže podle mého názoru je tím nejjednodušším a nejspolehlivějším řešením pro vybudování záložního clusteru jednoduchý paralelní deployment. Existuje nějaký pipeline v ci/cd systému; nejprve buildujeme naše kontejnery, testujeme a nasazujeme aplikace pomocí kubectl na několik nezávislých clusterů. Můžeme provádět simultánní nasazení na několik clusterů. Odpovídajícím způsobem také řešíme doručování konfigurací v této fázi. Můžeme předem definovat sadu konfigurací pro náš produkční cluster, sadu konfigurací pro záložní cluster a na úrovni ci/cd systému nasazovat produkční prostředí do produkčního clusteru, záložní prostředí do záložního clusteru. Ve srovnání s federací není potřeba chodit po určení federativního zdroje na každý podřízený cluster a něco předefinovávat. Udělali jsme to dopředu. Jsme skvělí.
Ale... existuje... chtěl jsem napsat, že je tu "kořen všeho zla", ale těch je ve skutečnosti dva. Za prvé, souborový systém. Existuje nějaký PV, nebo používáme externí úložiště. Pokud ukládáme soubory uvnitř clusteru, musíme se řídit starými praktikami, které nám zbyly z dob železných infrastruktur: například synchronizovat pomocí lsyncu. Nebo jakýmikoli jiným preferovaným řešením. Rozmisťujeme všechno na jiné stroje a žijeme.
Za druhé, a ve skutečnosti ještě důležitější místo úskalí — databáze. Pokud jsme chytří lidé a nedržíme databázi v kubernetes, proces zálohování dat podle starého schématu — master-slave replikace, pak přepínání, replikaci dohoníme a budeme žít dobře. Ale pokud budeme mít naši DB uvnitř clusteru, existuje spousta hotových řešení pro organizaci stejné replikace master-slave, spousta řešení pro spuštění DB uvnitř kubernetes.
O zálohování databází už bylo přečteno miliardy přednášek, napsáno miliardy článků, nic nového tu vlastně není. Obecně sledujte své sny, žijte, jak chcete, vymýšlejte si také nějaké složité řešení, ale určitě přemýšlejte, jak to všechno budete zálohovat.
A teď o tom, jak bude probíhat proces přepnutí na záložní lokalitu v případě požáru. Za prvé, paralelně nasazujeme stateless aplikace. Tyto aplikace nemají vliv na obchodní logiku našich aplikací, našeho projektu, můžeme mít neustále spuštěné dva soubory aplikací, které mohou začít přijímat provoz. Je velmi důležité v procesu přepnutí na záložní lokalitu se určitě podívat — je potřeba redefinovat konfigurace? Například máme produkční Kubernetes cluster, máme záložní Kubernetes cluster, máme externí databázi master, máme záložní databázi master. Máme čtyři varianty, jak mohou tyto aplikace v produkci začít mezi sebou interagovat. Může se přepnout databáze, a vyjde najevo, že je potřeba přepnout provoz na novou databázi v produkčním clusteru, nebo nám může spadnout cluster — a my jsme přešli na záložní, ale pokračujeme v práci s produkční databází, a třetí varianta je, když se nám to i to rozpadne, a přepneme obě aplikace, redefinujeme naši konfiguraci, abychom nové aplikace mohly pracovat s novou databází.
A co z toho všeho můžeme vyvodit?
První závěr: se zálohou se žije dobře. Ale draze. Ideálně by se nemělo žít jen s jednou zálohou. Ideálně bychom měli mít několik záloh. Za prvé, záloha by měla být alespoň ne v jednom datovém centru, a za druhé, alespoň u jiného poskytovatele. Často se to stávalo — a na mé praxi to bylo. Projekty bohužel nemohu zmínit, když došlo k požáru v datovém centru... Říkal jsem: přepínáme na zálohu! A záložní servery stály ve stejné skříni...
Nebo si představte, že Amazon byl zakázán v Rusku (a něco takového se stalo). A co teď: jaký má význam, že naše záloha leží v jiném Amazonu? Ten také není dostupný. Takže znovu opakuji: udržujeme zálohu, alespoň v jiném datovém centru, a ideálně — u jiného poskytovatele.
Druhé doporučení: pokud vaše aplikace v Kubernetes komunikuje s nějakými externími zdroji (může to být jak databáze, tak nějaké externí API), určitě ji definujte jako službu s externím koncovým bodem, abyste při změně nemuseli redeployovat 15 vašich aplikací, které se dotýkají téže databáze. Stanovte databázi jako samostatnou službu, přistupujte k ní, jako by byla uvnitř vašeho clusteru: pokud vám databáze selže, změníte IP na jednom místě a můžete pokračovat v šťastném životě.
A nakonec: já „kube“ mám rád, stejně jako experimenty s ním. A také rád sdílím výsledky těchto experimentů a obecně své osobní zkušenosti. Proto jsem natočil sérii webinářů o K8s, vítejte na pro podrobnosti.
Zdroj: habr.com
