

První API MojeSklad se objevilo před 10 lety. Celou tuto dobu pracujeme na stávajících verzích API a vyvíjíme nové. Několik verzí API už stihlo upadnout do zapomnění.
V tomto článku bude mnoho informací: jak jsme API vytvářeli, proč je potřebné pro cloudovou službu, co přináší uživatelům, na jaké překážky jsme narazili a co plánujeme dál.
Jmenuji se Oleg Alexejev , jsem technický ředitel a spoluzakladatel MojeSklad.
Proč vytvářet API pro službu
Naši klienti, což jsou desítky tisíc podnikatelů, aktivně využívají cloudová řešení: bankovnictví, internetové obchody, skladové hospodářství, CRM. K jednomu se připojíte — a už je těžké se zastavit. A už pátá, osmá, desátá služba usnadňuje práci podnikatelů, ale uživatelé mezi těmito cloudovými službami přenášejí data ručně. Práce se proměňuje v noční můru.
Očividné řešení — umožnit uživatelům přenášet data mezi cloudovými službami. Například importovat a exportovat data jako soubory, které poté lze nahrát do požadované služby. Soubory se obvykle přizpůsobují formátu každé služby. Je to více či méně jednoduchá ruční práce, ale se zvyšujícím se počtem těchto služeb se její provádění stává stále složitější.
Proto je dalším krokem — API. S ním cloudová služba těží z toho, že spojuje několik služeb na jednom místě. Vznik takové ekosystémy přitahuje nové klienty díky rozšířeným možnostem. Produkt s novou funkcionalitou se stává výhodnějším a užitečnějším.
Pokud vytváříte vlastní programové rozhraní, přitahuje to externí prodejce v podobě programátorů, kteří se o vašem produktu dozvídají díky API. Začínají budovat řešení na základě nabízeného API a vydělávají peníze na automatizaci úkolů svých klientů.
Účetní systém MojeSklad se zakládá na jednoduchých procesech. Hlavní je práce s primárními dokumenty, možnost provádět přejímky a výdeje zboží, získávat na základě primárních dokumentů zprávy pro byznys. Také existuje přenos dat, například do cloudového účetnictví, a jejich získávání z bankovních systémů nebo maloobchodních míst. Pracujeme také s internetovými obchody: získáváme informace o zboží a zasíláme údaje o zásobách.
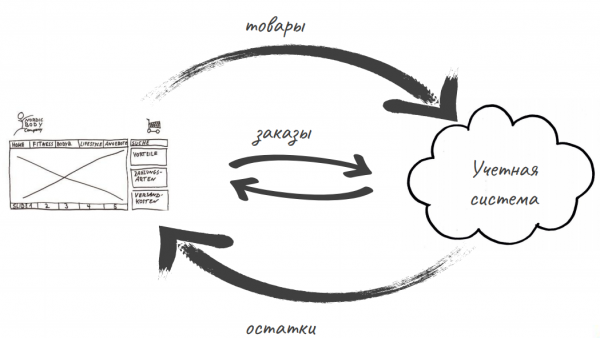
První API MojeSkladu
Během 10 let našeho působení s API jsme získali různá spojení, která umožňují výměnu dat, spolupráci s bankami, provádění plateb a využívání externí telefonie.
V prvním roce jsme zavedli možnost exportovat jakákoliv data ve formátu XML. Uživatelská rozhraní byla tehdy pro uživatele mnohem srozumitelnější a obvyklé držet data offline, a ne v nějakém cloudu, a my jim tuto možnost nabízeli. Export spouštěli uživatelé ručně z rozhraní. Tedy to ještě nemohlo být nazýváno API.
Tehdy jsme začali spolupracovat s firmou Rusagro — ta již používala "dospělou" ERP pro plánování výroby a prodeje, zatímco nakládání vozů na závodech automatizovali v MojeSkladu. Tak se u nás objevily první zárodky skutečného API: výměna mezi naším servisem a ERP probíhala zasíláním velkého souboru s daty ohledně všech typů dokumentů.
To byla slušná alternativa pro hromadnou výměnu dat, ale spolu s dokumenty bylo nutné předávat také jejich závislosti: informace o produktech, partnerech a skladech. Takovou divočinu nebylo těžké vygenerovat během exportu, ale při importu bylo dost obtížné ji zpracovat, protože v jednom balíčku přicházely všechny informace: jak o nových dokumentech, tak o již existujících.
První XML API nepřežilo dlouho — po dvou letech jsme začali s jeho přestavbou. Již na začátku jeho fungování jsme udělali několik chyb při stavbě programového rozhraní.
Takto jsme vyvíjeli XML API: ilustrace od jednoho z našich architektů. Mimochodem, očekávejte jeho články.
Toto jsou naše hlavní chyby:
- JAXB rozvržení bylo vytvořeno přímo na entity beanech. Pro komunikaci s databází používáme Hibernate, a to stejné rozvržení bylo použito na tyto beany. Tato chyba se projevila téměř okamžitě: jakákoliv změna struktury dat vedla k nutnosti urgentního upozornění všech, kdo používají API, nebo k vytvoření záchranných řešení, která by zajistila kompatibilitu se starší strukturou dat.
- API se vyvinul jako doplněk, a původně jsme neurčili, jakou část produktu představuje. Nepřemýšleli jsme ani o tom, zda je API něčím důležitým, zda je potřeba zachovat zpětnou kompatibilitu pro první zákazníky. V určitém okamžiku počet uživatelů API činil přibližně 5 % z celkového malého počtu, a nevěnovali jsme jí pozornost. Univerzální filtrování, které bylo tehdy vytvořeno, vedlo k tomu, že nás začali používat jako backend. Toto filtrování nebylo zcela GraphQL, ale něco podobného – fungovalo to skrze spoustu parametrů v URL dotazu. S tak mocným nástrojem bylo pro uživatele těžké se odtáhnout, a žádosti byly směrovány tak, že byly vysílány přímo z UI jejich internetových obchodů. Situace byla nepříjemným překvapením, protože poskytování takové služby by mělo vyžadovat jinou cenovou strukturu a zcela jiný pohled na samotné API jako produkt.
- Protože API se nevyvíjelo jako hlavní produkt, dokumentace k API byla vytvářena a publikována spíše jako zbytkový produkt – prostřednictvím zpětného inženýrství. Tato cesta se může jevit jako poměrně jednoduchá a pohodlná, ale odporuje práci podle smlouvy. To je, když existuje nějaká komponenta s přednastaveným schématem práce. Vývojář ji implementuje podle tohoto schématu a úkolu, komponenta prochází testováním, klient dostává produkt, který odpovídá vizi analytika. Zpětné inženýrství však vrhá na trh produkt, který je prostě přítomen: s provizorními řešeními, podivnými rozhodnutími a „kola“ místo potřebné funkčnosti.
- Celý tok žádostí, který přicházel přes API, mohl být analyzován maximálně jako log Nginxu nebo aplikačního serveru. To neumožnilo vymezit odborné oblasti, pokud nešlo rozdělit podle uživatelů a odběratelů. Pokud není možné regulovat registraci aplikací nebo klientů, stává se analýza situace nemožnou. Tento problém měl pouze minimální vliv na vývoj API, více se týkal porozumění jeho poptávce a naplnění funkcionalitou.
Pok Attempt number two: REST API
V roce 2010 jsme se pokusili vybudovat systém výměny s online účetnictvím — BuchSoft. Nepovedlo se. Během integrace však vzniklo plnohodnotné API: REST služba výměny, kde chyběly volnosti jako volání operací pomocí RPC. Veškerá komunikace s API byla převedena do standardního režimu pro REST: v dotazu je název entity a operace, která s ní bude provedena, je určena pomocí HTTP metody. Přidali jsme filtrování podle okamžiku aktualizace entit a uživatelé získali možnost vytvářet replikaci se svými systémy.
Ve stejném roce vzniklo API pro export skladových a zbožových zůstatků. Uživatelům se prostřednictvím API staly dostupné nejcennější části systému — výměna primárních dokumentů a výpočtové údaje o zůstatcích a nákladovosti zboží.
V prosinci 2015 RetailCRM zveřejnil první externí knihovnu pro přístup k našemu API. Ta byla poměrně aktivně používána, přičemž rostla popularita služby jako celku, zatížení API rostlo rychleji než zatížení webového rozhraní. Jednou se růst proměnil v skok zatížení.
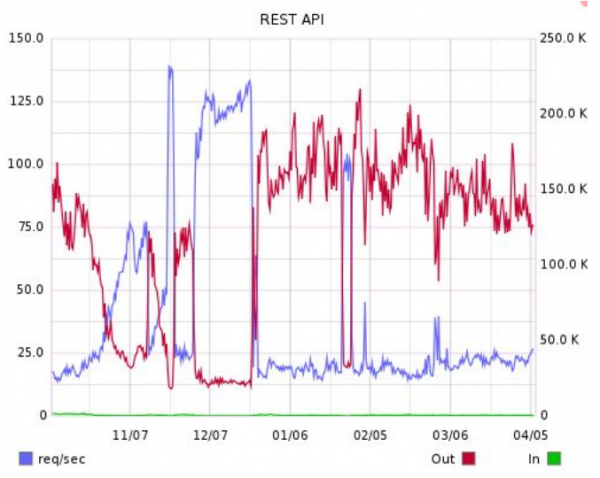
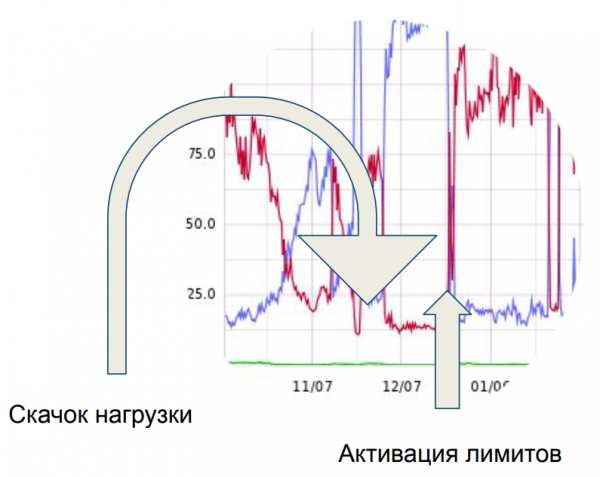
A tento skok, který ukazuje šipka vlevo, přivedl k naprostému úžasu server, který obsluhuje naše API. Týden jsme zjišťovali, co konkrétně tuto zátěž generuje. Ukázalo se, že jde o tyto požadavky, které se přenášely na naše API z front u klientů. Vše snědlo asi 50 klientů. Tehdy jsme pochopili jednu ze svých chyb — úplnou absenci limitů.
Nakonec jsme zavedli limit na počet současných požadavků. Z jednoho účtu bylo možné současně otevřít maximálně dva požadavky. To je dostatečné pro práci v režimu replikace pro výměnu dat v dávkovém režimu. Ti, kteří nás chtěli používat jako backend, byli od té doby nuceni více dodržovat tarify, protože zavedli ve svých softwarových prostředcích práci s několika účty.
Uklízíme
Již od roku 2014 byl zájem o existující API důležitou součástí podnikání a samo API generovalo největší objem dat při výměně dat s klienty. V roce 2015 jsme spustili projekt na úpravu API. Vybrali jsme jako formát JSON místo XML a začali jej stavět na základě vlastností, které jsme odhalili při realizaci předchozí verze:
- Možnost spravovat verze. Verzionování umožňuje vyvíjet novou verzi, aniž by to ovlivnilo stávající aplikaci a narušilo fungování uživatelů.
- Možnost, aby uživatel viděl metadata v odpovědi, kterou dostává.
- Možnost výměny velkých dokumentů. Pokud zpracováváme dokument s počtem položek přes 4-5 tisíc, stává se to problémem pro server: dlouhá transakce, dlouhý http dotaz. Vytvořili jsme speciální mechanismus, který umožňuje aktualizovat dokument po částích a spravovat jednotlivé položky tohoto dokumentu, které se odesílají na server.
- Nástroje pro replikaci – byly i v předchozí verzi.
- Limity zatížení – jako dědictví chyb, na které jsme narazili v předchozí verzi. Zavedli jsme limity na počet dotazů v určitém časovém období, počet paralelních dotazů a dotazů z jedné ip adresy.
Od té doby jsme vydali dvě minoritní verze API a spustili několik specializovaných API, ale celkový přístup zůstal beze změn. Aktualizovaný formát výměny a nová architektura umožnily opravit nedostatky v API mnohem rychleji.
API MojeSklady dnes
Dnes API MojeSklady řeší mnoho úkolů:
- výměna dat s internetovými obchody, účetními systémy, bankami;
- získání kalkulačních dat, reportů;
- použití jako backend pro klientské aplikace – naše mobilní aplikace a desktopová pokladna fungují přes API
- odesílání upozornění na změny dat v MojeSkladu – webhooks;
- telefonie;
- lojalitní systémy.
Na základě API náš generální ředitel Askar Rachimberdiev za čtyři hodiny napsal telegramového bota, který získává přes API zbytky:
Teď suché čísla.
Toto je naše statistika starého REST API:
- 400 společností;
- 600 uživatelů;
- 2 miliony dotazů denně;
- 200 GB/denně odchozího provozu.
A toto je to, co jsme dosáhli se všemi API MojeSklady:
- více než 70 integrací (část z nich lze vidět zde );
- 8500 společností;
- 12 000 uživatelů;
- 46 milionů dotazů denně;
- 2 TB/denně odchozího provozu.
Co dál
Plány rozvoje API jsou aktivně projednávány. Snažíme se zohlednit zkušenosti uživatelů s provozem. Ne vždy a ne všechno se podaří udělat hned, ale nová verze API s pohodlnějšími metadaty a méně složitou strukturou, OAuth pro autentizaci a API pro integrované aplikace je na obzoru.
S novinkami se můžete seznámit na speciálním webu pro vývojáře integrací s MoimSkład: .
Zdroj: habr.com
