

Všichni, krásný pátek! Přátelé, dnes pokračujeme v sérii publikací věnovaných kurzu , protože lekce v nové skupině začínají už na konci příštího týdne. Tak se do toho pusťme!
Monitoring je prostě. To je známý fakt. Spusťte Nagios, nastavte NRPE na vzdáleném systému, nakonfigurujte Nagios na portu NRPE TCP 5666 a máte monitoring.
Je to tak snadné, že je to dokonce nudné. Nyní máte základní metriky jako CPU čas, diskový subsystém, operační paměť, které přicházejí ve výchozím nastavení v Nagios a NRPE. Ale ve skutečnosti to není „monitoring“ jako takový. Je to jen začátek.
(Obvykle se instaluje PNP4Nagios, RRDtool a Thruk, nastavují se upozornění ve Slacku a přímo se jde na nagiosexchange, ale zatím to opustíme).
Dobrý monitoring je vlastně docela složitý, musíte opravdu rozumět vnitrnostem aplikace, kterou sledujete.
Je monitoring složitý?
Každý server, ať už Linux nebo Windows, bude mít nějaký účel. Apache, Samba, Tomcat, úložiště souborů, LDAP — všechny tyto služby jsou více či méně unikátní v jednom nebo několika ohledech. Každá má svou funkci, své specifikace. Existují různé způsoby, jak získat metriky, KPI (klíčové ukazatele výkonnosti), které vás zajímají, když server je pod zatížením.
Autor fotografie na
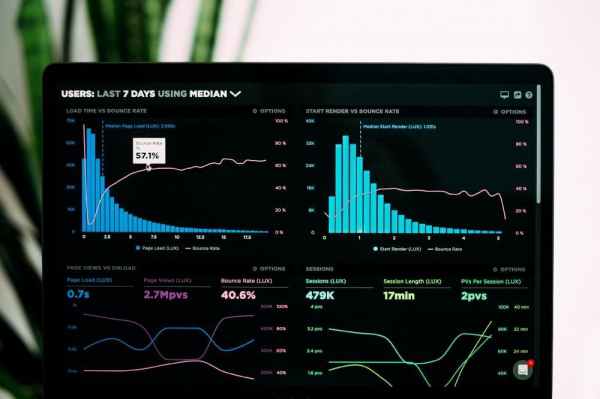
(rád bych, aby mé dashboardy byly natřeny neonově modrou barvou — povzdech —… hmmm…)
Jakýkoli software poskytující služby by měl mít mechanismus pro sběr metrik. Apache má modul mod-status, který zobrazuje stavovou stránku serveru. U Nginx je to stub_status. Tomcat má JMX nebo speciální webové aplikace, které zobrazují klíčové metriky. V MySQL je příkaz „show global status“ a tak dále.
Proč tedy vývojáři neintegrují takové mechanismy do aplikací, které vytvářejí?
Dělají to jen vývojáři?
Určitá úroveň lhostejnosti k integraci metriky se neomezuje pouze na vývojáře. Pracoval jsem ve firmách, které vyvíjely aplikace pomocí Tomcat a nevydávaly žádné své metriky, žádné záznamy o aktivitě služby, kromě obecných chybových logů Tomcat. Někteří vývojáři generují spoustu logů, které nic neznamenají pro systémového administrátora, který je nucen je číst ve 3:15 ráno.
Autor fotografie na
Systémoví inženýři, kteří umožňují těmto produktům dostat se na trh, by také měli nést určitou odpovědnost za situaci. Jen málo systémových inženýrů má čas a zajímá se o to, jak získat smysluplné metriky z logů, aniž by měli kontext těchto metrik a možnost je interpretovat ve světle aktivity aplikace. Někteří nechápou, jaký užitek z toho mohou mít, kromě ukazatelů typu 'něco není v pořádku (nebo brzy bude)'.
Změna myšlení ohledně potřeby metrik by se měla dít nejen mezi vývojáři, ale i mezi systémovými inženýry.
Pro každého systémového inženýra, který musí nejen reagovat na kritické události, ale i zaručit jejich absenci, je nedostatek metrik obvykle překážkou.
Systémoví inženýři obvykle nekoukají do kódu, jak vydělávají peníze pro svou společnost. Potřebují vedoucí vývojáře, kteří chápou důležitost odpovědnosti systémového inženýra při detekci problémů, zvyšování povědomí o výkonnostních problémech a podobně.
Tato věc s devops.
Mentalita devops popisuje synergii myšlení vývojářů (dev) a operací (ops). Jakákoli společnost, která tvrdí, že 'dělá devops', by měla:
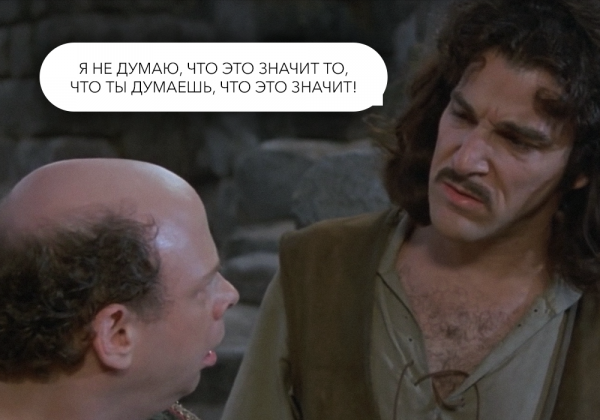
- říkat věci, které pravděpodobně nedělají (narážka na mem z filmu 'Princezna nevěsta' - 'Nemyslím si, že to znamená to, co si myslíš, že to znamená!')
- podporovat přístup k neustálému zdokonalování produktu.
Nemůžete zlepšit produkt a vědět, že byl vylepšen, pokud nevíte, jak funguje v současnosti. Nebudete moci zjistit, jak produkt funguje, pokud nepochopíte, jak fungují jeho komponenty, služby, od kterých závisí, jeho základní bolestivá místa a úzká místa.
Pokud nesledujete potenciálně úzká místa, nebudete moci použít techniku 'pět proč' při psaní Postmortem. Nebudete schopni shromáždit všechno na jednom displeji, abyste viděli, jak produkt funguje nebo jak vypadá 'normálně a šťastně'.
Posun vlevo, VLEVO, ŘÍKAL JSEM, LEEEEE—
Pro mě je jedním z klíčových principů Devops 'Posun vlevo' (shift left). Posun vlevo v tomto kontextu znamená posun možnosti (ne odpovědnosti, a pouze možnosti) dělat to, o co se obvykle starají systémoví inženýři, například vytvářet metriky výkonu, efektivněji využívat logy atd., na začátku životního cyklu dodávky softwaru (Software Delivery Life Cycle).
Autor fotografie na
Vývojáři softwaru by měli mít možnost používat a znát monitorovací nástroje, které společnost používá, aby prováděli monitoring ve všech jeho formách, metrikách, logování, monitoračních rozhraních a co je nejdůležitější, sledovat, jak jejich produkt funguje v produkčním prostředí.. Nemůžete donutit vývojáře, aby investovali své úsilí a čas do monitoringu, pokud nebudou moci vidět metriky a ovlivnit to, jak vypadají, jak je vlastníkem produktu představí CTO na dalším briefingu atd.
Stručně řečeno,
- přiveďte koně k vodě. Ukážte vývojářům, kolika problémům se mohou vyhnout, pomozte jim definovat správné KPI a metriky pro jejich aplikace, aby bylo méně křiku od vlastníka produktu, na kterého křičí technický ředitel (CTO). Vyveďte je na světlo, jemně a klidně. Pokud to nevyjde, pak podplácejte, vyhrožujte a přemlouvejte buď je, nebo vlastníka produktu, aby co nejrychleji zrealizovali získání těchto metrik z aplikací, a pak nakreslete grafy. Bude to obtížné, protože to nebude považováno za prioritu a v produktové roadmapě bude mnoho projektů čekajících na realizaci, které přinášejí příjmy. Proto budete potřebovat ekonomické zdůvodnění, abyste obhájili čas a prostředky vynaložené na implementaci monitoringu do produktu.
- Pomozte systémovým inženýrům vyspat se. Ukažte jim, že použití kontrolního seznamu „vydáváme verzi“ pro jakýkoli vydávaný produkt je dobré. A kontrola toho, že všechny aplikace v produkci mají pokrytí metrikami, pomůže dosáhnout zdravého spánku v noci, umožňující vývojářům vidět, co a kde nefunguje. Nicméně, správný způsob, jak podráždit a rozčilit jakéhokoli vývojáře, vlastníka produktu a technického ředitele, je neustále vkládat klacky pod nohy a odporovat. Toto chování ovlivní datum vydání jakéhokoli produktu, pokud se opět vyčká na poslední chvíli, takže proveďte posun vlevo a co nejdříve zahrňte tyto otázky do projektového plánu. Pokud je to nutné, vměšujte se na schůzky věnované produktu. Noste falešné kníry a klobouk nebo něco takového, to nikdy nezkazí. Nahlaste své problémy, ukažte jasné výhody a evangelizujte.
- Ujistěte se, že jak vývojáři (dev), tak provoz (ops) chápou význam a dopad přechodu metrik produktu do „červené zóny“. Nenechávejte provoz jako jediného strážce funkčnosti produktu, ujistěte se, že se do toho zapojují i vývojáři (#productsquads).
- Logy jsou skvělé, ale metriky taky. Spojte je a nepovolte, aby se vaše logy staly odpadem v obrovské hořící kouli zbytečnosti. Vysvětlete a ukažte vývojářům, proč se nikdo kromě nich nevyzná v jejich logách, ukažte jim, jaké to je sledovat bezcenné logy v 3:15 ráno.
Autor fotografie na
Tímto to končí. Nový materiál vyjde příští týden. Pokud se chcete dozvědět více o kurzu, zveme vás na , který proběhne již v pondělí. A nyní tradičně čekáme na vaše komentáře.
Zdroj: habr.com
