

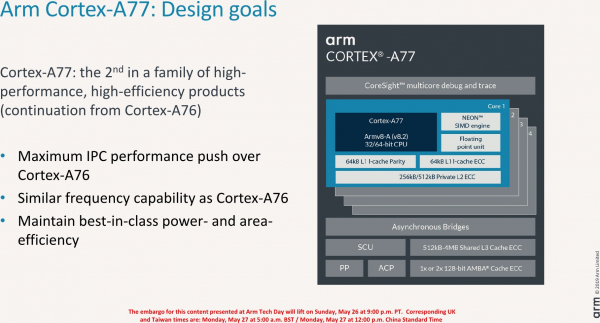
ARM představila svůj nejnovější design procesoru – Cortex-A77. Stejně jako loňské jádro Cortex-A76, je tato architektura určená pro náročné úkoly ve smartphonech a různých zařízeních. Cílem vývojářů je zvýšení počtu vykonávaných instrukcí na takt (IPC). Taktní frekvence a spotřeba energie zůstaly zhruba na úrovni Cortex-A76.
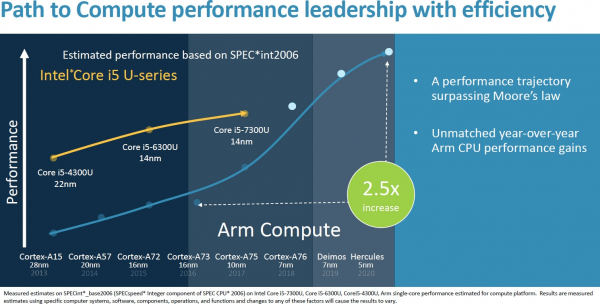
V současnosti se ARM rychle zaměřuje na zvyšování výkonu svých jader. Podle jejích plánů, počínaje Cortex-A73 z roku 2016 až po design Hercules z roku 2020, hodlá zvýšit výkon CPU až 2,5krát. Už přechody z 16 nm na 10 nm a poté na 7 nm umožnily zvýšení taktní frekvence, a v kombinaci s architekturou Cortex-A75 a následně Cortex-A76 ARM odhaduje, že výkonnost dosáhla zvýšení o 1,8krát. Nyní jádro Cortex-A77 umožní, díky růstu IPC, zvýšení výkonu o dalších 20 % při stávající taktní frekvenci. To znamená, že 2,5násobné zvýšení v roce 2020 se stává zcela reálným.
Navzdory 20% nárůstu IPC se podle odhadů ARM spotřeba energie A77 nezvýšila. Kompromis spočívá v tom, že plocha čipu A77 je o přibližně 17 % větší než A76 při stejných technologických normách. V důsledku toho se náklady na jednotlivé jádro mírně zvýší. Pokud porovnáme dosažení ARM s lídry v odvětví, je třeba říci, že AMD v Zen 2 dosáhla nárůstu IPC o 15 % ve srovnání se Zen+, zatímco IPC jader Intel zůstává již léta na přibližně stejné úrovni.
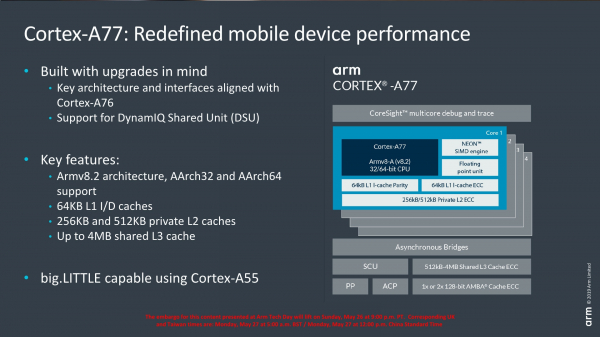
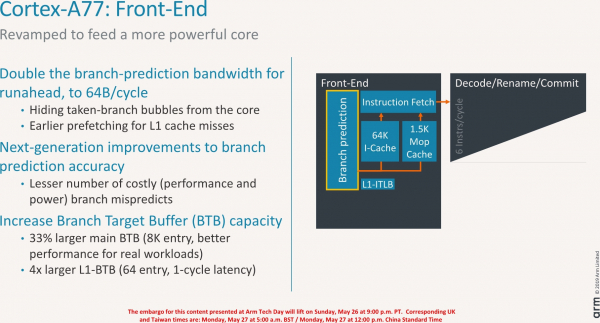
Okno vykonávání se změnou pořadí instrukcí (out-of-order window size) bylo zvýšeno o 25 %, na 160 jednotek, což umožňuje jádru zvýšit paralelismus výpočtů. Již v Cortex-A76 byl velký buffer adres skoků (Branch Target Buffer), a v Cortex-A77 byl zvýšen o dalších 33 %, na 8 KB, což umožňuje bloku predikce skoků efektivně zvládat rostoucí množství paralelních instrukcí.
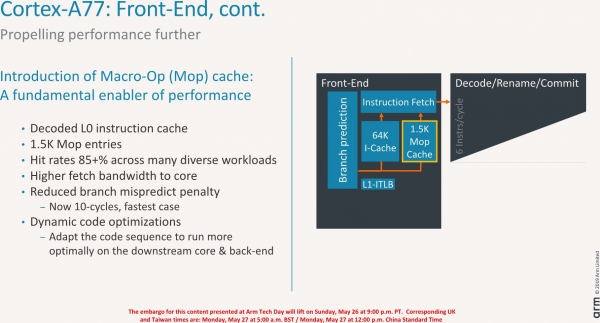
Ještě zajímavějším novinkou je zcela nový 1,5-KB cache, ve kterém jsou uloženy makrooperace (MOP) vracené z dekódovací jednotky. Architektura procesoru ARM dekóduje instrukce z uživatelské aplikace na menší makrooperace a poté je rozděluje na mikrooperace, které jsou předávány jádru provádění. Cache MOP se používá ke snížení vlivu chybějících odvětvení a resetů, protože makrooperace jsou nyní uloženy v samostatné jednotce a nevyžadují opětovné dekódování — tím se zvyšuje celková propustnost jádra. V některých zátěžích je nový blok velmi užitečným doplněním k standardnímu cache instrukcí.
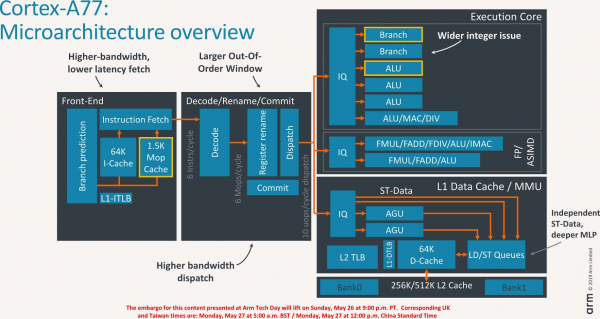
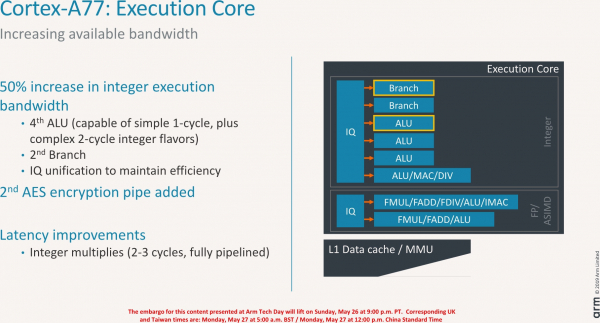
Do jádra provádění byl přidán čtvrtý blok ALU a druhý blok odvětvení. Čtvrtý ALU zvyšuje celkovou propustnost procesoru 1,5krát díky schopnosti vykonávat jednocyklické instrukce (jako ADD a SUB) a dvouciklové celočíselné operace, jako je násobení. Další dva ALU mohou zpracovávat pouze základní jednocyklické instrukce, zatímco poslední blok je zatěžován složitějšími matematickými operacemi, jako je dělení, násobení s akumulací atd. Druhý blok odvětvení uvnitř jádra provádění zdvojnásobuje počet současných odvětvovacích přechodů, se kterými může jádro pracovat, což je užitečné v případech, kdy dva ze šesti zaslaných příkazů se týkají přechodů odvětvení. Interní testování v ARM ukázalo zisk ve výkonu využitím tohoto druhého bloku přechodů.
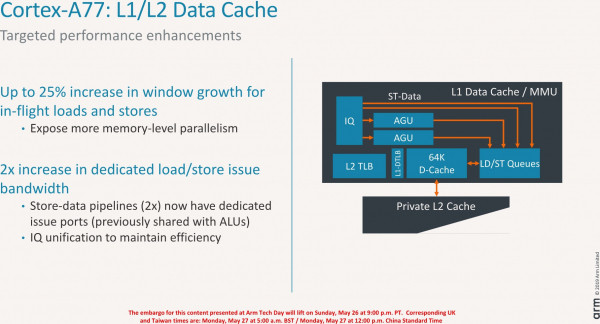
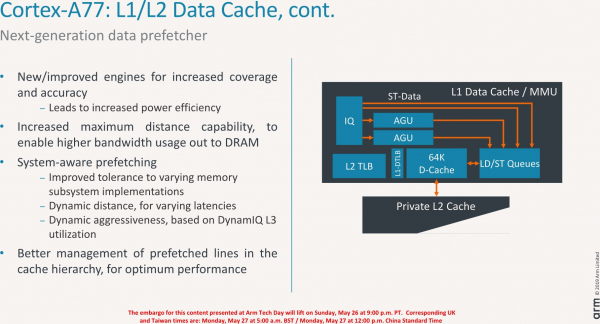
Mezi další změny v jádře patří přidání druhého konvejeru šifrování AES, zvýšení propustnosti paměti, vylepšený mechanismus předběžného získávání dat nové generace, který zvyšuje účinnost energetické spotřeby a zároveň zvyšuje propustnost systému DRAM, optimalizace práce cache a další.
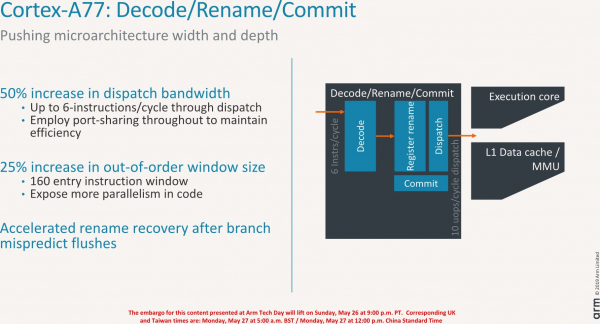
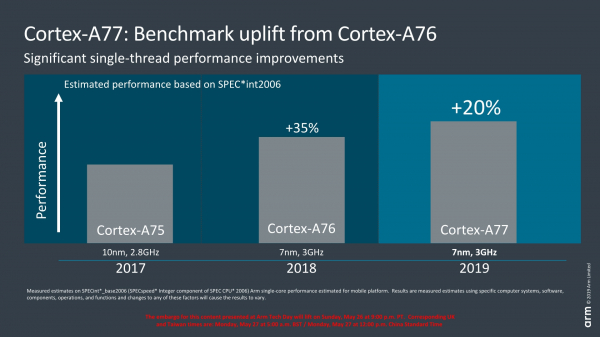
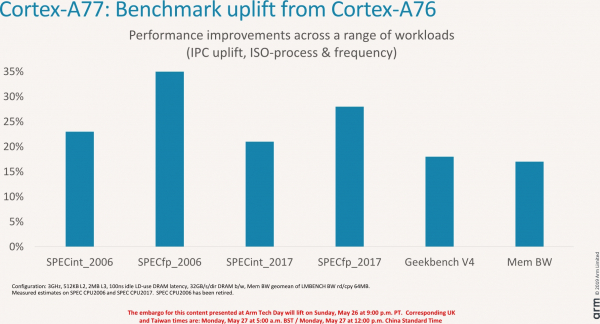
Největší nárůst je pozorován u Cortex-A77 při celých operacích a výpočtech s pohyblivou desetinnou čárkou. To potvrzují interní testy ARM v SPEC, které ukázaly zvýšení výkonu o 20 % a 35 % u celých operací a výpočtů s pohyblivou desetinnou čárkou. Zlepšení propustnosti paměti se pohybují někde v rozmezí 15–20 %. Celkově optimalizace a úpravy v A77 přinášejí průměrný nárůst výkonu o 20 % ve srovnání s předchozí generací. Díky novějším technologickým normám, jako je 7nm ULV, můžeme dosáhnout dalších výhod v konečných čipech.
ARM vyvinula Cortex-A77, aby fungovala v konfiguraci 4+4 big.LITTLE (4 výkonná jádra a 4 jednoduchá energeticky úsporná). Vzhledem k větší ploše nové architektury však mohou mnozí výrobci z důvodu úspor představit kombinace 1+3+4 nebo 2+2+4, které se již aktivně praktikují, kde pouze jedno nebo dvě jádra budou plnohodnotná a neomezená A77.
Zdroj: 3dnews.ru
