

Ahoj všem. Pracuji jako vedoucí systémový administrátor v OК a odpovídám za stabilní provoz portálu. Chci se podělit o to, jak jsme vytvořili proces automatické výměny disků a jak jsme poté ze procesu vyloučili administrátora a nahradili ho botem.
Tento článek je jakousi transkripcí na HighLoad+ 2018
Vytvoření procesu výměny disků
Nejprve několik čísel
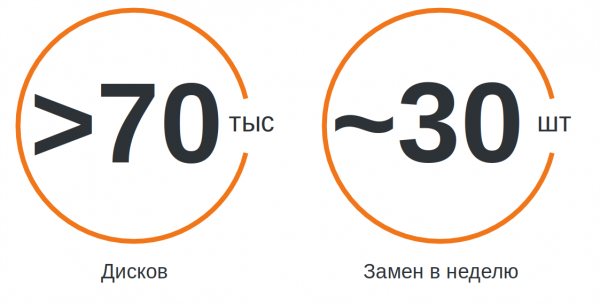
OК — to je obrovský servis, který používají miliony lidí. Jeho provoz zabezpečuje kolem 7 tisíc serverů, které se nacházejí ve 4 různých datových centrech. Na serverech je více než 70 tisíc disků. Pokud bychom je naskládali na sebe, dostali bychom věž vyšší než 1 km.
Pevné disky jsou součástí serveru, která se porouchává nejčastěji. Při takových objemech musíme měnit kolem 30 disků týdně, a tento proces se stal nepříjemnou rutinou.
Incidenty
V naší společnosti je zavedena plnohodnotná správa incidentů. Každý incident zaznamenáváme do Jiry, a poté jej řešíme a analyzujeme. Pokud měl incident vliv na uživatele, určitě se sejdeme a přemýšlíme, jak rychleji reagovat v takových případech, jak snížit dopad a samozřejmě, jak předejít opakování.
Úložná zařízení nejsou výjimkou. O jejich stavu se stará Zabbix. Monitorujeme zprávy v Syslog na přítomnost chyb při zápisu/čtení, analyzujeme stav HW/SW RAIDů, sledujeme SMART, pro SSD počítáme opotřebení.
Jak se dříve měnily disky
Když se v Zabbixu rozsvítí nějaký spouštěč, v Jize se vytvoří incident a automaticky se přiděluje příslušným inženýrům v datových centrech. Toto děláme se všemi HW incidenty, tedy takovými, které vyžadují fyzickou práci s vybavením v datovém centru.
Inženýr datového centra je člověk, který řeší otázky spojené se železem, odpovídá za instalaci, údržbu a demontáž serverů. Po obdržení tiketu se inženýr pustí do práce. V diskových policích mění disky sám. Pokud však nemá přístup k potřebnému zařízení, obrátí se na pohotovostní systémové administrátory o pomoc. Nejdříve je třeba disk vyjmout z rotace. K tomu je třeba provést nezbytné změny na serveru, zastavit aplikace a odpojit disk.
Pohotovostní systémový administrátor během pracovní směny odpovídá za správu celého portálu. Vyšetřuje incidenty, provádí opravy a pomáhá vývojářům plnit drobné úkoly. Nezabývá se pouze pevným diskem.
Dříve inženýři datových center komunikovali se systémovým administrátorem v chatu. Inženýři posílali odkazy na Jira tickety, administrátor je procházel a vedl si záznamy o práci v nějakém bloku. Ale pro takové úkoly jsou chaty nepohodlné: informace tam nejsou strukturované a rychle se ztrácí. A administrátor mohl jednoduše opustit počítač a nějakou dobu neodpovídat na požadavky, zatímco inženýr stál u serveru s hromadou disků a čekal.
Nejhorší bylo, že administrátoři nevěděli, jaká je celková situace: jaké diskové incidenty existují a kde by mohly nastat potenciální problémy. To je dáno tím, že všechny HW incidenty předáváme inženýrům. Ano, mohli bychom zobrazit všechny incidenty na administrátorském dashboardu. Ale je jich příliš mnoho a administrátor byl zapojen jen do některých z nich.
Kromě toho inženýr nemohl správně stanovit priority, protože nic nevěděl o účelu konkrétních serverů a o rozdělení informací mezi diskami.
Nový postup výměny
První, co jsme udělali, bylo vyčlenit všechny diskové incidenty do samostatného typu "HW-disk" a přidat k němu pole "název blokového zařízení", "velikost" a "typ disku", aby tyto informace byly uchovávány v tiketu a nemusely se neustále vyměňovat v chatu.
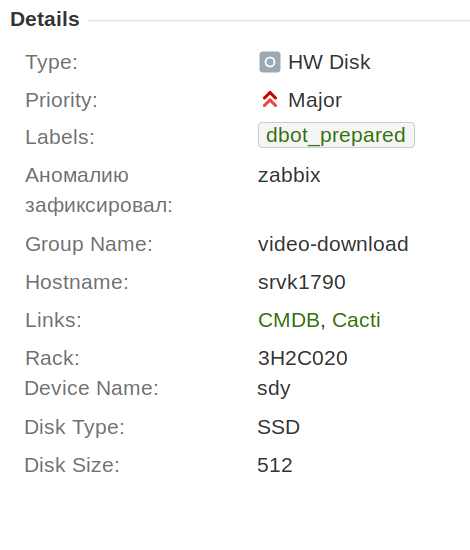
Také jsme se dohodli, že v rámci jednoho incidentu vyměníme pouze jeden disk. To výrazně usnadnilo následný proces automatizace, sběr statistik a práci.
Kromě toho jsme přidali pole "odpovědný administrátor". Tam se automaticky doplňuje pohotovostní systémový administrátor. To je velmi výhodné, protože inženýr nyní vždy vidí, kdo je zodpovědný. Není potřeba chodit do kalendáře a hledat. Právě toto pole umožnilo vyvěsit na administrátorském dashboardu tikety, ve kterých by mohla být jeho pomoc potřebná.
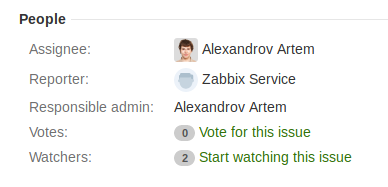
Aby všichni účastníci mohli získat maximální prospěch z novinek, vytvořili jsme filtry a dashboardy a informovali jsme o nich všechny zúčastněné. Když lidé chápou změny, nedistancují se od nich jako od něčeho zbytečného. Pro inženýra je důležité znát číslo racku, kde se nachází server, velikost a typ disku. Správci je důležité především pochopit, o jakou skupinu serverů se jedná a jaký může být efekt při výměně disku.
Existence polí a jejich zobrazení je užitečné, ale nezbavili jsme se tím potřeby používat chaty. Museli jsme změnit pracovní proces.
Dříve to vypadalo takto:
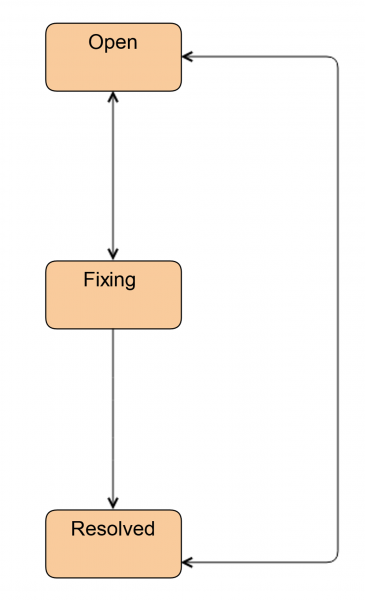
Dnes takto stále pracují inženýři, když nepotřebují pomoc správce.
První, co jsme udělali, bylo zavedení nového stavu Investigate. V této fázi je tiket, když inženýr ještě nerozhodl, zda bude potřebovat správce, nebo ne. Skrze tento stav může inženýr předat tiket správci. Kromě toho tímto stavem označujeme tickety, když je třeba vyměnit disk, ale disk na místě není. To se stává v případě CDN a vzdálených lokalit.
Také jsme přidali stav Ready. Do něj se tiket převádí po výměně disku. To znamená, že vše již bylo uděláno, ale na serveru se synchronizuje HW/SW RAID. To může trvat docela dlouho.
Pokud je do práce zapojen správce, schéma se mírně komplikuje.
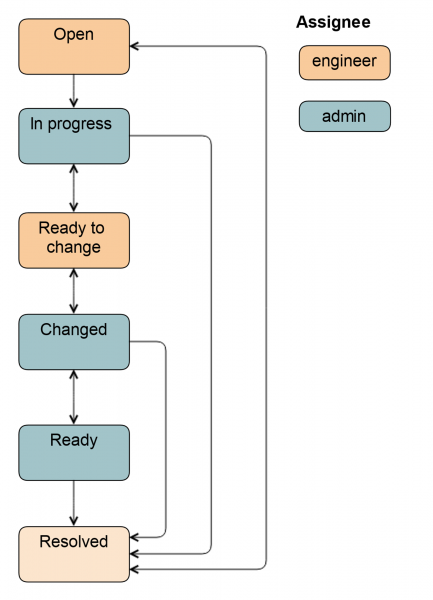
Z stavu Otevřít může tiket převést jak systémový administrátor, tak inženýr. Ve stavu In progress administrátor odpojuje disk z rotace, aby inženýr mohl prostě vytáhnout: zapne osvětlení, odmontuje disk, zastaví aplikace, v závislosti na konkrétní skupině serverů.
Poté se tiket převede do Ready to change: to je signál pro inženýra, že disk lze vytáhnout. Všechna pole v Jira jsou již vyplněna, inženýr ví, jaký typ a velikost disku. Tato data jsou zadávaná buď automaticky při předchozím stavu, nebo správcem.
Po výměně disku se tiket převede do stavu Changed. Kontroluje se, že byl vložen správný disk, provádí se rozložení, spustí se aplikace a některé úkoly pro obnovu dat. Také může být tiket převeden do stavu Ready, v tom případě zůstává odpovědným správcem, protože on disk do rotace zaváděl. Celkové schéma vypadá takto.
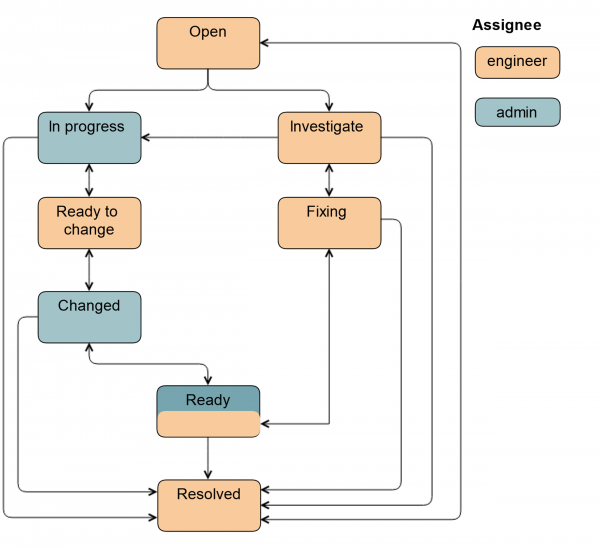
Přidání nových polí nám výrazně usnadnilo život. Kluci začali pracovat se strukturovanými informacemi, takže bylo jasné, co a v jaké fázi je potřeba udělat. Prioritizace se stala mnohem relevantnější, protože je nyní nastavuje administrátor.
Odpadla potřeba v chatech. Samozřejmě, administrátor může napsat inženýrovi "tady je potřeba vyměnit rychleji" nebo "už je večer, stihneš to vyměnit?". Ale už se o těchto věcech každý den v chatech nebavíme.
Disky se začaly měnit po skupinách. Pokud administrátor přijde do práce o něco dříve, má volný čas a zatím se nic nestalo, může připravit řadu serverů k výměně: nastavit pole, vyřadit disky z rotace a předat úkol inženýrovi. Inženýr přijde do datového centra o chvíli později, vidí úkol, vezme potřebné úložiště ze skladu a okamžitě je vymění. Výsledkem je zvýšení rychlosti výměny.
Nastavené zkušenosti při budování Workflow
- Při vytváření procedury je třeba shromáždit informace z různých zdrojů.
Někteří naši administrátoři nevěděli, že inženýr mění disky sám. Někteří si mysleli, že za synchronizaci MD RAID dohlížejí inženýři, přestože někteří z nich neměli k tomu přístup. Někteří vedoucí inženýři to dělali, ale ne vždy, protože proces nikde nebyl popsán. - Procedura by měla být jednoduchá a srozumitelná.
Je těžké udržet na paměti mnoho kroků. Nejpodstatnější sousední stavy v Jira je potřeba umístit na hlavní obrazovku. Můžeme je přejmenovat, například In progress nazveme Ready to change. Ostatní stavy můžeme skrýt do rozbalovacího menu, aby nevyčnívaly. Ale je lepší neomezení lidí, dát možnost provést přechod.
Vysvětlete hodnotu novinek. Když lidé chápou, lépe přijímají novou proceduru. Pro nás bylo velmi důležité, aby lidé neklikali na celý proces, ale šli jím. Pak jsme na tom budovali automatizaci. - Čekat, analyzovat, zkoumat.
Trvalo nám asi měsíc vybudovat proceduru, technicky ji realizovat, uspořádat schůzky a diskuse. A na zavedení — více než tři měsíce. Viděl jsem, jak lidé pomalu začínají novinku používat. V první fázi bylo hodně negativních reakcí. Ale to nijak nesouviselo s procedurou nebo její technickou realizací. Například jeden administrátor používal nikoli Jira, ale Jira plugin v Confluence, a některé věci mu nebyly dostupné. Ukázali jsme mu Jira, jeho produktivita vzrostla jak v běžných úkolech, tak i při výměnách disků.
Automatizace výměny disků
K automatizaci výměny disků jsme se pokusili přistoupit několikrát. Měli jsme už nějaké skripty, ale všechny pracovaly buď v interaktivním nebo v manuálním režimu, vyžadovaly spuštění. A teprve po zavedení nové procedury jsme si uvědomili, že nám právě to chybělo.
Protože jsme nyní proces výměny rozdělili na fáze, kde každou má na starosti určitý vykonavatel a seznam úkonů, můžeme zapínat automatizaci postupně, a ne hned celou. Například nejjednodušší fázi — Ready (kontrola synchronizace RAID/dat) lze snadno delegovat botovi. Jakmile se bot trochu naučí, můžeme mu dát zodpovědnější úkol — zařazení disku do rotace atd.
Zoologická zahrada konfigurací
Než začneme mluvit o botovi, uděláme si krátký výlet do naší zoologické zahrady instalací. V první řadě je to dáno obrovskou velikostí naší infrastruktury. Zadruhé se snažíme pro každý servis vybrat optimální konfiguraci hardwaru. Máme asi 20 modelů hardwarových RAID, převážně LSI a Adaptec, ale objevují se i HP a DELL různých verzí. Každý RAID kontrolér má svou vlastní řídící utilitu. Sada příkazů a výstupy se mohou lišit mezi verzemi každého RAID kontroléru. Tam, kde se nepoužívá HW-RAID, může být mdraid.
S téměř všemi novými instalacemi se snažíme obejít diskové zálohování. Snažíme se více nepoužívat hardwarové a softwarové RAID, protože zálohujeme naše systémy na úrovni datových center, nikoli serverů. Ale samozřejmě existuje mnoho starších serverů, které je třeba podporovat.
Někde jsou disky v RAID kontrolerech spojeny jako raw zařízení, jinde se používá JBOD. Existují konfigurace se samotným systémovým diskem v serveru, a pokud je třeba ho vyměnit, je nutné server přeinstalovat s operačním systémem a aplikacemi, a to ve stejných verzích, poté přidat konfigurační soubory a spustit aplikace. Také existuje řada skupin serverů, kde se zálohování provádí nikoli na úrovni diskového subsystému, ale přímo v samotných aplikacích.
Celkově máme víc než 400 unikátních skupin serverů, na kterých běží kolem 100 různých aplikací. Abychom pokryli tak obrovské množství variant, potřebovali jsme multifunkční automatizační nástroj. Ideálně s jednoduchým DSL, aby ho mohl udržovat nejen ten, kdo ho napsal.
Vybrali jsme Ansible, protože je bezagentový: nebylo třeba připravovat infrastrukturu, rychlý start. Navíc je napsaný v Pythonu, který je v týmu přijat jako standard.
Obecná schéma
Podívejme se na obecný diagram automatizace na příkladu jednoho incidentu. Zabbix detekuje, že disk sdb selhal, spustí se trigger, vytvoří se tiket v Jira. Administrátor se na něj podívá, pochopí, že to není duplikát a není to false positive, tedy že je třeba disk vyměnit, a převede tiket do stavu In progress.
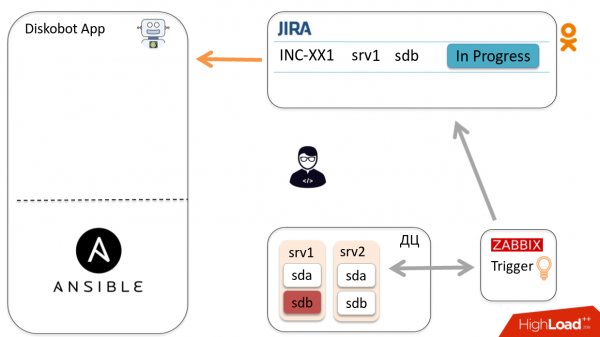
Aplikace DiskoBot napsaná v Pythonu periodicky prohledává Jira na nové tikety. Zjistí, že se objevil nový tiket ve stavu In progress, spustí se odpovídající thread, který spustí playbook v Ansible (to se dělá pro každý stav v Jira). V tomto případě se spouští Prepare2change.
Ansible se odesílá na hostitele, vyřazuje disk z rotace a hlásí stav aplikaci prostřednictvím Callbacks.
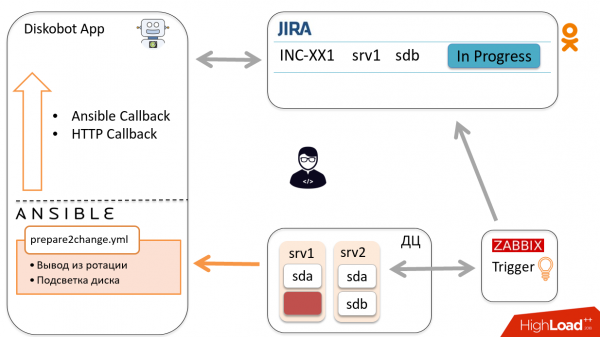
Na základě výsledků bot automaticky převede tiket do stavu Ready to change. Inženýr dostává oznámení a jde vyměnit disk, po čemž převede tiket do stavu Changed.
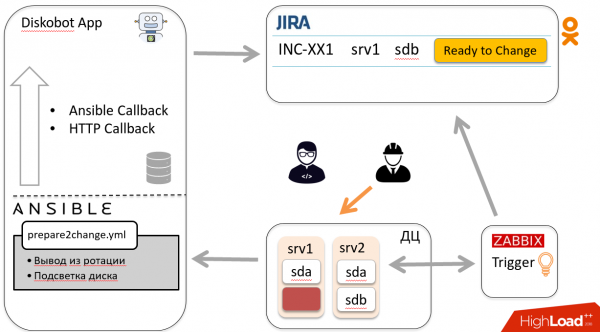
Podle výše popsaného schématu se tiket vrátí zpět k botovi, ten spustí jiný playbook, jde na hostitele a uvede disk do rotace. Bot uzavírá tiket. Hurá!
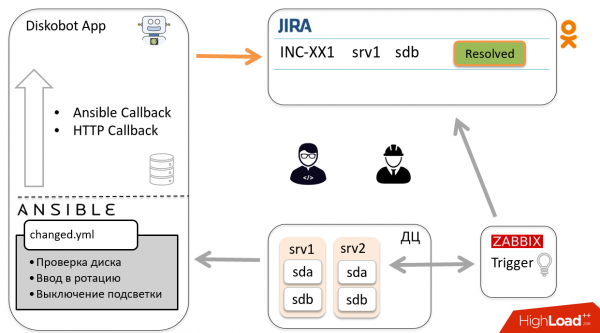
Teď se pojďme podívat na některé komponenty systému.
Diskobot
Tato aplikace je napsaná v Pythonu. Vybírá tikety z Jira podle JQL. V závislosti na stavu tiketu, poslední úkol přechází k odpovídajícímu zpracovateli, který na oplátku spustí odpovídající Ansible playbook podle stavu.
JQL a intervaly dotazů jsou definovány v konfiguračním souboru aplikace.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
Například, mezi tikety ve stavu In progress, se vybírají pouze ty, ve kterých jsou vyplněna pole Disk size a Device name. Device name je název blokového zařízení potřebného pro provedení playbooku. Disk size je potřebný, aby inženýr věděl, jak velký disk je třeba.
A mezi tikety se stavem Ready se filtrují tikety s labelem dbot_ignore. Mimochodem, Jira labely používáme jak pro takové filtrování, tak pro označování duplicitních tiketů a sběr statistiky.
V případě selhání playbooku Jira přiřadí label dbot_failed, aby bylo možné se později vyřešit.
Interakce s Ansible
Aplikace interaguje s Ansible prostřednictvím . V playbook_executor předáváme název souboru a sadu proměnných. To umožňuje uchovávat Ansible projekt jako běžné yml soubory, nikoli jej popisovat v Python kódu.
Také v Ansible jsou přes *extra_vars* předávány název blokového zařízení, stav tiketu a callback_url, kde je zakódován issue key — je používán pro callback v HTTP.
Pro každé spuštění se generuje dočasná inventory, která se skládá z jednoho hostitele a skupiny, do které tento hostitel patří, aby se uplatnily group_vars.
Zde je příklad úkolu, ve kterém je implementován HTTP callback.
Výsledek provedení playbooků získáváme pomocí callback(-ů). Jsou dvou typů:
- , poskytuje údaje o výsledcích provedení playbooku. Popisuje úkoly, které byly spuštěny, úspěšně vykonány nebo neúspěšně vykonány. Tento callback se vyvolá po skončení přehrávání playbooku.
- HTTP callback pro získávání informací během přehrávání playbooku. V Ansible úkolu provádíme POST/GET dotaz směrem k naší aplikaci.
Pomocí HTTP callback(-ů) se předávají proměnné, které byly definovány při provádění playbooku a které chceme zachovat a použít při dalších spuštěních. Tyto údaje zapisujeme do sqlite.
Také pomocí HTTP callbacku zanecháváme komentáře a měníme stav tiketu.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Stejně jako u mnoha podobných úloh jsme to vyčlenili do samostatného běžného souboru a zahrnujeme ho podle potřeby, abychom se v playbooku neustále neopakovali. Zde se objevuje callback_url, ve kterém jsou zakódovány issue key a host name. Když Ansible provede tento POST požadavek, bot rozumí, že přišel v rámci určitého incidentu.
A tady je příklad z playbooku, ve kterém jsme odpojí disk z MD zařízení:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Tato úloha převádí Jira tiket do stavu „Ready to change“ a přidává komentář. Také se v proměnné mdam_data ukládá seznam md zařízení, ze kterých byl disk odstraněn, a v parted_info — dump partition od parted.
Když inženýr vloží nový disk, můžeme použít tyto proměnné k obnovení dumpu partition a také přidat disk do těch md zařízení, ze kterých byl odstraněn.
Ansible kontrolní režim
Spouštění automatizace bylo děsivé. Proto jsme se rozhodli spouštět všechny playbooky v režimu
, ve kterém Ansible na serverech neprovádí žádné akce, ale pouze je emuluje.
Takové spuštění probíhá prostřednictvím samostatného callback modulu a výsledek provedení playbooku se ukládá do Jira jako komentář.
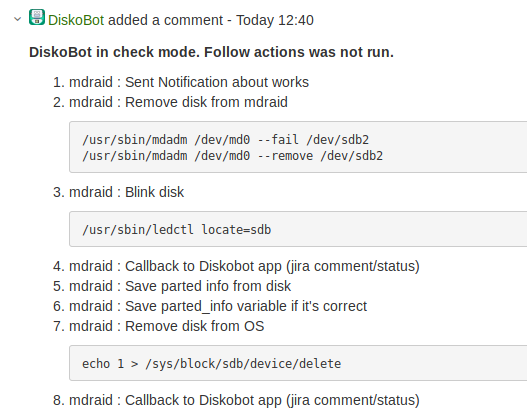
Za prvé, to umožnilo validovat práci bota a playbooků. Za druhé, zvýšilo to důvěru administrátorů v bota.
Když jsme prošli validací a pochopili, že můžeme spouštět Ansible nejen v režimu dry run, vytvořili jsme v Jira tlačítko Run Diskobot pro spuštění stejného playbooku se stejnými proměnnými na stejném hostu, ale v běžném režimu.
Kromě toho se tlačítko používá pro opětovné spuštění playbooku v případě jeho selhání.
Struktura Playbooks
Už jsem zmínil, že v závislosti na stavu Jira tiketu bot spouští různé playbooky.
Za prvé, tak je mnohem snazší organizovat přístup.
Za druhé, v některých případech je to zcela nezbytné.
Například při výměně systémového disku je nutné nejdříve jít do systému nasazení, vytvořit úkol, a po správném nasazení server bude dostupný přes ssh a lze na něj nasadit aplikaci. Kdybychom to všechno dělali v jednom playbooku, Ansible by ho nemohl provést kvůli nedostupnosti hosta.
Používáme Ansible role pro každou skupinu serverů. Zde je vidět, jak jsou playbooky uspořádány v jednom z nich.
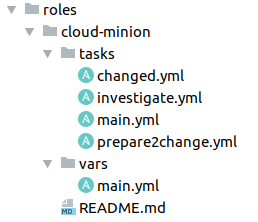
Je to pohodlné, protože je hned jasné, kde se nacházejí jednotlivé úkoly. V main.yml, který slouží jako vstup pro Ansible roli, můžeme mít prostě include podle stavu tiketu nebo obecné úkoly, které jsou potřebné pro všechny, například provedení identifikace nebo získání tokenu.
Investigation.yml
Spouští se pro tikety ve stavu Investigation a Open. Nejdůležitější pro tento playbook je název blokového zařízení. Tyto informace nejsou vždy k dispozici.
Pro jejich získání analyzujeme shrnutí Jira, poslední hodnotu ze Zabbix triggeru. Tam může být uveden název blokového zařízení — máme štěstí. Může tam být také mount point — pak je nutné jít na server, zpracovat a vypočítat potřebný disk. Trigger může také poskytnout scsi adresu nebo nějaké jiné informace. Ale někdy se stane, že žádné stopy nejsou a je třeba analyzovat.
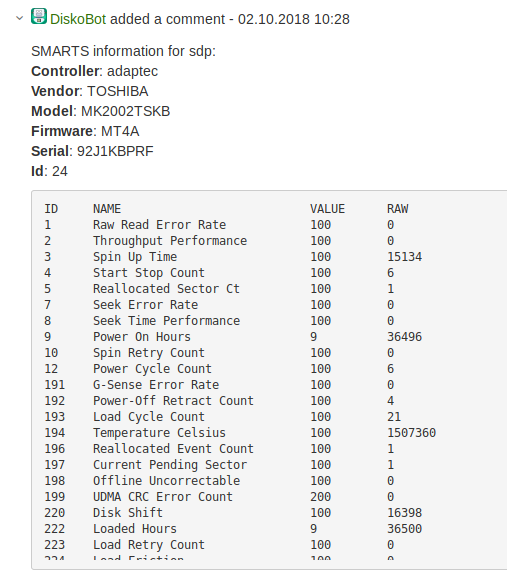
Zjistivši název blokového zařízení, shromažďujeme informace o typu a velikosti disku pro vyplnění polí v Jira. Taktéž zaznamenáváme informace o vendorovi, modelu, firmwaru, ID, SMART, a to vše vkládáme do komentáře v Jira tiketu. Administrátor a inženýr nyní nemusí tyto údaje hledat. 🙂
prepare2change.yml
Vytahování disku z rotace, příprava na výměnu. Nejdůležitější a nejtěžší fáze. Právě zde můžete zastavit aplikaci, když ji není možné zastavit. Nebo vytáhnout disk, u kterého chyběly repliky, a tím ovlivnit uživatele, ztratit nějaká data. Zde máme nejvíce kontrol a notifikací v chatu.
V nejjednodušším případě jde o odstranění disku z HW/MD RAID.
V komplikovanějších situacích (v našich úložištích), kdy je zálohování prováděno na úrovni aplikace, je nutné jít do aplikace přes API, informovat o vyjmutí disku, deaktivovat ho a zahájit obnovu.
Právě teď masově migrujeme do , a pokud je server cloudový, Diskobot se obrací na API cloudu, říká, že se chystá pracovat s tímto minionem — serverem, na kterém běží kontejnery, a žádá „migruj všechny kontejnery z tohoto miniona“. A zároveň zapíná osvětlení disku, aby inženýr okamžitě viděl, který je třeba vytáhnout.
changed.yml
Po výměně disku nejprve kontrolujeme jeho dostupnost.
Inženýři ne vždy vkládají nové disky, proto jsme přidali kontrolu vyhovujících hodnot SMART.
Jaké atributy sledujemeReallocated Sectors Count (5) < 100
Current Pending Sector Count (107) == 0
Pokud disk neprojde kontrolou, inženýrovi se oznámí potřeba výměny. Pokud je vše v pořádku, kontrolka se vypne, je provedena značení a disk je zařazen do rotace.
ready.yml
Nejjednodušší případ: kontrola synchronizace HW/SW RAID nebo ukončení synchronizace dat v aplikaci.
API aplikací
Několikrát jsem zmínil, že robot často přistupuje k API aplikací. Samozřejmě, že ne všechny aplikace měly potřebné metody, proto bylo nutné je doplnit. Zde jsou nejdůležitější metody, které používáme:
- Status. Stav clusteru nebo disku, abychom pochopili, zda s ním lze pracovat;
- Start/stop. Aktivace-deaktivace disku;
- Migrate/restore. Migrace a obnova dat během a po výměně.
Získané zkušenosti s Ansible
Ansible mám velmi rád. Ale často, když se dívám na různé open-source projekty a vidím, jak lidé píší playbooky, trošku se děsím. Složitá logická provázanost s when/loop, nedostatek flexibility a idempotence kvůli častému používání shell/command.
Rozhodli jsme se vše maximálně zjednodušit a využít výhodu Ansible - modularitu. Na nejvyšší úrovni jsou playbooky, které může psát jakýkoli administrátor, externí vývojář, který něco ví o Ansible.
- name: Blink disk
  become: True
  register: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Pokud je nějakou logiku těžké realizovat v playbookách, přesouváme ji do Ansible modulu nebo filtru. Skripty mohou být psány buď v Pythonu, nebo v jakémkoli jiném jazyce.
Jsou snadné a rychlé na psaní. Například modul pro blikání disku, jehož příklad použití je uveden výše, se skládá z 265 řádků.
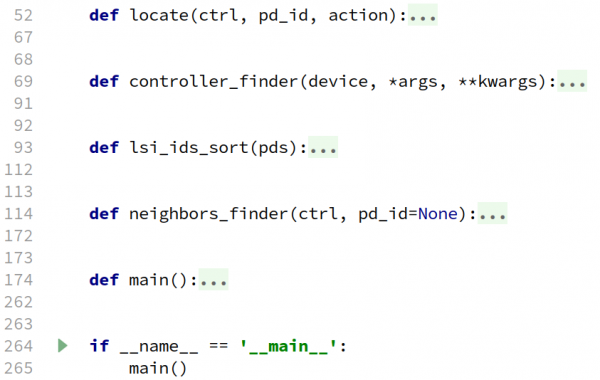
Na nejnižší úrovni je knihovna. Pro tento projekt jsme napsali samostatnou aplikaci, jakousi abstrakci nad hardwarovými a softwarovými RAIDs, které provádějí odpovídající požadavky.
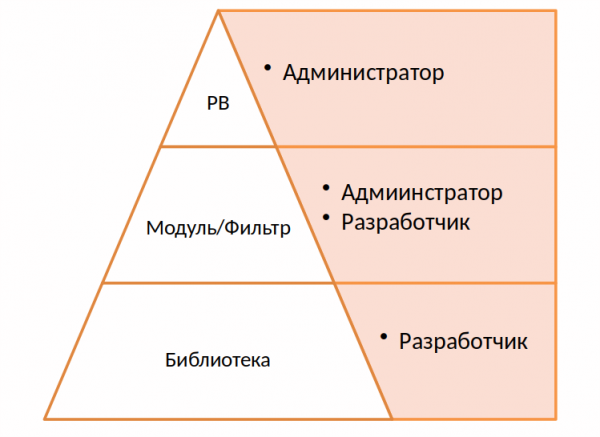
Nejvyššími silnými stránkami Ansible jsou jednoduchost a srozumitelné playbooky. Domnívám se, že je třeba toho využívat a nežene generovat zděšené yaml-soubory a velké množství podmínek, shell-kódu a smyček.
Pokud chcete zopakovat naši zkušenost s Ansible API, mějte na paměti dvě věci:
- Playbook_executor a vůbec playbook nelze předat časový limit. Existuje časový limit na SSH relaci, ale na playbook není. Pokud se pokusíme odpojit disk, který v systému již neexistuje, playbook se bude vykonávat nekonečně, takže jsme museli jeho spuštění zabalit do samostatného wrapperu a zabíjet podle časového limitu.
- Ansible funguje na principu fork-procesů, proto jeho API není thread-safe. Všechny naše playbooky spouštíme jednovláknově.
Nakonec se nám podařilo automatizovat výměnu přibližně 80 % disků. Celková rychlost výměny se zdvojnásobila. Dnes administrátor pouze sleduje incident a rozhoduje, zda je potřeba disk vyměnit, a poté provede jeden klik.
Ale nyní se začínáme potýkat s jiným problémem: někteří noví administrátoři nevědí, jak měnit disky. 🙂
Zdroj: habr.com
