

Dnes má služba „Bitrix24“ tisíce gigabitů provozu, nemá ohromný park serverů (i když jich samozřejmě není málo). Ale pro mnohé zákazníky se stal klíčovým pracovním nástrojem v jejich firmách, je to skutečná aplikace životně důležitá pro podnikání. Proto nesmí selhat — to prostě není možné. A co když k výpadku přece jen dojde, ale služba se „vrátí“ tak rychle, že si toho nikdo ani nevšimne? A jak se podaří realizovat při tom failover bez ztráty kvality práce a počtu klientů? Alexandr Demidov, ředitel oddělení cloudových služeb „Bitrix24“, pro náš blog prozradil, jak se za 7 let existence produktu vyvinul systém rezervování.
„Spuštění „Bitrix24“ jako SaaS před 7 lety bylo velkou výzvou. Největší obtíž asi spočívala v tom, že před spuštěním pro veřejnost jako SaaS existoval tento produkt pouze jako krabicové řešení. Zákazníci si ho u nás kupovali, umisťovali na své servery, zakládali firemní portál — společné řešení pro komunikaci zaměstnanců, ukládání souborů, vedení úkolů, CRM, to celé. A v roce 2012 jsme se rozhodli, že chceme to spustit jako SaaS, administrující samostatně, zajišťující odolnost vůči poruchám a spolehlivost. Zkušenosti jsme získali v průběhu, protože do té doby jsme je jednoduše neměli — byli jsme pouze výrobci softwaru, ne poskytovateli služeb.
Při spuštění služby jsme chápali, že to nejdůležitější je zajistit odolnost vůči poruchám, spolehlivost a stálou dostupnost služby, protože pokud máte běžnou webovou stránku, například obchod, a ta vám spadne a leží hodinu — trpíte jenom vy, ztrácíte objednávky, ztrácíte zákazníky, ale pro samotného vašeho klienta — pro něj to není tak kritické. Je pochopitelně naštvaný, ale půjde a koupí na jiném webu. Ale pokud se jedná o aplikaci, na které je postavena celá práce uvnitř firmy, komunikace, rozhodování, klíčové je získat důvěru uživatelů, tedy je nezklamat a neselhávat. Protože veškerá práce se může zastavit, pokud něco uvnitř nebude fungovat.
Bitrix24 jako SaaS
První prototyp jsme sestavili rok před veřejným spuštěním, v roce 2011. Sestavili jsme ho zhruba za týden, podívali jsme se na něj a vyzkoušeli – byl dokonce funkční. To znamená, že bylo možné přejít na formulář, zadat název portálu, nový portál se rozjel a vytvořila se databáze uživatelů. Podívali jsme se na něj, zhodnotili v zásadě produkt, zabalili to a celý rok jsme jej dále vyvíjeli. Protože jsme měli velký úkol: nechtěli jsme mít dvě různé kódové základny, nechtěli jsme podporovat zvlášť krabicový produkt a zvlášť cloudová řešení – chtěli jsme to vše realizovat v rámci jednoho kódu.
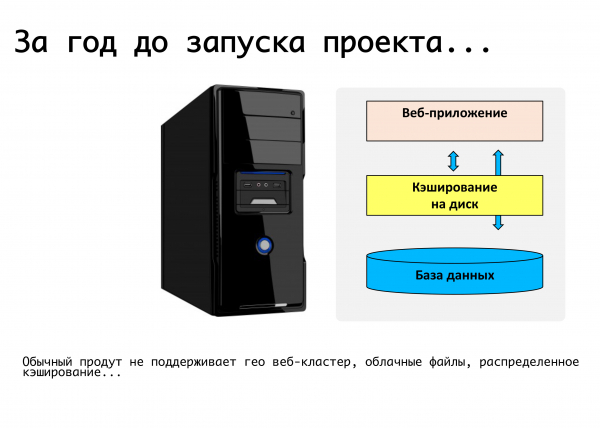
Typická webová aplikace v té době – to je jeden server, na kterém běží nějaký kód php, databáze mysql, soubory se nahrávají, dokumenty, obrázky se ukládají do složky upload – a to je všechno. Bohužel, spuštění kriticky odolného webového servisu na tomto není možné. Tam se nepodporuje distribuované cache, replikace databází se nepodporuje.
Formulovali jsme požadavky: umění umístit se na různých místech, podporovat replikaci, ideálně umístit do různě geograficky rozložených datových center. Oddělit logiku produktu a samotné ukládání dat. Dynamicky umět škálovat podle zátěže, statiku vůbec vynést. Z těchto úvah vznikly vlastně požadavky na produkt, který jsme po celý rok vyvíjeli. Během této doby jsme ve vznikající platformě, která byla jednotná – pro krabicová řešení, pro naši vlastní službu – udělali podporu těch věcí, které jsme potřebovali. Podporu replikace mysql na úrovni produktu: to znamená, že vývojář, který píše kód – nepřemýšlí, jak budou jeho dotazy rozdělovány, používá naše api, a my umíme správně rozdělovat dotazy na zápis a čtení mezi master a slave.
Zavedli jsme podporu na úrovni produktu různých cloudových objektových úložišť: google storage, amazon s3 – plus, podpora open stack swift. Proto to bylo pohodlné jak pro nás jako službu, tak pro vývojáře, kteří pracují s krabicovým řešením: pokud používají pouze naše api pro práci, nepřemýšlejí, kde nakonec bude soubor uložen, zda lokálně v souborovém systému nebo se dostane do objektového úložiště.
Nakonec jsme se okamžitě rozhodli, že budeme rezervovat na úrovni celého datového centra. V roce 2012 jsme se plně spustili na Amazon AWS, protože jsme již měli zkušenosti s touto platformou – naše vlastní webové stránky byly tam hostovány. Přitahovalo nás, že v každém regionu Amazonu je několik dostupnostních zón – v podstatě, (v jejich terminologii) několik datových center, která jsou více či méně nezávislá a umožňují nám rezervaci na úrovni celého datového centra: pokud by jedno z nich náhle selhalo, databáze se replikují master-master, servery webových aplikací jsou rezervovány a statické soubory jsou uloženy v objektovém úložišti s3. Zátěž je vyvažována – v té době pomocí amazon elb, ale o něco později jsme přešli k vlastním vyrovnávačům zátěže, protože jsme potřebovali složitější logiku.
Co jsme chtěli, to jsme dostali…
Všechny základní věci, které jsme chtěli zajistit – odolnost samotných serverů, webových aplikací a databází – fungovaly dobře. Nejjednodušší scénář: pokud nám selže některá z webových aplikací, je to prosté – jsou vyřazeny z vyvažování.
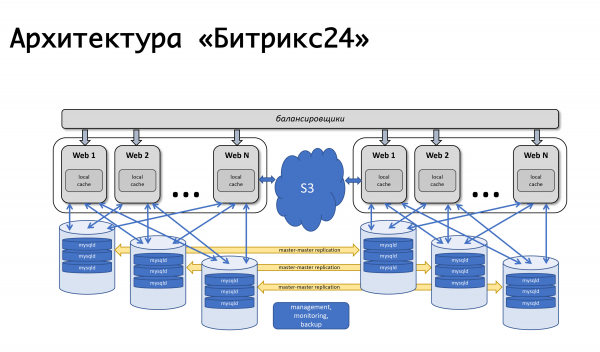
Selhávající stroje vyvažovač (tehdy to byl amazon elb) sám označoval jako unhealthy a vypínal na něm rozdělování zátěže. Fungoval amazon auto-scaling: když zátěž vzrostla, do auto-scalingové skupiny byly přidány nové stroje a zátěž byla rozložena na nové stroje – vše bylo v pořádku. S našimi vyvažovači zátěže je logika zhruba stejná: pokud se něco stane se serverem aplikací, odstraníme z něj požadavky, vyřadíme tyto stroje, spustíme nové a pokračujeme v práci. Schematicky se to za všechny ty roky trochu změnilo, ale stále to funguje: je to jednoduché, srozumitelné a s tím nejsou žádné komplikace.
Pracujeme po celém světě, vrcholy zátěže u klientů jsou zcela různé, a logicky bychom měli mít možnost provádět určité servisní práce s jakýmikoli komponenty našeho systému kdykoli – pro klienty bez povšimnutí. Proto máme možnost vypnout databázi a přerozdělit zatížení na druhé datové centrum.
Jak to všechno funguje? — Provoz přesměrováváme na funkční datové centrum — pokud dojde k havárii v datovém centru, tak zcela, pokud se jedná o naše plánované údržbové práce nějaké databáze, přesměrováváme část provozu, který obsluhuje tyto klienty, na druhé datové centrum, přičemž replikace je pozastavena. Pokud potřebujeme nové stroje pro webové aplikace vzhledem k nárůstu zatížení v druhém datovém centru, automaticky se spustí. Práce končí, replikace se obnoví a celý provoz se vrací zpět. Pokud musíme provést zrcadlové práce v druhém DC, například nainstalovat systémové aktualizace nebo změnit nastavení v druhé databázi, v podstatě opakujeme to samé, pouze na druhou stranu. A pokud dojde k havárii, tak děláme vše jednoduše: v monitorovacím systému používáme mechanismus event-handlers. Pokud se nám spustí několik kontrol a stav přejde do kritického, spustí se tento handler, zpracovatel, který může provést tu či onu logiku. Pro každou databázi máme definováno, který server je pro ni failover, a kam je třeba přesměrovat provoz v případě její nedostupnosti. Historicky jsme využívali v nějaké podobě nagios nebo jeho forky. V podstatě podobné mechanismy jsou téměř v každém monitorovacím systému, něco složitějšího zatím nepoužíváme, ale možná to někdy budeme. Aktuálně monitorování reaguje na nedostupnost a má možnost něco přesměrovat.
Všechno jsme rezervovali?
Máme mnoho klientů z USA, mnoho klientů z Evropy, mnoho klientů, kteří jsou blíže k východu — Japonsko, Singapur a tak dále. Samozřejmě existuje obrovský podíl klientů v Rusku. To znamená, že pracujeme daleko ne jen v jednom regionu. Uživatelé chtějí rychlou odezvu, existují požadavky na dodržování různých místních zákonů, a v každém regionu máme rezervovány dva datové centra, navíc existují nějaké další služby, které, opět, je výhodné umístit do jednoho regionu — pro klienty, kteří v tomto regionu pracují. REST handlerové, servery autorizace, jsou méně kritické pro práci klienta jako celku, na nich se lze přepínat s malým přijatelným zpožděním, ale nechceme vymýšlet kolo, jak je monitorovat a co s nimi dělat. Proto se co nejvíce snažíme využívat již existující řešení, a ne rozvíjet u sebe nějakou kompetenci v oblasti dodatečných produktů. A někde prostě používáme přepínání na úrovni DNS, přičemž živost služby určujeme stejným DNS. V Amazonu je služba Route 53, ale to není jen DNS, do kterého lze přidat záznamy a je to hotovo — je mnohem flexibilnější a pohodlnější. Pomocí něj můžete vybudovat geo-distribuované služby s geolokacemi, kdy pomocí něj určujete, odkud klient přišel, a poskytujete mu určité záznamy — s jeho pomocí můžete vybudovat failover architektury. Stejné health-checky jsou nastavovány v samotném Route 53, zadáváte endpointy, které se monitorují, nastavujete metriky, určujete, podle jakých protokolů určovat „živost“ služby — tcp, http, https; nastavujete frekvenci kontrol, určující, zda je služba živá, či nikoli. A v samotném DNS zapisujete, co bude primární, co bude sekundární, kam se přepnout, pokud se spustí health-check uvnitř Route 53. To vše lze udělat i jinými nástroji, ale co je na tom pohodlné — nakonfigurujete to jednou a pak vůbec nepřemýšlíte o tom, jak probíhají kontroly, jak jde přepínání: všechno funguje samo.
První „ale“: jak a čím zálohovat samotný route 53? Kdyby se náhodou něco stalo? Naštěstí jsme se s tím ještě nesetkali, ale mám na mysli, proč jsme uvažovali o zálohování. Už dopředu si tak zajišťujeme ochranu. Několikrát denně provádíme úplný export všech zón, které máme v route 53. API od Amazonu nám umožňuje je snadno dostat v JSON formátu, a máme postaveno několik záložních serverů, kam to konvertujeme, exportujeme jako konfigurace a máme, jak se říká, záložní konfiguraci. V případě potřeby ji můžeme rychle ručně nasadit a neztratíme žádná nastavení dns.
Druhé „ale“: co ještě v této sestavě není zálohováno? Samotný load balancer! Rozložení klientů podle regionů máme velmi jednoduché. Máme domény bitrix24.ru, bitrix24.com, .de – teď jich máme asi 13 různých, které fungují v různých zónách. Došli jsme k následujícímu: v každém regionu máme své load balancery. Takto je pohodlnější rozdělovat podle regionů, v závislosti na tom, jaká je kde špičková zátěž sítě. Pokud dojde k selhání na úrovni jednoho load balanceru, jednoduše se vyřadí z provozu a odstraní z dns. Pokud dojde k nějakému problému s celou skupinou load balancerů, pak se zálohují na jiných místech a přepínání mezi nimi se provádí pomocí stejného route53, protože díky krátkému ttl přepnutí probíhá maximálně během 2, 3, 5 minut.
Třetí „ale“: co ještě není zálohováno? S3, správně. Když ukládáme soubory, které uchováváme u uživatelů v s3, – opravdu jsme věřili, že je to neprůstřelné a není třeba tam nic zálohovat. Ale historie ukazuje, že se věci dějí jinak. Celkově Amazon popisuje S3 jako základní službu, protože Amazon sám S3 používá pro ukládání obrazů strojů, konfigurací, obrazů AMI, snapshotů… A když S3 selže, jak se to jednou stalo za těch 7 let, co používáme bitrix24, táhne to za sebou hromadu problémů — nedostupnost spuštění virtuálek, poruchy v chodu api a tak dále.
A S3 outage can happen — it has happened before. This is why we arrived at the following scheme: a few years ago, there were no serious public object storage solutions in Russia, and we considered creating something of our own… Fortunately, we did not start this because we would have gotten bogged down in the expertise we lack and would likely have made mistakes. Now, there are S3-compatible storages offered by Mail.ru, Yandex, and several other providers. Ultimately, we decided that we wanted, firstly, redundancy, and secondly, the ability to work with local copies. For the specific Russian region, we use the Mail.ru Hotbox service, which is API-compatible with S3. We didn't need any major code adjustments within the application, and we implemented the following mechanism: S3 has triggers that activate on the creation/deletion of objects, Amazon has a service called Lambda — this is a serverless code execution that runs precisely when certain triggers are activated.
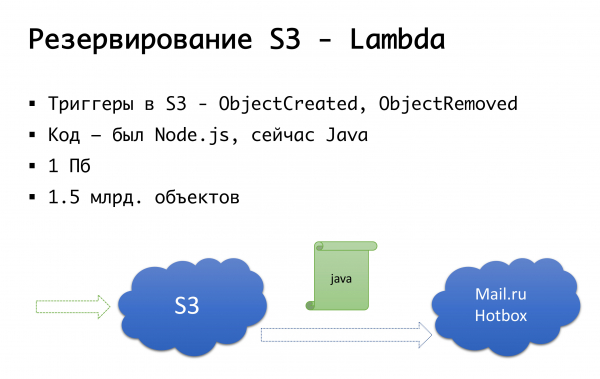
We kept it very simple: if a trigger is activated, we execute code that copies the object to Mail.ru storage. To fully initiate work with local data copies, we also need reverse synchronization so that clients in the Russian segment can work with a storage solution that is closer to them. Mail is about to finish the triggers in their storage — it will soon be possible to execute reverse synchronization at the infrastructure level, but for now, we are managing it through our own code. If we see that a client uploaded a file, we queue an event at our code level, process it, and perform reverse replication. The downside is that if we perform any operations on our objects outside our product, using some external tools, we won't account for that. Therefore, we are waiting until the triggers at the storage level are available, so that regardless of where the code is executed, the object that comes to us is copied in the other direction.
Na úrovni kódu máme pro každého klienta zapsána obě úložiště: jedno se považuje za hlavní, druhé za záložní. Pokud je vše v pořádku, pracujeme s tím úložištěm, které je nám blíže: tedy naši klienti, kteří jsou v Amazonu, pracují s S3, a ti, kteří pracují v Rusku, pracují s Hotbox. Pokud se aktivuje vlajka, musíme připojit failover a přepneme klienty na jiné úložiště. Tuto vlajku můžeme nastavovat nezávisle podle regionů a můžeme je tam a zpět přepínat. V praxi jsme tímto ještě nepoužívali, ale mechanismus jsme předpokládali a myslíme, že někdy v budoucnu budeme potřebovat a bude se hodit. Jednou se to už stalo.
Ojej, a váš Amazon utekl...
V letošním dubnu uplyne výročí od začátku blokací Telegramu v Rusku. Nejvíce postižený poskytovatel, který na to doplatil, je Amazon. A bohužel, více utrpěly ruské firmy, které pracovaly pro celý svět.
Pokud je firma globální a Rusko je pro ni velmi malý segment, 3-5% — tak či onak, lze jimi obětovat.
Pokud jde o ryze ruskou firmu — jsem si jist, že je třeba mít umístění lokálně — prostě to uživatelům usnadní přístup, bude to pohodlnější, rizik bude méně.
A pokud je to firma, která pracuje celosvětově, a má přibližně stejně klientů z Ruska jako z jiných částí světa? Propojení segmentů je důležité, a i tak musí spolupracovat.
Na konci března 2018 Roskomnadzor poslal největším operátorům dopis, ve kterém je informoval, že plánují zablokovat několik milionů ip adres Amazonu, aby zablokovali... messenger Zello. Děkujeme těmto poskytovatelům — dopis úspěšně všem unikl, a vzniklo pochopení, že propojení s Amazonem může selhat. Bylo to v pátek, v panice jsme přiběhli k kolegům z servers.ru s slovy: „Přátelé, potřebujeme několik serverů, které nebudou v Rusku, nebudou v Amazonu, ale například někde v Amsterdamu,“ abychom měli možnost nějakým způsobem tam umístit vlastní. vpn a proxy pro nějaké endpointy, na které nemáme žádný vliv, například endpointy S3 — nelze se pokusit zprovoznit novou službu a získat jinou IP, stále se k tomu musíme dostat. Během několika dnů jsme tyto servery nastavili, zprovoznili, a obecně, do okamžiku začátku blokací jsme se připravili. Zajímavé je, že RKN, když viděl humbuk a vytvořenou paniku, řekl: „Ne, nyní nic blokovat nebudeme.“ (Ale to trvalo přesně do chvíle, kdy začali blokovat Telegram.) Nastavili jsme možnosti obcházení a chápali jsme, že blokáda nebyla zavedena, přesto jsme to všechno nezpracovali. Tak, pro každou eventualitu.
A tak v roce 2019 žijeme v podmínkách blokací. Včera v noci jsem se díval: kolem milionu IP stále pokračuje v blokaci. Pravda, Amazon byl téměř úplně odblokován, v nejvyšším bodě se to dostalo až na 20 milionů adres… Celkově je realita taková, že konektivita, dobrá konektivita — ta nemusí být. Naráz. Může chybět z technických důvodů — požáry, bagry, to vše. Nebo, jak jsme viděli, to není úplně technické. Proto někdo velký a významný, s vlastními AS, může to řídit jinými cestami — direct connect a další věci již na úrovni L2. Ale v jednoduchém případě, jako jsme my nebo ještě menší, je dobré mít rezervaci na úrovni serverů, které jsou zprovozněny někde jinde, předem nastavené VPN, proxy, s možností rychle přepínat konfiguraci v těch segmentech, které jsou kritické pro vaši konektivitu. To se nám opakovaně hodilo, když začaly blokace Amazonu, přes něj jsme v nejhorším případě propouštěli právě S3 provoz, ale postupně se to vyřešilo.
A jak rezervovat… celého poskytovatele?
V současnosti nemáme scénář pro případ výpadku celého Amazonu. Existuje podobný scénář pro Rusko. V Rusku jsme byli umístěni u jednoho poskytovatele, u kterého jsme vybírali, aby bylo několik lokalit. Před rokem jsme se však setkali s problémem: i když se jedná o dvě datová centra, na úrovni konfigurace sítě poskytovatele mohou vzniknout problémy, které se dotknou obou datových center. Můžeme tak zažít nedostupnost na obou místech. A to se také stalo. Nakonec jsme přepracovali naši interní architekturu. Ta se nezměnila výrazně, ale pro Rusko máme nyní dvě lokality, které nejsou u jednoho poskytovatele, ale u dvou různých. Pokud u jednoho dojde k nějakému výpadku, můžeme přepnout na druhého.
Hypoteticky zvažujeme pro Amazon možnost zálohování na úrovni jiného poskytovatele; možná Google, možná někdo jiný… Ale zatím jsme v praxi zjistili, že když dojde k havárii na úrovni jedné availability zóny u Amazonu, havárie na úrovni celého regionu je poměrně vzácná. Takže teoreticky máme představu, že bychom mohli vytvořit zálohu "Amazon – ne Amazon", ale v praxi to zatím neexistuje.
Pár slov o automatizaci
Je automatizace vždy potřebná? Zde je na místě vzpomenout na efekt Dunninga-Krugera. Na ose "x" jsou naše znalosti a zkušenosti, které získáváme, a na ose "y" – důvěra v naše jednání. Nejprve nic nevíme a jsme zcela nejistí. Poté víme něco málo a stáváme se mega-sebevědomými – to je takzvaný "vrchol stupidity", dobře ilustrovaný obrázkem "hloupost a odvaha". Dále se již něco naučíme a jsme připraveni jít do boje. Pak narazíme na nějaké mega-závažné problémy, dostaneme se do údolí zoufalství, kdy sice něco víme, ale ve skutečnosti toho víme mnohem méně. Jak nabíráme zkušenosti, stáváme se už sebevědomějšími.
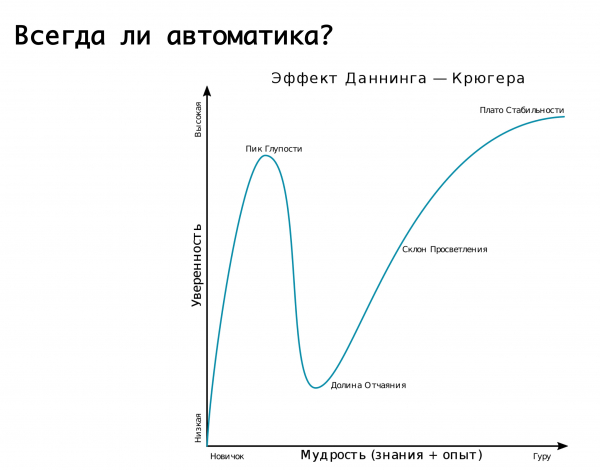
Naše logika, co se týče různých automatických přepnutí při haváriích, je velmi dobře popsána tímto grafem. Začali jsme bez zkušeností, prakticky veškerá práce se vykonávala ručně. Pak jsme si uvědomili, že můžeme na všechno nasadit automatizaci a jakoby spát v klidu. A najednou jsme narazili na velký problém: dostali jsme false positive a neustále přepínáme provoz tam a zpět, i když to ve skutečnosti nebylo nutné. To pak narušilo replikaci nebo něco jiného — a to je ta pravá dolina zoufalství. A pak jsme dospěli k poznání, že na všechno je potřeba se dívat s rozumem. To znamená, že má smysl se spolehnout na automatizaci, ale zároveň předvídat možnost falešného alarmu. Ale! Pokud jsou následky destruktivní, je lepší přenechat to pohotovostnímu týmu, pohotovostním inženýrům, kteří ověří, zajistí, že se opravdu jedná o havárii, a provedou nezbytné kroky ručně...
Závěr
Za 7 let jsme prošli cestou od toho, že jakmile něco spadlo, panika, k uvědomění, že problém neexistuje, existují jen úkoly, které je nutné — a možné — vyřešit. Když stavíte nějakou službu, podívejte se na ni z nadhledu a zhodnoťte všechna rizika, která mohou nastat. Pokud je vidíte hned, předem naplánujte záložní opatření a možnost vytvoření odolné infrastruktury, protože jakýkoli bod, který může selhat a vést k nefunkčnosti služby — ten to udělá. A i když se vám zdá, že některé prvky infrastruktury určitě neselžou — jako například s3, mějte na paměti, že se tak může stát. A alespoň teoreticky mějte představu o tom, co s nimi budete dělat, pokud k něčemu dojde. Mějte plán na řízení rizik. Když přemýšlíte o tom, zda vše dělat automatizovaně nebo ručně, zhodnoťte rizika: co se stane, když automatizace začne vše přepínat — nevede to k ještě horšímu scénáři než havárie? Možná je někde potřeba rozumný kompromis mezi použitím automatizace a reakcí pohotovostního inženýra, který posoudí skutečný stav a pochopí, zda je třeba něco přepínat okamžitě nebo "ano, ale ne teď".
Rozumný kompromis mezi perfekcionismem a reálnými silami, časem a penězi, které můžete investovat do schématu, které nakonec budete mít.
Tento text je doplněnou a rozšířenou verzí zprávy Alexandra Demidova na konferenci. .
Zdroj: habr.com
