

Ahoj, zabývám se vytvářením aplikací pro databázové systémy. — je to platforma vyvinutá ve skupině Mail.ru, která spojuje vysoce výkonnou databázi a aplikační server v jazyce Lua. Vysoká rychlost řešení založených na Tarantoolu je dosažena především díky podpoře in-memory režimu databáze a možnosti provádět obchodní logiku aplikace ve stejném adresním prostoru jako data. Přitom je zajištěna trvalost dat pomocí ACID transakcí (na disku se udržuje WAL žurnál). Tarantool má vestavěnou podporu replikace a shardování. Od verze 2.1 jsou podporovány dotazy v jazyce SQL. Tarantool je open-source a šíří se pod licencí Simplified BSD. Existuje také komerční Enterprise verze.
Cítíte sílu! (…aka užijte si výkon)
Všechny uvedené vlastnosti činí Tarantool atraktivní platformou pro vytváření vysoce zatížených aplikací pracujících s databázemi. V takových aplikacích často vzniká potřeba replikace dat.
Jak bylo uvedeno výše, v Tarantoolu existuje vestavěná replikace dat. Princip fungování spočívá v sekvenčním provádění všech transakcí obsažených v žurnálu mastera (WAL) na replikách. Obvykle se tato replikace (budeme ji dále nazývat nízkou úrovní) používá k zajištění odolnosti aplikace proti výpadkům a/nebo k rozložení zátěže čtení mezi uzly clustera.
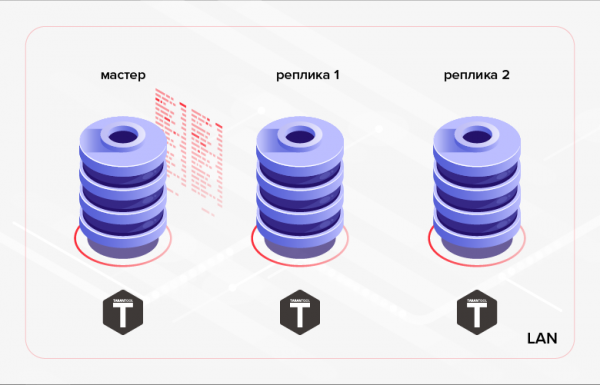
Obr. 1. Replikace uvnitř clustera
Příkladem alternativního scénáře může být přenos dat vytvořených v jedné databázi do druhé databáze pro zpracování/monitorování. V posledním případě může být výhodnějším řešením použití vysoké úrovně replikace — replikace dat na úrovni obchodní logiky aplikace. Tedy nepoužíváme hotové řešení integrované do databáze, ale vlastním způsobem realizujeme replikaci uvnitř aplikace, kterou vyvíjíme. Tento přístup má jak výhody, tak nevýhody. Vyjmenujme klady.
1. Úspora provozu:
- můžeme přenášet ne všechna data, ale pouze jejich část (například můžeme přenášet pouze určité tabulky, některé jejich sloupce nebo záznamy odpovídající určitému kritériu);
- Na rozdíl od nízkoúrovňové replikace, která probíhá kontinuelně v asynchronním (realizováno v aktuální verzi Tarantool — 1.10) nebo synchronním (bude realizováno v budoucích verzích Tarantool) režimu, vysokou úrovňovou replikaci lze provádět v sekvencích (tj. aplikace nejprve provede synchronizaci dat — sekvenci výměny dat, poté následuje pauza v replikaci, po níž proběhne další sekvence výměny atd.);
- Pokud byla položka několikrát změněna, lze předat pouze poslední verzi (na rozdíl od nízkoúrovňové replikace, při které budou na replikách postupně aplikovány všechny změny provedené na hlavním uzlu).
2. Není problém s realizací výměny pomocí HTTP, což umožňuje synchronizaci vzdálených databází.
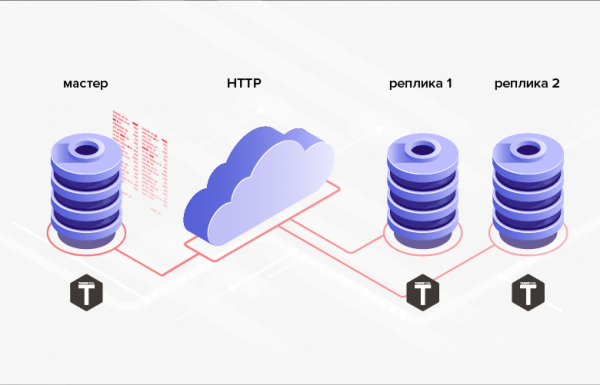
Obr. 2. Replikace přes HTTP
3. Struktury databází, mezi kterými jsou přenášena data, nemusí být shodné (navíc, obecně lze dokonce použít různé DBMS, programovací jazyky, platformy atd.).
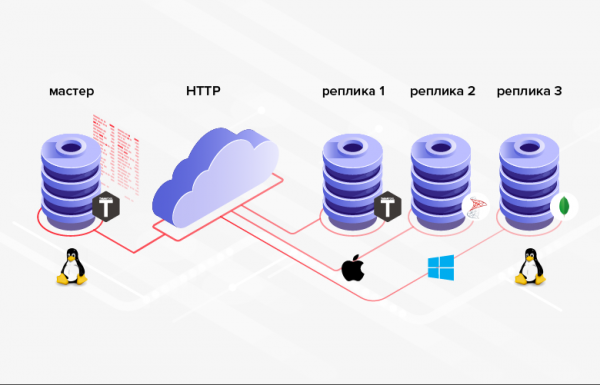
Obr. 3. Replikace v heterogenních systémech
Nevýhodou je, že průměrné programování je obtížnější/nákladnější než konfigurace, a místo nastavení integrované funkce bude nutné realizovat vlastní.
Pokud v vaší situaci uvedené výhody hrají rozhodující roli (nebo jsou nezbytnou podmínkou), má smysl použít vysokou úrovňovou replikaci. Podívejme se na několik způsobů, jak realizovat vysokou úrovňovou replikaci dat v DBMS Tarantool.
Minimalizace provozu
Jedním z výhod vysoké úrovňové replikace je úspora provozu. Aby se tato výhoda plně projevila, je třeba minimalizovat množství dat přenášených při každé sekvenci výměny. Samozřejmě, že při tom nelze zapomínat na to, že na konci sekvence musí být příjemce dat synchronizován se zdrojem (alespoň co se týče části dat, která se podílí na replikaci).
Jak tedy minimalizovat množství dat přenášených při vysoké úrovňové replikaci? Řešením "přímo" může být filtrování dat podle data a času. K tomu lze použít již existující pole data a času v tabulce (pokud existuje). Například dokument "objednávka" může mít pole "požadovaný čas splnění objednávky" — doba dodání. Problém tohoto řešení spočívá v tom, že hodnoty v tomto poli nemusí být uspořádány v pořadí odpovídajícímu vytváření objednávek. Tím pádem si nemůžeme zapamatovat maximální hodnotu pole doba dodání, předanou při předchozí výměně, a při další výměně vybrat všechny záznamy s vyšší hodnotou pole doba dodání. Mezi výměnami mohly být přidány záznamy s nižší hodnotou pole doba dodání. Také objednávka mohla podstoupit změny, které se nicméně této hodnoty netýkaly doba dodání. V obou případech nebudou změny přeneseny ze zdroje do příjemce. Pro řešení těchto problémů budeme potřebovat přenášet data "přes". Tedy při každé výměně budeme přenášet všechna data s hodnotou pole doba dodání, překračující nějaký moment v minulosti (například N hodin od současného okamžiku). Je však zřejmé, že pro velké systémy je tento přístup silně nadbytečný a může zcela eliminovat úsporu dat, které se snažíme dosáhnout. Navíc v přenášené tabulce nemusí být pole spojené s datem a časem.
Další řešení, složitější z hlediska implementace, spočívá v potvrzení příjmu dat. V tomto případě jsou při každé výměně přenášena všechna data, jejichž přijetí nebylo potvrzeno příjemcem. Pro realizaci bude potřeba přidat do zdrojové tabulky boolean sloupec (například, is_transferred). Pokud příjemce potvrdí přijetí záznamu, odpovídající pole přijímá hodnotu true, po čemž se záznam již neúčastní výměn. Tento variant implementace má následující nevýhody. Za prvé, pro každý přenesený záznam je nutné vygenerovat a zaslat potvrzení. Zjednodušeně řečeno, to může být srovnatelné s zdvojnásobením množství přenášených dat a vést k zdvojnásobení počtu roundtripů. Za druhé, není zde možnost odeslat stejný záznam několika příjemcům (první přijatý příjemce potvrdí přijetí za sebe a za všechny ostatní).
Bezchybný způsob, o kterém byla řeč výše, spočívá v přidání sloupce do přenášené tabulky pro sledování změn v jejích řádcích. Tento sloupec může mít typ datum-čas a měl by být nastavován/aktualizován aplikací na aktuální čas pokaždé při přidání/změně záznamů (atomárně s přidáním/změnou). Nazveme tento sloupec update_time. Uložením maximální hodnoty pole tohoto sloupce pro přenesené záznamy budeme moci začít další sezení výměny od této hodnoty (vybrat záznamy s hodnotou pole update_time, která překračuje dříve uloženou hodnotu). Problém spojený s posledním přístupem spočívá v tom, že změny dat mohou probíhat dávkově. Výsledkem je, že hodnoty polí ve sloupci update_time nemusí být unikátní. Tento sloupec tedy nelze použít pro stránkování dat. Pro stránkování dat bude nutné vymyslet další mechanizmy, které pravděpodobně budou mít velmi nízkou efektivitu (například vytáhnout z databáze všechny záznamy s hodnotou update_time nad zadanou a vydat určitý počet záznamů, počínaje nějakou offsetovou hodnotou od začátku výběru).
Efektivitu přenosu dat je možné zvýšit drobným vylepšením předchozího přístupu. K tomu budeme používat celá čísla (dlouhé celé číslo) jako hodnoty polí sloupce pro sledování změn. Nazveme tento sloupec row_ver. Hodnota pole tohoto sloupce by měla být stále nastavena/aktualizována pokaždé při vytvoření/změně záznamu. V tomto případě ale nebude pole přidělováno aktuálnímu datu a času, ale hodnotě nějakého čítače, zvýšeného o jedna. V důsledku toho bude sloupec row_ver obsahovat unikátní hodnoty a mohl by být použit nejen pro dodání "delta" dat (dat, která byla přidána/změněna po skončení předchozího sezení výměny), ale také pro jednoduché a efektivní rozdělení na stránky.
Poslední navrhovaný způsob minimalizace množství dat přenášených v rámci vysoceúrovňové replikace se jeví jako nejoptimálnější a nejuniverzálnější. Zaměřme se na něj podrobněji.
Přenos dat pomocí čítače verzí řádků
Implementace serverové/master části
V MS SQL Server existuje speciální typ sloupce pro realizaci podobného přístupu — rowversion. Každá databáze má čítač, který se zvyšuje o jednu jednotku pokaždé, když je záznam v tabulce se sloupcem typu přidán nebo změněn. Hodnota tohoto čítače se automaticky přiřazuje poli tohoto sloupce v přidaném nebo změněném záznamu. Systém pro správu databází Tarantool nemá podobný integrovaný mechanismus. Nicméně v Tarantool to není složité realizovat ručně. Podívejme se, jak to udělat. rowversionNejprve si objasníme některé termíny: tabulky v Tarantool se nazývají prostory (space) a záznamy — n-tice (tuple). V Tarantool lze vytvářet sekvence (sequence). Sekvence představují nic jiného než pojmenované generátory uspořádaných celých čísel. Tedy je to přesně to, co potřebujeme pro naše účely. Následně vytvoříme takovou sekvenci.
Než provedeme jakoukoli operaci s databází v Tarantool, je třeba vykonat následující příkaz:
box.cfg{}
V důsledku toho začne Tarantool zapisovat snímky databáze (snapshot) a protokol transakcí do aktuálního katalogu.Vytvoříme sekvenci
row_version box.schema.sequence.create('row_version', { if_not_exists = true }):
if_not_exists Volba umožňuje opakovat skript pro vytváření: pokud objekt existuje, Tarantool se jej nebude snažit vytvořit znovu. Tato volba se bude používat ve všech následujících DDL příkazech. Vytvoříme prostor pro příklad.
box.schema.space.create('goods', { format = { { name = 'id', type = 'unsigned'}, { name = 'name', type = 'string'}, { name = 'code', type = 'unsigned'}, { name = 'row_ver', type = 'unsigned'} }, if_not_exists = true })
Zde jsme zadali jméno prostoru ( goods), názvy polí a jejich typy.Automaticky inkrementované pole v Tarantool jsou také vytvářeny pomocí sekvencí. Vytvoříme automaticky inkrementovaný primární klíč podle pole
box.schema.sequence.create('goods_id', { if_not_exists = true }) box.space.goods:create_index('primary', { parts = { 'id' }, sequence = 'goods_id', unique = true, type = 'HASH', if_not_exists = true }) id:
box.schema.sequence.create('goods_id',
{ if_not_exists = true })
box.space.goods:create_index('primary', {
parts = { 'id' },
sequence = 'goods_id',
unique = true,
type = 'HASH',
if_not_exists = true
})Tarantool podporuje několik typů indexů. Nejčastěji se používají indexy typu TREE a HASH, které jsou založeny na odpovídajících strukturách. TREE je nejuniverzálnější typ indexu. Umožňuje extrakci dat v uspořádaném formátu. Pro výběr na základě rovnosti je však vhodnější HASH. Proto je pro primární klíč vhodné použít HASH (což jsme také udělali).
Aby bylo možné použít sloupec row_ver pro předání změněných dat, je nutné připojit k polím tohoto sloupce hodnoty sekvence row_ver. Na rozdíl od primárního klíče musí hodnota pole sloupce row_ver zvyšovat o jednu nejen při přidání nových záznamů, ale také při změně existujících. K tomu lze použít spouštěče. V Tarantool existují dva typy spouštěčů pro prostory: before_replace a on_replace. Spouštěče se spouštějí při každé změně dat v prostoru (funkce spouštěče se spouští pro každý plný řádek, který byl změněn). Na rozdíl od on_replace, before_replace-spouštěče umožňují modifikovat data plného řádku, pro který se spouští spouštěč. Proto je pro nás vhodný poslední typ spouštěčů.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
Tento spouštěč nahradí hodnotu pole row_ver sbíraného plného řádku dalším hodnotou sekvence box.schema.sequence.create('row_version', { if_not_exists = true }).
Aby bylo možné extrahovat data z prostoru ), názvy polí a jejich typy. podle sloupce row_ver, vytvoříme index:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
Typ indexu je strom (TREE), protože potřebujeme extrahovat data v pořadí podle vzestupných hodnot ve sloupci. row_ver.
Do prostoru přidáme některá data:
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Protože první pole je auto-incrementní čítač, předáváme místo něj nil. Tarantool automaticky vloží další hodnotu. Podobným způsobem jako hodnotu polí sloupce row_ver lze předat nil - nebo hodnotu vůbec neuvádět, protože tento sloupec zaujímá poslední pozici v prostoru.
Zkontrolujeme výsledek vložení:
tarantool> box.space.goods:select()
---
- - [1, 'pero', 123, 1]
  - [2, 'tužka', 321, 2]
  - [3, 'štětec', 100, 3]
  - [4, 'akvarelové barvy', 456, 4]
  - [5, 'album', 101, 5]
  - [6, 'blok', 800, 6]
  - [7, 'guma', 531, 7]
  - [8, 'pravítko', 135, 8]
...
Jak vidíme, první a poslední pole se zaplnila automaticky. Nyní bude snadné napsat funkci pro stránkování změn prostoru. ), názvy polí a jejich typy.:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
Funkce přijímá jako parametr hodnotu row_ver, od kterého je třeba provést export změn, a vrací dávku změněných dat.
Výběr dat v Tarantool se provádí prostřednictvím indexů. Funkce get_goods používá iterátor přes index row_ver k získání změněných dat. Typ iterátoru – GT (Greater Than, větší než). To znamená, že iterátor bude provádět sekvenční procházení hodnot indexu začínajícím od předaného klíče (hodnoty pole row_ver).
Iterátor vrací n-tice. Abychom mohli později předat data pomocí HTTP, je nutné přetvořit n-tice na strukturu, která je vhodná pro následnou serializaci. V příkladu se k tomu používá standardní funkce tomap. Místo používání tomap můžeme napsat vlastní funkci. Například můžeme chtít přejmenovat pole name, nepředávat pole code a přidat pole comment:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'nějaký komentář'
    obj.row_ver = tuple.row_ver
    return obj
end
Velikost stránky vracených dat (počet záznamů v jedné dávce) je určena proměnnou page_size. V příkladu je hodnota page_size rovná se 5. V reálném programu má velikost stránky obvykle větší význam. Závisí na průměrné velikosti tuples space. Optimální velikost stránky lze zjistit empiricky měřením doby přenosu dat. Čím větší je velikost stránky, tím méně je kolo mezi odesílatelem a příjemcem. To může snížit celkový čas nahrávání změn. Příliš velká velikost stránky však může způsobit, že server zabere příliš dlouho procesem serializace výběru. V důsledku toho mohou vzniknout zpoždění při zpracování dalších požadavků, které přišly na server. Parametr page_size lze načíst z konfiguračního souboru. Pro každý přenášený space lze nastavit svou hodnotu. Přičemž pro většinu space může být vhodná hodnota výchozí (například 100).
Proveďme funkci get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: pero
    id: 1
  - row_ver: 2
    code: 321
    name: tužka
    id: 2
  - row_ver: 3
    code: 100
    name: štětec
    id: 3
  - row_ver: 4
    code: 456
    name: akvarel
    id: 4
  - row_ver: 5
    code: 101
    name: album
    id: 5
...
Vezmeme hodnotu pole row_ver z posledního řádku a znovu zavoláme funkci:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: blok
    id: 6
  - row_ver: 7
    code: 531
    name: guma
    id: 7
  - row_ver: 8
    code: 135
    name: pravítko
    id: 8
...
A ještě jednou:
tarantool> get_goods(8)
---
- []
...
Jak vidíme, při tomto použití funkce vrací všechny záznamy prostoru postupně. ), názvy polí a jejich typy.Za poslední stránkou následuje prázdný výběr.
Provedeme změny ve space:
box.space.goods:update(4, {{'=', 6, 'sešit'}})
box.space.goods:insert{nil, 'klips', 234}
box.space.goods:insert{nil, 'složka', 432}
Změnili jsme hodnotu pole name pro jeden záznam a přidali dva nové záznamy.
Opakujeme poslední volání funkce:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: sešit
    id: 6
  - row_ver: 10
    code: 234
    name: klips
    id: 9
  - row_ver: 11
    code: 432
    name: složka
    id: 10
...
Funkce vrátila změněné a přidané záznamy. Tímto způsobem funkce get_goods umožňuje získat data, která se změnila od jejího posledního volání, což je základem zvažovaného způsobu replikace.
Zanecháme výstup výsledků po HTTP ve formátu JSON mimo rámec tohoto článku. O tom si můžete přečíst zde:
Realizace klientské/slave části
Podívejme se, jak vypadá realizace přijímací strany. Vytvoříme na přijímací straně space pro uložení nahraných dat:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Struktura prostoru připomíná strukturu prostoru ve zdroji. Ale protože nemáme v úmyslu předávat získaná data nikam jinam, sloupec row_ver ve prostoru příjemce chybí. V poli id budou zaznamenávány identifikátory zdroje. Proto na straně příjemce není třeba mít autoinkrementaci.
Kromě toho budeme potřebovat prostor pro ukládání hodnot row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Pro každý nahrávaný prostor (pole space_name) zde budeme ukládat poslední nahranou hodnotu row_ver (pole value). Primární klíč představuje sloupec space_name.
Vytvoříme funkci pro načítání dat z prostoru ), názvy polí a jejich typy. přes HTTP. K tomu budeme potřebovat knihovnu, která implementuje HTTP klienta. Následující řádek načítá knihovnu a vytváří instanci HTTP klienta:
local http_client = require('http.client').new()Také budeme potřebovat knihovnu pro deserializaci json:
local json = require('json')To je dostatečné pro vytvoření funkce pro načítání dat:
local function load_data(url, row_ver)
    local url = ('%s?rowVer=%s'):format(url,
        tostring(row_ver))
    local body = nil
    local data = http_client:request('GET', url, body, {
        keepalive_idle =  1,
        keepalive_interval = 1
    })
    return json.decode(data.body)
end
Funkce provádí HTTP požadavek na adresu url, předává do něj row_ver jako parametr a vrací deserializovaný výsledek dotazu.
Funkce pro ukládání získaných dat vypadá takto:
local function save_goods(goods)
    local n = #goods
    box.atomic(function()
        for i = 1, n do
            local obj = goods[i]
            box.space.goods:put(
                obj.id, obj.name, obj.code)
        end
    end)
end
Cyklus pro ukládání dat do prostoru ), názvy polí a jejich typy. je umístěn v transakci (k tomu se používá funkce box.atomic) ke snížení počtu operací na disku.
Nakonec lze funkci pro synchronizaci lokálního prostoru ), názvy polí a jejich typy. se zdrojem realizovat takto:
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Nejprve načteme dříve uloženou hodnotu row_ver pro prostor ), názvy polí a jejich typy.. Pokud chybí (první výměnná seance), vezmeme jako row_ver nula. Dále v cyklu provádíme stránkovou načítání změněných dat ze zdroje podle uvedeného url. Na každé iteraci ukládáme získaná data do odpovídajícího lokálního prostoru a aktualizujeme hodnotu row_ver (v prostoru row_ver a v proměnné row_ver) — vezmeme hodnotu row_ver z posledního řádku načtených dat.
Abychom se ochránili před náhodným zacyklením (v případě chyby v programu), lze cyklus while nahradit for:
for _ = 1, max_req do ... V důsledku provedení funkce sync_goods prostor ), názvy polí a jejich typy. v příjemci bude obsahovat nejnovější verze všech záznamů prostoru ), názvy polí a jejich typy. ve zdroji.
Je zřejmé, že tímto způsobem nelze provést přenos odstranění dat. Pokud je taková potřeba, lze použít označení k odstranění. Přidáme do prostoru ), názvy polí a jejich typy. logické pole is_deleted a místo fyzického odstranění záznamu použijeme logické odstranění — nastavíme hodnotu pole is_deleted na hodnotu true. Někdy je místo logického pole is_deleted pohodlnější použít pole deleted, ve kterém se ukládá datum a čas logického odstranění záznamu. Po provedení logického odstranění bude označený k odstranění záznam zaslán ze zdroje do příjemce (podle výše uvedené logiky).
Sekvenci row_ver lze použít k předání dat jiných prostorů: není třeba vytvářet samostatnou sekvenci pro každý předávaný prostor.
Probrali jsme efektivní způsob vysoceúrovňové replikace dat v aplikacích, které používají DBMS Tarantool.
Závěry
- DBMS Tarantool je atraktivní, perspektivní produkt pro vytváření vysoce zatížených aplikací.
- Vysoceúrovňová replikace dat má řadu výhod oproti nízkoúrovňové replikaci.
- Způsob vysoceúrovňové replikace, který jsme zkoumali v článku, umožňuje minimalizovat množství přenášených dat tím, že se přenášejí pouze ty záznamy, které se změnily po posledním výměnném sezení.
Zdroj: habr.com
