

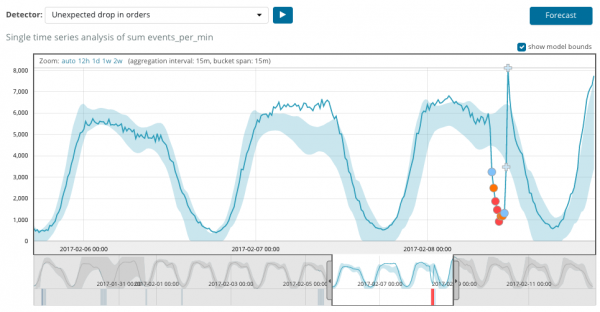
Připomínáme, že základ Elastic Stack tvoří nerelační databáze Elasticsearch, webové rozhraní Kibana a sběrači-zpracovatelé dat (nejznámější je Logstash, různé Beats, APM a další). Jednou z příjemných doplňků celého uvedeného produktu je analýza dat pomocí algoritmů strojového učení. V článku se zabýváme tím, co tyto algoritmy vyžadují. Prosíme, pokračujte ve čtení.
Strojové učení je placená funkce podmíněně bezplatného Elastic Stack a je součástí balíčku X-Pack. Abyste začali používat tuto funkci, stačí po instalaci aktivovat 30denní zkušební verzi. Po uplynutí zkušební doby můžete požádat o prodloužení předplatného nebo si zakoupit předplatné. Cena předplatného se nevypočítává podle objemu dat, ale podle počtu použitých uzlů. Ano, objem dat samozřejmě ovlivňuje počet potřebných uzlů, ale tento přístup k licencování je k rozpočtu společnosti šetrnější. Pokud není potřeba vysoký výkon, je možné také ušetřit.
ML v Elastic Stack je napsán v C++ a funguje mimo JVM, ve které běží samotný Elasticsearch. To znamená, že proces (tento proces se mimochodem nazývá autodetect) spotřebovává vše, co JVM neabsorbuje. Na demo stánku to není tak kritické, ale ve výrobním prostředí je důležité vyčlenit samostatné uzly pro úkoly ML.
Algoritmy strojového učení se dělí do dvou kategorií — a . V Elastic Stack algoritmus patří do kategorie „bez učitele“. Pomocí můžete prozkoumat matematickou základnu algoritmů strojového učení.
Pro provádění analýzy používá algoritmus strojového učení data uložená v indexech Elasticsearch. Úkoly pro analýzu můžete vytvářet jak z rozhraní Kibana, tak prostřednictvím API. Pokud to děláte přes Kibana, není nutné znát některé věci. Například dodatečné indexy, které algoritmus využívá v průběhu svého fungování.
Dodatečné indexy, které se používají v průběhu analýzy.ml-state — informace o statistických modelech (nastavení analýzy);
.ml-anomalies-* — výsledky práce algoritmů ML;
.ml-notifications — nastavení upozornění na výsledky analýzy.
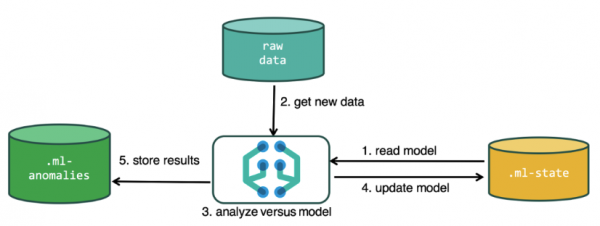
Struktura dat v databázi Elasticsearch se skládá z indexů a dokumentů, které v nich jsou uloženy. Pokud to porovnáme s relační databází, můžeme index přirovnat ke schématu databáze a dokument k zápisu v tabulce. Toto srovnání je zjednodušující a je uvedeno pro usnadnění pochopení dalšího materiálu pro ty, kteří o Elasticsearch slyšeli poprvé.
Přes API je dostupná stejná funkčnost jako přes webové rozhraní, proto pro přehlednost a pochopení konceptů budeme ukazovat, jak nastavit prostřednictvím Kibany. V levém menu je sekce Machine Learning, kde můžete vytvořit novou úlohu (Job). V rozhraní Kibany to vypadá jak na obrázku níže. Nyní si rozebereme každý typ úlohy a ukážeme typy analýz, které lze zde konstruovat.
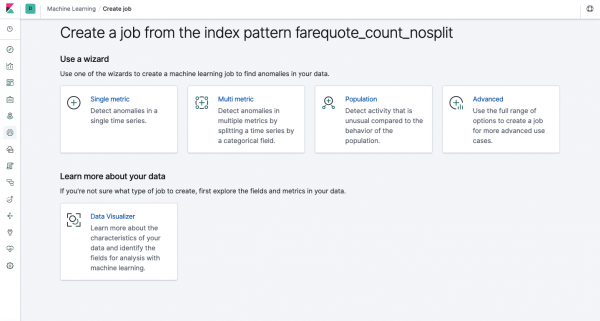
Single Metric — analýza jedné metriky, Multi Metric — analýza dvou a více metrik. V obou případech se každá metrika analyzuje v izolovaném prostředí, tj. algoritmus nezohledňuje chování současně analyzovaných metrik, jak by se mohlo zdát v případě Multi Metric. Pro provedení výpočtu se zohledněním korelace různých metrik lze použít Population-analýzu. Advanced — to je jemné nastavení algoritmů pomocí dalších možností pro určité úkoly.
Single Metric
Analýza změn jediné metriky — to je nejjednodušší, co lze zde udělat. Po kliknutí na Create Job algoritmus vyhledá anomálie.
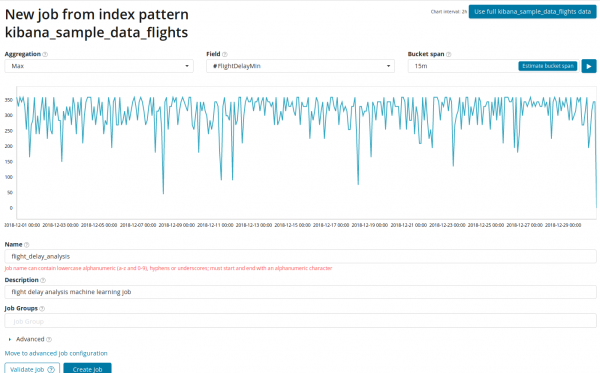
V poli Aggregation můžete vybrat přístup k vyhledávání anomálií. Například, při Min anomaly will be considered values below typical. There are also Max, High Mean, Low, Mean, Distinct and others. A description of all functions can be viewed .
V poli Field uvádí číselné pole v dokumentu, podle kterého provedeme analýzu.
V poli — granularita intervalů na časové ose, podle které bude analýza vedena. Můžete se spolehnout na automatiku nebo vybrat ručně. Na obrázku níže je uveden příklad příliš nízké granularity — můžete zmeškat anomálii. Pomocí tohoto nastavení lze měnit citlivost algoritmu na anomálie.
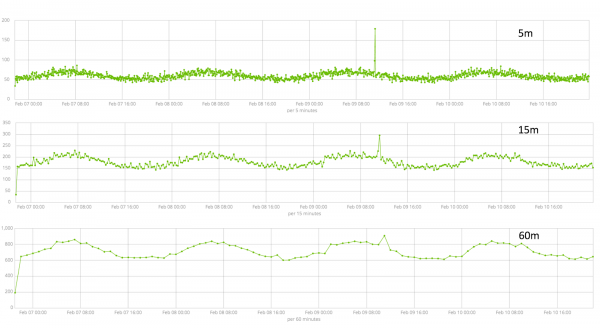
Délka shromážděných dat — klíčová věc, která ovlivňuje efektivitu analýzy. Při analýze algoritmus určuje opakující se intervaly, vypočítává interval spolehlivosti (základní linie) a odhaluje anomálie — netypická odchylky od běžného chování metriky. Jen pro příklad:
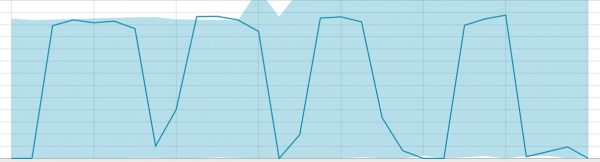
Základní linie při malém množství dat:
Když má algoritmus co učit, základní linie vypadají takto:
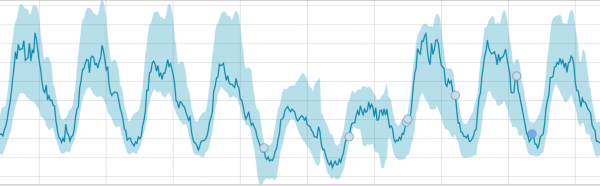
Po spuštění úkolu algoritmus určuje anomální odchylky od normy a třídí je podle pravděpodobnosti anomálie (v závorkách je uvedena barva odpovídajícího štítku):
Warning (modrá): méně než 25
Minor (žlutá): 25-50
Major (oranžová): 50-75
Critical (červená): 75-100
Na grafu níže je příklad s nalezenými anomáliemi.
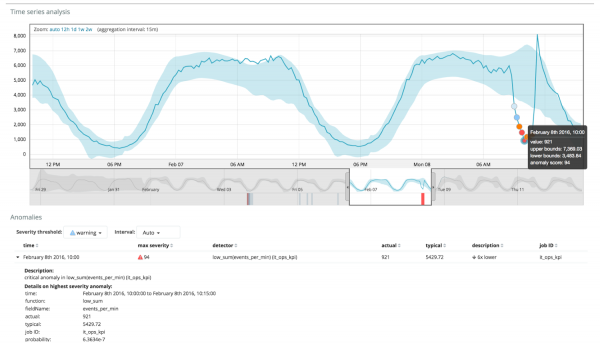
Zde je vidět číslo 94, které označuje pravděpodobnost anomálie. Je jasné, že vzhledem k tomu, že je hodnota blízká 100, máme před sebou anomálii. Ve sloupci pod grafem je uvedena zanedbatelná pravděpodobnost 0.000063634 % výskytu této hodnoty metriky.
Kromě hledání anomálií v Kibana lze spustit také prognózování. Dělá se to velmi jednoduše a z toho samého zobrazení s anomáliemi — tlačítko Forecast v pravém horním rohu.
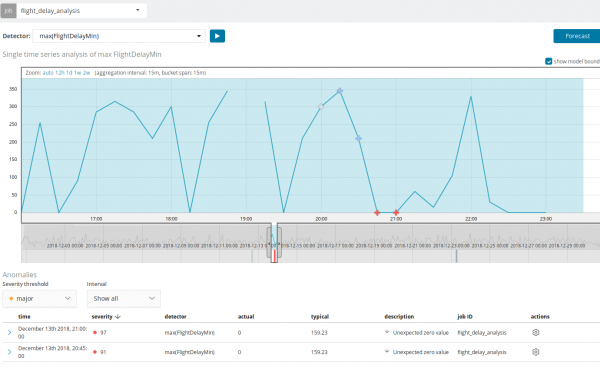
Prognóza se vytváří maximálně na 8 týdnů dopředu. I když si velmi přejete — více to nejde, a to záměrně.
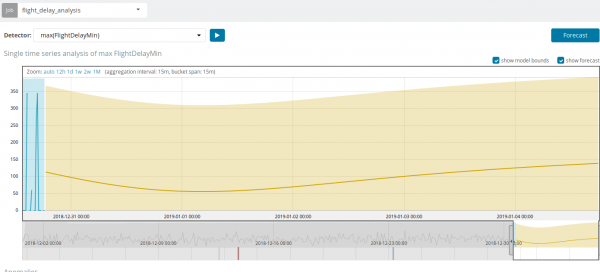
V některých situacích bude prognóza velmi užitečná, například když se sleduje uživatelská zátěž na infrastruktuře.
Multi Metric
Přejděme k další funkci ML v Elastic Stack — analýze několika metrik najednou. Ale to neznamená, že se bude analyzovat závislost jedné metriky na druhé. To je totéž co Single Metric, jen s více metrikami na jedné obrazovce pro snadné srovnání vlivu jedné na druhou. O analýze závislosti jedné metriky na druhé si povíme v části Population.
Po kliknutí na čtvereček s Multi Metric se otevře okno s nastavením. Na něm se zastavíme podrobněji.
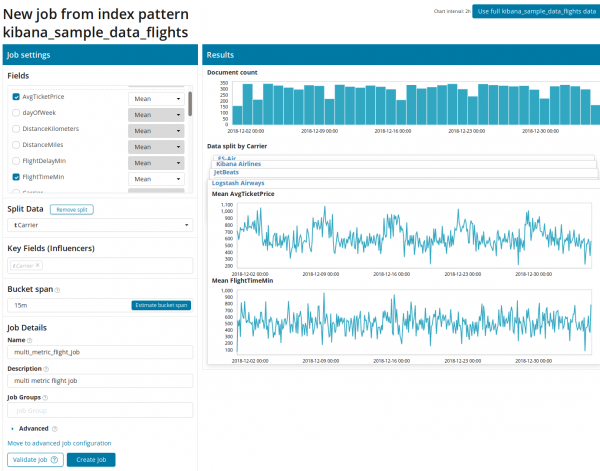
Nejprve je třeba vybrat pole pro analýzu a agregaci dat podle nich. Možnosti agregace jsou zde stejné jako pro Single Metric (Max, High Mean, Low, Mean, Distinct a další). Dále se data, pokud si to přejete, dělí podle jednoho z polí (pole Split Data). V příkladu jsme to udělali podle pole OriginAirportID. Všimněte si, že graf metrik vpravo je nyní zobrazen ve formě mnoha grafů.
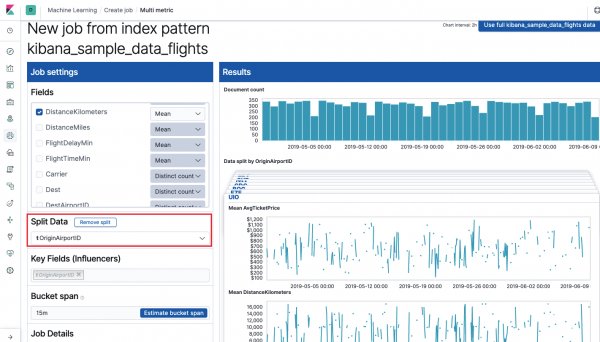
Pole Key Fields (Influencers) přímo ovlivňuje nalezené anomálie. Ve výchozím nastavení tu vždy bude alespoň jedna hodnota, ale vy můžete přidat další. Algoritmus bude při analýze brát v úvahu vliv těchto polí a ukáže nejvíce 'vlivné' hodnoty.
Po spuštění se v rozhraní Kibana objeví přibližně takový obrázek.
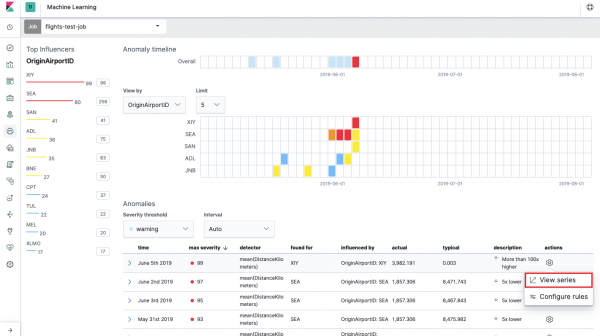
To je tzv. tepelná mapa anomálií podle každé hodnoty pole OriginAirportID, které jsme uvedli v Split Data. Stejně jako v případě Single Metric barva označuje úroveň anomálního odchylování. Podobnou analýzu je pohodlné provádět například na pracovních stanicích, abychom sledovali ty, kde je podezřele velké množství autorizací atd. Již jsme psali , které můžete také sbírat a analyzovat zde.
Pod tepelnou mapou je seznam anomálií, z každé můžete přejít na zobrazení Single Metric pro podrobnou analýzu.
Population
Aby bylo možné hledat anomálie mezi korelacemi mezi různými metrikami, existuje v Elastic Stack specializovaná analýza Population. Pomocí ní můžete hledat anomální hodnoty v výkonu nějakého serveru ve srovnání s ostatními, například při zvýšení počtu požadavků na cílový systém.
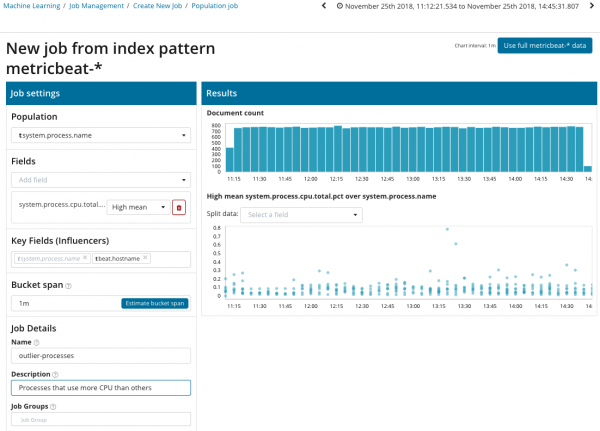
Na tomto obrázku je v poli Population uvedena hodnota, k níž se budou analyzované metriky vztahovat. V tomto případě je to název procesu. Výsledkem bude, že uvidíme, jak zatížení procesoru každým z procesů vzájemně ovlivňovalo.
Všimněte si, že graf analyzovaných dat se liší od případů se Single Metric a Multi Metric. To bylo v Kibana navrženo pro lepší vnímání distribuce hodnot analyzovaných dat.
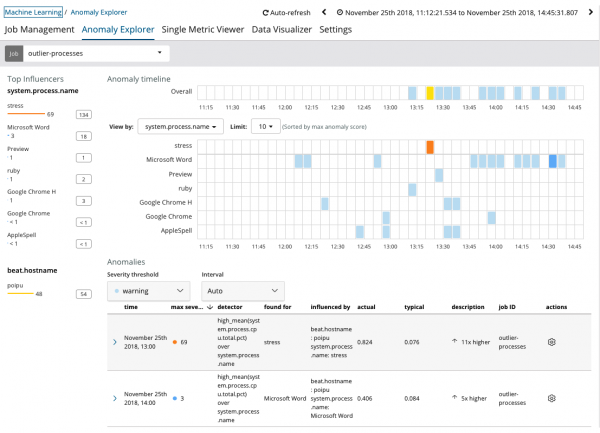
Z grafu je vidět, že proces stress ve skutečnosti, vytvořený speciálním nástrojem, se na serveru poipu, který měl vliv (nebo byl influencerem) na vznik této anomálie.
Advanced
Analytika s jemným nastavením. Při pokročilé analýze se v Kibana objeví další nastavení. Po kliknutí v menu vytvoření na dlaždici Advanced se objeví takové okno se záložkami. Záložku Job Details jsme záměrně vynechali, obsahuje základní nastavení, které se přímo netýká nastavení analýzy.
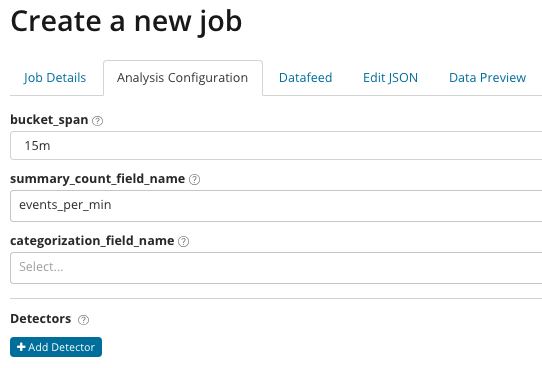
V summary_count_field_name případně můžete uvést název pole z dokumentů, které obsahuje agregované hodnoty. V tomto příkladu — počet událostí za minutu. V je uveden název hodnoty pole z dokumentu, které obsahuje určitou proměnnou hodnotu. Pomocí masky na toto pole lze rozdělit analyzovaná data na podmnožiny. Všimněte si tlačítka Add detector na předchozím obrázku. Níže je výsledek stisknutí tohoto tlačítka.
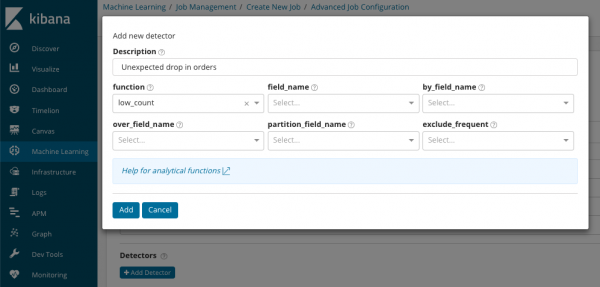
Zde je další blok nastavení pro přizpůsobení detektoru anomálií pro konkrétní úkol. Konkrétní případy použití (zejména v oblasti bezpečnosti) plánujeme probrat v následujících článcích. Například, jeden z probraných případů. Ten se týká vyhledávání vzácně se vyskytujících hodnot a realizuje se .
V poli function můžete si vybrat konkrétní funkci pro vyhledávání anomálií. Kromě rare, existují ještě další zajímavé funkce — . Tyto funkce odhalují anomálie v chování metrik během dne nebo týdne. Ostatní funkce analýzy .
V field_name uvádí pole dokumentu, podle kterého bude probíhat analýza. By_field_name může být použito pro rozdělení výsledků analýzy podle každé jednotlivé hodnoty zde uvedeného pole dokumentu. Pokud vyplníte over_field_name získáte population-analýzu, kterou jsme probrali výše. Pokud uvedete hodnotu v partition_field_name, budou podle tohoto pole dokumentu počítány jednotlivé základní linie pro každou hodnotu (v roli hodnoty mohou být například názvy serverů nebo procesů na serveru). V exclude_frequent si můžete vybrat all nebo none, což bude znamenat vyloučení (nebo zahrnutí) často se vyskytujících hodnot polích dokumentů.
V článku jsme se snažili co nejvíce stručně přiblížit možnosti strojového učení v Elastic Stack, mnohé podrobnosti však zůstaly mimo. Sdělte nám v komentářích, jaké případy se vám podařilo vyřešit pomocí Elastic Stack a pro jaké úkoly jej používáte. Pro kontakt s námi můžete využít soukromé zprávy na Habr nebo .
Zdroj: habr.com
