

Výzkum je pravděpodobně tou nejzajímavější součástí našeho vzdělávání. Idea spočívá v tom, vyzkoušet si ještě na univerzitě vybraný směr. Například studenti z oborů Software Engineering a Machine Learning často dělají výzkumné projekty ve firmách (většinou v JetBrains nebo Yandexu, ale nejen tam).
V tomto příspěvku vám povím o svém projektu zaměřeném na počítačové vědy. V rámci práce jsem zkoumal a prakticky realizoval přístupy k řešení jednoho z nejznámějších NP-těžkých problémů: problém pokrytí vrcholů.
V poslední době se velmi rychle vyvíjí zajímavý přístup k NP-těžkým problémům — parametrizované algoritmy. Pokusím se vás zasvětit do této problematiky, představím několik základních parametrizovaných algoritmů a popíšu jeden silný metod, který mi velmi pomohl. Své výsledky jsem představil na soutěži PACE Challenge: podle výsledků otevřených testů moje řešení obsadilo třetí místo, konečné výsledky budou známy 1. července.
O mně
Jmenuji se Vasilij Alferov, momentálně dokončuji třetí rok na Vysoké škole ekonomické — Petrohrad. Algoritmy mě zajímají už od školních časů, kdy jsem studoval na moskevské škole číslo 179 a úspěšně se účastnil olympiád z informatiky.
Konečný počet specialistů na parametrizované algoritmy vstupuje do baru…
Příklad je převzat z knihy
Představte si, že jste vrátný v baru v malém městě. Každý pátek polovina města přichází do vašeho baru odpočívat, což vám dělá nemalé starosti: musíte vyhazovat divoké návštěvníky z baru, abyste zabránili bitkám. Nakonec vás to přestává bavit a rozhodnete se přijmout preventivní opatření.
Protože máte malé město, přesně víte, které páry návštěvníků se s vysokou pravděpodobností pohádají, pokud se ocitnou v baru spolu. Máte seznam n lidí, kteří přijdou dnes večer do baru. Rozhodnete se nevpustit do baru některé místní obyvatele tak, aby se nikdo nepobodal. Zároveň vaše vedení nechce přijít o zisk a bude nespokojené, pokud do baru nepustíte více než k lidí.
Bohužel úkol, který před vámi stojí, je klasický NP-těžký problém. Měli jste ho možná znát jako , nebo jak úlohu o vrcholovém pokrytí. Pro takové úlohy obvykle neexistují algoritmy, které by pracovaly v přijatelném čase. Pokud budeme přesní, tak nedokázaná a docela silná hypotéza ETH (Exponential Time Hypothesis) říká, že tato úloha není řešitelná za čas  , tedy že není nijak výrazně lepší než úplné procházení. Například, pokud se k vám do baru chystá přijít n = 1000 lidí. Poté by úplný průchod měl
 variant, což je zhruba
 — nesmírně mnoho. Naštěstí vám vaše vedení stanovilo omezení k = 10, takže počet kombinací, které musíte procházet, je mnohem menší: počet podmnožin o deseti prvcích je roven
 . To už je lepší, ale i tak to nevyčítáte za den ani na výkonném clusteru.
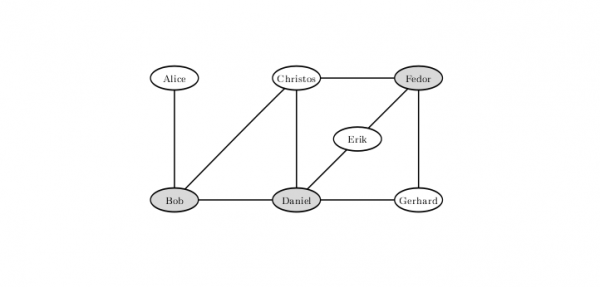
Aby se vyloučila pravděpodobnost hádky při takové konfiguraci napjatých vztahů mezi návštěvníky baru, je nutné nepustit Boba, Daniela a Fjodora. Řešení, kdy zůstanou venku pouze dva, neexistuje.
Znamená to, že je čas se vzdát a vpustit všechny? Zvážíme další možnosti. Například můžeme nepustit pouze ty, kdo pravděpodobně budou mít konflikt s velmi mnoha lidmi. Pokud se někdo může poprat alespoň s k + 1 dalšími lidmi, tak ho rozhodně pustit nelze — jinak budete muset nepustit všechny k + 1 obyvatele, se kterými může mít konflikt, což již určitě rozruší vedení.
Představte si, že jste vyhodili všechny, které jste mohli, podle tohoto principu. Poté mohou ostatní mít konflikt maximálně s k lidmi. Když z nich vyhodíte k lidí, můžete zabránit maximálně  konfliktům. To znamená, že pokud se více než
 lidí účastní alespoň jednoho konfliktu, jistě nebudete moci zabránit všem. Jak je zřejmé, ty, kteří nejsou konfliktní, určitě pustíte, takže musíte projít všechny podmnožiny o velikosti deset ze dvou stovek lidí. Těch je zhruba
 , a takové množství operací už lze projet na clusteru.
Pokud je možné bezpečně vzít zcela nekonfliktní osobnosti, co říct o těch, kteří se účastní jen jednoho konfliktu? Opravdu, i tyto můžeme pustit dovnitř, pokud zavřeme dveře před jejich protivníkem. A vlastně, pokud Alice konfliktuje pouze s Bobem, tak když pustíme Alici z těch dvou, neprohrajeme: Bob může mít jiné konflikty, zatímco Alice žádné určitě nemá. Navíc by pro nás nedávalo smysl nepustit oba. Po takových operacích nám zbyde maximálně  hostů s nevyřešeným osudem: celkem máme
 konfliktů, v každém jsou dva účastníci a každý se účastní alespoň dvou. To znamená, že musíme projít pouze
 varianty, což se dá samozřejmě spočítat za půl dne na notebooku.
Opravdu, jednoduchými úvahami můžeme dosáhnout ještě atraktivnějších podmínek. Všimněme si, že nutně musíme vyřešit všechny spory, tedy z každé konfliktující dvojice vybrat alespoň jednu osobu, kterou nepustíme dovnitř. Zvažme takový algoritmus: vezmeme jakýkoli konflikt, ze kterého odstraníme jednoho účastníka a rekurzivně se pustíme od zbytku, poté odstraníme druhého a také rekurzivně se pustíme. Protože na každém kroku někoho vylučujeme, strom rekurze tohoto algoritmu je binární strom hloubky k, takže celkově algoritmus pracuje za  , kde n – počet vrcholů, a m – počet hran. V našem příkladu je to kolem deseti milionů, což se za zlomek sekundy spočítá nejen na notebooku, ale i na mobilním telefonu.
Uvedený příklad výše je příkladem parametrizovaného algoritmu. Parametrizované algoritmy jsou algoritmy, které pracují za čas f(k) poly(n), kde p – polynom, f – libovolná počitatelná funkce, a k – nějaký parametr, který může být mnohem menší než velikost úlohy.
Všechny úvahy do tohoto algoritmu vedou příklad kernelizace — jednou z běžných technik pro vytváření parametrizovaných algoritmů. Kernelizace je zmenšení velikosti úlohy na hodnotu, která je omezena funkcí od parametru. Získanou úlohu často nazýváme jádrem. Tak jsme jednoduchými úvahami o stupních vrcholů získali kvadratické jádro pro úlohu Vertex Cover parametrizovanou velikostí odpovědi. Existují i jiné parametry, které lze zvolit pro tuto úlohu (například Vertex Cover Above LP), ale budeme diskutovat právě o tomto parametru.
Pace Challenge
Soutěž (The Parameterized Algorithms and Computational Experiments Challenge) vznikla v roce 2015, aby vytvořila spojení mezi parametrizovanými algoritmy a přístupy používanými v praxi k řešení výpočetních úloh. První tři soutěže byly zaměřeny na hledání stromové šířky grafu (), hledání Steinertova stromu () a hledání množiny vrcholů, které překrajuje cykly (). V tomto roce jednou z úloh, ve kterých si mohli účastníci vyzkoušet své síly, byla výše zmíněná úloha o vrcholovém pokrytí.
Soutěž každým rokem získává na popularitě. Pokud se věří předběžným údajům, v tomto roce se v soutěži zaměřené na řešení úlohy vrcholového pokrytí účastnilo 24 týmů. Je třeba poznamenat, že soutěž netrvá několik hodin ani týden, ale několik měsíců. Týmy mají možnost prostudovat literaturu, vymyslet svůj originální nápad a pokusit se jej realizovat. V podstatě tato soutěž představuje výzkumnou práci. Nápady nejefektivnějších řešení a vyhlášení vítězů proběhne společně s konferencí (International Symposium on Parameterized and Exact Computation) v rámci největšího každoročního algoritmického setkání v Evropě . Podrobnější informace o samotné soutěži lze nalézt na , zatímco výsledky z minulých let jsou k dispozici .
Schéma řešení
Aby se vypořádal se problémem pokrytí vrcholů, zkusil jsem použít parametrizované algoritmy. Obvykle se skládají ze dvou částí: pravidel zjednodušení (která ideálně vedou k jádrování) a pravidel dělení. Pravidla zjednodušení jsou předzpracování vstupu v polynomiálním čase. Cílem použití těchto pravidel je převést problém na ekvivalentní problém menší velikosti. Pravidla zjednodušení jsou nejnákladnější částí algoritmu a aplikace této části vede ke celkovému času běhu  namísto jednoduchého polynomiálního času. V našem případě jsou pravidla dělení založena na tom, že pro každý vrchol je potřeba vzít buď jeho, nebo jeho souseda.
Obecná schéma je taková: používáme pravidla zjednodušení, pak si vybíráme nějaký vrchol a provádíme dva rekurzivní volání: v prvním bereme jeho jako odpověď, a ve druhém bereme všechny jeho sousedy. To nazýváme dělením (branching) podle tohoto vrcholu.
Do této schémy bude přidáno přesně jedno doplnění v následujícím odstavci.
Myšlenky pro pravidla dělení (branching)
Pojďme diskutovat, jak vybrat vrchol, podle kterého dojde k dělení.
Hlavní myšlenka je velmi chtivá v algoritmickém smyslu: vezměme vrchol s maximálním stupněm a rozdělme se právě podle něj. Proč se zdá, že je to lepší? Protože ve druhé větvi rekurzivního volání takto odstraníme spoustu vrcholů. Můžeme očekávat, že zůstane malý graf a na něm budeme pracovat rychle.
Tento přístup s již projednanými jednoduchými technikami jádrování se ukazuje jako slušný, řeší určité testy o velikosti několika tisíc vrcholů. Ale například špatně funguje pro kubické grafy (tj. grafy, jejichž stupeň každého vrcholu je tři).
Je tu ještě jedna myšlenka, vycházející z poměrně jednoduché myšlenky: pokud je graf nespojený, úlohu na jeho komponentách spojitosti lze řešit nezávisle, a na konci spojit odpovědi. To je mimochodem malá slíbená modifikace ve schématu, která podstatně urychlí řešení: dříve jsme v takovém případě pracovali za násobení časů počítání odpovědí komponent, a nyní pracujeme za součet. A pro zrychlení dělení je potřeba převést spojitý graf na nespojený.
Jak to udělat? Pokud je v grafu bod rozvětvení, je třeba rozvětvit právě podle něj. Bod rozvětvení je vrchol, jehož odstranění způsobí ztrátu spojitosti grafu. Všechny body rozvětvení lze v grafu najít klasikou algoritmem v lineárním čase. Tento přístup výrazně urychluje rozvětvování.
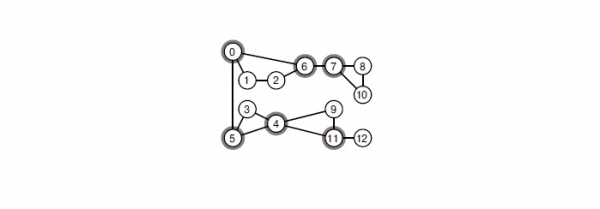
Při odstranění libovolného z vyznačených vrcholů se graf rozpadne na komponenty spojitosti.
To uděláme, ale chtěli bychom více. Například hledat v grafu malé vrcholové řezy a provádět rozdělení podle vrcholů z něj. Nejefektivnější způsob, který znám pro nalezení minimálního globálního vrcholového řezu, je využití Gomorii-Huova stromu, který se staví v kubickém čase. V PACE Challenge je typická velikost grafu několik tisíc vrcholů. Při tomto scénáři musí být na každém vrcholu rekurzivního stromu provedeno miliardy operací. Takže vyřešit úlohu v daném čase je prostě nemožné.
Pokusíme se optimalizovat řešení. Minimální vrcholový řez mezi dvojicí vrcholů lze nalézt jakýmkoliv algoritmem, který staví maximální tok. Můžeme na takovou síť aplikovat , který v praxi funguje velmi rychle. Mám podezření, že teoreticky lze dokázat odhad na časovou složitost  , což je už zcela přijatelné.
Zkoušel jsem několikrát hledat řezy mezi páry náhodných vrcholů a brát z nich ten nejvyváženější. Bohužel, na otevřených testech PACE Challenge to přineslo špatné výsledky. Porovnával jsem s algoritmem, který se pokoušel rozdělit podle vrcholů s maximálním stupněm, spouštějícím je s omezením na hloubku poklesu. Po algoritmu, který se snažil najít řez tímto způsobem, zůstávaly grafy většího rozměru. To souvisí s tím, že řezy byly velmi nevyvážené: odstraněním 5-10 vrcholů bylo možné odštěpit pouze 15-20.
Je třeba si povšimnout, že v článcích o teoreticky nejrychlejších algoritmech se používají mnohem pokročilejší techniky výběru vrcholů pro dělení. Tyto techniky mají velmi složitou implementaci a často špatné odhady na čas a paměť. Nepodařilo se mi z nich vybrat zcela přijatelné pro praxi.
Jak aplikovat pravidla zjednodušení
Už máme nápady na kernelizaci. Připomínám:
- Pokud je vrchol izolovaný, je třeba jej odstranit.
- Pokud existuje vrchol stupně 1, odstraňte ho a vezměte jeho souseda jako odpověď.
- Pokud existuje vrchol stupně alespoň k + 1, vezměte ho jako odpověď.
První dva jsou jasní, s třetím je jeden trik. Pokud jsme v vtipné úloze o baru měli horní omezení na k, v PACE Challenge musíme jednoduše najít vrcholové pokrytí minimální velikosti. To je typická transformace úloh hledání (Search Problem) na úlohy rozhodování (Decision Problem), často se mezi těmito dvěma typy úloh nedělá rozdíl. V praxi, pokud píšeme řešitel úlohy o vrcholovém pokrytí, rozdíl může být. Například v třetím bodě.
Z pohledu implementace lze postupovat dvěma způsoby. První přístup se nazývá Iterative Deepening. Ten spočívá v tom, že můžeme začít s nějakým rozumným dolním omezením na odpověď a poté spustit náš algoritmus, používající toto omezení jako horní omezení na odpověď, aniž bychom se dostali do rekurze hlouběji, než na toto omezení. Pokud jsme našli nějakou odpověď, je zaručeně optimální, jinak můžeme toto omezení zvýšit o jednotku a znovu spustit.
Druhý přístup – uchovávat nějakou aktuální optimální odpověď a hledat odpověď menší velikosti, při nalezení měníme tento parametr k k většímu otravování nadbytečných větví v hledání.
Po několika nočních experimentech jsem se zastavil na kombinaci těchto dvou způsobů: nejprve spustím svůj algoritmus s nějakým omezením na hloubku hledání (navrhuji ho tak, aby to trvalo zanedbatelný čas ve srovnání s hlavním řešením) a používám nejlepší nalezené řešení jako horní omezení na odpověď – tedy na to právě k.
Vrcholům stupně 2
S vrcholy stupně 0 a 1 jsme se vypořádali. Ukazuje se, že to lze udělat i s vrcholy stupně 2, ale pro to si graf vyžaduje složitější operace.
Aby to bylo vysvětleno, je potřeba nějak označit vrcholy. Označme vrchol stupně 2 jako vrchol v, a jeho sousedy jako vrcholy x a y. Dále budeme mít dva případy.
- Když x a y – sousedy. Pak lze vzít jako odpověď x a y, a v odstranit. A opravdu, z tohoto trojúhelníku musí být alespoň dva vrcholy vzaty jako odpověď a rozhodně neprohrajeme, pokud vezmeme x a y: pravděpodobně mají ještě sousedy, ale v oni nemají.
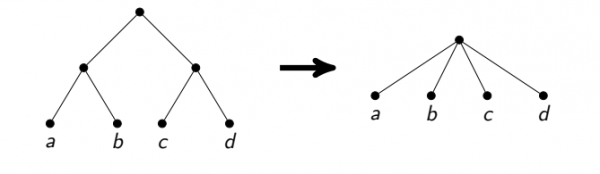
- Když x a y — ne sousedé. Poté se tvrdí, že všechny tři vrcholy lze spojit do jednoho. Myšlenka je v tom, že v takovém případě existuje optimální odpověď, ve které vezmeme buď v, nebo oba vrcholy x a y. Výslovně v prvním případě budeme muset vzít všechny sousedy x a y, zatímco ve druhém to není nutné. To přesně odpovídá případům, kdy nesbíráme spojený vrchol jako odpověď a kdy ho sbíráme. Nyní je třeba poznamenat, že v obou případech se odpověď takové operace snižuje o jednotku.
Stojí za zmínku, že takový přístup je při dodržení čestného lineárního času poměrně obtížné dokonale realizovat. Spojení vrcholů je složitá operace, je třeba zkopírovat seznamy sousedů. Pokud to uděláte neopatrně, můžete získat asymptoticky suboptimální čas práce (například pokud po každém spojení zkopírujete mnoho hran). Zastavil jsem se u hledání celých cest z vrcholů s 2 stupni a analyzoval jsem celou řadu speciálních případů, jako jsou cykly z těchto vrcholů nebo ze všech takových vrcholů kromě jednoho.
Kromě toho je třeba, aby tato operace byla vratná, aby jsme během návratu z rekurze obnovili graf do původního stavu. Pro zajištění toho jsem nečistil seznamy hran spojených vrcholů, po čemž jsem věděl, které hrany kam nasměrovat. Taková implementace grafů také vyžaduje opatrnost, ale poskytuje čestný lineární čas. A pro grafy s několika desítkami tisíc hran už se vejde do mezipaměti procesoru, což přináší velké výhody ve rychlosti.
Lineární jádro
Nakonec, nejzajímavější částí jádra.
Nejprve si vzpomeňme, že v bipartitních grafech lze minimální vrcholové pokrytí hledat za  . K tomu je třeba použít algoritmus pro nalezení maximální párové přihrávky, a poté využít věty .
Myšlenka lineárního jádra je následující: nejprve rozdělíme graf, to znamená, že místo každého vrcholu v vytvoříme dva vrcholy  a
 , a místo každé hrany u — v vytvoříme dvě hrany
 a
 Získaný graf bude dvoudílný. Najdeme v něm minimální vrcholové pokrytí. Některé vrcholy původního grafu se tam dostanou dvakrát, některé pouze jednou a některé ani jednou. Věta Nemhausera-Trottera tvrdí, že v tomto případě můžeme odstranit vrcholy, které se nedostaly ani jednou, a do odpovědi zahrnout ty, které se dostaly dvakrát. Navíc říká, že z zbývajících vrcholů (těch, které se dostaly jednou) je třeba vzít alespoň polovinu.
Právě jsme se naučili ponechat v grafu maximálně 2k vrcholů. A skutečně, pokud zbývá odpověď — alespoň polovina všech vrcholů, pak celkový počet vrcholů tam není větší než 2k.
Tady se mi podařilo udělat malý krok vpřed. Je jasné, že jádro postavené tímto způsobem závisí na tom, které minimální vrcholové pokrytí v dvoudílném grafu jsme vzali. Rád bych vzal takové, aby počet zbývajících vrcholů byl minimální. Dříve to šlo udělat jen za čas  . Jsem však vymyslel implementaci tohoto algoritmu za čas
 , takže toto jádro lze hledat na grafech s několika sty tisíci vrcholy na každém kroku větvení.
Výsledek
Praxe ukazuje, že moje řešení dobře funguje na testech se stovkami vrcholů a několika tisíci hranami. Na takových testech je docela možné očekávat, že řešení bude nalezeno za půl hodiny. Pravděpodobnost nalezení odpovědi v přijatelném čase obecně roste, pokud je v grafu dostatečně mnoho vrcholů s vysokým stupněm, například stupně 10 a více.
Pro účast v soutěži bylo třeba odeslat řešení na . Podle uvedené , moje řešení na otevřených testech obsazuje třetí místo z dvaceti s velkým odstupem od druhého. Pokud jsem úplně upřímný, není úplně jasné, jak budou hodnocena řešení na samotné soutěži: například mé řešení prochází méně testy než řešení na čtvrtém místě, ale na těch, které prochází, pracuje rychleji.
Výsledky na uzavřených testech se stanou známými prvního července.
Zdroj: habr.com
