

Ahoj! Jmenuji se Vadim Madison a vedu vývoj System Platform pro Avito. O tom, jak přecházíme z monolitické architektury na mikroslužby, už bylo řečeno mnohokrát. Je čas podělit se o to, jak jsme transformovali naši infrastrukturu, abychom z mikroslužeb vytěžili co nejvíce výhod a neztratili se v nich. Jak nám v tom pomáhá PaaS, jak jsme zjednodušili nasazení a převedli vytvoření mikroslužby na jedno kliknutí — čtěte dál. Ne vše, co zde píšu, bylo na Avito plně implementováno, část je to, jak vyvíjíme naši platformu.
(A na konci tohoto článku se podělím o možnost zúčastnit se třídenního semináře od odborníka na mikroslužbovou architekturu Chrise Richardsona).
Jak jsme přišli k mikroslužbám
Avito je jedním z největších online bazarů na světě, každý den zde vyjde více než 15 milionů nových inzerátů. Naše backendová infrastruktura zpracovává více než 20 000 požadavků za sekundu. V současnosti máme několik stovek mikroslužeb.
Mikroslužbovou architekturu budujeme už několik let. Jak přesně — naši kolegové podrobněji o tom promluvili na naší sekci na RIT++ 2017. Na CodeFest 2017 (viz ), Sergej Orlov a Michail Prokoptchuk podrobně vysvětlili, proč vlastně potřebujeme přechod na mikroslužby a jakou roli zde hraje Kubernetes. Teď děláme vše, co je v našich silách, abychom minimalizovali náklady na škálování, které je pro takovou architekturu typické.
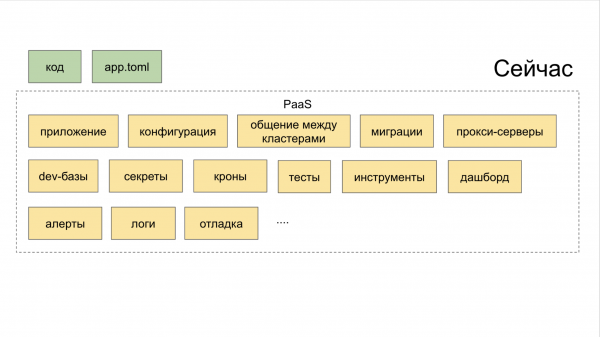
Původně jsme nevytvářeli ekosystém, který by nám komplexně pomáhal při vývoji a nasazení mikroslužeb. Jen jsme shromažďovali kvalitní open-source řešení, nasazovali je u nás a nabízeli vývojářům, aby si s nimi poradili. Výsledkem bylo, že vývojáři skákali mezi deseti místy (dashboardy, interní služby), což je posílilo v touze psát kód starým způsobem, v monolitu. Na schématech níže je zelenou barvou označeno to, co vývojář dělá nějakým způsobem sám, žlutou barvou — automatizace.
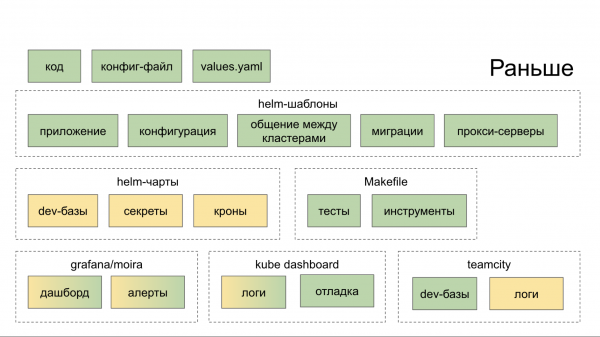
Nyní pomocí CLI nástroje PaaS vytvoříte nový servis jedním příkazem, dalšími dvěma se přidá nová databáze a nasadí se na Stage.
Jak překonat éru "mikroslužbové roztříštěnosti"
Při monolitní architektuře, kvůli konzistenci změn v produktu, byli vývojáři nuceni zjišťovat, co se děje u sousedů. Při práci s novou architekturou přestaly kontexty služeb záviset jedna na druhé.
Aby byla mikroslužbová architektura efektivní, je třeba nastavit mnoho procesů, a to konkrétně:
• protokolování;
• sledování požadavků (Jaeger);
• agregaci chyb (Sentry);
• stavy, zprávy, události z Kubernetes (Event Stream Processing);
• race limit / circuit breaker (můžete použít Hystrix);
• kontrolu provázanosti služeb (používáme Netramesh);
• monitorování (Grafana);
• sestavování (TeamCity);
• komunikaci a notifikace (Slack, email);
• sledování úkolů; (Jira)
• vytváření dokumentace.
Aby systém při expandování neztratil integritu a zůstal efektivní, přepracovali jsme organizaci práce mikroslužeb v Avitu.
Jak řídíme mikroslužby
Jednotnou „politiku strany“ mezi mnoha mikroslužbami Avita pomáhá udržovat:
- rozdělení infrastruktury do vrstev;
- koncept Platform as a Service (PaaS);
- monitoring všeho, co se s mikroslužbami děje.
Úrovně abstrahování infrastruktury zahrnují tři vrstvy. Pojďme od horní k dolní.
A. Horní — service mesh. Na začátku jsme zkoušeli Istio, ale ukázalo se, že používá příliš mnoho zdrojů, což je na našich objemech příliš drahé. Proto senior inženýr v architektonickém týmu Alexander Lukjancevnko vyvinul vlastní řešení — (dostupné v Open Source), které nyní používáme v produkci a které spotřebovává několikanásobně méně zdrojů než Istio (ale také nedělá všechno, čím se může Istio pochlubit).
B. Střední — Kubernetes. Na něm nasazujeme a provozujeme mikroslužby.
C. Spodní — bare metal. Nepoužíváme cloudové služby ani podobné věci jako OpenStack, ale máme vše kompletně na bare metal.
Všechny vrstvy spojuje PaaS. Tato platforma se na oplátku skládá ze tří částí.
I. Generátory, řízené přes CLI utility. Ta pomáhá vývojáři vytvořit mikroslužbu správně a s minimálními námahou.
II. Agregátor s kontrolou všech nástrojů přes společný dashboard.
III. Úložiště. Integruje se s plánovači, kteří automaticky nastavují spouštěče na významné akce. Díky tomuto systému žádný úkol nezůstane opominutý jen proto, že někdo zapomněl si zadat úkol do Jira. Pro to používáme interní nástroj nazvaný Atlas.
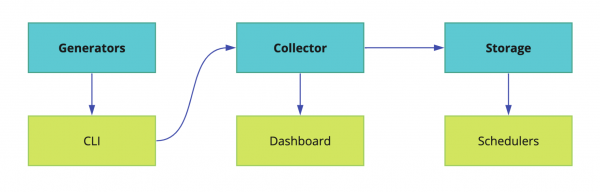
Implementace mikroslužeb na Avitu probíhá také podle jednotného schématu, což zjednodušuje kontrolu nad nimi v každé fázi vývoje a uvolnění.
Jak funguje standardní konvejový proces vývoje mikroslužeb
V obecné podobě řetězec vytváření mikroslužby vypadá takto:
CLI-push → Kontinuální integrace → Bake → Nasazení → Umělé testy → Canary testy → Squeeze Testing → Produkce → Údržba.
Projdeme si ji přesně v tomto pořadí.
CLI-push
• Vytváření mikroslužby.
Dlouho jsme se snažili naučit každého vývojáře, jak dělat mikroslužby. Včetně psaní podrobných pokynů do Confluence. Ale schémata se měnila a doplňovala. Výsledek — v počátku se vytvořilo úzké hrdlo: spuštění mikroslužeb zabíralo mnohem více času, než bylo přijatelné, a přesto se při jejich vytváření často objevovaly problémy.
Nakonec jsme vytvořili jednoduchou CLI utilitu, která automatizuje hlavní kroky při vytváření mikroslužby. V podstatě nahrazuje první git push. Tady je konkrétně, co dělá.
— Vytváří službu podle šablony — krok za krokem, v režimu „průvodce“. Máme šablony pro hlavní programovací jazyky na backendu Avita: PHP, Golang a Python.
— S jedním příkazem nasazuje prostředí pro místní vývoj na konkrétním stroji — spouští se Minikube, Helm grafy se automaticky generují a spouští na místním Kubernetes.
— Připojuje potřebnou databázi. Vývojář nepotřebuje znát IP, přihlašovací jméno a heslo, aby získal přístup k potřebné databázi — ať už lokálně, na Stage nebo na produkci. Při tom se databáze nasazuje ihned v konfiguraci odolné vůči poruchám a s vyvážením.
— Sama provádí live build. Představme si, že vývojář něco upravil v mikroslužbě přes svou IDE. Utilita vidí změny v souborovém systému a na jejich základě přestavuje aplikaci (pro Golang) a restartuje ji. Pro PHP jednoduše propojujeme adresář uvnitř kontejneru a tam live-reload se děje „automaticky“.
— Generuje automatizované testy. Ve formátu šablon, ale zcela použitelné.
• Nasazení mikroslužby.
Dříve bylo nasazení mikroslužby poněkud komplikované. Bylo nutné dodržet:
I. Dockerfile.
II. Konfiguraci.
III. Helm-chart, který je sám o sobě objemný a zahrnuje:
— samotné charty;
— šablony;
— konkrétní hodnoty s ohledem na různá prostředí.
Odbourali jsme bolest spojenou s překopáváním manifestů Kubernetes, a nyní se generují automaticky. Hlavně jsme však nasazení maximálně zjednodušili. Nyní máme Dockerfile a celou konfiguraci vývojář zapisuje do jednoho krátkého souboru app.toml.
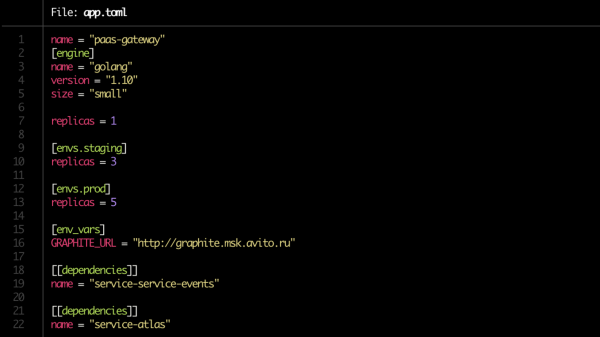
A také v samotném app.toml je teď práce otázkou minut. Zapisujeme, kolik kopií služby zvednout (na dev-serveru, na stagingu, na produkci), uvádíme její závislosti. Všimněte si řádku size = "small" v bloku [engine]. To je limit, který bude vyhrazen službě přes Kubernetes.
Dále na základě konfigurace automaticky generujeme všechny potřebné Helm-charty a vytváříme připojení k databázím.
• Základní validace. Takové kontroly jsou také automatizované.
Je třeba sledovat:
— zda existuje Dockerfile;
— zda existuje app.toml;
— zda je dokumentace;
— zda jsou závislosti v pořádku;
— zda jsou nastaveny pravidla alertů.
K poslednímu bodu: vlastník služby sám určuje, které produktové metriky sledovat.
• Příprava dokumentace.
Dále stále problematické místo. Zdá se to být nejvíce zřejmé, ale zároveň je to rekordně "často zapomínané", a tím pádem i zranitelné místo v řetězci.
Je nutné, aby dokumentace byla pro každou mikroslužbu. Zahrnuje následující bloky.
I. Stručný popis služby. Doslova několik vět o tom, co dělá a k čemu je potřeba.
II. Odkaz na diagram architektury. Je důležité, aby bylo při rychlém pohledu jasné, zda používáte Redis pro caching nebo jako hlavní úložiště dat v perzistentním režimu. V Avitu je to prozatím odkaz na Confluence.
III. Runbook. Krátký průvodce spuštěním služby a jejími specifiky.
IV. FAQ, kde by bylo dobré předvídat problémy, se kterými se mohou vaši kolegové setkat při práci se službou.
V. Popis endpoints pro API. Pokud jste náhodou neuvedli cílové body, téměř jistě budou muset zaplatit vaši kolegové, jejichž mikroservisy jsou spojené s vašimi. V současné době používáme k tomu Swagger a naše řešení nazvané brief.
VI. Štítky. Nebo markery, které ukazují, k jakému produktu, funkčnosti, nebo organizační jednotce společnosti patří služba. Pomáhají rychle pochopit, zda náhodou nevyvíjíte funkčnost, kterou před týdnem nasadili vaši kolegové pro stejnou obchodní jednotku.
VII. Vlastník nebo vlastníci služby. V drtivé většině případů bývá jeho — nebo jejich — určení pomocí PaaS automatické, ale pro jistotu vyžadujeme, aby je vývojář uvedl i ručně.
Nakonec je dobrá praxe provádět revizi dokumentace, podobně jako při kódové revizi.
Continuous Integration
- Příprava repozitářů.
- Vytvoření pipeline v TeamCity.
- Nastavení oprávnění.
- Hledání vlastníků služby. Zde je hybridní schéma — ruční označování a minimální automatizace od PaaS. Úplně automatické schéma selhává při předávání služeb na podporu jiné vývojářské týmu nebo například když vývojář služby odešel.
- Registrace služby v Atlasu (viz výše). Se všemi jejími vlastníky a závislostmi.
- Kontrola migrací. Kontrolujeme, zda mezi nimi nejsou potenciálně nebezpečné. Například v jedné z nich se objevuje alter table nebo něco jiného, co by mohlo narušit kompatibilitu datového schématu mezi různými verzemi služby. Potom se migrace neprovádí, ale je zařazena do fronty — PaaS by měla upozornit vlastníka služby, kdy bude bezpečné ji aplikovat.
Bake
Další fáze — balení služeb před nasazením.
- Sestavení aplikace. Podle klasiky — do Docker obrazu.
- Generování Helm chartů pro samotnou službu a související zdroje. Včetně databází a cache. Ty jsou vytvářeny automaticky podle konfiguračního souboru app.toml, který byl vytvořen během fáze CLI-push.
- Vytváření tiketů administrátorům k otevření portů (když je to nutné).
- Provedení unit testů a výpočet code coveragePokud pokrytí kódu klesne pod stanovenou prahovou hodnotu, pravděpodobně služba neprojde nasazením. Pokud se bude nacházet na hranici povoleného, bude službě přidělen "pesimistický" koeficient: pak, pokud nedojde k zlepšení ukazatelů v průběhu času, vývojář obdrží oznámení, že nedochází k pokroku v testech (a bylo by dobré s tím něco udělat).
- Zohlednění omezení paměti a CPUHlavně mikroservisy píšeme v Golangu a spouštíme je v Kubernetes. Odtud vyplývá jedna nuance spojená se zvláštnostmi jazyka Golang: při spuštění se ve výchozím nastavení využívají všechny jádra na stroji, pokud explicitně nenastavíte proměnnou GOMAXPROCS, a když na jednom stroji spouštíme několik takových služeb, začnou si konkurovat o zdroje a narušovat se navzájem. Na grafech níže je zobrazeno, jak se mění doba vykonávání, pokud spustíte aplikaci bez konkurence a v režimu závodu o zdroje. (Zdroje grafů jsou uloženy ).
Čas vykonávání, méně je lepší. Maximum: 643ms, minimum: 42ms. Foto je klikatelné.
Doba na operaci, méně je lepší. Maximum: 14091 ns, minimum: 151 ns. Foto je klikatelné.
Ve fázi přípravy sestavení lze tuto proměnnou výslovně nastavit, nebo lze použít knihovnu od kluků z Uberu.
Nasazení
• Kontrola konvencí. Předtím, než začneme dodávat sestavy služby do určených prostředí, je nutné zkontrolovat následující:
— API koncové body.
— Shoda odpovědí API koncových bodů se schématem.
— Formát logů.
— Nastavení hlaviček při dotazech na službu (to aktuálně dělá netramesh)
— Nastavení majitele při odesílání zpráv do sběrnice (event bus). To je nutné pro sledování spojitosti služeb prostřednictvím sběrnice. Do sběrnice lze odesílat jak idempotentní data, která nezvyšují spojitost služeb (což je dobře), tak obchodní data, která spojitost služeb posilují (což je velmi špatně!). A v okamžiku, kdy se tato spojitost stane problémem, pochopení toho, kdo píše a čte sběrnici, pomáhá správně rozdělit služby.
Dosud není v službě Avito příliš mnoho konvencí, ale jejich okruh se rozšiřuje. Čím více takových dohod ve formátu, který je srozumitelný a удобný pro tým, tím snazší je udržovat konzistenci mezi mikroservisy.
Syntetické testy
• Testování v uzavřeném konturu. Pro něj nyní používáme opensourcový Nejprve zaznamenává skutečné zatížení služby, a poté — v uzavřeném okruhu — to emuluje.
• Zátěžové testování. Snažíme se optimalizovat výkon všech služeb. A všechny verze každé služby musí být podrobeny zátěžovému testování — tak můžeme pochopit aktuální výkon služby a rozdíl oproti předchozím verzím téže služby. Pokud po aktualizaci služby výkon klesne o polovinu, je to jasný signál pro její vlastníky: je třeba se ponořit do kódu a situaci napravit.
Na základě shromážděných údajů se orientujeme například při správné implementaci auto scalingu a nakonec vůbec pochopíme, jak moc je služba schopná škálování.
Při zátěžovém testování kontrolujeme, zda spotřeba zdrojů odpovídá stanoveným omezením. A zaměřujeme se především na extrémy.
a) Sledujeme celkové zatížení.
— Příliš nízké — pravděpodobně něco vůbec nefunguje, pokud zatížení náhle kleslo několikrát.
— Příliš vysoké — je třeba optimalizace.
b) Sledujeme prahovou hodnotu podle RPS.
Tady sledujeme jak rozdíl mezi aktuální a předchozí verzí, tak celkové množství. Například, pokud služba vydává 100 rps — je buď špatně napsaná, nebo je to její specifikum, ale v každém případě je to důvod se na službu podívat velmi pečlivě.
Pokud je RPS naopak příliš vysoké, může být nějaká chyba a některý z endpointů přestal vykonávat užitečnou zátěž a jen se spouští nějaký return true;
Canary testy
Po absolvování syntetických testů rozběhneme práci mikroslužby na malém počtu uživatelů. Začínáme opatrně, s minimálním podílem předpokládané cílové skupiny služby — méně než 0,1 %. V této fázi je velmi důležité, aby v monitoringu byly zavedeny správné technické a produktové metriky, aby co nejrychleji ukázaly problém ve službě. Minimální doba canary testu je 5 minut, základní — 2 hodiny. Pro složité služby nastavujeme čas ručně.
Analyzujeme:
— metriky specifické pro jazyk, konkrétně pracovníci php-fpm;
— chyby v Sentry;
— stavy odpovědí;
— čas odpovědí (response time), přesný a průměrný;
— latence;
— výjimky, zpracované a nezpracované;
— produktové metriky.
Squeeze Testing
Testování squeeze se také nazývá testováním "vytlačováním". Název této metodiky byl zaveden ve společnosti Netflix. Její podstatou je, že nejprve naplníme jeden instance skutečným provozem až do stavu selhání, čímž stanovíme jeho limit. Poté přidáme další instanci a zatížíme tuto dvojici — opět až na maximum; vidíme jejich strop a rozdíl s prvním „squeeze“. A tak pokračujeme v připojování jedné instance po kroku a počítáme vzory v těchto změnách.
Údaje z testů přes "vytlačování" také přicházejí do společné databáze metrik, kde buď obohacujeme výsledky umělého zatížení, nebo je zcela nahrazujeme "syntetikou".
Produkce
• Škálování. Při nasazení služby do produkce sledujeme, jak se škáluje. Podle naší zkušenosti není efektivní sledovat pouze ukazatele CPU. Auto scaling s benchmarkingem RPS v čisté podobě funguje, ale pouze pro některé služby, například online streaming. Proto se nejprve díváme na specifické produktové metriky aplikace.
Při škálování tedy analyzujeme:
— ukazatele CPU a RAM,
— počet požadavků v řadě,
— čas odpovědi,
— předpověď na základě nasbíraných historických dat.
Při škálování služby je také důležité sledovat její závislosti, abychom se vyhnuli tomu, že první službu v řetězci škálujeme a ty, na které se obrací, selhávají pod zátěží. Abychom stanovili přijatelné zatížení pro celý soubor služeb, díváme se na historická data "nejbližší" závislé služby (na základě kombinace ukazatelů CPU a RAM spolu s metrikami specifickými pro aplikaci) a porovnáváme je s historickými daty iniciující služby, a to takto pokračujeme po celé "řetězci závislostí", shora dolů.
Údržba
Jakmile je mikroslužba uvedena do provozu, můžeme na ni přidat spouštěče.
Tady jsou typické situace, kdy se spouštěče aktivují.
— Byly zjištěny potenciálně nebezpečné migrace.
— Byly vydány bezpečnostní aktualizace.
— Samotná služba nebyla dlouho aktualizována.
— Výrazně kleslo zatížení služby nebo některé její produktové metriky překračují normu.
— Služba přestala splňovat nové požadavky platformy.
Část triggerů zajišťuje stabilitu provozu, část slouží jako funkce údržby systému — například, nějaká služba nebyla dlouho nasazena a její základní obraz přestal splňovat bezpečnostní kontrolu.
Dashboard
Pokud to řekneme velmi stručně, dashboard je řídicí panel našeho PaaS.
- Jednotné místo informací o službě, s údaji o jejím pokrytí testy, počtem jejích obrazů, počtem produkčních kopií, verzích atd.
- Nástroj pro filtrování dat podle služeb a značek (markerů příslušnosti k obchodním jednotkám, produktové funkčnosti atd.)
- Nástroj pro integraci s infrastrukturními nástroji pro sledování, logování a monitoring.
- Jednotné místo dokumentace pro služby.
- Jednotné místo pro přehled všech událostí souvisejících se službami.
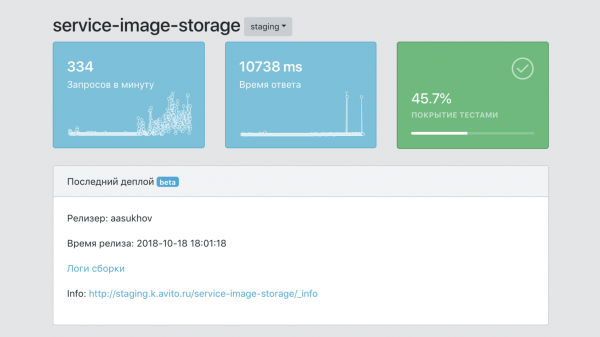
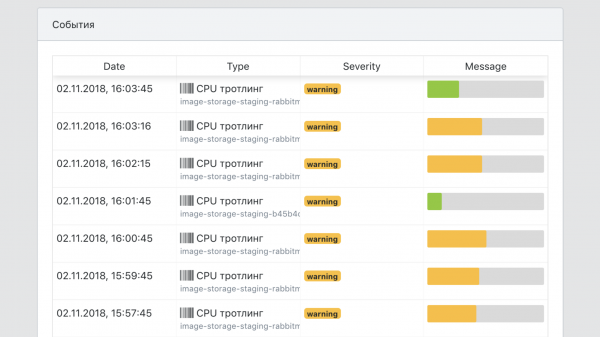
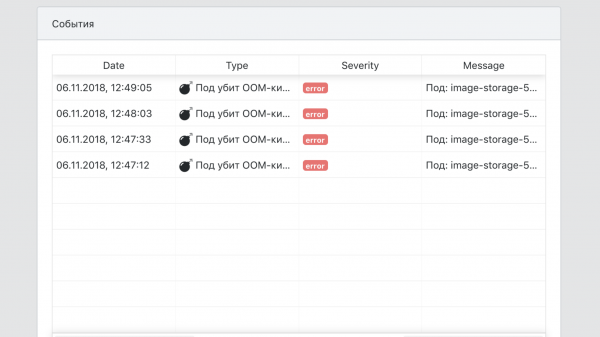
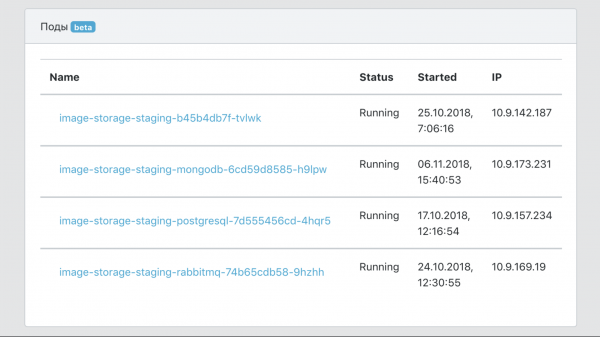
Celkem
Před zavedením PaaS mohl nový vývojář strávit několik týdnů tím, že si osvětloval všechny nástroje potřebné k nasazení mikroslužby do produkce: Kubernetes, Helm — naše interní specifika TeamCity, nastavení připojení k databázím a cache v odolném režimu atd. Nyní na to stačí pár hodin — přečíst si quickstart a vytvořit samotnou službu.
Toto téma jsem prezentoval na HighLoad++ 2018, můžete se podívat. a .
Bonusový track pro ty, kteří dočetli až do konce.
Ve společnosti Avito organizujeme interní třídenní školení pro vývojáře od , experta na mikroslužebnou architekturu. Chceme nabídnout možnost účasti na něm někomu z čtenářů tohoto příspěvku. Program školení byl zveřejněn.
Školení proběhne od 5. do 7. srpna v Moskvě. To jsou pracovní dny, které budou zcela obsazené. Oběd a školení budou v naší kanceláři, zatímco cestu a ubytování si zvolený účastník hradí sám.
Žádost o účast je možné podat . Požadujeme od vás odpověď na otázku, proč právě vy byste měli na školení jít, a informace o tom, jak s vámi kontaktovat. Odpovídejte v angličtině, protože účastníka, který se na školení dostane, vybírá Kris sám.
Jméno účastníka školení oznámíme aktualizací tohoto příspěvku a na sociálních sítích Avito pro vývojáře (AvitoTech na , , ) nejpozději 19. července.
Zdroj: habr.com
