

Úvod
Informační systém je z pohledu uživatele dobře definován ve znění ČSN 51987 – „automatizovaný systém, jehož výstupem je prezentace výstupních informací pro následné použití“. Pokud se díváme na vnitřní strukturu, každá informační systém ve své podstatě představuje systém vzájemně propojených algoritmů, realizovaných v kódu. V širším pojetí Turingovy-Churchovy teze algoritmus (a tudíž i IS) provádí transformaci množství vstupních dat na množství výstupních dat.
Lze dokonce říci, že v transformaci vstupních dat spočívá smysl existence informačního systému. Odpovídajícím způsobem hodnota IS a celého komplexu IS se určuje prostřednictvím hodnoty vstupních a výstupních dat.
Na základě toho by návrh měl začínat a brát v úvahu data, přizpůsobující architekturu a metody struktuře a významu dat.
Uložená data
Klíčovým krokem při přípravě na návrh je získání charakteristik všech sad dat, které se plánují zpracovávat a uchovávat. Tyto charakteristiky zahrnují:
— Objem dat;
— Informace o životním cyklu dat (nárůst nových dat, délka života, zpracování zastaralých dat);
— Klasifikace dat z pohledu vlivu na hlavní byznys společnosti (tři aspekty důvěrnosti, integrity, dostupnosti) spolu s finančními ukazateli (např. náklady na ztrátu dat za poslední hodinu);
— Geografie zpracování dat (fyzické umístění systémů zpracování);
— Požadavky regulátorů na každou třídu dat (např. zákon č. 152, PCI DSS).
Informační systémy
Data jsou nejen uchovávána, ale také zpracovávána (transformována) informačními systémy. Dalším krokem po získání charakteristik dat je co možná nejúplnější inventarizace informačního systému, jeho architektonických zvláštností, vzájemných závislostí a požadavků na infrastrukturu v podmínkových jednotkách pro čtyři druhy zdrojů:
— Procesorový výpočetní výkon;
— Objem operační paměti;
— Požadavky na objem a výkon systému pro ukládání dat;
— Požadavky na síť pro přenos dat (externí kanály, kanály mezi komponenty IS).
Požadavky musí být uvedeny pro každou službu/mikroslužbu v rámci IS.
Je třeba zmínit, že pro správné navrhování je nezbytné mít údaje o vlivu IS na hlavní podnikání společnosti ve formě nákladů na výpadek IS (korun za hodinu).
Model hrozeb
Jako povinnost musí existovat formální model hrozeb, proti kterým se plánuje ochrana dat/služeb. Model hrozeb zahrnuje nejen aspekty důvěrnosti, ale také integrity a dostupnosti. Tedy například:
— Výpadek fyzického serveru;
— Výpadek switchi top-of-the-rack;
— Přerušení optického spojení mezi datovými centry;
— Výpadek operačního úložiště celkově.
V některých případech jsou modely hrozeb vytvářeny nejen pro infrastrukturní komponenty, ale i pro konkrétní IS nebo jejich komponenty, například selhání DBMS s logickým narušením struktury dat.
Všechna rozhodnutí v rámci projektu o ochraně proti nepopisované hrozbě jsou nadbytečná.
Požadavky regulátorů
Pokud se zpracovávaná data řídí zvláštními pravidly stanovenými regulátory, je nezbytně nutné mít informace o souborech dat a pravidlech zpracování/uchovávání.
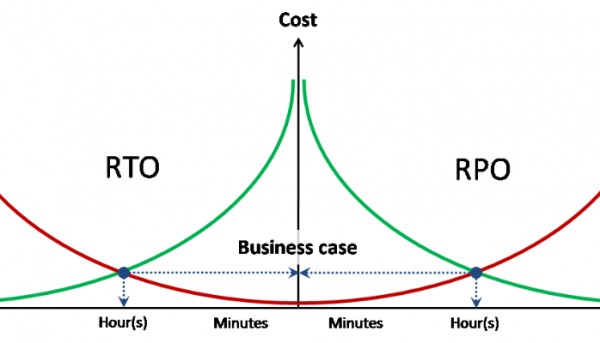
Cílové ukazatele RPO/RTO
Navrhování jakéhokoli typu ochrany vyžaduje existenci ukazatelů cílové ztráty dat a cílového času na obnovení služby pro každou z popsaných hrozeb.
Ideálně by RPO a RTO měly mít asociované náklady na ztrátu dat a výpadek v jednotce času.
Rozdělení na pooly zdrojů
Po shromáždění všech počátečních informací je prvním krokem seskupení souborů dat a IS do poolů na základě modelů hrozeb a požadavků regulátorů. Je určena forma rozdělení různých poolů – programově na úrovni systémového softwaru nebo fyzicky.
Příklady:
— Okruh zpracovávající osobní údaje je fyzicky oddělen od ostatních systémů;
— Záložní kopie jsou uchovávány na samostatném úložišti.
Přitom pooly mohou mít částečnou nezávislost, například se určují dva pooly výpočetních zdrojů (výpočetní výkon + operační paměť), které využívají jednotný pool úložiště dat a jednotný pool přenosových zdrojů.
Výpočetní výkon
Abstraktní potřeby na procesorový výkon virtualizovaného datového centra se měří počtem virtuálních procesorů (vCPU) a koeficientem jejich konsolidace na fyzických procesorech (pCPU). V tomto konkrétním případě 1 pCPU = 1 fyzické jádro procesoru (bez zohlednění Hyper-Threading). Počet vCPU se sčítá ve všech definovaných zdrojových clusterech (z nichž každý může mít svůj koeficient konsolidace).
Koeficient konsolidace pro zatížené systémy se získává empiricky, vycházejíc z již existující infrastruktury, nebo při pilotní instalaci a zátěžovém testování. Pro nezatížené systémy se používají „best practice“. Konkrétně VMware uvádí průměrný koeficient 8:1.
Operační paměť
Celková potřeba operační paměti se získá prostým sčítáním. Použití oversubscription u operační paměti se nedoporučuje.
Úložné zdroje
Požadavky na úložné zdroje se získávají prostým sčítáním všech zdrojových clusterech podle objemu a výkonu.
Požadavky na výkon se vyjadřují v IOPS v kombinaci s průměrným poměrem čtení/zápis a při potřebě maximální latencí odezvy.
Samostatně by měly být uvedeny požadavky na zajištění kvality služby (QoS) pro konkrétní zdroje nebo systémy.
Zdroje sítě pro přenos dat
Požadavky na síť pro přenos dat se získávají prostým sčítáním všech zdrojových clusterech šířky pásma.
Samostatně by měly být uvedeny požadavky na zajištění kvality služby (QoS) a latence (RTT) pro konkrétní zdroje nebo systémy.
V rámci požadavků na zdroje sítě pro přenos dat se také uvádějí požadavky na izolaci a/nebo šifrování síťového provozu a preferované mechanismy (802.1q, IPSec atd.)
Výběr architektury
V rámci této příručky se nezvažuje jiný výběr než architektura x86 a 100% virtualizace serverů. Proto se výběr architektury výpočetního subsystému omezuje na výběr platformy serverové virtualizace, formátu serverů a obecných požadavků na konfiguraci serverů.
Klíčovým bodem volby je vyjasnění použití klasického přístupu s rozdělením funkcí zpracování, ukládání a přenosu dat nebo konvergovaného.
Klasická architektura představuje využití inteligentních externích systémů ukládání a přenosu dat, zatímco servery přinášejí do společného fondu fyzických zdrojů pouze procesorový výkon a operační paměť. V krajním případě se servery stávají zcela anonymními, nemají vlastní disky ani systémový identifikátor. V tomto případě se používá spuštění operačního systému nebo hypervizora z interního flash úložiště nebo externího systému ukládání dat (boot from SAN).
V rámci klasické architektury se výběr mezi blade a rackovými servery provádí především podle následujících principů:
— Ekonomická efektivita (průměrně jsou rackové servery levnější);
— Výpočetní hustota (u blade je vyšší);
— Energetická spotřeba a tepelný výkon (u blade je vyšší specifická na jednotku);
— Škálovatelnost a spravovatelnost (blade obecně vyžaduje méně úsilí při větších instalacích);
— Použití rozšiřujících karet (pro blade je velmi omezený výběr).
Konvergentní architektura (také známá jako hyperkonvergentní) předpokládá kombinaci funkcí zpracování a ukládání dat, což vede k využití místních disků serverů a následně k opuštění formátu klasických blade. Pro konvergentní systémy se používají buď rackové servery, nebo clusterové systémy spojující v jednom pouzdru několik blade serverů a místní disky.
CPU / Paměť
Pro správný výpočet konfigurace je třeba pochopit typ zátěže pro prostředí nebo každý z nezávislých clusterů.
CPU bound – prostředí omezené výkonností procesorového výkonu. Přidání operační paměti nic nezmění z hlediska výkonu (počet VM na serveru).
Memory bound – prostředí omezené operační pamětí. Větší množství operační paměti na serveru umožňuje spustit více VM na serveru.
GB / MHz (GB / pCPU) – průměrný poměr spotřeby této konkrétní zátěží operační paměti a procesorového výkonu. Může být použito pro výpočty potřebného objemu paměti při dané výkonnosti a naopak.
Výpočet konfigurace serveru
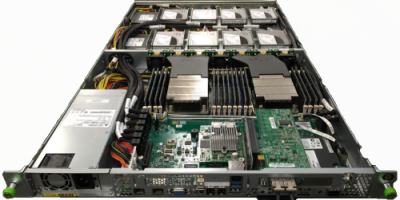
Nejprve je třeba určit všechny typy zátěže a rozhodnout, zda sloučit nebo oddělit různé výpočetní pooly podle různých clusterů.
Dále se pro každý z definovaných clusterů určuje poměr GB / MHz při známé předem zátěži. Pokud není zátěž známa předem, ale máme přibližnou představu o úrovni zatížení procesorového výkonu, můžeme použít standardní koeficienty vCPU:pCPU pro převod požadavků poolů na fyzické.
Pro každý cluster dělíme součet požadavků poolů vCPU koeficientem:
vCPU_součet / vCPU:pCPU = pCPU_součet – požadovaný počet fyzických jader
pCPU_součet / 1.25 = pCPU_ht – počet jader s opravou na Hyper-Threading
Předpokládejme, že je třeba provést výpočet clustera na 190 jader / 3.5TB RAM. Přitom bereme cílovou 50% zátěž procesorového výkonu a 75% využití operační paměti.
pCPU
190
CPU využití
50%
RAM
3500
Utilizace RAM
75%
Socle
Core
Srv / CPU
Srv RAM
Srv / RAM
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
V tomto případě vždy používáme zaokroulení na nejbližší celé číslo nahoru (=ROUNDUP(A1;0)).
Z tabulky je jasné, že jako vyvážené podle cílových ukazatelů existuje několik konfigurací serverů:
— 26 serverů 2*6c / 192 GB
— 19 serverů 2*10c / 256 GB
— 10 serverů 2*18c / 512 GB
Volba z těchto konfigurací by se měla dále řídit podle dalších faktorů, jako jsou například tepelný výkon a dostupné chlazení, již používané servery nebo cena.
Charakteristiky výběru konfigurace serveru
Široké VM. Při potřebě umístění širokých VM (srovnatelných s 1 uzlem NUMA a více) se doporučuje vybírat server s konfigurací, která umožní, aby takové VM zůstaly v rámci NUMA uzlu. Při velkém počtu širokých VM vzniká nebezpečí fragmentace prostředků clusteru, a v tomto případě se vybírají servery, které umožňují umístit široké VM maximálně blízko sebe.
Velikost domény jediného selhání.
Volba velikosti serveru se také provádí na základě principu minimalizace domény jediného selhání. Například při rozhodování mezi:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Při jinak stejných podmínkách je třeba zvolit druhou možnost, protože při selhání jednoho serveru (nebo jeho údržbě) přichází o 33% prostředků clusteru, ale pouze o 17%. Také se přesně takto snižuje počet VM a IS, na které mělo nehoda dopad.
Výpočet klasického úložiště podle výkonu
Klasické úložiště se vždy počítá podle nejhoršího scénáře, s výjimkou vlivu operační cache a optimalizace operací.
Jako základní ukazatele výkonu považujeme mechanický výkon z disku (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Dále se počet disků v diskovém poli vypočítává podle následujícího vzorce: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Kde:
— TotalIOPS – celkový požadovaný výkon v IOPS z diskového pole
— RW – procentuální podíl operací čtení
— RAIDpen – RAID penalizace pro vybranou úroveň RAID
Více o zařízení RAID a RAID penalizaci se dozvíte zde — a a
Na základě získaného počtu disků se počítají možné varianty, které vyhovují požadavkům na kapacitu úložiště, včetně variant s vícestupňovým úložením.
Výpočet systémů s použitím SSD jako úrovně ukládání se posuzuje odděleně.
Zvláštnosti výpočtu systémů s Flash Cache
Flash Cache – obecný název pro všechny proprietární technologie využití flash paměti jako cache druhé úrovně. Při použití flash cache se obvykle počítá výkon úložiště pro zajištění ustálené zátěže z magnetických disků, zatímco vrcholové zátěže zpracovává cache.
Přitom je nutné chápat profil zátěže a míru lokalizace požadavků na bloky úložných svazků. Flash cache je technologie pro zátěže s vysokou lokalizací požadavků a je prakticky neaplikovatelná pro rovnoměrně zatížené svazky (například pro analytické systémy).
Výpočet hybridních systémů low-end / mid-range
Hybridní systémy nižších a středních tříd využívají vícestupňové ukládání s přemísťováním dat mezi úrovněmi podle plánu. Velikost bloku vícestupňového ukládání u nejlepších modelů dosahuje 256 MB. Tyto vlastnosti neumožňují považovat technologii vícestupňového ukládání za technologii zvyšování výkonu, jak si mnozí mylně myslí. Vícestupňové ukládání v systémech nižší a střední třídy je technologií optimalizace nákladů na ukládání pro systémy s výraznou nerovnoměrností zatížení.
Pro vícestupňové ukládání se především počítá výkon na vrcholu úrovně, zatímco dolní úroveň úložiště se považuje pouze za přidávající chybějící kapacitu. Pro hybridní vícestupňový systém je nezbytné použití technologie flash cache pro vícestupňový pool za účelem kompenzace poklesu výkonu pro náhle zahřátá data z dolní úrovně.
Použití SSD v vícestupňovém diskovém poli
Použití SSD v vícestupňovém diskovém poli má variace, v závislosti na specifikách implementace algoritmů flash cache daného výrobce.
Obecná praxe politiky ukládání pro diskové pole s úrovní SSD — SSD first.
Read Only Flash Cache. Pro úložiště flash cache pouze pro čtení se úroveň ukládání na SSD objevuje při významné lokalizaci operací zápisu mimo cache.
Čtení / Zápis Flash Cache. V případě flash cache pro zápis se nejprve nastaví maximální objem cache, a úroveň ukládání na SSD se objevuje pouze při nedostatku velikosti cache pro zpracování celého lokalizovaného zatížení.
Výpočet výkonu SSD a cache se provádí pokaždé na základě doporučení výrobce, ale vždy pro nejhorší variantu.
Zdroj: habr.com
