

Jak můžeme zdesetinásobit počet dotazů na databázi, aniž bychom přešli na výkonnější server, a přitom udržet systém funkční? Ukážu vám, jak jsme bojovali s poklesem výkonu naší databáze, jak jsme optimalizovali SQL dotazy, abychom obsloužili co nejvíce uživatelů, aniž bychom zvyšovali náklady na výpočetní zdroje.
Vytvářím službu pro řízení obchodních procesů ve stavebních společnostech. Spolupracuje s námi přibližně 3 tisíce firem. Více než 10 tisíc lidí každý den pracuje s naším systémem 4-10 hodin. Řeší různé úkoly plánování, varování, upozornění, validace… Používáme PostgreSQL 9.6. V databázi máme přibližně 300 tabulek a denně do ní přijde až 200 milionů dotazů (10 tisíc různých). V průměru máme 3-4 tisíce dotazů za sekundu, v nejrušnějších chvílích více než 10 tisíc dotazů za sekundu. Většina dotazů je OLAP. Přidání, změny a mazání jsou výrazně méně časté, tedy OLTP zátěž je relativně malá. Tato čísla uvádím, aby jste mohli posoudit rozsah našeho projektu a pochopit, jak může být naše zkušenost pro vás užitečná.
Obrázek první. Lyrický
Když jsme začali vyvíjet, moc jsme nepřemýšleli o tom, jaká zátěž dopadne na databázi a co uděláme, pokud server přestane fungovat. Při navrhování databáze jsme se řídili obecnými doporučeními a snažili jsme se střílet si do nohy, ale dál než k obecným radám jako "nepoužívejte vzor jsme se nedostali. Navrhovali jsme podle principů normalizace, abychom se vyvarovali nadbytečnosti dat, a nezabývali jsme se urychlováním různých dotazů. Jakmile přišli první uživatelé, čelili jsme problémům s výkonem. Jak to obvykle bývá, nebyli jsme na to vůbec připraveni. První problémy byly jednoduché. Většinou se to řešilo přidáním nového indexu. Ale nastal okamžik, kdy jednoduché opravy přestaly fungovat. Uvědomili jsme si, že nám chybí zkušenosti a že je pro nás čím dál tím obtížnější pochopit, co způsobuje problémy, najali jsme specialisty, kteří nám pomohli správně nastavit server, připojit monitorování a ukázali, kam se dívat, abychom získali .
Obrázek druhý. Statistický
Máme tedy asi 10 000 různých dotazů, které se denně provádějí na naší databázi. Z těchto 10 000 jsou tu monstra, která se provádějí 2-3 milionykrát s průměrnou dobou provádění 0,1-0,3 ms, a pak jsou tu dotazy s průměrnou dobou provádění 30 sekund, které se vyvolávají 100krát denně.
Optimalizovat všech 10 000 dotazů nebylo možné, a tak jsme se rozhodli zjistit, jakým směrem směrovat úsilí, abychom správně zlepšili výkon databáze. Po několika iteracích jsme začali dotazy rozdělovat do typů.
TOP dotazy
To jsou nejzatěžující dotazy, které zabírají nejvíce času (celkový čas). Jsou to dotazy, které se buď velmi často vyvolávají, nebo dotazy, které se provádějí velmi dlouho (dlouhé a časté dotazy byly optimalizovány již v prvních iteracích boje za rychlost). Celkově server stráví na jejich vykonání nejvíce času. Je také důležité oddělit top dotazy podle celkového času provádění a samostatně podle IO času. Způsoby optimalizace těchto dotazů se poněkud liší.
Běžnou praxí všech společností je pracovat s TOP dotazy. Je jich málo, optimalizace i jediného dotazu může uvolnit 5-10 % zdrojů. Jak však projekt „dospívá“, optimalizace TOP dotazů se stává stále obtížnějším úkolem. Všechny jednoduché metody už byly vyzkoušeny a nejvíce „zatěžující“ dotaz zabírá „pouze“ 3-5 % zdrojů. Pokud TOP dotazy celkem zabírají méně než 30-40 % času, pravděpodobně jste již vynaložili úsilí, abychom pracovaly rychle a nastal čas přejít k optimalizaci dotazů z další skupiny.
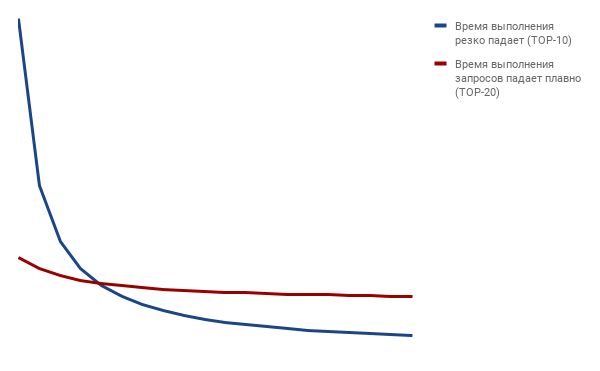
Zůstává odpovědět na otázku, kolik vrcholných dotazů zařadit do této skupiny. Obvykle beru nejméně 10, ale ne více než 20. Snažím se, aby se doba prvního a posledního v TOP skupině lišila maximálně 10krát. Tedy pokud doba provádění dotazů náhle klesne z 1. místa na 10., vezmu TOP-10, pokud klesání je plynulejší, zvětšuji velikost skupiny na 15 nebo 20.
Střední dotazy (medium)
To jsou všechny dotazy, které přicházejí hned za TOP, s výjimkou posledních 5-10 %. Obvykle se právě v optimalizaci těchto dotazů skrývá možnost výrazně zvýšit výkon serveru. Tyto dotazy mohou tvořit až 80 %. Ale i když jejich podíl překročil 50 %, znamená to, že je na ně třeba se podívat podrobněji.
Ocas (tail)
Jak bylo řečeno, tyto dotazy přicházejí na konci a zaberou 5-10% času. Na ně lze zapomenout, pokud nepoužíváte automatické nástroje pro analýzu dotazů, pak jejich optimalizace může být také levná.
Jak ohodnotit každou skupinu?
Používám SQL dotaz, který pomáhá provést takové hodnocení pro PostgreSQL (jsem si jistý, že pro mnoho dalších DBMS lze napsat podobný dotaz).
SQL dotaz pro hodnocení velikosti skupin TOP-MEDIUM-TAIL
SELECT sum(time_top) AS sum_top, sum(time_medium) AS sum_medium, sum(time_tail) FROM ( SELECT CASE WHEN rn 20 AND rn 800 THEN tt_percent ELSE 0 END AS time_tail FROM ( SELECT total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query, ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn FROM pg_stat_statements ORDER BY total_time DESC ) AS t ) AS ts
Výsledkem dotazu jsou tři sloupce, z nichž každý obsahuje procento času, který je věnován zpracování dotazů z této skupiny. Uvnitř dotazu jsou dvě čísla (v mém případě 20 a 800), která oddělují dotazy jedné skupiny od druhé.
Takto se přibližně vztahují podíly dotazů na začátku optimalizace a nyní.
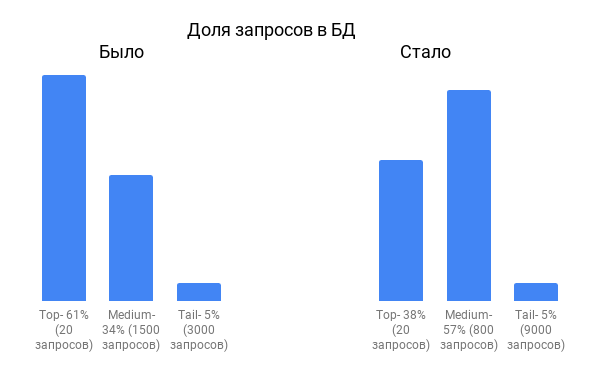
Z diagramu je vidět, že podíl TOP dotazů výrazně klesl, zato podíl „středních“ dotazů vzrostl.
Zpočátku do TOP dotazů spadaly očividné chyby. Sčasem zmizely dětské nemoci, podíl TOP dotazů se zmenšoval a bylo potřeba vynaložit více úsilí, aby se těžké dotazy zrychlily.
Abychom získali text dotazů, použijeme takový dotaz
SELECT * FROM ( SELECT ROW_NUMBER () OVER (ORDER BY total_time DESC) AS rn, total_time / (SELECT sum(total_time) FROM pg_stat_statements) * 100 AS tt_percent, query FROM pg_stat_statements ORDER BY total_time DESC ) AS T WHERE rn 20 AND rn 800 -- TAIL
Zde je seznam nejčastěji používaných technik, které nám pomáhaly zrychlovat TOP dotazy:
- Redesign systému, například přepracování logiky oznámení na message broker místo periodických dotazů do DB.
- Přidání nebo změna indexů.
- Přepsání ORM dotazů na čistý SQL.
- Přepsání logiky lazy načítání dat.
- Kešování prostřednictvím denormalizace dat. Například máme vazbu tabulek Doprava -> Faktura -> Dotaz -> Žádost. To znamená, že každá doprava je spojena se žádostí prostřednictvím dalších tabulek. Abychom v každém dotazu nespojovali všechny tabulky, jsme duplikovali odkaz na žádost v tabulce Doprava.
- Caching static tables with directories and rarely changing tables in the program's memory.
Sometimes changes led to a significant redesign, but they provided a 5-10% system load reduction and were justified. Over time, the output became smaller, and more serious redesigns were required.
Then we turned our attention to the second group of queries - the mid-ranking group. It had many more queries, and it seemed that analyzing the entire group would take a lot of time. However, most queries turned out to be very simple to optimize, and many problems repeated dozens of times in various variations. Here are examples of some typical optimizations we applied to dozens of similar queries, with each group of optimized queries reducing the database load by 3-5%.
- Instead of checking for record existence with COUNT and full table scans, we started using EXISTS.
- We got rid of DISTINCT (there's no universal recipe, but sometimes it can be easily eliminated, speeding up the query by 10-100 times).
For example, instead of a query to select all drivers from a large delivery table (DELIVERY),
SELECT DISTINCT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM DELIVERY D JOIN PERSON P ON D.DRIVER_ID = P.ID
we changed the query to one against a relatively small PERSON table.
SELECT P.ID, P.FIRST_NAME, P.LAST_NAME
FROM PERSON
WHERE EXISTS(SELECT D.ID FROM DELIVERY WHERE D.DRIVER_ID = P.ID)
It seemed we used a correlated subquery, but it speeds up by more than 10 times.
- In many cases, we completely abandoned COUNT and
- místo
UPPER(s) LIKE 'JOHN%'VPS KVM
s ILIKE 'John%'
Each specific query could be sped up by 3-1000 times. Despite the impressive results, at first we felt there was no point in optimizing a query that runs in 10 ms, is in the third hundred of the heaviest queries, and generally takes a fraction of a percent of the overall database load time. But by applying the same recipe to a group of similar queries, we reclaimed a few percent. To avoid spending time manually reviewing all hundreds of queries, we wrote a few simple scripts that used regular expressions to find similar queries. As a result, the automated search for groups of queries allowed us to further improve our performance with modest efforts.
Už tři roky pracujeme na stejném vybavení. Průměrná denní zátěž je kolem 30 %, v špičkách dosahuje až 70 %. Počet dotazů i uživatelů vzrostl přibližně desetinásobně. A to vše díky stálému monitorování příslušných skupin dotazů TOP-MEDIUM. Jakmile se nějaký nový dotaz objeví ve skupině TOP, okamžitě ho analyzujeme a snažíme se jej zrychlit. Skupinu MEDIUM kontrolujeme jednou týdně pomocí skriptů pro analýzu dotazů. Pokud se objeví nové dotazy, které již umíme optimalizovat, rychle je měníme. Někdy nacházíme nové způsoby optimalizace, které lze aplikovat ihned na několik dotazů.
Podle našich předpovědí současný server zvládne zvýšení počtu uživatelů ještě 3-5krát. Mimochodem máme ještě jeden trumf v rukávu - dosud jsme nepřevedli SELECT dotazy na zrcadlo, jak se doporučuje. Ale to děláme vědomě, protože nejdříve chceme plně využít možnosti „inteligentní“ optimalizace, než zapneme „těžkou artilerii“.
Kritický pohled na odvedenou práci může naznačit, že je možné použít vertikální škálování. Koupit výkonnější server, místo abychom ztráceli čas specialistů. Server nemusí být tak drahý, zvlášť když limity vertikálního škálování ještě nebyly vyčerpány. Nicméně, počet dotazů vzrostl pouze desetinásobně. Během několika let se zvýšila funkčnost systému a nyní je více druhů dotazů. Funkčnost, která byla, díky kešování, se nyní provádí menším počtem dotazů, navíc efektivnějších. To znamená, že můžeme směle vynásobit ještě 5, abychom získali skutečný koeficient zrychlení. Takže podle nejskromnějších výpočtů můžeme říci, že zrychlení činilo 50 a vícekrát. Vertikálně zvýšit kapacitu serveru 50krát by bylo dražší. Obzvlášť když jednou provedená optimalizace funguje stále, zatímco účet za pronajatý server chodí každý měsíc.
Zdroj: habr.com
