

Pozn. přek.: Představujeme vám technické podrobnosti o důvodech nedávného výpadku v provozu cloudové služby, kterou spravují tvůrci Grafany. To je klasický příklad toho, jak nová a zdánlivě užitečná funkce, určená ke zlepšení kvality infrastruktury… může uškodit, pokud se neberou v potaz četné nuance jejího použití v produkčních prostředích. Je skvělé, když se objevují takové materiály, které umožňují učit se nejen na vlastních chybách. Podrobnosti najdete v překladu tohoto textu od viceprezidenta pro produkt z Grafana Labs.
V pátek 19. července přestala služba Hosted Prometheus v Grafana Cloud fungovat přibližně na 30 minut. Omlouvám se všem klientům, kteří byli tímto výpadkem zasaženi. Naším úkolem je poskytovat potřebné nástroje pro monitoring a chápeme, že jejich nedostupnost vám ztěžuje život. Tento incident bereme velmi vážně. V této poznámce vysvětluji, co se stalo, jak jsme na to reagovali a co děláme, abychom podobné situace odstranili.
Pozadí
Služba Grafana Cloud Hosted Prometheus je založena na — projektu CNCF pro vytvoření horizontálně škálovatelné, vysoce dostupné, multitenantní služby Prometheus. Architektura Cortex se skládá z řady samostatných mikroslužeb, z nichž každá plní svou funkci: replikaci, ukládání, dotazy atd. Cortex se aktivně vyvíjí, stále se objevují nové možnosti a zvyšuje se výkonnost. Pravidelně nasazujeme nové verze Cortex do clusterů, aby klienti mohli využít těchto možností – Cortex má schopnost aktualizovat se bez výpadků.
Pro bezvýpadkové aktualizace služba Ingester Cortexu vyžaduje dodatečnou replikaci Ingesteru během procesu aktualizace. (Pozn. přek.: — základní komponenta Cortexu. Jeho úkolem je shromažďovat neustálý tok vzorků, seskupovat je do chunků Prometheus a ukládat do databáze jako DynamoDB, BigTable nebo Cassandra. To umožňuje starým Ingesterům přenášet aktuální data novým Ingesterům. Je třeba poznamenat, že Ingesteři jsou nároční na zdroje. Pro jejich fungování je zapotřebí 4 jádra a 15 GB paměti na pod, tj. 25 % procesorového výkonu a paměti základního stroje v případě našich Kubernetes clusterů. Obecně máme obvykle mnohem více nevyužitých zdrojů v clusteru než 4 jádra a 15 GB paměti, proto můžeme snadno spouštět tyto další Ingesteri během aktualizací.
Nicméně často se stává, že během normálního provozu není na žádném ze strojů těchto 25 % nevyužitých zdrojů. A ani se o to nesnažíme: CPU a paměť jsou vždy užitečné pro jiné procesy. Pro řešení tohoto problému jsme se rozhodli využít . Myšlenka spočívá v tom, že Ingesterům přiřadíme vyšší prioritu než dalším (stateless) mikroslužbám. Když potřebujeme spustit další (N+1) Ingester, dočasně vyhneme jiné, menší podny. Tyto podny jsou přesunuty do volných zdrojů na jiných strojích, což zanechává dostatečně velkou "díru" pro spuštění dalšího Ingesteru.
Ve čtvrtek 18. července jsme nasadili čtyři nové úrovně priorit v našich clusterech: kritická, vysokou, střední a nízká. Byly testovány na interním clusteru bez klientského provozu asi týden. Podle defaultu podny bez zadané priority dostávaly střední prioritu, pro Ingesteri byla nastavena třída s vysokou Pravidlo 4b: Pokud úloha uvolní CPU před vypršením svého časového okna, její Kritická byla vyhrazena pro monitorování (Prometheus, Alertmanager, node-exporter, kube-state-metrics atd.). Náš konfigurační soubor je otevřený a můžete se podívat na PR .
Havárie
V pátek 19. července jeden z inženýrů spustil nový dedikovaný cluster Cortex pro velkého klienta. Konfigurace tohoto clustera nezahrnovala nové priority podů, takže všem novým podům byla přiřazena priorita podle defaultu - střední.
V clusteru Kubernetes chyběly zdroje pro nový cluster Cortex, a existující produkční cluster Cortex nebyl aktualizován (Ingesteři zůstali bez vysoké priority). Protože Ingesteři nového clustera měli defaultně střední prioritu, zatímco existující produkční podny pracovaly úplně bez priority, Ingesteři nového clustera vytlačili Ingester z existujícího produkčního clustera Cortex.
ReplicaSet pro vytlačeného Ingester’a v produkčním clusterech objevil vytlačený pod a vytvořil nový pro udržení požadovaného počtu kopií. Novému pod’u byl podle defaultu přidělen střední priorita, a další "starý" Ingester v produkci přišel o zdroje. Výsledkem bylo lavinové proces, který vedl k vytlačení všech pod’ů s Ingester pro produkční clustery Cortexu.
Ingester’y ukládají stav (stateful) a uchovávají data za posledních 12 hodin. To nám umožňuje efektivněji je komprimovat před zápisem do dlouhodobého úložiště. K tomu Cortex provádí shardování dat podle sérií, používá distribuovanou hash tabulku (Distributed Hash Table, DHT) a replikujte každou sérii na tři Ingester’y pomocí kvórumové shody ve stylu Dynamo. Cortex nenapíše data do Ingester’ů, které jsou vypnuty. Tím pádem, když velké množství Ingester’ů opustí DHT, Cortex nemůže zajistit dostatečnou replikaci záznamů a ty "padnou".
Detekce a odstranění
Nová upozornění Prometheus na základě "rozpočtu chyb" (error-budget-based — podrobnosti se objeví v budoucím článku) začala alarmovat po 4 minutách od započetí výpadku. Během následujících přibližně pěti minut jsme provedli diagnostiku a navýšili podkladový cluster Kubernetes pro umístění jak nových, tak existujících produkčních clusterů.
Dalších pět minut staré Ingester’y úspěšně zapsaly svá data, a nové se spustily, takže clustery Cortex byly opět dostupné.
Dalších 10 minut bylo vyčleněno na diagnostiku a opravy chyb out-of-memory (OOM) od reverzních proxy serverů autentizace, umístěných před Cortexem. OOM chyby byly způsobeny desetinásobným nárůstem QPS (jak se domníváme, kvůli příliš agresivním požadavkům z klientských serverů Prometheus).
Důsledky
Celkový čas výpadku činil 26 minut. Data nebyla ztracena. Ingester’y úspěšně nahrály všechna in-memory data do dlouhodobého úložiště. Během výpadku servery Prometheus klientů ukládaly do vyrovnávací paměti vzdálené (remote) záznamy pomocí na základě WAL (podle z Grafana Labs) a opakovali neúspěšné záznamy po chybě.
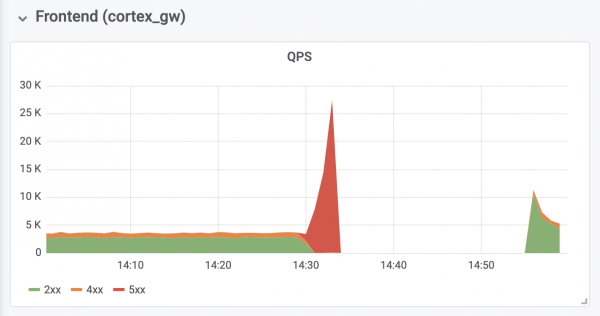
Operace zápisu produkčního clusteru
Závěry
Je důležité se z tohoto incidentu poučit a přijmout nezbytná opatření, aby se předešlo jeho opakování.
Když se ohlédneme zpět, musíme přiznat, že byste neměli nastavovat výchozí střední prioritu, dokud všechny ingestry v produkci nedostaly vysokou prioritu. Dále bylo potřeba se včas postarat o jejich vysokou prioritu. Nyní je vše opraveno. Doufáme, že naše zkušenost pomůže dalším organizacím, které uvažují o používání priorit podů v Kubernetes.
Přidáme další úroveň kontroly nad nasazením jakýchkoli dalších objektů, jejichž konfigurace jsou globální pro cluster. Do budoucna budou takové změny posuzovány větším počtem lidí. Dále byla modifikace, která vedla k selhání, považována za příliš nevýznamnou pro samostatnou projektovou dokumentaci — byla projednávána pouze v GitHub issue. Od tohoto okamžiku budou všechny podobné změny konfigurací doprovázeny odpovídající projektovou dokumentací.oNakonec automatizujeme změnu velikosti reverzního proxy serveru pro autentizaci, abychom předešli OOM při přetížení, čemuž jsme byli svědky, a analyzujeme výchozí parametry Promethea související s návratem a škálováním, abychom se do budoucna vyhnuli podobným problémům.
Zaznamenané selhání mělo také některé pozitivní důsledky: po získání potřebných zdrojů se Cortex automaticky zotavil bez dalšího zásahu. Získali jsme také cenné zkušenosti s
— naším novým systémem agregace logů, — který pomohl zajistit, že všechny ingestry správně fungovaly během a po selhání. Příběhy úspěchů Kubernetes v produkci. Část 10: Reddit
P.S. od překladatele
Přečtěte si také náš blog:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
