

Pozn. přek.: Autorkou tohoto materiálu je Cindy Sridharan, inženýrka z společnosti imgix, zabývající se vývojem API a zvláště testováním mikroslužeb. V tomto materiálu se dělí o své podrobné názory na aktuální problémy v oblasti distribuovaného sledování, kde podle jejího názoru chybí skutečně efektivní nástroje k řešení naléhavých úkolů.
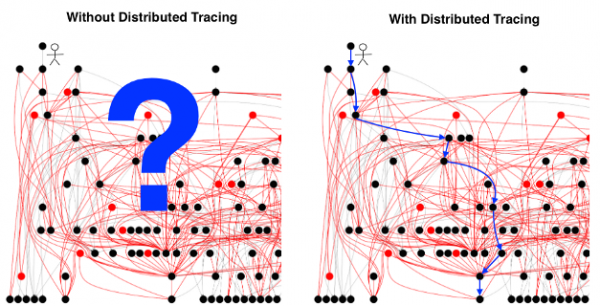
[Ilustrace převzata z o distribuovaném sledování.]
Předpokládá se, že je obtížné zavést, a také, že jeho přínos . "Problémovost" sledování vysvětluje řada důvodů, přičemž se často odvolává na pracnost nastavení každé součásti systému pro přenos odpovídajících hlaviček s každým požadavkem. Ačkoli tento problém skutečně existuje, nelze ho považovat za nepřekonatelný. Mimochodem, to vůbec nevysvětluje, proč vývojáři sledování (dokonce i již fungujícího) příliš nemilují.
Hlavní obtíž s distribuovaným sledováním nespočívá ve sběru dat, normalizaci formátů distribuce a prezentace výsledků, ani v určení, kdy, kde a jak provést vzorkování. Nemyslím si, že představuji banální tyto "problémy s osvojením" — ve skutečnosti existují poměrně významné technické a (pokud zvažujeme skutečně Open Source ) politické výzvy, které je třeba překonat, aby se tyto problémy mohly považovat za vyřešené.
Nicméně, pokud bychom si představili, že všechny tyto problémy jsou vyřešeny, je velmi pravděpodobné, že se nic zásadně nezmění z hlediska zkušenosti koncového uživatele. Sledování stále nemusí přinášet praktický užitek v nejběžnějších scénářích ladění — i poté, co bylo nasazeno.
Takové odlišné sledování
Distribuované sledování zahrnuje několik roztržených komponentů:
- osazení aplikací a middleware nástroji pro sledování;
- přenášení distribuovaného kontextu;
- sběr sledování;
- uchovávání sledování;
- jejich vyhledávání a vizualizace.
Mnoho diskusí o distribuovaném trasování se shrnuje do toho, že je to jakási unární operace, jejímž jediným cílem je pomoci v komplexní diagnostice systému. Do značné míry to souvisí s tím, jak se historicky formovala představa o distribuovaném trasování. V , který byl napsán, když se otevřely zdrojové kódy Zipkin, se zmiňovalo, že on [Zipkin] zrychluje Twitter. První komerční nabídky pro trasování byly také propagovány jako .
Pozn. přek.: Aby byl další text čitelnější, definujme dva základní termíny podle :
- Span — základní prvek distribuovaného trasování. Představuje popis jakéhosi pracovního procesu (například dotazu do databáze) s názvem, časem začátku a konce, tagy, logy a kontextem.
- Span'y obvykle obsahují odkazy na jiné span'y, což umožňuje spojit více span'ů do Trace — vizualizace životního cyklu požadavku při jeho pohybu v distribuovaném systému.
Trace'y obsahují neuvěřitelně cenná data, která mohou pomoci při takových úlohách, jako jsou: testování v produkci, provádění testů obnovy po havárii, testování s nasazováním chyb atd. Ve skutečnosti některé společnosti již nasazují trasování pro podobné účely. Začněme tím, že má i jiné aplikace než jen jednoduchý přenos span'ů do úložiště:
- Například Uber výsledky trasování pro rozdělení testového a produkčního provozu.
- Facebook data trace'ů pro analýzu kritické cesty a pro přepínání provozu během pravidelných testů obnovy po havárii.
- Také sociální síť notebooky Jupyter, které umožňují vývojářům provádět libovolné dotazy na výsledky trasování.
- Zastánci (Lineage Driven Failure Injection) distribuované trace'y pro testování s nasazováním chyb.
Žádná z výše uvedených možností se zcela nevztahuje k scénáři ladění, kdy se inženýr pokouší vyřešit problém, přičemž se dívá na trace.
Když už to dojde k scénáři ladění, primárním rozhraním zůstává diagram traceview (i když někteří jej také nazývají «Ganttovým diagramem» nebo «kaskádovým diagramem»). Pod traceview já všechny span a související metadata, která společně tvoří trace. Každý systém trasování s otevřeným zdrojovým kódem, stejně jako každé komerční řešení pro trasování, nabízí založené na traceview uživatelském rozhraní pro vizualizaci, detailizaci a filtrování trace.
Problém se všemi systémy trasování, se kterými jsem dosud měl zkušenosti, spočívá v tom, že konečný vizualizace (traceview) prakticky zcela odráží zvláštnosti procesu generování trace. I když jsou nabízeny alternativní vizualizace: mapy intenzity (heatmap), topologie služeb, histogramy zpoždění (latency), v konečném důsledku se opět redukují na traceview.
V minulosti jsem na to, že většina "inovací" v oblasti trasování z hlediska UI/UX se zdá omezena dalších metadat do trace, vložením vysoce kardinálních informací (high-cardinality) nebo poskytováním možnosti detailizovat konkrétní span nebo provádět dotazy mezi a uvnitř trace. Přitom traceview zůstává hlavním prostředkem vizualizace. Pokud se taková situace udrží, distribuované trasování bude (v tom lepším případě) na 4. místě jako debuggingový nástroj, za metrikami, logy a stack trace, a v tom horším se ukáže jako prázdná ztráta peněz a času.
Problém s traceview
Účel traceview — poskytovat úplný obraz pohybu jednotlivého požadavku napříč všemi komponenty distribuovaného systému, k nimž se vztahuje. Některé pokročilejší systémy trasování umožňují detailizaci jednotlivých span a sledování časového rozložení uvnitř jednoho procesu (když span mají funkční hranice).
Základním předpokladem architektury mikroservisů je myšlenka, že organizační struktura roste spolu s potřebami společnosti. Příznivci mikroservisů tvrdí, že rozdělení různých obchodních úkolů do jednotlivých služeb umožňuje malým, autonomním týmům vývojářů řídit celý životní cyklus těchto služeb, což jim dává možnost nezávisle vytvářet, testovat a nasazovat tyto služby. Nicméně nevýhodou takového rozdělení je ztráta informací o tom, jak každá služba interaguje s ostatními. V takových podmínkách představuje distribuované sledování nepostradatelný nástroj pro ladění složitá interakce mezi službami.
Pokud máte opravdu , pak žádný člověk nedokáže udržet v hlavě jeho úplný obraz. Ve skutečnosti vývoj nástroje na základě předpokladu, že je to vůbec možné, je něco jako antipattern (neefektivní a neproduktivní přístup). Ideálně pro ladění potřebujete nástroj, který pomůže zúžit oblast hledání, aby se inženýři mohli soustředit na podmnožinu měření (služeb/uživatelů/serverů atd.), které se vztahují k příslušnému scénáři problému. Při zjišťování příčiny selhání inženýři nemají povinnost zkoumat, co se dělo ve všech službách najednou, protože takový požadavek by byl v rozporu s samotnou myšlenkou mikroservisní architektury.
Nicméně traceview představuje přesně tohle. Ano, některé sledovací systémy nabízejí zkrácené traceview, když je počet spanů v trace tak vysoký, že je nelze zobrazit v rámci jediné vizualizace. Nicméně kvůli velkému objemu informací, které obsahuje i tak zjednodušená vizualizace, jsou inženýři stále nuceni «procházet» ji, manuálně zúžit výběr na sadu služeb, které jsou zdrojem problémů. Bohužel, na tomto poli jsou stroje výrazně rychlejší než lidé, méně náchylné k chybám a jejich výsledky jsou opakovatelnější.
Dalším důvodem, proč považuji metodu traceview za nesprávnou, je, že se špatně hodí pro odstraňování chyb na základě hypotéz. V své podstatě je ladění iterativní proces, který začíná hypotézou, za níž následuje ověření různých pozorování a faktů získaných ze systému v různých směrech, závěry/souhrny a další hodnocení pravdivosti hypotézy.
Možnost rychle a levně testovat hypotézy a odpovídajícím způsobem zlepšovat mentální model je základním kamenem ladění. Každý ladicí nástroj by měl být interaktivní a zúžit prostor hledání nebo, v případě falešné stopy, umožnit uživateli vrátit se a soustředit se na jinou oblast systému. Ideální nástroj by to dělal s předstihem, okamžitě upoutávající pozornost uživatele na potenciálně problematické oblasti.
Bohužel, traceview nelze považovat nástroj s interaktivním rozhraním. To nejlepší, na co se dá při jeho používání spolehnout, je zjistit nějaký zdroj zvýšených latencí a prohlédnout si všechny možné značky a logy s ním spojené. To inženérovi nepomáhá najít vzorce v provozu, jako například specifika rozložení latencí, nebo odhalit korelace mezi různými měřeními. může pomoci obejít některé z těchto problémů. Skutečně, úspěšného analýzy pomocí strojového učení k odhalení anomálních spanů a identifikaci podmnožiny značek, které mohou být spojeny s anomálním chováním. Nicméně jsem doposud nenarazil na přesvědčivé vizualizace zjištění, učiněných pomocí strojového učení nebo analýzy dat u spanů, které by se významně lišily od traceview nebo DAG (směrovaného acyklického grafu).
Spany jsou příliš nízkoúrovňové
Základním problémem s traceview je, že spany jsou příliš nízkoúrovňovými primitivy pro analýzu latencí a analýzu příčin. Je to jako analyzovat jednotlivé instrukce procesoru při pokusu o vyřešení výjimky, přičemž víme, že existují mnohem vyšší úrovňové nástroje, jako je backtrace, s nimiž se lépe pracuje.
Navíc si dovolím tvrdit následující: ideálně nepotřebujeme vůbec úplný obraz co se stalo během životního cyklu požadavku, což moderní nástroje pro trasování prezentují. Místo toho je vyžadována nějaká forma abstrakce vyšší úrovně, která obsahuje informace o tom, co se pokazilo (analogicky k backtrace), spolu s určitým kontextem. Namísto toho, abych sledoval celý trace, dávám přednost tomu, abych viděl jeho část, kde se děje něco zajímavého nebo neobvyklého. V současné době se vyhledávání provádí ručně: inženýr obdrží trace a sám analyzuje span’y v hledání něčeho zajímavého. Přístup, kdy lidé zírají na span’y v jednotlivých trace’aích v naději, že odhalí podezřelou aktivitu, se absolutně neškáluje (zejména když musí zpracovávat veškerá metadata zakódovaná v různých spanech, jako je span ID, název RPC metody, délka span’a, logy, tagy atd.)
Alternativy traceview
Výsledky trasování jsou nejvíce užitečné, když je možné je vizualizovat tak, aby poskytly netriviální zobrazení toho, co se děje ve vzájemně propojených částech systému. Dokud to není k dispozici, proces ladění zůstává do značné míry inertní a závisí na schopnosti uživatele postřehnout správné korelace, zkontrolovat správné části systému nebo shromáždit kousky mozaiky dohromady — na rozdíl od nástroje, který pomáhá uživateli formulovat tyto hypotézy.
Nejsem vizuální designér a odborník na UX, nicméně v následující části chci sdílet několik nápadů o tom, jak by takové vizualizace mohly vypadat.
Zaměření na konkrétní služby
V podmínkách, kdy se odvětví konsoliduje kolem myšlenek , se zdá rozumné, že jednotlivé týmy by měly primárně sledovat, zda jejich služby odpovídají těmto cílům. Z toho vyplývá, že na službu orientovaná vizualizace je nejvhodnější pro takové týmy.
Trace’y, zejména bez výběru, jsou zlatým dolem informací o každé složce distribuovaného systému. Tyto informace lze předat chytrému zpracovateli, který uživatelům poskytne na službu orientované nálezy. Mohou být odhaleny předem — ještě předtím, než uživatel nahlédne do trace’ů:
- Diagramy rozložení zpoždění pouze pro výrazně odlišující se požadavky (výrazné požadavky);
- Diagramy rozložení zpoždění v případech, kdy nejsou splněny cíle SLO služby;
- Nejběžnější, nejzajímavější a nejpodivnější tagy v požadavcích, které se nejčastěji opakují;
- Rozdělení zpoždění v případech, kdy závislosti služby nedosahují stanovených cílů SLO;
- Rozdělení zpoždění podle různých podřízených (downstream) služeb.
Na některé z těchto otázek vestavěné metriky jednoduše nemohou odpovědět, nutí uživatele důkladně prozkoumávat span. Nakonec máme extrémně nepřátelský mechanismus pro uživatele.
V této souvislosti se objevuje otázka: jak to vypadá s komplexními interakcemi mezi různými službami, které kontrolují různé týmy? Není traceview nejvhodnějším nástrojem pro osvětlení podobné situace?
Mobilní vývojáři, majitelé stateless služeb, majitelé spravovaných stateful služeb (jako jsou databáze) a majitelé platforem mohou mít zájem o jinou prezentaci distribuovaného systému; traceview — je to příliš univerzální řešení pro tyto zásadně odlišné potřeby. I v velmi složité architektuře mikroslužeb nepotřebují majitelé služby hluboké znalosti více než dvou či tří upstream a downstream služeb. V podstatě, ve většině scénářů stačí, aby uživatelé odpovídali na otázky týkající se omezeného množství služeb..
To je jako zkoumat malé podmnožství služeb prostřednictvím lupa pro pečlivé prozkoumání. To umožní uživateli klást naléhavější otázky týkající se komplexní interakce mezi těmito službami a jejich bezprostředními závislostmi. Je to podobné backtrace v oblasti služeb, kde inženýr ví, co ne jak, ale také má nějakou představu o tom, co se děje v okolních službách, aby porozuměl, proč.
Můj přístup je úplně opačný než přístup z „hora dolů“ založený na traceview, kdy analýza začíná celým trace a poté se postupně dostává k jednotlivým spánům. Naproti tomu přístup „zdola nahoru“ začíná analýzou malé části blízké potenciální příčině incidentu, a poté se prostor vyhledávání rozšiřuje podle potřeby (s možným zapojením dalších týmů k analýze širšího spektra služeb). Druhý přístup je lépe přizpůsoben rychlé validaci počátečních hypotéz. Po získání konkrétních výsledků se pak přejde k cílenější a podrobnější analýze.
Budování topologie
Zobrazení spojená s konkrétní službou mohou být neuvěřitelně užitečná, pokud uživatel ví, která služba nebo skupina služeb může zvyšovat latenci nebo je zdrojem chyb. Nicméně, v komplikovaném systému může být určení problematické služby během selhání netriviálním úkolem, zvláště pokud zprávy o chybách od služeb nebyly přijaty.
Budování topologie služeb může výrazně pomoci při určování, která služba vykazuje nárůst chybovosti nebo zpoždění, což vede k viditelnému zhoršení funkčnosti. Když hovořím o budování topologie, nemyslím na mapu služeb, která zobrazuje každou existující službu v systému a je známá svými . Toto zobrazení není lepší než traceview založené na orientovaném acyklickém grafu. Místo toho bych rád viděl dynamicky generovanou topologii služeb, založenou na konkrétních atributech, jako je chybovost, doba odezvy nebo na jakémkoliv uživatelském parametru, který pomáhá objasnit situaci s konkrétními podezřelými službami.
Pojďme se podívat na příklad. Představme si hypotetickou zpravodajskou stránku. Služba hlavní stránky (front page) vyměňuje data s Redis, službou doporučení, reklamní službou a videoslužbou. Videoslužba načítá videa ze S3 a metadata z DynamoDB. Služba doporučení získává metadata z DynamoDB, načítá data z Redis a MySQL, posílá zprávy do Kafka. Reklamní služba získává data z MySQL a posílá zprávy do Kafka.
Níže je schématické znázornění této topologie (topologie jsou vytvářeny mnoha komerčními programy pro trasování). Může být užitečné, pokud je třeba porozumět závislostem služeb. Při ladění, kdy nějaká služba (například videoslužba) vykazuje zvýšenou dobu odezvy, však taková topologie není příliš užitečná.
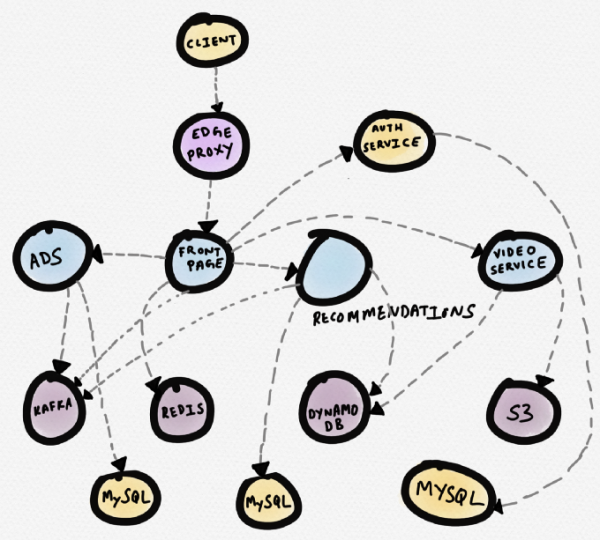
Schéma služeb hypotetického zpravodajského portálu
Lepší by byla diagram, který je zobrazen níže. Na něm je problémová služba (video) zobrazena přímo uprostřed. Uživatel si ji hned všimne. Z této vizualizace je jasné, že videoslužba funguje anomálně kvůli zvýšení doby odezvy S3, což ovlivňuje rychlost načítání části hlavní stránky.
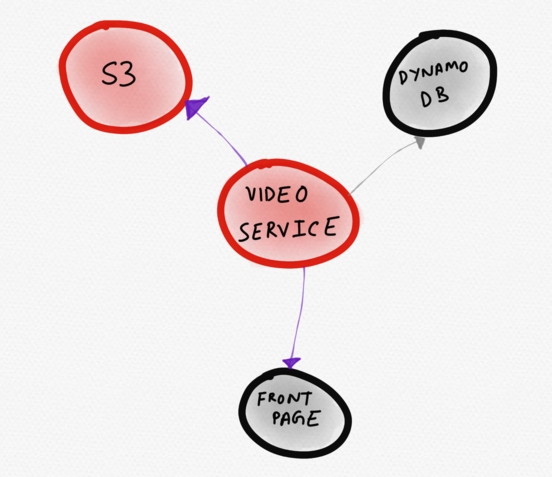
Dynamická topologie, zobrazující pouze „zajímavé“ služby
Dynamicky generované topologické schémata mohou být efektivnější než statické mapy služeb, zejména v elastických, automaticky škálovatelných infrastrukturách. Možnost porovnávat a srovnávat topologie služeb umožňuje uživateli klást aktuálnější otázky. Přesnější otázky o systému mají větší pravděpodobnost vést k lepšímu porozumění tomu, jak systém funguje.
Srovnávací zobrazení
Další užitečnou vizualizací bude srovnávací zobrazení. V současnosti trace nejsou příliš vhodné pro srovnání vedle sebe, takže se obvykle porovnávají spany. A hlavní myšlenka tohoto článku spočívá v tom, že span jsou příliš nízkoúrovňové na to, aby extrahovaly nejcennější informace z výsledků trasování.
Srovnání dvou trace nevyžaduje zásadně nové vizualizace. Ve skutečnosti stačí něco jako histogram, který představuje ty samé informace jako traceview. Je to překvapující, ale i tato jednoduchá metoda může přinést mnohem větší úspěch, než pouze studium dvou trace samostatně. Ještě silnější by byla možnost vizualizovat srovnání trace’ů v souhrnu. Bylo by velmi užitečné vidět, jak nedávno nasazená změna konfigurace databáze se zapnutým GC (garbage collection) ovlivňuje dobu odezvy downstream služby v průběhu několika hodin. Pokud to, co zde popisuji, vypadá jako A/B analýza vlivu infrastrukturních změn v mnoha službách , pak se příliš nepletlíte.
Závěr
Nepochybuji o užitečnosti samotného traceování. Upřímně věřím, že neexistuje jiná metoda, jak sbírat tak bohaté, případové a kontextové údaje, jako ty, které obsahuje trace. Nicméně také soudím, že všechna řešení pro traceování tyto údaje využívají extrémně neefektivně. Dokud budou nástroje pro traceování zakotveny v traceview reprezentaci, budou omezeny v možnostech maximálně využít cenné informace, které lze extrahovat z dat obsažených v traces. Navíc existuje riziko dalšího vývoje zcela nepřátelského a neintuitivního vizuálního rozhraní, které výrazně omezí schopnost uživatele odstraňovat chyby v aplikaci.
Debugování složitých systémů, i s použitím nejnovějších nástrojů, je nesmírně složité. Nástroje by měly pomáhat vývojáři formulovat a ověřovat hypotézy, aktivně poskytující relevantní informace, odhalující odchylky a zaznamenávající vlastnosti v rozložení latencí. Aby se traceování stalo preferovaným nástrojem vývojářů při odstraňování poruch v produkci nebo řešení problémů pokrývajících různé služby, jsou potřeba originální uživatelské rozhraní a vizualizace, které více odpovídají mentálnímu modelu vývojářů, kteří tyto služby vytvářejí a provozují.
Bude třeba značného duševního úsilí, abychom navrhli systém, který bude různá signály dostupné ve výsledcích traceování prezentovat způsobem optimalizovaným pro usnadnění analýzy a dedukcí. Je nutné promyslet, jak abstrahovat topologii systému během ladění tak, aby pomáhala uživateli překonávat slepé body, aniž by se musel dívat do jednotlivých trace’ů nebo span’ů.
Potřebujeme dobré možnosti abstrakce a rozdělení na úrovně (zejména v UI). Takové, které se dobře zapojí do procesu ladění na základě hypotéz, kde lze iterativně klást otázky a testovat hypotézy. Nevyřeší automaticky všechny problémy s pozorovatelností, ale pomohou uživatelům zdokonalit intuici a formulovat uváženější otázky. Vyjádřuji výzvu k promyšlenějšímu a inovativnímu přístupu v oblasti vizualizace. Zde je reálná příležitost rozšířit obzory.
P.S. od překladatele
Přečtěte si také náš blog:
- «»;
- «»;
- «».
Zdroj: habr.com
