

Když se hovoří o monitorování bezpečnosti interní podnikové nebo ministerské sítě, mnoho lidí si vybaví kontrolu úniků informací a zavádění DLP řešení. A co kdybychom se pokusili upřesnit otázku a zeptali se, jak zjistíte útoky v interní síti? Odpovědí většinou bude zmínka o systémech detekce útoků (intrusion detection systems, IDS). A to, co bylo jedinou možností před 10-20 lety, se dnes stává anachronismem. Existuje efektivnější, a místy dokonce jedině možný způsob monitorování interní sítě — používat flow protokoly, které byly původně určeny pro vyhledávání síťových problémů (troubleshooting), ale časem se transformovaly na velmi zajímavý bezpečnostní nástroj. O tom, jaké flow protokoly existují a které z nich lépe pomáhají odhalovat síťové útoky, kde je nejlepší implementovat monitorování flow, na co si dát pozor při nasazení takového schématu, a dokonce jak to vše „zvednout“ na domácím vybavení, si povíme v tomto článku.
Nebudu se zastavovat u otázky „Proč je potřeba monitorování bezpečnosti interní infrastruktury?“ Odpověď na ní je jasná. Ale pokud byste se chtěli ještě jednou ujistit, že dnes se bez toho nikam neposunete, malé video ukazující, jak lze 17 různými způsoby proniknout do korporátní sítě chráněné firewallem. Takže budeme považovat, že chápeme, že vnitřní monitorování je nezbytné, a zbývá jen pochopit, jak to lze zorganizovat.
Vybral bych tři klíčové zdroje dat pro monitorování infrastruktury na síťové úrovni:
- „surový“ provoz, který zachytávám a posílám na analýzu některým analytickým systémům,
- události ze síťových zařízení, přes která prochází provoz,
- informace o provozu získané pomocí jednoho z flow protokolů.
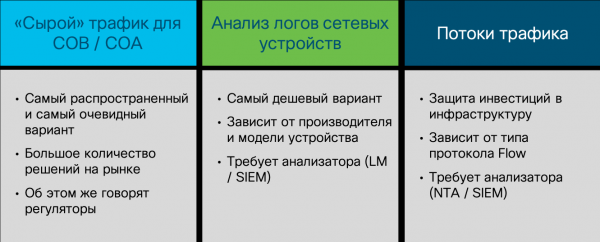
Zachytávání surového provozu je nejpopulárnější variantou mezi bezpečnostními odborníky, protože historicky byl prvním metodou. Běžné systémy detekce útoků (první komerční systém detekce útoků byl NetRanger od společnosti Wheel Group, zakoupený v roce 1998 firmou Cisco) se právě zabývaly zachytáváním paketů (a později i relací), ve kterých hledaly určité signatury („rozhodující pravidla“ v terminologii FSTEK), signalizující útoky. Samozřejmě, že analyzovat surový provoz lze nejen pomocí IDS, ale také s jinými prostředky (například Wireshark, tcpdump nebo funkce NBAR2 v Cisco IOS), ale těm obvykle chybí znalostní databáze, která odlišuje prostředek IB od běžného IT nástroje.
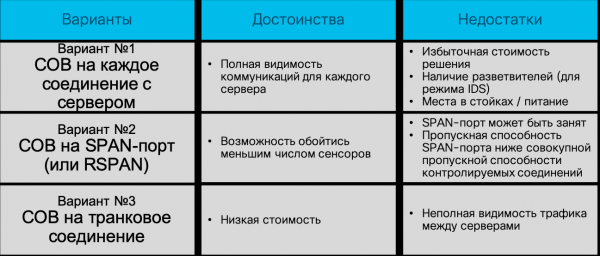
Takže, systémy detekce útoků. Nejstarší a nejpopulárnější metoda detekce síťových útoků, která si celkem dobře poradí se svou úlohou na perimetru (je jedno jakém — firemním, datovém centru, segmentu atd.), ale selhává v moderních síťových a softwarově definovaných prostředích. V případě sítě postavené na běžných přepínačích se infrastruktura senzorů detekce útoků stává příliš rozsáhlou — budete muset instalovat jeden senzor na každé spojení s uzlem, jehož útoky chcete monitorovat. Každý výrobce by vám samozřejmě rád prodal stovky a tisíce senzorů, ale myslím, že váš rozpočet by takové výdaje neunesl. Mohu říci, že i v Cisco (a my jsme vývojáři NGIPS) jsme to nezvládli, ačkoli si zdálo, že otázka ceny by neměla stát před námi — je to přece naše vlastní řešení. Navíc vyvstává otázka, jak senzor v takovém případě připojit? Do řezání? A co když se sám senzor porouchá? Požadovat přítomnost bypass modulu v senzoru? Používat rozbočovače (tap)? To vše zvyšuje náklady na řešení a činí je nedostupným pro společnosti jakékoli velikosti.
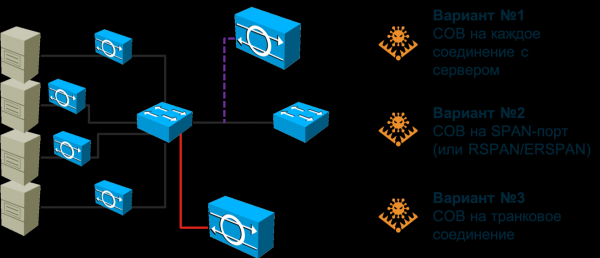
Můžete zkusit "pověsit" senzor na SPAN/RSPAN/ERSPAN port a nasměrovat na něj provoz z potřebných portů přepínače. Tato varianta částečně řeší problém popsaný v předchozím odstavci, ale vytváří jiný - SPAN port nemůže přijmout veškerý provoz, který mu bude nasměrován - nebude mít dostatečnou propustnost. Budete muset s něčím obětovat. Buď některé uzly nechat bez monitorování (pak je třeba předem provést jejich prioritizaci), nebo směřovat ne veškerý provoz z uzlu, ale pouze určitého typu. V každém případě můžeme přehlédnout některé útoky. Kromě toho může být SPAN port obsazen pro jiné potřeby. Nakonec budeme muset přehodnotit existující topologii sítě a možná ji upravit, abychom co nejlépe pokryli vaši síť stávajícím počtem senzorů (a sladit to s IT).
A co když vaše síť používá asymetrické trasy? A co když máte nasazenou nebo plánujete implementaci SDN? A co když potřebujete monitorovat virtualizované stroje nebo kontejnery, jejichž provoz vůbec nedosahuje fyzického přepínače? Tyto otázky výrobci tradičních IDS nemají rádi, protože nevědí, jak na ně odpovědět. Možná vás budou přesvědčovat, že všechny tyto módní technologie jsou hype a že je nepotřebujete. Možná budou mluvit o potřebě začít s malým. Nebo vám mohou říct, že potřebujete umístit výkonnou mašinu do centra sítě a nasměrovat veškerý provoz přes vyrovnávače zatížení. Ať už vám budou nabízet jakoukoli možnost, je důležité si jasně uvědomit, jak dobře vám vyhovuje. A teprve poté se rozhodnout o přístupu k monitorování informační bezpečnosti síťové infrastruktury. Pokud se vrátíme k zachycování paketů, chci říct, že tato metoda zůstává velmi populární a důležitá, ale jejím hlavním účelem je kontrola hranic; hranice mezi vaší organizací a Internetem, hranice mezi datovým centrem a zbylými sítěmi, hranice mezi řízením průmyslových procesů a korporátním segmentem. Na těchto místech mají klasické IDS/IPS stále oprávnění na existenci a docela dobře plní zadané úkoly.
Přejdeme k druhé variantě. Analýza událostí ze síťových zařízení může být také využita k detekci útoků, ale ne jako hlavní mechanismus, protože umožňuje detekovat pouze malou třídu narušení. Kromě toho má určitou reaktivitu — útok nejprve musí nastat, poté musí být zachycen síťovým zařízením, které nějakým způsobem signalizuje problém s informační bezpečností. Existuje několik takových metod. Může to být syslog, RMON nebo SNMP. Poslední dva protokoly pro síťový monitoring v kontextu informační bezpečnosti se používají pouze tehdy, pokud potřebujeme odhalit DoS útok na samotné síťové zařízení, protože pomocí RMON a SNMP můžeme sledovat, například, zatížení centrálního procesoru zařízení nebo jeho rozhraní. Je to jeden z nejlevnějších způsobů (syslog nebo SNMP má každý), ale také nejméně efektivní ze všech metod monitorování informační bezpečnosti vnitřní infrastruktury — mnohé útoky jsou před ním prostě skryté. Samozřejmě na ně nesmíme zapomínat a analýza syslog vám pomůže včas identifikovat změny v konfiguraci samotného zařízení, jeho kompromitaci, ale detekce útoků na celou síť není příliš vhodná.
Třetí možností je analýza informací o provozu, který prochází zařízením, jež podporuje jeden z několika flow protokolů. V tomto případě, bez ohledu na protokol, infrastruktura pro práci s tokem se vždy skládá ze tří komponentů:
- Generování nebo export flow. Tuto roli obvykle zajišťuje směrovač, switch nebo jiné síťové zařízení, které, když propouští síťový provoz, umožňuje vyčlenit z něj klíčové parametry, které jsou poté předávány shromažďovacímu modulu. Například protokol Netflow u Cisco se podporuje nejen na směrovačích a switchech, včetně virtuálních a průmyslových, ale také na bezdrátových controllerech, firewallech a dokonce i na serverech.
- Sběr flow. Vzhledem k tomu, že v moderní síti je obvykle více než jedno síťové zařízení, vzniká úkol shromáždit a konsolidovat toky, který se řeší pomocí takzvaných kolektorů, jež provádí zpracování přijatých toků a následně je předávají k analýze.
- Analýza flow. Analizátor se ujímá hlavního intelektuálního úkolu a používá různé algoritmy na toky, aby vyvodil určité závěry. Například v rámci IT funkce může tento analyzátor odhalovat úzká místa v síti nebo analyzovat profil zátěže provozu pro následnou optimalizaci sítě. A pro bezpečnost informací může tento analyzátor identifikovat úniky dat, šíření malwaru nebo DDoS útoky.
Neměli bychom si myslet, že taková trojvrstvá architektura je příliš složitá — všechny ostatní varianty (kromě možná systémů síťového monitorování pracujících se SNMP a RMON) také fungují podle ní. Máme generátor dat pro analýzu, kterým je síťové zařízení nebo samostatný senzor. Máme systém shromažďování poplachových signálů a systém správy celé monitorovací infrastruktury. Poslední dva komponenty mohou být integrovány v rámci jednoho uzlu, ale v rozměrnějších sítích jsou obvykle rozloženy na minimálně dvou zařízeních za účelem zajištění škálovatelnosti a spolehlivosti.
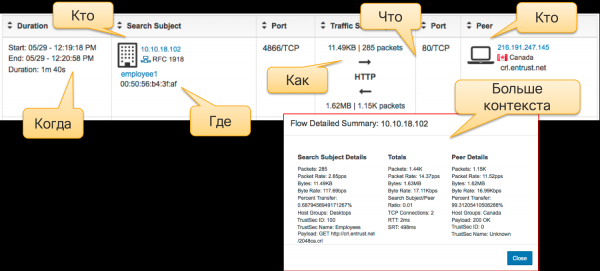
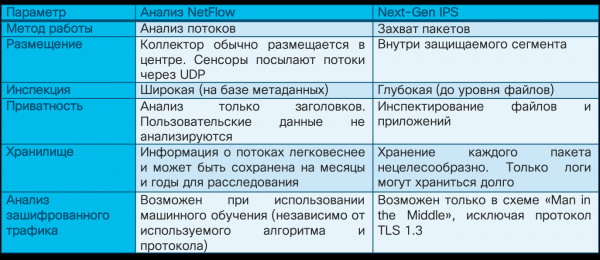
Na rozdíl od analýzy paketů, která se zakládá na zkoumání hlaviček a obsahu každého paketu a ze kterých se skládají sezení, analýza toků se opírá o shromažďování metadat o síťovém provozu. Kdy, kolik, odkud a kam, jak… to jsou otázky, na které odpovídá analýza síťové telemetrie pomocí různých flow protokolů. Původně byly používány k analýze statistik a hledání IT problémů v síti, ale později, s rozvojem analytických mechanismů, se staly použitelné i pro tuto telemetrii a pro bezpečnostní účely. Je třeba ještě jednou zdůraznit, že analýza toků nenahrazuje a nezruší zachytávání paketů. Každá z těchto metod má svou oblast použití. Ale v kontextu tohoto článku je právě analýza toků nejlépe vhodná pro monitorování vnitřní infrastruktury. Máte síťová zařízení (a je jedno, zda pracují v softwarově definované paradigmě nebo podle statických pravidel), která útok nelze obejít. Klasický IDS senzor může být mine, ale síťové zařízení podporující flow protokol nikoliv. To je výhoda této metody.
Na druhou stranu, pokud potřebujete důkazní materiály pro orgány činné v trestním řízení nebo vlastní vyšetřovací skupinu incidentů, bez zachytávání paketů se neobejdete — síťová telemetrie není kopií provozu, kterou lze použít při sběru důkazů; je potřebná pro rychlé odhalení a rozhodování v oblasti kybernetické bezpečnosti. Na druhou stranu, pomocí analýzy telemetrie můžete "zapsat" pouze ten provoz, který se účastní útoku (pokud by to mělo být, Cisco a datovými centry se zabývá :-), a ne celý síťový provoz. Nástroje pro analýzu telemetrie tak dobře doplní tradiční mechanismy zachytávání paketů tím, že umožní cílené zachytávání a ukládání. Jinak budete potřebovat obrovskou infrastrukturní kapacitu pro ukládání.
Představme si síť pracující na rychlosti 250 Mbit/s. Pokud byste chtěli uchovávat celý tento objem, potřebovali byste úložiště o velikosti 31 MB pro jednu sekundu přenosu dat, 1,8 GB pro jednu minutu, 108 GB pro jednu hodinu a 2,6 TB pro jeden den. Pro ukládání denních dat ze sítě s propustností 10 Gbit/s byste potřebovali úložiště o velikosti 108 TB. A přitom někteří regulátoři požadují uchovávat bezpečnostní data po celá léta... Záznam "na vyžádání", který vám pomáhá realizovat analýza toků, pomáhá tyto hodnoty radikálně snížit. Mimochodem, pokud jde o poměr objemu ukládaných dat síťové telemetrie a celkového zachycení dat, je to přibližně 1 ku 500. Pro tyto výše uvedené hodnoty by ukládání plného rozložení celého denního provozu v průměru činilo 5 a 216 GB. (Můžete to dokonce zapsat na běžnou flashku.)
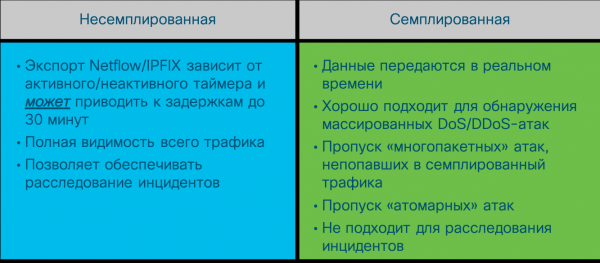
Pokud se metodika analýzy syrových síťových dat téměř neliší mezi jednotlivými dodavateli, situace při analýze toků je odlišná. Existuje několik variant flow protokolů, o jejichž rozdílech je třeba vědět zejména v kontextu bezpečnosti. Nejpoužívanější je protokol NetFlow, vyvinutý firmou Cisco. Existuje několik verzí tohoto protokolu, které se liší svými možnostmi a objemem zaznamenávaných informací o provozu. Aktuální verzí je devátá (NetFlow v9), na jejímž základě byl vyvinut průmyslový standard NetFlow v10, známý také jako IPFIX. Dnes většina síťových dodavatelů podporuje právě NetFlow nebo IPFIX ve svém zařízení. Existují však i různé jiné varianty flow protokolů — sFlow, jFlow, cFlow, rFlow, NetStream a další, přičemž sFlow je nejpopulárnější. Jeho častá podpora domácími výrobci síťového vybavení je způsobena jednoduchostí implementace. Jaké jsou klíčové rozdíly mezi NetFlow, který se de facto stal standardem, a sFlow? Klíčových bych vyzdvihl několik. Zaprvé, NetFlow má uživatelsky konfigurovatelná pole, na rozdíl od pevných polí v sFlow. A za druhé, a to je pro nás nejdůležitější, sFlow shromažďuje takzvanou samplingovou telemetrii; na rozdíl od nesamplingové telemetrie NetFlow a IPFIX. Jaký je mezi nimi rozdíl?
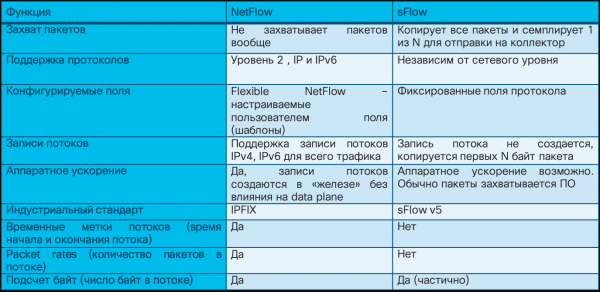
Představte si, že jste se rozhodli seznámit s knihou “” mých kolegů — Garyho McIntyra, Josepha Munica a Nadema Al-Fardana (na odkazu si můžete stáhnout část knihy). Máte tři možnosti, jak dosáhnout cíle — přečíst si celou knihu, proběhnout ji očima, zastavujíc se na každé 10., nebo 20. stránce, nebo se pokusit najít shrnutí klíčových konceptů v nějakém blogu nebo službě typu SmartReading. Takže nesamplingová telemetrie je jako čtení každé “stránky” síťového provozu, tedy analýza metadat pro každý paket. Samplingová telemetrie je selektivní zkoumání provozu s nadějí, že se ve vybraných vzorcích objeví to, co potřebujete. V závislosti na rychlosti kanálu bude samplingová telemetrie posílat k analýze každý 64., 200., 500., 1000., 2000. nebo dokonce 10000. paket.
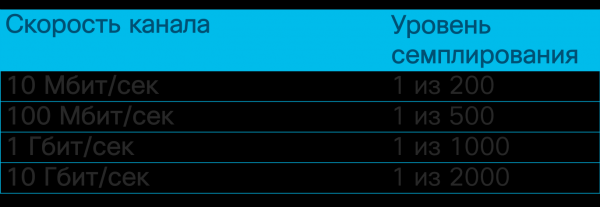
V kontextu monitorování kybernetické bezpečnosti to znamená, že vzorkovaná telemetrie je dobře vhodná pro detekci DDoS útoků, skenování a šíření malwaru, ale může minout atomární nebo Vícebalíkové útoky, které se nedostaly do vzorku zaslaného k analýze. Nesamplovaná telemetrie tato omezení nemá a s její pomocí je spektrum detekovaných útoků mnohem širší. Zde je malý seznam událostí, které lze detekovat pomocí prostředků analýzy síťové telemetrie.
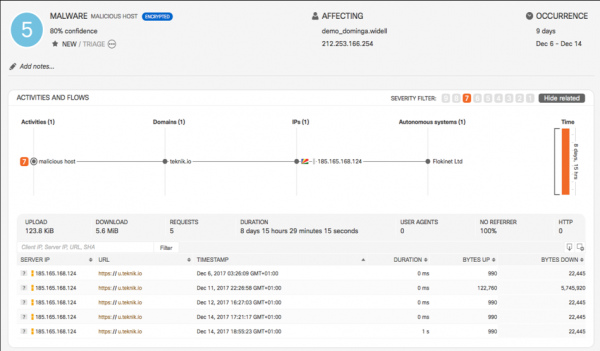
Samozřejmě, že nějaký open source analyzátor Netflow vám to neumožní, protože jeho hlavním úkolem je shromažďovat telemetrii a provádět nad ní základní analýzu z pohledu IT. Pro odhalení hrozeb kybernetické bezpečnosti na základě flow je nezbytné vybavit analyzátor různými enginy a algoritmy, které budou na základě standardních nebo uživatelských polí Netflow identifikovat problémy v kybernetické bezpečnosti, obohacovat standardní data externími daty z různých zdrojů Threat Intelligence atd.
Proto, pokud máte na výběr, zvolte Netflow nebo IPFIX. Ale i když vaše zařízení pracuje pouze s sFlow, jak u domácích výrobců, i v tomto případě z něj můžete vytěžit užitek v kontextu bezpečnosti.
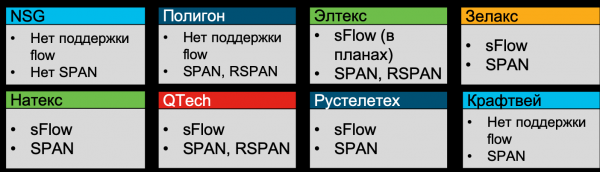
V létě 2019 jsem prováděl analýzu možností, které mají ruští výrobci síťového hardwaru, a všichni, kromě NSG, Poligonu a Kraftveye, tvrdili, že podporují sFlow (alespoň Zelaks, Natex, Eltex, QTech, Rusteletech).
Další otázka, kterou si položíte, je, kde implementovat podporu flow pro bezpečnostní účely? Odpověď na tuto otázku není zcela správná. Na moderním vybavení je podpora flow protokolů téměř vždy. Proto bych tuto otázku přeformuloval jinak – kde je nejefektivnější sbírat telemetrii z pohledu bezpečnosti? Odpověď je docela jasná – na úrovni přístupu, kde uvidíte 100 % veškerého provozu, kde budete mít podrobné informace o hostitelích (MAC, VLAN, ID rozhraní), kde dokážete sledovat i P2P provoz mezi hostiteli, což je kritické pro detekci skenování a šíření škodlivého kódu. Na úrovni jádra část provozu prostě neuvidíte, a na úrovni perimetru uvidíte maximálně čtvrtinu celého vašeho síťového provozu. Pokud však z různých důvodů ve vaší síti existují cizí zařízení, která umožňují útočníkům „vstupovat a vystupovat“, obcházející perimetr, analýza telemetrie z něj vám nic nepřinese. Proto se pro maximální pokrytí doporučuje zahrnout sběr telemetrie právě na úrovni přístupu. Je třeba poznamenat, že i když mluvíme o virtualizaci nebo kontejnerech, moderní virtuální switche také často podporují flow, což umožňuje řídit provoz i tam.
Ale když už jsem toto téma nastolil, musím odpovědět na otázku, co když zařízení, fyzické nebo virtuální, přesto nepodporuje flow protokoly? Nebo je jeho zapnutí zakázáno (například v průmyslových segmentech pro zajištění spolehlivosti)? Nebo zapnutí vede k vysokému zatížení centrálního procesoru (což se stává na zastaralém vybavení)? Pro řešení tohoto problému existují specializované virtuální senzory (flow sensor), které v podstatě fungují jako běžné rozbočovače, které propouštějí provoz a přenášejí ho ve formě flow na sběrný modul. Pravda, v tomto případě se setkáváme se všemi problémy, o kterých jsme hovořili výše v souvislosti s prostředky pro zachytávání paketů. Musíme tedy rozumět nejen výhodám technologie analýzy toků, ale také jejím omezením.
Ještě jedna věc, kterou je důležité mít na paměti, když mluvíme o nástrojích pro analýzu toků. Pokud pro běžné nástroje generování událostí bezpečnosti používáme metriku EPS (událostí za sekundu), pak pro analýzu telemetrie se tento ukazatel neuplatňuje; nahrazuje se metrikou FPS (toků za sekundu). Stejně jako u EPS, předem jej nelze spočítat, ale můžeme odhadnout přibližný počet toků, které generuje určité zařízení v závislosti na jeho úkolu. Na internetu najdete tabulky s přibližnými hodnotami pro různé typy firemních zařízení a podmínek, které vám umožní odhadnout, jaké licence budete potřebovat pro nástroje analýzy a jak bude jejich architektura vypadat. Je to proto, že senzor IDS má omezenou propustnost, kterou „vytáhne“, a také sběrač toků má svá omezení, která je třeba chápat. Proto v rozsáhlých, geograficky distribuovaných sítích je obvykle více sběračů. Když jsem popisoval, , už jsem uváděl číslo našich sběračů — je jich 21. A to na síť rozprostřenou po pěti kontinentech a obsahující přibližně půl milionu aktivních zařízení).
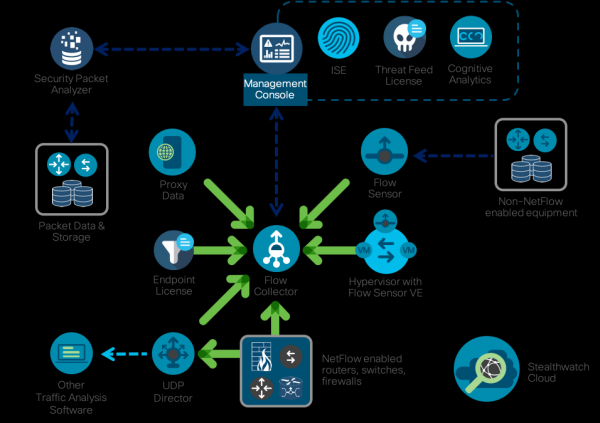
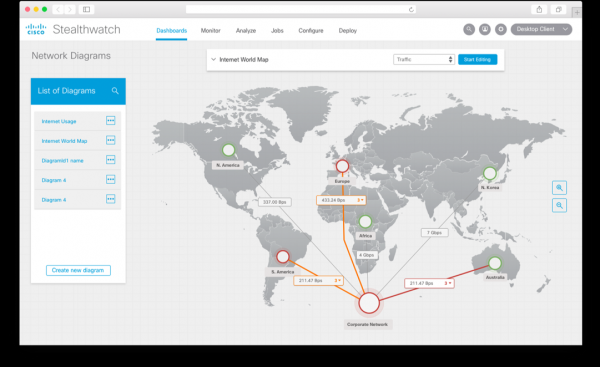
Jako systém monitorování Netflow používáme naše vlastní řešení , které je speciálně zaměřeno na řešení bezpečnostních úkolů. Obsahuje mnoho integrovaných motorů pro detekci anomální, podezřelé a zcela škodlivé aktivity, což umožňuje detekci širokého spektra různých hrozeb – od kryptominingu po úniky informací, od šíření škodlivého kódu po podvody. Stealthwatch, podobně jako většina analyzátorů toku, je postaven na trojvrstvé architektuře (generátor – sběrač – analyzátor), ale je doplněn několika zajímavými funkcemi, které jsou důležité v kontextu probírané problematiky. Za prvé, integruje se s řešeními pro zachytávání paketů (například Cisco Security Packet Analyzer), což umožňuje zaznamenávat vybrané síťové sezení pro následné důkladné vyšetřování a analýzu. Za druhé, speciálně pro rozšíření bezpečnostních úkolů jsme vyvinuli speciální protokol nvzFlow, který umožňuje „streamovat“ činnost aplikací na koncových uzlech (serverech, pracovních stanicích atd.) do telemetrie a předávat ji na sběrač pro další analýzu. Zatímco ve své původní podobě Stealthwatch pracuje s jakýmkoliv protokolem toku (sFlow, rFlow, Netflow, IPFIX, cFlow, jFlow, NetStream) na síťové úrovni, podpora nvzFlow umožňuje provádět korelaci dat i na úrovni uzlu, čímž zvyšuje efektivitu celého systému a zachycuje více útoků než běžné síťové analyzátory toku.
Je jasné, že mluvíme-li o systémech pro analýzu Netflow z hlediska zabezpečení, trh není omezen pouze na jedno řešení od firmy Cisco. Můžete používat jak komerční, tak bezplatná nebo podmíněně bezplatná řešení. Bylo by dost zvláštní, kdybych v blogu Cisco uváděl příklady řešení konkurentů, proto řeknu pár slov o tom, jak může být síťová telemetrie analyzována pomocí dvou populárních, pojmenováním podobných, ale přesto různých nástrojů – SiLK a ELK.
SiLK je sada nástrojů (Systém pro znalosti na úrovni internetu) pro analýzu provozu, kterou vyvinul americký CERT/CC a která v kontextu dnešního článku podporuje Netflow (5. a 9. nejpopulárnější verze), IPFIX a sFlow, a pomocí různých utilit (rwfilter, rwcount, rwflowpack atd.) provádí různé operace s síťovou telemetrií za účelem odhalení známek neoprávněných činností. Je však třeba zmínit několik důležitých bodů. SiLK je nástroj příkazového řádku a provádět operativní analýzu znamená stále zadávat příkazy, například (odhalení paketů ICMP o velikosti větší než 200 bajtů):
rwfilter --flowtypes=all/all --proto=1 --bytes-per-packet=200- --pass=stdout | rwrwcut --fields=sIP,dIP,iType,iCode --num-recs=15
není to příliš pohodlné. Můžete použít grafické rozhraní iSiLK, ale to vám příliš neusnadní život, protože plní pouze funkci vizualizace, nikoli náhrady analytika. A to je druhý bod. Na rozdíl od komerčních řešení, která už obsahují solidní analytickou základnu, algoritmy pro odhalování anomálií, odpovídající workflow atd., v případě SiLK budete muset toto vše provést sami, což vyžaduje trochu jiné kompetence, než využití hotových nástrojů. To není dobré ani špatné — je to vlastnost téměř každého bezplatného nástroje, který vychází z toho, že víte, co dělat, a on vám v tom pouze pomůže (komerční nástroje jsou méně závislé na kompetencích svých uživatelů, přesto však předpokládají, že analytici rozumí alespoň základům provádění síťových vyšetřování a monitoringu). Ale vraťme se k SiLK. Cyklus práce analytika s tímto nástrojem vypadá takto:
- Formulace hypotézy. Musíme mít jasnou představu o tom, co budeme hledat v síťové telemetrii, a znát unikátní atributy, podle kterých budeme vyhledávat určité anomálie nebo hrozby.
- Vytváření modelu. Po formulaci hypotézy ji programujeme pomocí Pythonu, shellu nebo jiných nástrojů, které nepatří do SiLK.
- Testování. Přichází řada na ověření naší hypotézy, kterou potvrdí nebo vyvrátí utility SiLK, začínající na 'rw', 'set', 'bag'.
- Analýza reálných dat. V průmyslovém provozu SiLK nám pomáhá odhalovat určité trendy a analytik musí odpovědět na otázky jako "Našli jsme to, co jsme očekávali?", "Odpovídá to naší hypotéze?", "Jak snížit počet falešných poplachů?", "Jak zlepšit úroveň rozpoznávání?" a podobně.
- Zlepšení. V závěrečné fázi vylepšujeme dříve udělané věci — vytváříme šablony, zlepšujeme a optimalizujeme kód, přeformulováváme a upřesňujeme hypotézu a další.
Tento cyklus bude použitelný také pro Cisco Stealthwatch, pouze poslední tyto pět kroků maximalizuje automatizaci, čímž snižuje chyby analytika a zvyšuje pohotovost při detekci incidentů. Například v SiLK můžete obohatit síťovou statistiku o externí data o škodlivých IP pomocí vlastních skriptů, zatímco v Cisco Stealthwatch — je to integrovaná funkce, která ihned zobrazuje varovný signál, pokud se v síťovém provozu objeví interakce s IP adresami ze seznamu zakázaných.
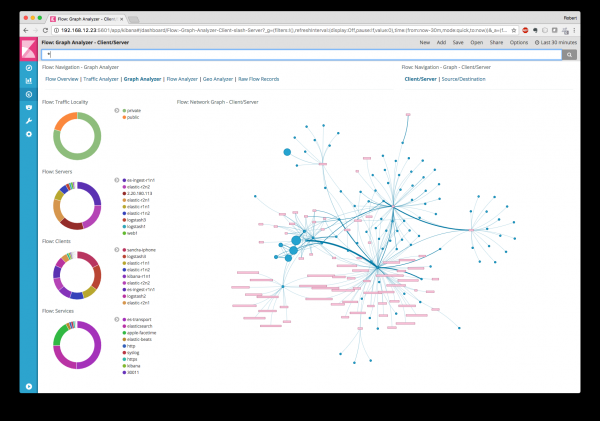
Pokud se podíváte výše na pyramidě "placenosti" software pro analýzu flow, pak po zcela bezplatném SiLK následuje podmíněně bezplatné ELK, které se skládá ze tří klíčových komponentů — Elasticsearch (indexování, vyhledávání a analýza dat), Logstash (vstup/výstup dat) a Kibana (vizualizace). Na rozdíl od SiLK, kde je všechno potřeba napsat samostatně, má ELK již mnoho hotových knihoven/modulů (část placené, část ne), které automatizují analýzu síťové telemetrie. Například filtr GeoIP v Logstash umožňuje přidělit sledované IP adresy k jejich geografické poloze (stealthwatch má tuto funkci zabudovanou).
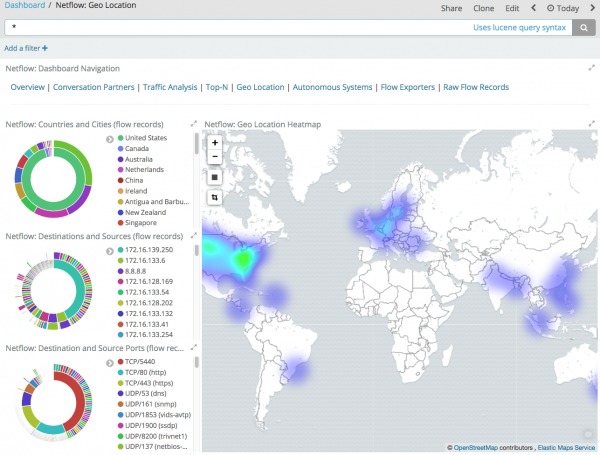
ELK má také poměrně velké komunitní zázemí, které doplňuje chybějící komponenty pro toto monitorovací řešení. Například pro práci s Netflow, IPFIX a sFlow můžete využít modul , pokud vám nevyhovuje Logstash Netflow Module, který podporuje pouze Netflow.
Přestože ELK poskytuje lepší pohotovost při sběru flow a vyhledávání v něm, v současnosti postrádá bohatou integrovanou analytiku pro odhalování anomálií a hrozeb v síťové telemetrii. Tedy, v souladu s výše popsaným životním cyklem, budete muset sami popsat modely porušení a poté je používat v produkčním systému (žádné integrované modely tam nejsou).
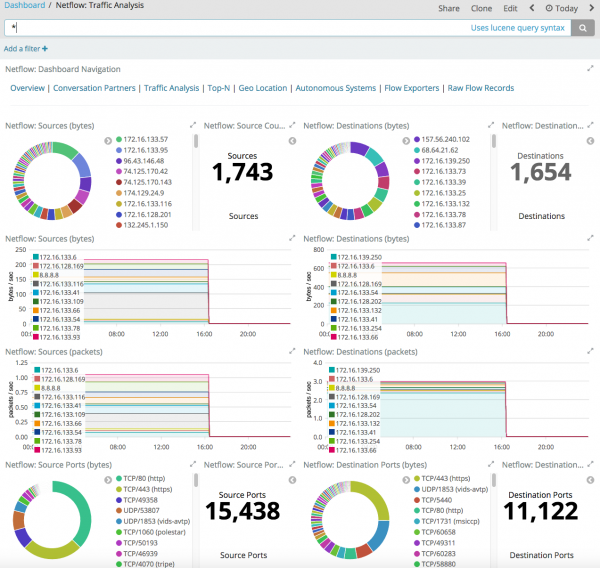
Existují samozřejmě i více sofistikovaná rozšíření pro ELK, která již obsahují některé modely detekce anomálií v síťové telemetrii, ale taková rozšíření stojí peníze a vyvstává otázka, zda to za to opravdu stojí — napsat si podobný model sám, koupit jeho realizaci pro své monitorovací nástroje, nebo si pořídit hotové řešení třídy Network Traffic Analysis.
O tom, zda je lepší investovat peníze a koupit hotové řešení pro monitoring anomálií a hrozeb v síťové telemetrii (například Cisco Stealthwatch), nebo se na to podívat sám a přizpůsobit si pro každou novou hrozbu ten stejný SiLK, ELK nebo nfdump či OSU Flow Tools (mám na mysli poslední dvě), se mi nechce rozepisovat. Každý si vybírá podle sebe a pro každého existují své důvody vybrat jednu z obou variant. Já jsem chtěl pouze ukázat, že síťová telemetrie je velmi důležitým nástrojem pro zajištění kybernetické bezpečnosti vlastní vnitřní infrastruktury a není dobré ji podceňovat, abychom se nepřipojili k seznamu firem, jejichž jména se objevují v médiích s přídomky jako „hacknutá“, „neseznamující se s požadavky na IB“, „nemyslící na bezpečnost svých dat a dat svých klientů“.
Na závěr bych chtěl shrnout klíčové rady, kterými byste se měli řídit při nastavování monitorování IB své vnitřní infrastruktury:
- Nepřestávejte pouze na perimetru! Používejte (a vybírejte) síťovou infrastrukturu nejen pro přenos dat mezi bodem A a bodem B, ale také pro řešení otázek kybernetické bezpečnosti.
- Prozkoumejte stávající mechanismy monitorování IB ve vašem síťovém zařízení a zapojte je.
- Pro interní monitoring dáváte přednost analýze telemetrie — ta umožňuje odhalit až 80-90 % všech síťových incidentů IB, přičemž dělá to, co je nemožné při zachycení síťových paketů a šetří místo pro uchovávání všech událostí IB.
- Pro monitoring toků používejte Netflow v9 nebo IPFIX – ty poskytují více informací v kontextu bezpečnosti a umožňují sledovat nejen IPv4, ale i IPv6, MPLS a další.
- Používejte nesemplovaný flow protokol – ten poskytuje více informací pro odhalování hrozeb. Například Netflow nebo IPFIX.
- Zkontrolujte zatížení vašeho síťového vybavení – možná nebude schopné zpracovávat také flow protokol. Poté zvažte použití virtuálních senzorů nebo zařízení pro generování Netflow.
- Implementujte kontrolu především na úrovni přístupu – to vám umožní vidět 100 % veškerého provozu.
- Pokud nemáte na výběr a používáte ruské síťové vybavení, vyberte si to, které podporuje flow protokoly nebo má SPAN/RSPAN porty.
- Kombinujte systémy detekce/prevence útoků na hranicích s analyzačními systémy vnitřních proudů (včetně cloudů).
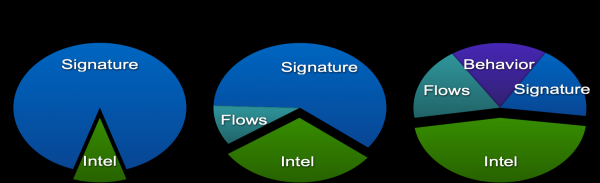
Co se týče posledního doporučení, rád bych uvedl ilustraci, kterou jsem již jednou zmiňoval. Vidíte, že dříve služba kybernetické bezpečnosti Cisco téměř zcela budovala svůj monitoring na základě systémů detekce útoků a signaturních metod, ale nyní na jejich podíl připadá pouze 20 % incidentů. Dalších 20 % odpovídá systémům analýzy toků, což naznačuje, že tato řešení nejsou pouhým rozmaru, ale skutečným nástrojem v činnosti kybernetických bezpečnostních služeb moderního podniku. O to víc, že pro jejich zavedení máte to nejdůležitější – síťovou infrastrukturu, jejíž investice můžete navíc chránit tím, že na síť přenesete i funkce monitorování bezpečnosti.
Úmyslně jsem se nezabýval tématem reakce na zjištěné anomálie nebo hrozby v síťových tocích, ale myslím, že je zřejmé, že monitoring by neměl končit pouze odhalením hrozby. Mělo by následovat reakce, ideálně v automatickém nebo automatizovaném režimu. Ale to je již téma pro samostatný materiál.
Další informace:
P. S. Pokud vám lépe vyhovuje slyšet všechny výše uvedené informace, můžete si prohlédnout hodinovou prezentaci, která byla základem tohoto poznámky.

Zdroj: habr.com
