

Říká se, že v životě stojí za to vyzkoušet všechno alespoň jednou. A pokud jste zvyklí pracovat s relačními databázovými systémy, setkání s NoSQL v praxi byste měli zvážit především pro všeobecný rozvoj. V současné době, díky rychlému rozvoji této technologie, existuje mnoho protichůdných názorů a vášnivých diskuzí na toto téma, což zájem ještě více podporuje.
Pokud se ponoříte do podstaty všech těchto sporů, můžete vidět, že vznikají z nesprávného přístupu. Ti, kteří používají NoSQL databáze na místech, kde jsou potřeba, jsou spokojeni a získávají ze svého řešení všechny jeho výhody. Experimentátoři, kteří spoléhají na tuto technologii jako na všelék tam, kde není vůbec použitelná, zažívají zklamání, jelikož ztrácejí silné stránky relačních databází, aniž by získali významné výhody.
Povím vám o naší zkušenosti s implementací řešení založeného na databázi Cassandra: s čím jsme se potýkali, jak jsme se dostávali z obtížných situací, zda se nám podařilo získat výhody z používání NoSQL a kde jsme museli investovat další úsilí/náklady.
Základním úkolem je vytvoření systému, který zaznamenává hovory do určitého úložiště.
Princip fungování systému je následující. Na vstupech přicházejí soubory s určitou strukturou, popisující strukturu hovoru. Aplikace poté zajišťuje uložení této struktury do odpovídajících sloupců. Uložené hovory se následně používají – k zobrazení informací o spotřebě dat pro účastníky (účtování, hovory, historie zůstatku).
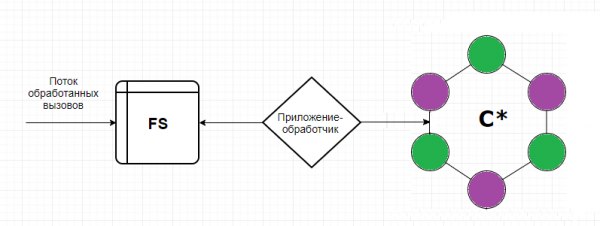
Proč jsme zvolili Cassandru je zcela jasné – píše jako kulomet, je snadno škálovatelná a odolná proti chybám.
Takže, co nám zkušenost přinesla
Ano, vyhozený uzel – není tragédie. O tom je podstata odolnosti Kassandry. Ale uzel může být živý a přesto začít mít problémy s výkonem. Jak se ukázalo, to se okamžitě odráží na výkonu celého klastru.
Kassandra vás nepodpoří tam, kde Oracle zachraňoval svými omezeními. A pokud autor aplikace tento aspekt předem nepochopil, pak pro Kassandra není dubl vůbec horší než originál. Když přišel, dáme ho.
Bezplatná Kassandra „z krabice“ se náhle nelíbila IB: Žádné logování akcí uživatelů, ani rozdělení práv.. Informace o voláních se týká osobních údajů, což znamená, že všechny pokusy o jejich dotazování / změnu musí být logovány s možností následné auditu. Je také nutné si uvědomit nezbytnost rozdělení práv na různé úrovně pro různé uživatele. Obvyklý inženýr údržby a superadmin, který může volně odstranit celý keyspace – to jsou různé role, jiná odpovědnost a kompetence. Bez takového rozdělení přístupu se hodnota a integrita dat velmi rychle dostanou pod otázku, rychleji než na úrovni konzistence ANY.
Nepočítali jsme s tím, že k voláním je zapotřebí jak vážná analýza, tak i periodické výběry podle nejrůznějších podmínek. Vzhledem k tomu, že vybrané záznamy se pak předpokládají k odstranění a přepsání (v rámci úkolu musíme udržovat proces aktualizace dat, když k nám původně došlo chybné kontury dat), Cassandra nám zde není nápomocná. Cassandra, jako pokladnice – je pohodlné ji plnit, ale nebude možné v ní počítat.
Narazili jsme na problém s přenosem dat do testovacích zón. (5 uzlů v testu oproti 20 v produkci). Dump v tomto případě nebude možné použít.
Problém s aktualizacemi schématu dat aplikace, která zapisuje do Cassandry. Rollback vytvoří velké množství tombstonů, což může nepředvídatelným způsobem snížit výkon.. Cassandra je optimalizována pro zápis a před tím, než zapíše, se moc neodvažuje. Jakákoli operace s existujícími daty je také zápis. Tedy odstraněním nadbytečných záznamů jednoduše vytvoříme ještě více zápisů a pouze část z nich bude označena jako tombstone.
Časové limity při vkládání. Cassandra je skvělá při zápisu, ale někdy ji příchozí tok může značně zmást.. To se stává, když aplikace začne neustále cyklit přes několik záznamů, které nelze vložit z jakéhokoli důvodu. A budeme potřebovat skutečného DBA, který bude sledovat gc.log, systémové a debug logy pro pomalé dotazy a metriky na čekající kompresi.
Několik datových center v clusteru. Odkud číst a kam zapisovat?
Je možné rozdělit na čtení a zápis? A pokud ano, měl by být déle zpracovávající server pro zápis nebo pro čtení? A nestane se, že budeme mít skutečný split brain, pokud špatně zvolíme úroveň konzistence? Je tu spousta otázek, mnoho neprozkoumaných nastavení a možností, které bychom chtěli vyzkoušet.
Jak jsme se rozhodli
Aby nód nezahlcoval, jsme vypnuli SWAP. A teď, když je nedostatek paměti, by měl nód selhat, a ne vytvářet dlouhé gc pauzy.
Takže na logiku v databázi už se více nespoléháme. Vývojáři aplikace se přeučují a začínají se aktivně chránit ve svém vlastním kódu. Ideální jasné rozdělení mezi ukládáním a zpracováním dat.
Zakoupili jsme podporu od DataStax. Komerční Cassandra už se přestala vyvíjet (poslední commit v únoru 2018). Zároveň ale Datastax nabízí vynikající služby a velké množství vylepšených a přizpůsobených řešení pro existující informační systémy.
Rád bych také poznamenal, že Cassandra není příliš pohodlná pro dotazy na výběr. Samozřejmě, CQL je velký krok vpřed pro uživatele (v porovnání s Thrift). Ale pokud máte celé oddělení zvyklé na tak pohodlné spojování, volnou filtraci podle jakéhokoli pole a možnosti optimalizace dotazů, a tato oddělení pracují na tom, aby řešila nároky a havárie, pak se jim řešení na Cassandře zdá nepřátelské a hloupé. A začali jsme řešit, jak umožnit našim kolegům provádět výběry.
Zvažovali jsme dvě možnosti. V první možnosti zapisujeme vývolání nejen do C*, ale také do archivní databáze Oracle. Jen s tím rozdílem, že v této databázi jsou uloženy vývolání pouze za aktuální měsíc (dostatečná hloubka uchovávání vývolání pro případy p ре-tarifikace). Zde se hned vybavovala další problém: pokud bychom psali synchronně, ztrácíme všechny výhody C*, spojené s rychlým vkládáním, pokud asynchronně – není zaručeno, že všechna potřebná vývolání vůbec dostala do Oracle. Plus byl jeden, ale velký: pro provozování zůstává stále ten samý známý PL/SQL Developer, tj. prakticky realizujeme vzor „Fasádní“. Alternativní možnost. Realizujeme mechanismus, který vyváží vývolání z C*, vytahuje nějaká data pro obohacení z odpovídajících tabulek v Oracle, spojuje získané výběry a vydává nám výsledný výstup, který potom nějak využijeme (vracíme, opakujeme, analyzujeme, obdivujeme). Nevýhody: proces se ukazuje jako poměrně vícestupňový a navíc chybí rozhraní pro zaměstnance provozu.
Nakonec jsme se přece jen rozhodli pro druhou variantu. Pro výběry z různých zdrojů jsme použili Apache Spark. Podstata mechanismu spočívala v Java kódu, který podle zadaných klíčů (předplatitel, čas provedení vývolání – klíče oddílu) vytahuje data z C*, stejně jako potřebná data pro obohacení z jakékoli jiné databáze. Poté je spojuje ve své paměti a výstup vrací do výsledkové tabulky. Na Sparku jsme vytvořili webové rozhraní a výstup se ukázal jako zcela použitelné v provozu.
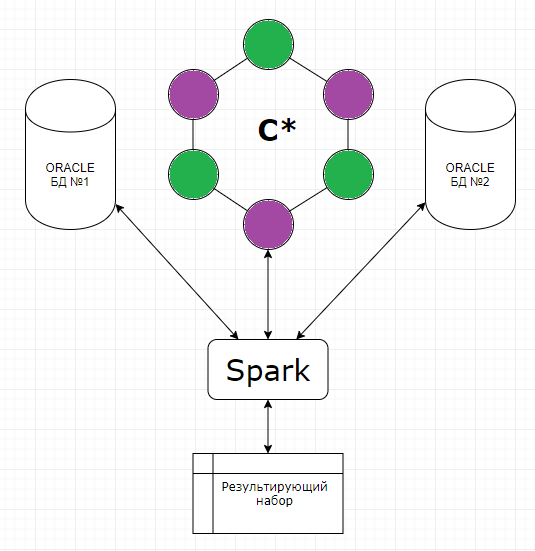
Při řešení úkolu s aktualizací dat jsme znovu zvažovali několik způsobů. Jak přenos přes Sstloader, tak varianta se rozdělením clusteru v testovací zóně na dvě části, z nichž každá se střídavě připojuje k jednomu clusteru s produkčními daty, čímž se od něj napájí. Při aktualizaci testu se plánovalo je vyměnit: ta část, která pracovala v testu, se vyčistí a zavede do produkce, zatímco druhá začne pracovat s daty samostatně. Po dalším uvážení jsme však racionálněji posoudili, která data stojí za přenos, a pochopili jsme, že samotné volání je nekonzistentní entita pro testy, rychle generovaná podle potřeby, a právě produkční datová sada nemá hodnotu pro přenos do testu. Existuje několik objektů, které stojí za přenos, ale jsou to doslova jen pár tabulek, které nejsou příliš těžké. Proto nám jako řešení znovu pomohl Spark, díky němuž jsme napsali a začali aktivně používat skript na přenos dat mezi tabulkami produkce a testu.
Naše současná politika nasazení nám umožňuje pracovat bez návratů zpět. Před produkcí je povinný nasazení na test, kde chyba není tak drahá. V případě neúspěchu je vždy možné odstranit keyspace a nasadit celou schéma od začátku.
Pro zajištění nepřetržité dostupnosti Cassandry je potřeba DBA a nejen on. Všichni, kdo pracují s aplikací, by měli chápat, kde a jak sledovat aktuální stav a jak včas diagnostikovat problémy. K tomu aktivně používáme DataStax OpsCenter (správa a monitorování pracovních zátěží), systémové metriky Cassandra Driver (počet timeoutů při zápisu do C*, počet timeoutů při čtení z C*, maximální latence atd.), monitorujeme práci samotné aplikace, která pracuje s Cassandrou.
Když jsme přemýšleli o předchozí otázce, pochopili jsme, kde se může skrývat hlavní riziko. Tím jsou formy zobrazení dat, které načítají informace z několika nezávislých dotazů do úložiště. Tímto způsobem můžeme získat značně nekonzistentní informace. Tento problém by však byl stejně aktuální, i kdybychom pracovali pouze s jedním datovým centrem. Nejrozumnější je tedy vytvořit dávkovou funkci pro čtení dat na externí aplikaci, která zajistí získání dat v jednotném časovém období. Co se týče dělení na čtení a zápis z hlediska výkonu, zde nás zastavilo riziko, že při určité ztrátě konektivity mezi datovými centry můžeme získat dva zcela nesourodé clustery.
V důsledku toho, v současnosti jsme se rozhodli pro úroveň konzistence pro zápis EACH_QUORUM, pro čtení – LOCAL_QUORUM.
Krátké dojmy a závěry
Abychom ohodnotili vzniklé řešení z hlediska provozní podpory a vyhlídek na další vývoj, rozhodli jsme se zamyslet, kde ještě lze tuto vyvinutou technologii aplikovat.
Pokud hned, pak skóring dat pro programy typu „Plať, když je to pohodlné“ (nahráváme do C* informace, výpočty na skriptech Spark), sledování stížností s agregací podle směrů, uchovávání rolí a výpočty podle matice přístupových práv uživatelů.
Jak vidíme, repertoár je široký a různorodý. A pokud bychom měli vybrat stranu zastánců/odpůrců NoSQL, postavili bychom se na stranu zastánců, protože jsme získali své výhody, a to právě tam, kde jsme čekali.
I variant Cassandra z krabice umožňuje horizontální škálování v reálném čase, naprosto bezbolestně řešící problém zvyšování dat v systému. Dokázali jsme oddělit vysoce zatížený mechanismus pro výpočet agregátů podle hovorů a také oddělit schéma a logiku aplikace, čímž jsme se zbavili škodlivé praxe psaní vlastních úloh a objektů přímo v databázi. Získali jsme možnost vybrat a přizpůsobit, pro urychlení, na kterých datových centrech provedeme výpočty a na kterých zápis dat, čímž jsme se zabezpečili vůči selhání jak jednotlivých uzlů, tak celkově datových center.
Při aplikaci na nové projekty naší architektury, přičemž již máme nějaké zkušenosti, bychom chtěli ihned vzít v úvahu výše uvedené nuance a vyhnout se některým chybám, zmírnit určité ostré hrany, kterým se ze začátku nedalo vyhnout.
Například, včas sledovat aktualizace samotné Cassandry, protože řada problémů, které jsme měli, již byla známá a řešila se.
Nesazovat jak samotnou databázi, tak Spark na stejné uzly ((nebo striktně rozdělovat podle množství povolené využití zdrojů), protože Spark může spotřebovat více RAM, než je povoleno, a rychle se dostaneme k problému číslo 1 z našeho seznamu.
Zlepšovat monitoring a dovednosti provozu již v testovací fázi projektu. Od začátku brát v úvahu co nejvíce všech potenciálních uživatelů našeho řešení, neboť právě od toho bude nakonec záviset struktura databáze.
Několikrát projít výslednou schématu z hlediska možné optimalizace. Vymezit, které pole lze serializovat. Pochopit, jaké další tabulky potřebujeme vytvořit, abychom co nejpřesněji a optimálně brali v úvahu a poté vraceli požadované informace (například s ohledem na to, že stejné údaje můžeme uchovávat v různých tabulkách, s ohledem na různé členění podle různých kritérií, můžeme výrazně šetřit procesorový čas při čtení dotazů).
Docela dobře ihned předpokládat přiřazení TTL a údržbu zastaralých dat.
Při exportu dat z Cassandry logika aplikace by měla fungovat na principu FETCH, aby se ne všechny řádky načítaly do paměti najednou, ale vybíraly se po dávkách.
Ideálně před převodem projektu na popisované řešení ověřit odolnost systému provedením série crash-testů, jako je ztráta dat v jednom datovém centru, obnova poškozených dat za určité období, pokles sítě mezi datovými centry. Takové testy umožní nejen posoudit výhody a nevýhody navrhované architektury, ale také poskytnou dobrou tréninkovou praxi pro inženýry, kteří je provádějí, a získané dovednosti nebudou nikdy na škodu, pokud dojde k selháním systémů v produkčním prostředí.
Pokud pracujeme s kritickými informacemi (jako jsou údaje pro fakturaci, výpočet dluhu zákazníka), je také důležité věnovat pozornost nástrojům, které umožňují snížit rizika vyplývající z charakteristiky DBMS. Například je vhodné použít utilitu nodesync (Datastax) a vypracovat optimální strategii jejího využití, aby se pro zachování konzistence nevytvářelo nadměrné zatížení na Cassandru. a používat ji pouze pro určité tabulky v určitých obdobích.
Tak co, po půl roce života s Cassandrou? Celkově není žádný nevyřešený problém. Závažné havárie a ztráty dat jsme také nezaznamenali. Ano, bylo třeba zamyslet se nad kompenzací některých dříve nevzniklých problémů, ale nakonec to zásadně neovlivnilo naše architektonické rozhodnutí. Pokud máte chuť a nebojíte se zkoušet něco nového, a přitom nechcete být příliš zklamáni, připravte se na to, že nic není zadarmo. Budete muset více studovat, ponořit se do dokumentace a shromáždit své vlastní individuální problémové situace, než u starého legacy řešení, a žádná teorie vám předem neřekne, jaké konkrétní překážky na vás čekají.
Zdroj: habr.com
