

Mnoho lidí používá specializované nástroje k vytváření procesů extrakce, transformace a načítání dat do relačních databází. Proces práce nástrojů je logován, chyby jsou zaznamenány.
V případě chyby obsahuje log informace o tom, že nástroji se nepodařilo úkol splnit a které moduly (často je to Java) zastavily proces. V posledních řádcích lze nalézt chybu databáze, například porušení unikátního klíče tabulky.
Abych odpověděl na otázku, jakou roli hraje informace o chybách ETL, klasifikoval jsem všechny problémy, které se vyskytly za poslední dva roky v poměrně velkém úložišti.
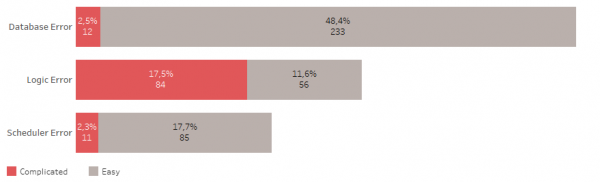
Mezi chyby databáze patří například nedostatek místa, přerušené spojení, zamrznutí relace a podobně.
Logickými chybami jsou například porušení klíčů tabulky, neplatné objekty, nedostatek přístupu k objektům a podobně.
Plánovač může být spuštěn v nesprávnou dobu, může zamrznout atd.
Jednoduché chyby nevyžadují mnoho času na opravu. Většinu z nich dobré ETL zvládá samo.
Složitější chyby vyžadují otevření a kontrolu datových procesů, zkoumání zdrojů dat. Často vedou k nutnosti testování změn a nasazení.
Takže polovina všech problémů je spojena s databází. 48 % všech chyb jsou jednoduché chyby.
Třetina všech problémů je spojena se změnou logiky nebo modelu úložiště, více než polovina těchto chyb je složitější.
A méně než čtvrtina všech problémů je spojena s plánovačem úloh, z nichž 18 % jsou jednoduché chyby.
Celkově 22 % všech vzniklých chyb je složitých, jejich oprava vyžaduje nejvíce pozornosti a času. Vyskytují se přibližně jednou týdně. Zatímco jednoduché chyby se vyskytují téměř každý den.
Je zřejmé, že monitorování procesů ETL bude efektivní, když bude v logu maximálně přesně uvedeno místo chyby a bude potřeba minimální čas na nalezení zdroje problému.
Efektivní monitorování
Co bych chtěl vidět v procesu monitorování ETL?
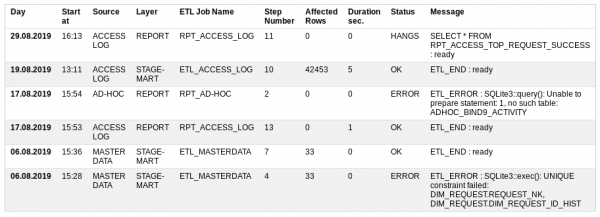
Start at — kdy začal pracovní proces,
Source — zdroj dat,
Layer — jaká úroveň úložiště je načítána,
ETL Job Name — procedura načítání, která se skládá z mnoha drobných kroků,
Step Number — číslo prováděného kroku,
Ovlivněné řádky — kolik dat už bylo zpracováno,
Doba trvání v sekundách — jak dlouho se provádí,
Stav — jestli je vše v pořádku nebo ne: OK, ERROR, RUNNING, HANGS
Zpráva — poslední úspěšná zpráva nebo popis chyby.
Na základě stavu záznamů lze poslat e-mail ostatním účastníkům. Pokud nejsou žádné chyby, e-mail není nutný.
Takže v případě chyby je jasně uvedeno místo události.
Někdy se stane, že samotný monitorovací nástroj nefunguje. V takovém případě je možné přímo v databázi vyvolat pohled (view), na jehož základě byl sestaven report.
Tabulka monitorování ETL
Pro realizaci monitorování ETL procesů postačí jedna tabulka a jeden pohled.
K tomu se můžeme vrátit do a vytvořit prototyp v databázi sqlite.
DDL tabulky
CREATE TABLE UTL_JOB_STATUS (
/* Tabulka pro zaznamenávání vykonání úloh. Důležité, aby úloha měla kroky ETL_START a ETL_END nebo ETL_ERROR */
  UTL_JOB_STATUS_ID INTEGER NOT NULL PRIMARY KEY AUTOINCREMENT,
  SID               INTEGER NOT NULL DEFAULT -1, /* Identifikátor relace. Unikátní pro každý běh úlohy */
  LOG_DT            INTEGER NOT NULL DEFAULT 0,  /* Datum a čas */
  LOG_D             INTEGER NOT NULL DEFAULT 0,  /* Datum */
  JOB_NAME          TEXT NOT NULL DEFAULT 'N/A', /* Název úlohy, jako JOB_STG2DM_GEO */
  STEP_NAME         TEXT NOT NULL DEFAULT 'N/A', /* ETL_START, ... , ETL_END/ETL_ERROR */
  STEP_DESCR        TEXT,                        /* Popis úkolu nebo zprávy o chybě */
  UNIQUE (SID, JOB_NAME, STEP_NAME)
);
INSERT INTO UTL_JOB_STATUS (UTL_JOB_STATUS_ID) VALUES (-1);
DDL pohledu/reportu
VYTVÁŘEJTE VIZUALIZACI, POKUD NEEXISTUJE UTL_JOB_STATUS_V
JAKO
/* Obsah: Protokol provádění balíčku za poslední 3 měsíce. */
S SRC JAKO (
  VYBERTE LOG_D,
    LOG_DT,
    UTL_JOB_STATUS_ID,
    SID,
	PŘÍPAD KDY INSTR(JOB_NAME, 'FTP') POTOM 'TRANSFER' /* přenos souboru */
	     KDY INSTR(JOB_NAME, 'STG') POTOM 'STAGE' /* fáze */
	     KDY INSTR(JOB_NAME, 'CLS') POTOM 'CLEANSING' /* úprava dat */
	     KDY INSTR(JOB_NAME, 'DIM') POTOM 'DIMENSION' /* dimenze */
	     KDY INSTR(JOB_NAME, 'FCT') POTOM 'FACT' /* fakt */
		 KDY INSTR(JOB_NAME, 'ETL') POTOM 'STAGE-MART' /* datový trh */
	     KDY INSTR(JOB_NAME, 'RPT') POTOM 'REPORT' /* zpráva */
	     JINAK 'N/A' KONEC JAKO VRSTVA,
	PŘÍPAD KDY INSTR(JOB_NAME, 'ACCESS') POTOM 'ACCESS LOG' /* zdroj */
	     KDY INSTR(JOB_NAME, 'MASTER') POTOM 'MASTER DATA' /* zdroj */
	     KDY INSTR(JOB_NAME, 'AD-HOC') POTOM 'AD-HOC' /* zdroj */
	     JINAK 'N/A' KONEC JAKO ZDROJ,
    JOB_NAME,
    STEP_NAME,
    PŘÍPAD KDY STEP_NAME='ETL_START' POTOM 1 JINAK 0 KONEC JAKO START_FLAG,
    PŘÍPAD KDY STEP_NAME='ETL_END' POTOM 1 JINAK 0 KONEC JAKO END_FLAG,
    PŘÍPAD KDY STEP_NAME='ETL_ERROR' POTOM 1 JINAK 0 KONEC JAKO ERROR_FLAG,
    STEP_NAME || ' : ' || STEP_DESCR JAKO STEP_LOG,
	SUBSTR( SUBSTR(STEP_DESCR, INSTR(STEP_DESCR, '***')+4), 1, INSTR(SUBSTR(STEP_DESCR, INSTR(STEP_DESCR, '***')+4), '***')-2 ) JAKO AFFECTED_ROWS
  Z UTL_JOB_STATUS
  KDE datetime(LOG_D, 'unixepoch') >= date('now', 'start of month', '-3 month')
)
VYBERTE JB.SID,
  JB.MIN_LOG_DT JAKO START_DT,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MIN_LOG_DT, 'unixepoch')) JAKO LOG_DT,
  JB.SOURCE,
  JB.LAYER,
  JB.JOB_NAME,
  PŘÍPAD
  KDY JB.ERROR_FLAG = 1 POTOM 'CHYBA'
  KDY JB.ERROR_FLAG = 0 A JB.END_FLAG = 0 A strftime('%s','now') - JB.MIN_LOG_DT > 0.5*60*60 POTOM 'ZAVISÍ' /* půl hodiny */
  KDY JB.ERROR_FLAG = 0 A JB.END_FLAG = 0 POTOM 'PROBÍHÁ'
  JINAK 'OK'
  KONEC JAKO STATUS,
  ERR.STEP_LOG     JAKO STEP_LOG,
  JB.CNT           JAKO STEP_CNT,
  JB.AFFECTED_ROWS JAKO AFFECTED_ROWS,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MIN_LOG_DT, 'unixepoch')) JAKO JOB_START_DT,
  strftime('%d.%m.%Y %H:%M', datetime(JB.MAX_LOG_DT, 'unixepoch')) JAKO JOB_END_DT,
  JB.MAX_LOG_DT - JB.MIN_LOG_DT JAKO JOB_DURATION_SEC
Z
  ( VYBERTE SID, SOURCE, LAYER, JOB_NAME,
           MAX(UTL_JOB_STATUS_ID) JAKO UTL_JOB_STATUS_ID,
           MAX(START_FLAG)       JAKO START_FLAG,
           MAX(END_FLAG)         JAKO END_FLAG,
           MAX(ERROR_FLAG)       JAKO ERROR_FLAG,
           MIN(LOG_DT)           JAKO MIN_LOG_DT,
           MAX(LOG_DT)           JAKO MAX_LOG_DT,
           SUM(1)                JAKO CNT,
           SUM(IFNULL(AFFECTED_ROWS, 0)) JAKO AFFECTED_ROWS
    Z SRC
    SKUPINA PODLE SID, SOURCE, LAYER, JOB_NAME
  ) JB,
  ( VYBERTE UTL_JOB_STATUS_ID, SID, JOB_NAME, STEP_LOG
    Z SRC
    KDE 1 = 1
  ) ERR
KDE 1 = 1
  A JB.SID = ERR.SID
  A JB.JOB_NAME = ERR.JOB_NAME
  A JB.UTL_JOB_STATUS_ID = ERR.UTL_JOB_STATUS_ID
OBJEDNÁVAJTE PODLE JB.MIN_LOG_DT DESC, JB.SID DESC, JB.SOURCE;
SQL Zkontrolujte možnost získání nového čísla relace
VYBERTE SUMU (
  PŘÍPAD KDY start_job.JOB_NAME NENÍ NULL A end_job.JOB_NAME JE NULL /* existující úloha skončila */
	    A NE ('y' = 'n') /* parametrem pro vynucení restartu */
       POTOM 1 JINAK 0
  KONEC ) JAKO IS_RUNNING
  Z
    ( VYBERTE 1 JAKO dummy Z UTL_JOB_STATUS KDE sid = -1) d_job
  LEVÝ EXTERNÍ JOIN
    ( VYBERTE JOB_NAME, SID, 1 JAKO dummy
      Z UTL_JOB_STATUS
      KDE JOB_NAME = 'RPT_ACCESS_LOG' /* jméno úlohy PARAMETRU */
	    A STEP_NAME = 'ETL_START'
      SKUPINA PODLE JOB_NAME, SID
    ) start_job /* začátky */
  NA d_job.dummy = start_job.dummy
  LEVÝ EXTERNÍ JOIN
    ( VYBERTE JOB_NAME, SID
      Z UTL_JOB_STATUS
      KDE JOB_NAME = 'RPT_ACCESS_LOG'  /* jméno úlohy PARAMETRU */
	    A STEP_NAME IN ('ETL_END', 'ETL_ERROR') /* stav zastavení */
      SKUPINA PODLE JOB_NAME, SID
    ) end_job /* konce */
  NA start_job.JOB_NAME = end_job.JOB_NAME
     A start_job.SID = end_job.SID
Vlastnosti tabulky:
- Začátek a konec procesu zpracování dat musí být doprovázen kroky ETL_START a ETL_END
- V případě chyby musí být vytvořen krok ETL_ERROR s jejím popisem
- Počet zpracovaných dat je třeba vyznačit, například hvězdičkami
- Stejný proces lze současně spustit s parametrem force_restart=y, bez něj se číslo relace vrací pouze dokončenému procesu
- V běžném režimu nelze paralelně spustit stejný proces zpracování dat
Nezbytné operace práce s tabulkou jsou následující:
- Získání čísla relace spouštěného procesu ETL
- Vložení záznamu protokolu do tabulky
- Získání posledního úspěšného záznamu procesu ETL
V takových databázích, jako je například Oracle nebo Postgres, lze tyto operace realizovat vestavěnými funkcemi. Pro SQLite je potřeba externí mechanismus a ten je v tomto případě .
Výstup
Tímto způsobem hrají zprávy o chybách v nástrojích pro zpracování dat mega-důležitou roli. Ale optimální pro rychlé nalezení příčiny problémů je těžko nazvat. Když počet procedur dosahuje stovky, monitoring procesů se stává složitým projektem.
V článku je uveden příklad možného řešení problému ve formě prototypu. Celý prototyp malého úložiště je dostupný na gitlabu .
Zdroj: habr.com
