

Zdroj:
Lineární regrese je jedním z základních algoritmů pro mnoho oblastí spojených s analýzou dat. Důvod je jasný. Je to velmi jednoduchý a srozumitelný algoritmus, což přispívá k jeho širokému využívání již po desítky, ne-li stovky let. Myšlenka spočívá v předpokladu lineární závislosti jedné proměnné na souboru dalších proměnných, a pak se pokoušíme tuto závislost obnovit.
V tomto článku se však nebudeme zabývat aplikací lineární regrese pro řešení praktických úloh. Budeme se věnovat zajímavým rysům implementace distribuovaných algoritmů pro její obnovu, se kterými jsme se setkali při psaní modulu strojového učení v . Trocha základní matematiky, principů strojového učení a distribuovaných výpočtů pomůže objasnit, jak obnovit lineární regresi, i když jsou data rozdělena mezi tisíce uzlů.
O čem je řeč?
Stojíme před úkolem obnovit lineární závislost. Jako vstupní data máme množství vektorů údajně nezávislých proměnných, přičemž každému z nich je přiřazena hodnota závislé proměnné. Tato data lze představit ve formě dvou matic:

Nyní, když předpokládáme závislost, a navíc ještě lineární, zapíšeme naši domněnku ve formě součinu matic (pro zjednodušení zápisu se zde a dále předpokládá, že volný člen rovnice je skryt za  , a poslední sloupec matice
 obsahuje jedničky):

Velmi to připomíná systém lineárních rovnic, že? Připomíná, ale řešení tohoto systému rovnic pravděpodobně neexistuje. Příčinou je šum, který se vyskytuje téměř v každých reálných datech. Také důvodem může být absence lineární závislosti jako takové, s níž lze bojovat zavedením dalších proměnných, které nelineárně závisí na původních. Zvažme následující příklad:
Zdroj:
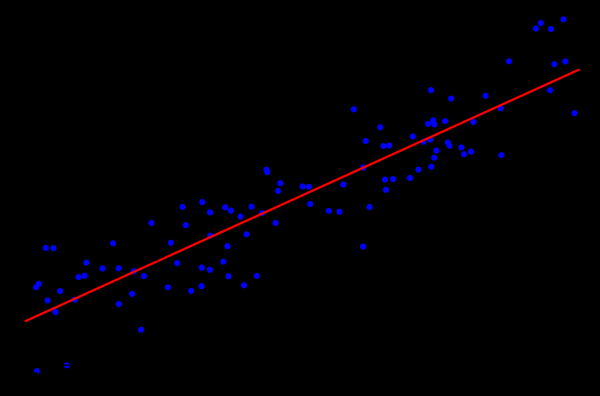
Jedná se o jednoduchý příklad lineární regrese, který demonstruje závislost jedné proměnné (na ose  ) na druhé proměnné (na ose
 ). Aby uvedený systém lineárních rovnic měl řešení, musí ležet všechny body přesně na jedné přímce. Ale to tak není. A neleží na jedné přímce právě kvůli šumu (nebo kvůli tomu, že předpoklad o existenci lineární závislosti byl chybný). Takže k obnovení lineární závislosti na skutečných datech je obvykle nutné zavést ještě jeden předpoklad: vstupní údaje obsahují šum a tento šum má . Lze činit předpoklady i o jiných typech rozdělení šumu, ale ve většině případů se zvažuje právě normální rozdělení, o kterém bude dále řeč.
Metoda maximální věrohodnosti
Takže jsme předpokládali přítomnost náhodného normálně rozděleného šumu. Jak se tedy v této situaci chovat? Na to existuje a je široce využívána v matematice . Stručně řečeno, její podstatou je výběr a její následná maximalizace.
Vraťme se k obnovení lineární závislosti na datech se normálním šumem. Všimněme si, že předpokládaná lineární závislost je matematickým očekáváním  existujícího normálního rozdělení. Zároveň je pravděpodobnost, že
 nabývá určité hodnoty, za předpokladu, že existují pozorované
 , vypadá následovně:

Nyní dosadíme místo  a
 nám potřebné proměnné:

Zbývá pouze najít vektor  , při kterém je tato pravděpodobnost maximální. Abychom takovou funkci maximalizovali, je pohodlné nejprve ji zlogaritmovat (logaritmus funkce dosáhne maxima ve stejné lokaci jako samotná funkce):

Což se zase shrnuje na minimalizaci následující funkce:

Mimochodem, tomu se říká metoda . Často jsou všechny výše uvedené úvahy opomenuty a jednoduše se tento metoda používá.
QR rozklad
Minimum uvedené funkce lze nalézt, pokud najdeme bod, ve kterém je gradient této funkce roven nule. A gradient bude zapsán následujícím způsobem:

je maticovou metodou řešení úlohy minimalizace používanou v metodě nejmenších čtverců. V tomto ohledu přepíšeme rovnici v maticovém tvaru:

Takže rozkládáme matici  na matice
 a
 a provádíme řadu transformací (samotný algoritmus QR rozkladu zde bude projednán jen okrajově, pouze jeho využití v souvislosti s daným úkolem):

Matice  je ortogonální. To nám umožňuje zbavit se součinu
 :

A pokud nahradíme  na
 , vyjde
 . Vzhledem k tomu, že
 je horní trojúhelníková matice, vypadá to následovně:

Toto lze řešit pomocí substituční metody. Prvek  se nachází jako
 , předchozí prvek
 se nachází jako
 a tak dále.
Zde je třeba poznamenat, že složitost výsledného algoritmu díky použití QR rozkladu je rovna  . Přitom, i když operace násobení matic je dobře paralelizovatelná, napsat efektivní distribuovanou verzi tohoto algoritmu se nezdá možné.
Gradientní spád
Když hovoříme o minimalizaci určité funkce, vždy stojí za to vzpomenout na metodu (stochastického) gradientního spádu. Je to jednoduchá a efektivní metoda minimalizace, založená na iterativním výpočtu gradientu funkce v bodě a následném posunu směrem, který je opačný k gradientu. Každý takový krok přibližuje řešení k minimu. Gradient vypadá stále takto:

Tato metoda je také dobře paralelizovatelná a distribuovatelná díky lineárním vlastnostem operátora gradientu. Všimněme si, že ve výše uvedeném vzorci pod symbolem sumy jsou nezávislé členy. Jinými slovy, můžeme vypočítat gradient nezávisle pro všechny indexy  od prvního do
 , současně lze vypočítat gradient pro indexy od
 do
 . Pak se sečtou získané gradienty. Výsledkem sčítání bude stejný, jako kdybychom okamžitě vypočítali gradient pro indexy od prvního do
 . Tímto způsobem, pokud jsou data rozdělena mezi několik částí dat, může být gradient vypočítán nezávisle na každé části, a poté mohou být výsledky těchto výpočtů sečteny, aby se získal konečný výsledek:

Z hlediska implementace se to vejde do paradigmatu . V každém kroku gradientního spádu je každému uzlu dat zaslána úloha pro výpočet gradientu, poté jsou vypočítané gradienty shromážděny dohromady a výsledek jejich sčítání se využívá k vylepšení výsledku.
I když je implementace jednoduchá a umožňuje provádění v paradigmatu MapReduce, gradientní sestup má také své nevýhody. Obzvláště počet kroků potřebných k dosažení konvergence je značně vyšší ve srovnání s jinými, více specializovanými metodami.
LSQR
je další metoda řešení daného úkolu, která je vhodná jak pro obnovu lineární regrese, tak pro řešení systémů lineárních rovnic. Jejím hlavním rysem je, že kombinuje výhody maticových metod a iterativního přístupu. Implementace této metody lze najít v knihovně , tak i v . Popis této metody zde nebude uveden (můžete jej nalézt v článku ). Místo toho bude demonstrován přístup, který umožňuje přizpůsobit LSQR pro provádění v distribuovaném prostředí.
Základem metody LSQR je . To je iterativní procedura, jejíž každá iterace se skládá z následujících kroků:
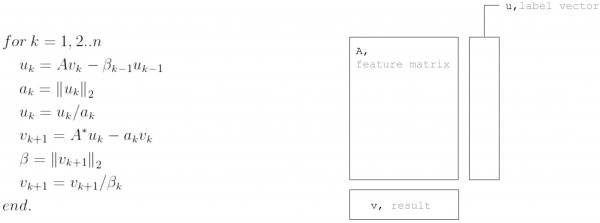
Pokud však vycházíme z toho, že matice je horizontálně partitionována, pak každou iteraci lze představit jako dva kroky MapReduce. Tímto způsobem se daří minimalizovat přenos dat během každé z iterací (pouze vektory o délce odpovídající počtu neznámých):  Právě tento přístup se používá při implementaci lineární regrese v
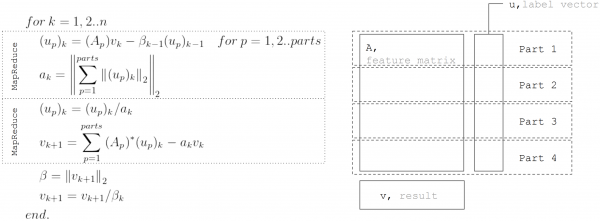
Apache Ignite ML .
Závěr
🥇Lineární regrese a metody její obnovy | ProHoster
Zdroj: habr.com
