

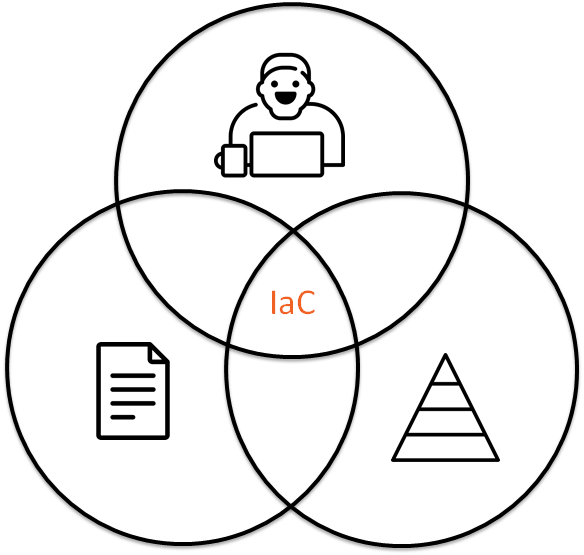
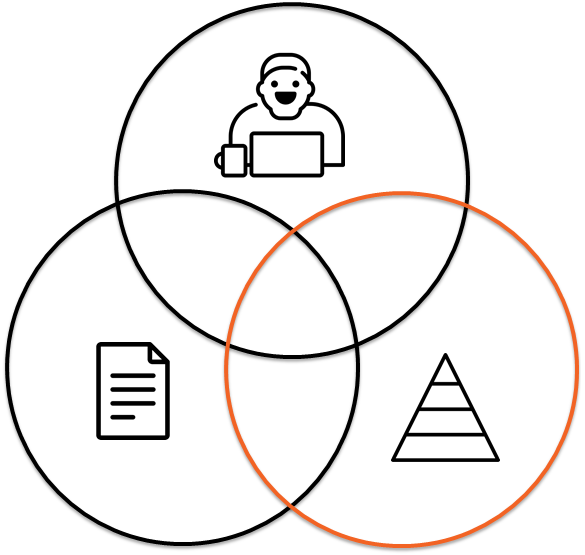
Přístup IaC (Infrastructure as Code) se neomezuje pouze na kód uložený v repozitáři, ale také na lidi a procesy, které tento kód obklopují. Můžeme aplikovat přístupy ze softwarového vývoje na správu a popis infrastruktury? Bude užitečné mít tuto myšlenku na paměti, když budete číst článek.
Tohle je přepis mého na .
Prezentace a videa
- Dry run 2019-04-24
Infrastruktura jako bash historie
Představte si, že přicházíte na nový projekt a říkají vám: „Máme tu Infrastruktura jako kód“. Ve skutečnosti se ukáže, Infrastruktura jako bash historie nebo například Dokumentace jako bash historie. To je zcela reálná situace, podobný případ popisoval Denis Lysenko ve svém vystoupení , vysvětlil, jak z bash historie získali přehlednou infrastrukturu na projektu.
S určitou soudržností lze říci, že Infrastruktura jako bash historie je jako kód:
- reprodukovatelnost: můžete vzít bash historii, provést příkazy z ní a možná, mimochodem, dostanete funkční konfiguraci na výstupu.
- verzování: víte, kdo se přihlásil a co dělal, opět však není jisté, že vás to dovede k funkční konfiguraci na výstupu.
- historie: příběh o tom, kdo a co provedl. pouze to nebudete moci využít, pokud ztratíte server.
Co dělat?
Infrastruktura jako kód
I tak zvláštní případ jako Infrastruktura jako bash historie můžete vztáhnout na Infrastruktura jako kód, ale když se pokusíme udělat něco složitějšího než starý dobrý LAMP server, dojdeme k tomu, že tento kód je třeba nějak modifikovat, měnit, upravovat. Dále budeme zvažovat paralely mezi Infrastruktura jako kód a vývojem softwaru.
D.R.Y.
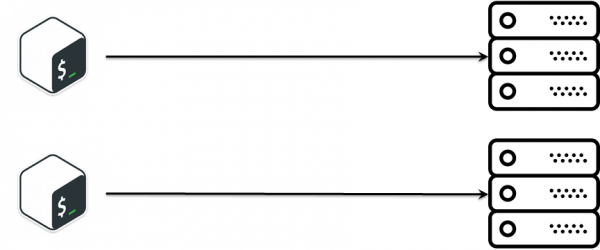
Na projektu pro vývoj úložišť dat bylo podúkoly : vydáváme nový release — je třeba ho nasadit pro další testování. Úkol je velmi jednoduchý:
- zde se přihlaste přes ssh a proveďte příkaz.
- tam zkopírujte soubor.
- tady upravte konfiguraci.
- tam spusťte službu.
- …
- ZISK!
Pro popsanou logiku je více než dostatečný bash, zvláště v počátečních fázích projektu, kdy se teprve rozjíždí. To je , ale časem přicházejí žádosti o rozšíření něčeho podobného, ale trochu odlišného. První věc, která nás napadne: copy-paste. A už máme dva velmi podobné skripty, které dělají téměř to samé. Časem se počet skriptů zvýšil a narazili jsme na to, že existuje určitá obchodní logika nasazení, kterou je třeba synchronizovat mezi různými skripty, což je poměrně složité.
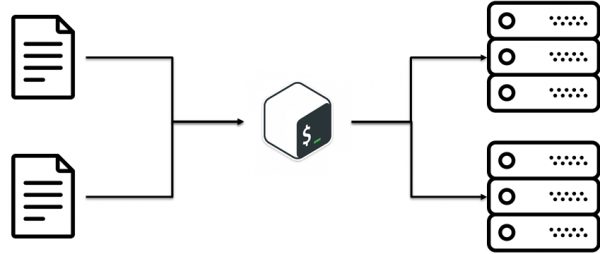
Ukazuje se, že existuje taková praxe D.R.Y. (Nepořádej se). Myšlenka spočívá v opětovném využití existujícího kódu. Zní to jednoduše, ale k tomu jsme nedošli hned. V našem případě to byla banální myšlenka: oddělit konfigurace od skriptů. Tedy obchodní logika, jak se nasazení provádí, zvlášť, konfigurace zvlášť.
S.O.L.I.D. pro CFM
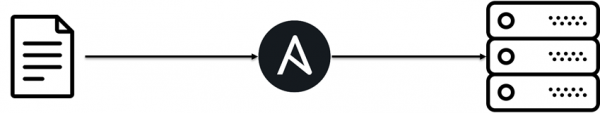
Časem projekt rostl a se stalo vznikání Ansible. Hlavním důvodem vzniku byl dostatek odbornosti v týmu a to, že bash není určen pro složitou logiku. Ansible také začal obsahovat složitou logiku. Aby se složitá logika nestala chaosem, v návrhu softwaru existují principy organizace kódu. S.O.L.I.D. Také například Grigorij Petrov ve svém referátu "Proč by měl IT specialista mít osobní značku" zmínil, že člověk je takto nastaven, že mu dává smysl operovat s určitými sociálními entitami, v návrhu softwaru jsou to objekty. Pokud tyto dvě myšlenky spojíme a budeme je dále rozvíjet, můžeme si všimnout, že i v popisu infrastruktury je možné využívat S.O.L.I.D. aby bylo v budoucnu snazší tuto logiku udržovat a modifikovat.
Princip jediného odpovědnosti
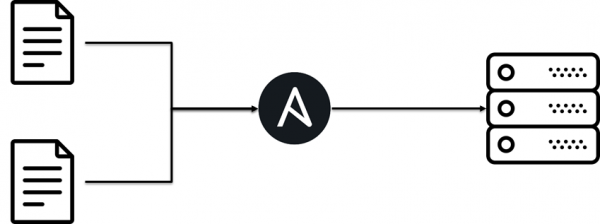
Každá třída vykonává pouze jeden úkol.
Není třeba míchat kód a vytvářet monolitní božské makaróny. Infrastruktura by měla sestávat z jednoduchých bloků. Ukazuje se, že pokud rozdělíme Ansible playbook na malé kousky, čti Ansible role, je jednodušší je udržovat.
Otevřený a uzavřený princip
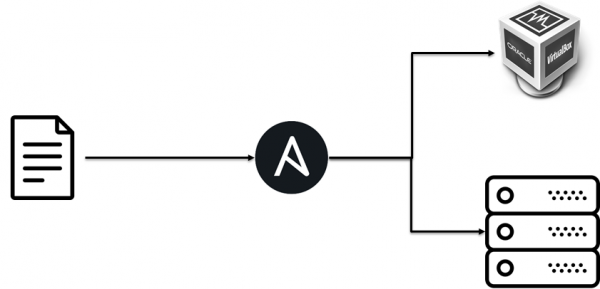
Princip otevřenosti/uzavřenosti.
- Jsou otevřeny k rozšíření: znamená to, že chování entity může být rozšířeno vytvořením nových typů entit.
- Jsou uzavřený pro změny: v důsledku rozšíření chování entity by neměly být prováděny změny v kódu, který tyto entity využívá.
Původně jsme nasadili testovací infrastrukturu na virtuálních strojích, ale díky tomu, že obchodní logika nasazení byla oddělena od implementace, jsme bez problémů přidali nasazení na bare metal.
Liskovův substituční princip
Princip substituce Barbary Liskov. objekty v programu by měly být zaměnitelné za instance jejich podtypů bez změny správnosti provádění programu
Pokud se podíváme široce, tak to není specifikum nějakého konkrétního projektu, kam to lze aplikovat S.O.L.I.D., je to obecně o CFM, například v jiném projektu je třeba nasadit krabicovou Java aplikaci na různé Java servery aplikací, databáze, operační systémy atd. Na tomto příkladu budu zvažovat další principy S.O.L.I.D.
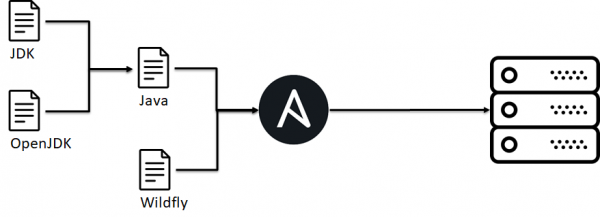
V našem případě v rámci infrastrukturního týmu platí dohoda, že pokud jsme nainstalovali roli imbjava nebo oraclejava, máme binární spustitelný soubor java. To je potřeba, protože vyšší role na tomto chování závisí, očekávají přítomnost java. Zároveň nám to umožňuje měnit jednu implementaci/verzi java na jinou, aniž bychom měnili logiku nasazení aplikace.
Problém spočívá v tom, že v Ansible nelze implementovat takové věci, jako důsledek se v týmu objevují určité dohody.
Princip segregace rozhraní
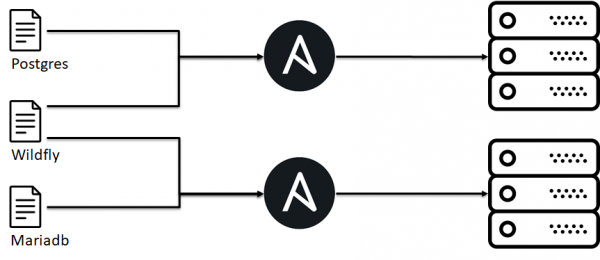
Princip rozdělení rozhraní „více rozhraní, speciálně navržených pro klienty, je lepší než jedno univerzální rozhraní.
Původně jsme se snažili soustředit veškerou variabilitu nasazení aplikace do jednoho Ansible playbooku, ale bylo to těžké na údržbu, a přístup, kdy máme specifikované rozhraní venku (klient očekává port 443), nám umožňuje skládat infrastrukturu z jednotlivých bloků pro konkrétní implementaci.
Princip inverze závislostí
Princip inverze závislostí. Moduly vyšších úrovní by neměly záviset na modulech nižších úrovní. Oba typy modulů by měly záviset na abstrakcích. Abstrakce by neměly záviset na detailech. Detaily by měly záviset na abstrakcích.
Tento příklad bude založen na antipatternu.
- U jednoho z klientů bylo soukromé cloudové řešení.
- Uvnitř cloudového prostředí jsme objednávali virtuální stroje.
- Ale vzhledem k charakteristikám cloudu bylo nasazení aplikace vázáno na to, na jaký hypervizor VM přišla.
To znamená, že vysoceúrovňová logika nasazení aplikace, která závisela na nižších úrovních hypervisoru, znamenala problémy při opětovném použití této logiky. Nedělejte to.
Interakce
Infrastruktura jako kód není jen o kódu, ale také o vztazích mezi kódem a člověkem, o interakcích mezi vývojáři infrastruktury.
Bus factor
Představme si, že máte ve svém projektu Vašu. Vše ví o vaší infrastruktuře, co se stane, když Vaša náhle zmizí? To je zcela reálná situace, neboť ho může srazit autobus. Někdy se to stává. Pokud dojde k tomu, že znalosti o kódu, jeho struktuře, jak funguje, přihlašovacích údajích a heslech, nejsou rozprostřeny v týmu, můžete se setkat s řadou nepříjemných situací. Aby se tyto rizika minimalizovala a znalosti se rozprostřely v rámci týmu, lze použít různé přístupy.
Párové Devopsing
Není to jako , že administrátoři pili pivo, měnili hesla, a analogie párového programování. Tedy dva inženýři si sednou k jednomu počítači, jedné klávesnici a začnou společně nastavovat vaši infrastrukturu: nastavovat server, psát roli Ansible atd. Zní to hezky, ale nám to nefungovalo. Ale občasné případy této praxe pracovaly. Přišel nový zaměstnanec, jeho mentor s ním vezme skutečný úkol, pracují — předávají znalosti.
Další výjimečný případ je incident call. Během problému se shromáždí skupina pohotovostních pracovníků a zainteresovaných, je vybrán jeden vedoucí, který sdílí svou obrazovku a oznamuje tok myšlenek. Ostatní účastníci sledují myšlenku vedoucího, nahlížejí na triky z konzole, kontrolují, zda něco nezapomněli v logu, dozvídají se nové informace o systému. Tento přístup spíše fungoval, než ne.
Code Review
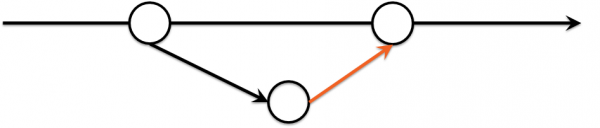
Subjektivně, nejefektivnější šíření znalostí o infrastruktuře a o tom, jak je uspořádána, probíhalo prostřednictvím code review:
- Infrastruktura je popsána kódem v repozitáři.
- Změny probíhají v samostatné větvi.
- Při žádosti o sloučení můžete vidět delta změn infrastruktury.
Zajímavostí bylo, že recenzenti byli vybíráni po sobě jdoucím způsobem, podle plánu, tj. s určitou pravděpodobností se dostanete do nového úseku infrastruktury.
Styl kódu
S postupem času se začaly objevovat neshody během revizí, protože revizoři měli každý svůj styl a rotace revizorů je srovnávala s různými styly: 2 mezery nebo 4, camelCase nebo snake_case. Zavedly se to hned nešlo.
- První myšlenka byla doporučit používat linter, protože všichni inženýři jsou přece chytří. Ale různé editory a operační systémy to dělaly nepohodlné.
- To se vyvinulo v bota, který posílal zprávy do Slacku při každém problematickém commitu a přikládal výstupy linteru. Většinou se ale našly důležitější úkoly a kód zůstal neopravený.
Green Build Master
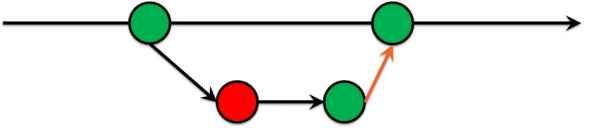
Čas běží a dostali jsme se k tomu, že nemůžeme povolit commity do masteru, které neprocházejí určitými testy. A máme! Vynalezli jsme Green Build Master, který se už dlouho praktikuje ve vývoji software:
- Vývoj probíhá v samostatné větvi.
- V této větvi se spouští testy.
- Pokud testy neprojdou, kód se nedostane do masteru.
Přijetí tohoto rozhodnutí bylo velmi bolestivé, protože vyvolalo mnoho diskuzí, ale stálo to za to, protože na revizích začaly přicházet žádosti o sloučení bez sporů ohledně stylu a časem se počet problematických míst začal snižovat.
IaC Testing
Kromě kontroly stylu lze použít i jiné věci, například zkontrolovat, že vaše infrastruktura se skutečně může nasadit. Nebo zkontrolovat, že změny v infrastruktuře nepovedou k ztrátě peněz. Proč by to mohlo být potřeba? To je složitá a filozofická otázka, lépe na ni odpovědět příběhem: kdysi byl auto-scaler na PowerShell, který neověřoval okrajové podmínky => vytvořil víc VM, než bylo potřeba => klient utratil víc, než plánoval. Nic příjemného, ale tuto chybu bylo možné odhalit v mnohem dřívějších fázích.
Můžete se zeptat, proč dělat složitou infrastrukturu ještě složitější? Testy pro infrastrukturu, stejně jako pro kód, nejsou o zjednodušení, ale o tom, vědět, jak vaše infrastruktura má fungovat.
IaC Testing Pyramid
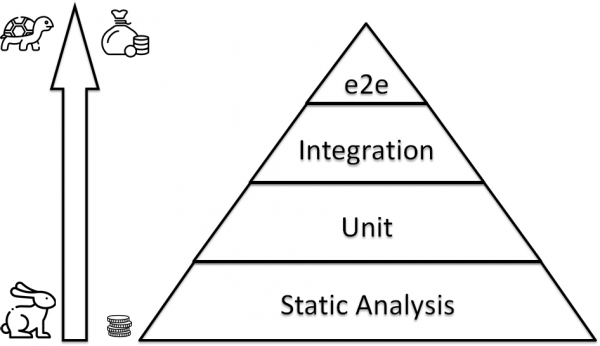
IaC Testing: Statická analýza
Pokud hned nasadíte celou infrastrukturu a zkontrolujete, že funguje, může se ukázat, že to trvá spoustu času a vyžaduje hodně zdrojů. Proto by mělo být něco rychle fungujícího, co je ho spousta a pokrývá mnoho primitivních míst.
Bash je ošidný
Podívejme se na banální příklad. Vybrat všechny soubory v aktuálním adresáři a zkopírovat je na jiné místo. První, co mě napadne:
for i in * ; do
    cp $i /some/path/$i.bak
done
A co když je v názvu souboru mezera? No dobře, jsme chytří, umíme používat uvozovky:
for i in * ; do cp "$i" "/some/path/$i.bak" ; doneSkvělá práce? Ne! Co když v adresáři není nic, tj. globbing nefunguje.
find . -type f -exec mv -v {} dst/{}.bak ;Teď už jste skvělí? Ne… Zapomněli jste, že v názvu souboru může být n.
touch x
mv x "$(printf "foonbar")"
find . -type f -print0 | xargs -0 mv -t /path/to/target-dir
Nástroje pro statickou analýzu
Problém z předchozího kroku bylo možné zachytit, když jsme zapomněli uvozovky, pro to existuje mnoho nástrojů. , všeho je hodně a pravděpodobně si pro svou IDE najdete linter pro svůj stack.
Jazyk
Nástroj
bash
Ruby
python
ansible
Testing IaC: Jednotkové testy
Jak jsme viděli z předchozího příkladu, lintery nejsou všemocné a nemohou ukázat na všechna problematická místa. Dále, analogicky k testování v softwarovém vývoji, si můžeme vzpomenout na jednotkové testy. Hned mě napadá , , , . Ale co s ansible, chef, saltstack a podobně?
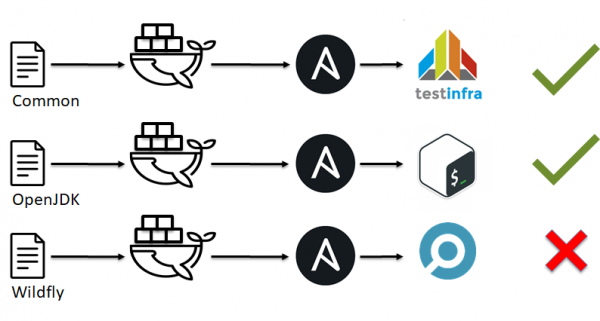
Na začátku jsme mluvili o tom, že naše infrastruktura by měla být složena z malých kostiček. Teď přišel jejich čas. S.O.L.I.D. Infrastruktura se rozpadá na malé kostičky, například Ansible role.
- Nastaví se nějaké prostředí, ať už docker nebo VM.
- Na toto testovací prostředí aplikujeme naši Ansible roli.
- Ověříme, že vše fungovalo, jak očekáváme (provozem testů).
- Rozhodujeme, zda je to v pořádku nebo ne.
- Testing IaC: Nástroje pro jednotkové testování
Otázka, co jsou testy pro CFM? Můžete jednoduše spustit skript, nebo můžete použít hotová řešení pro to:
CFM
Testinfra
Nástroj
Ansible
Chef
Chef
Goss
test1 test2, existují a patří do skupiny sshusers def test_default_users(host): users = ['test1', 'test2' ] for login in users: assert host.user(login).exists assert 'sshusers' in host.user(login).groups:
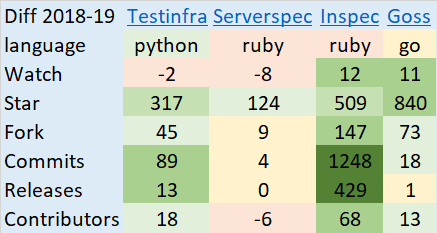
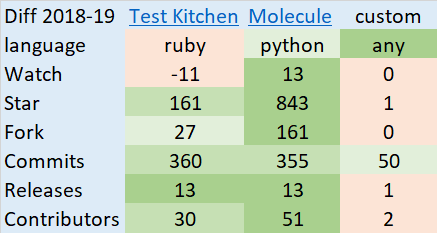
Co vybrat? Otázka je složitá a nejednoznačná, tady je příklad změn v projektech na githubu za roky 2018–2019:Rámce pro testování IaC
Jak to vše spojit a spustit? Můžete
vzít a udělat všechno sami Test Kitchen
Testinfra
Nástroj
Ansible
Chef
Terraform
Molecule vs. Testkitchen
Zpočátku jsme
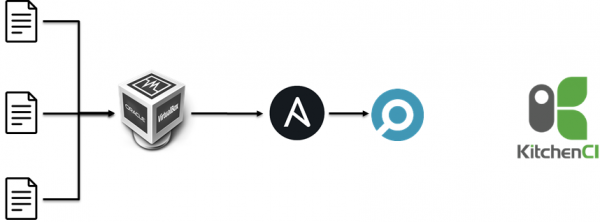
se pokusili použít testkitchen :
- Pro vytvoření VM paralelně.
- Použít Ansible role.
- Spustit inspec.
Pro 25-35 rolí to trvalo 40-70 minut, což bylo dlouhé.
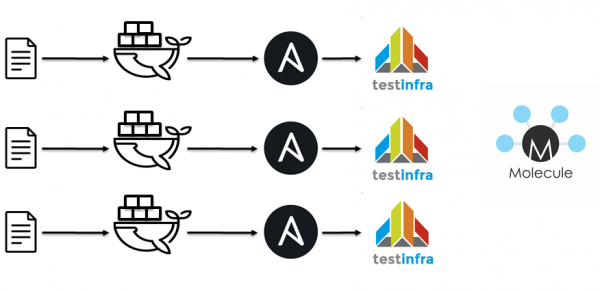
Dalším krokem byl přechod na jenkins / docker / ansible / molecule. Ideologicky je to vše stejné.
- Prolintovat playbooky.
- Prolintovat role.
- Spustit kontejner.
- Použít Ansible role.
- Spustit testinfra.
- Zkontrolovat idempotentnost.
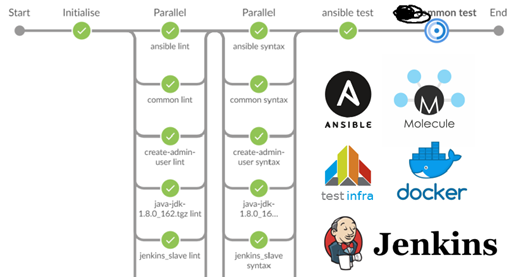
Lintování pro 40 rolí a testy pro desítku zabraly přibližně 15 minut.
Co vybrat závisí na mnoha faktorech, jako je použitý stack, odbornost v týmu atd. Každý si zde sám rozhoduje, jak řešit otázku unit testování.
IaC Testing: Integrační testy.
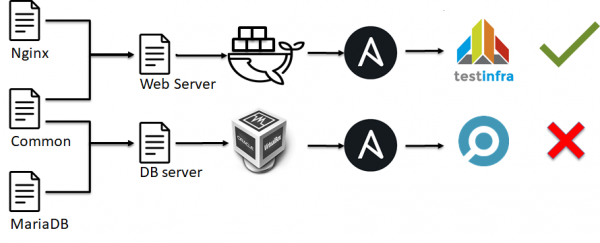
Na další úrovni pyramidy testování infrastruktury se objevují integrační testy. Ty jsou podobné unit testům:
- Infrastruktura je rozdělena na malé kostičky, například Ansible role.
- Na toto testovací prostředí aplikujeme naši Ansible roli.
- Na tuto testovací prostředí se aplikují objevilo mnoho Ansible role.
- Kontrolujeme, že vše proběhlo, jak očekáváme (spouštíme testy).
- Testing IaC: Nástroje pro jednotkové testování
Stručně řečeno, nekontrolujeme funkčnost jednotlivého prvku systému, jako v unit testech, ale ověřujeme, jak je server nakonfigurován jako celek.
IaC Testing: End to End testy.
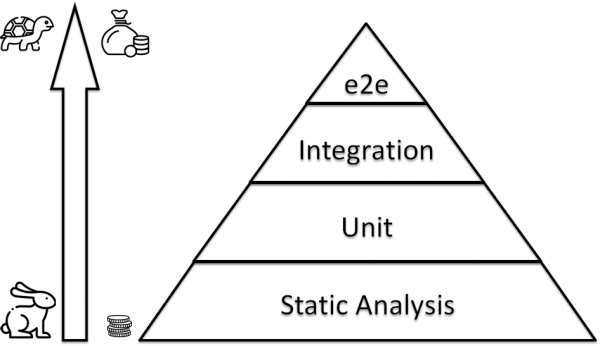
Na vrcholu pyramidy nás čekají end to end testy. Tedy nekontrolujeme funkčnost jednotlivého serveru, jednotlivého skriptu, jednotlivé kostičky naší infrastruktury. Ověřujeme, že množství serverů spojujících se do jednoho, naše infrastruktura funguje, jak očekáváme. Bohužel jsem neviděl hotová krabicová řešení, pravděpodobně proto, že infrastruktura je často unikátní a těžko ji šablonizovat a vytvořit rámec pro její testování. Výsledkem je, že si každý vytváří svá vlastní řešení. Poptávka je, ale odpovědí není. Proto povím, co existuje, abych inspiroval ostatní ke zdravému uvažování nebo mě navedl k tomu, že všechno bylo dávno vynalezeno.
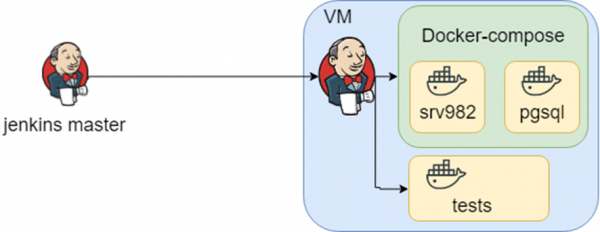
Projekt s bohatou historií. Používá se ve velkých organizacích a pravděpodobně se každý z vás s ním nějakým způsobem setkal. Aplikace podporuje mnoho databází, integrací atd. Znalost toho, jak může infrastruktura vypadat, to je množství docker-compose souborů, a znalost toho, jaké testy spouštět v jakém prostředí — to je jenkins.
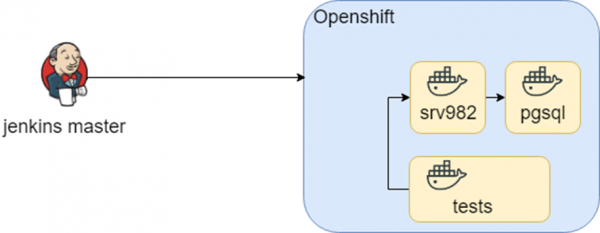
Tento systém fungoval dlouho, dokud jsme se nezkusili přenést to do Openshift. Kontajnery zůstaly stejné, ale spouštěcí prostředí se změnilo (pozdrav D.R.Y. znovu). мы не попробовали это перенести в Openshift. Контейнеры остались теже, а вот среда запуска сменилась (привет D.R.Y. опять).
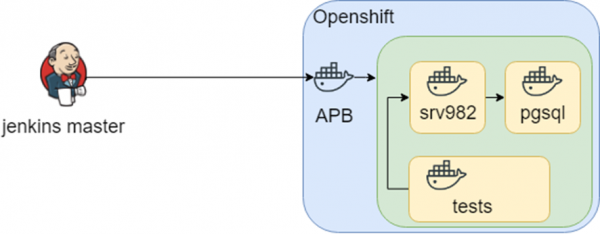
Myšlenka výzkumu se posunula dál a v openshift se našla věc APB (Ansible Playbook Bundle), která umožňuje zabalit znalosti o tom, jak nasadit infrastrukturu do kontejneru. T.j. existuje reprodukovatelný, testovatelný bod znalosti, jak nasadit infrastrukturu.
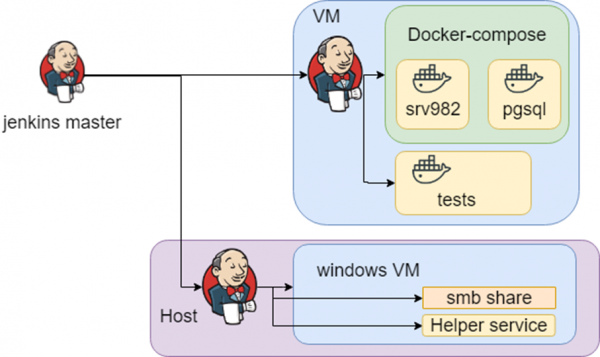
Všechno to znělo dobře, dokud jsme nenarazili na heterogenní infrastrukturu: pro testy potřebujeme Windows. Výsledkem je, že znalosti o tom, co, kde a jak nasadit a otestovat sedí v jenkins.
Závěr
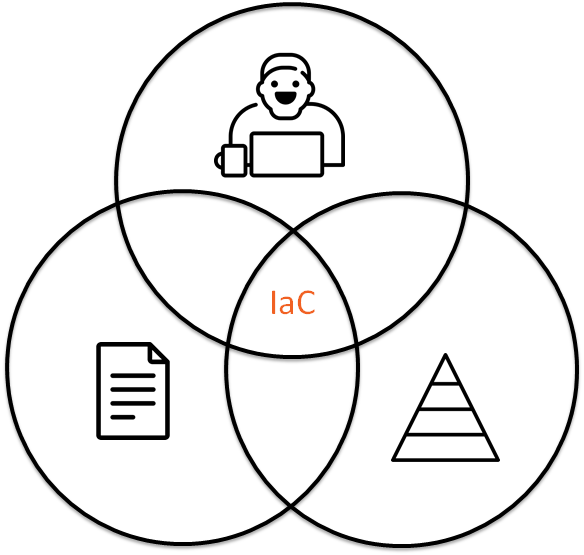
Infrastruktura jako kód je
- Kód v repozitáři.
- Interakce lidí.
- Testování infrastruktury.
odkazy
- Dry run 2019-04-24
- &&
Zdroj: habr.com
