

Pokračování překladu malé knihy:
„Porozumění zprostředkovatelům zpráv“,
autor: Jakub Korab, vydavatelství: O’Reilly Media, Inc., datum vydání: červen 2017, ISBN: 9781492049296.
Předchozí přeložená část:
KAPITOLA 3
Kafka
Kafka byla vyvinuta ve společnosti LinkedIn, aby překonala některá omezení tradičních zprostředkovatelů zpráv a vyhnula se nutnosti nakonfigurovat několik zprostředkovatelů zpráv pro různá „point-to-point“ zpracování, což je popsáno v této knize v části „Vertikální a horizontální škálování“ na straně 28. Použití ve společnosti LinkedIn bylo převážně založeno na jednosměrném získávání velmi velkých objemů dat, jako jsou kliknutí na stránkách a záznamy přístupu, přičemž se umožnilo využívat tato data několika systémům, aniž by to mělo vliv na výkon producentů nebo dalších konzumentů. Ve skutečnosti je důvodem existence Kafky dosažení architektury výměny zpráv, kterou popisuje Universal Data Pipeline.
S ohledem na tento konečný cíl se přirozeně objevily i další požadavky. Kafka musí:
- Být extrémně rychlá
- Poskytovat velkou propustnost při práci se zprávami
- Podporovat modely „Publisher-Subscriber“ a „Point-to-Point“
- Nesnižovat výkon se zvyšujícím se počtem konzumentů. Například výkon a fronty a témata v ActiveMQ se zhoršují s rostoucím počtem konzumentů na adrese
- Být horizontálně škálovatelná; pokud jeden broker, který uchovává (persists) zprávy, může to provádět pouze maximální rychlostí disku, pak má smysl překročit hranice jednoho instance brokera pro zvýšení výkonu
- Oddělovat přístup k ukládání a opětovnému vyhledávání zpráv
Aby toho všeho dosáhli, byla v Kafce přijata architektura, která redefinovala role a povinnosti klientů a zprostředkovatelů výměny zpráv. Model JMS je velmi orientován na zprostředkovatele, kde zprostředkovatel odpovídá za distribuci zpráv, zatímco klienti se musí starat pouze o odesílání a příjem zpráv. Kafka je naopak orientována na klienta, přičemž klient přebírá mnohé funkce tradičního zprostředkovatele, jako je spravedlivé rozdělení relevantních zpráv mezi spotřebitele, a na oplátku získává extrémně rychlého a škálovatelného zprostředkovatele. Pro lidi, kteří pracovali s tradičními systémy výměny zpráv, vyžaduje práce s Kafkou zásadní změny v názorech.
Tento inženýrský směr vedl k vytvoření infrastruktury výměny zpráv, schopné zvýšit propustnost o mnoho řádů ve srovnání s běžným zprostředkovatelem. Jak uvidíme, tento přístup souvisí s kompromisy, které znamenají, že Kafka není vhodná pro určité typy zátěží a zavedeného softwaru.
Ucelený model adresáta
Aby splnila výše uvedené požadavky, Kafka spojila výměnu zpráv typu "publikace-přihlášení" a "bod-bod" v rámci jednoho typu adresáta — tématu. To mate lidi, kteří pracovali se systémy výměny zpráv, kde slovo "téma" odkazuje na širokopásmový mechanismus, ze kterého (z tématu) čtení není spolehlivé (niedurable). Témata Kafky je třeba chápat jako hybridní typ adresáta, v souladu s definicí uvedenou v úvodu této knihy.
V zbytek této kapitoly, pokud výslovně neuvádíme jinak, bude termín "téma" odkazovat na téma Kafky.
Abychom plně porozuměli, jak se témata chovají a jaké záruky poskytují, musíme nejprve zvážit, jak jsou v Kafce implementována.
Každé téma v Kafce má svůj vlastní deník.
Producenti, kteří posílají zprávy do Kafky, zapisují do tohoto protokolu a konzumenti jej čtou pomocí ukazatelů, které se neustále posouvají dopředu. Periodicky Kafka odstraňuje ty nejstarší části protokolu, nezávisle na tom, zda byly zprávy v těchto částech přečteny, či nikoli. Centrálním prvkem designu Kafky je to, že broker se nestará o to, zda byly zprávy přečteny — to je odpovědnost klienta.
Termíny „protokol“ a „ukazatel“ se v neobjevují. Tyto dobře známé termíny jsou zde používány k usnadnění porozumění.
Tento model se zcela liší od ActiveMQ, kde jsou zprávy ze všech front ukládány do jednoho protokolu a broker označuje zprávy jako odstraněné poté, co byly přečteny.
Pojďme se nyní podívat podrobněji na protokol tématu.
Protokol Kafky se skládá z několika partičních (). Kafka zaručuje přísnou uspořádanost v každé partii. To znamená, že zprávy zapsané do partie v určitém pořadí budou přečteny ve stejném pořadí. Každá parta je implementována jako cyklický (rolling) protokol, který obsahuje podmnožinu (subset) všech zpráv odeslaných do tématu jeho producenty. Vytvořené téma obsahuje ve výchozím nastavení jednu partu. Myšlenka partií je centrální myšlenkou Kafky pro horizontální škálování.
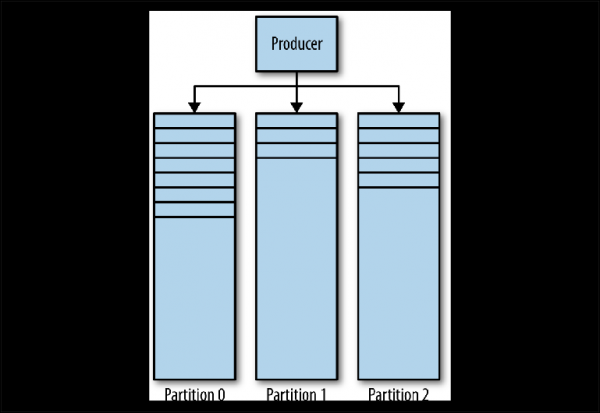
Obrázek 3-1. Partice Kafky
Když producent odešle zprávu do Kafky, rozhodne, do které partie zprávu poslat. Na to se podíváme podrobněji později.
Čtení zpráv
Klient, který chce číst zprávy, spravuje pojmenovaný ukazatel, nazývaný skupina konzumentů (consumer group), který ukazuje na offset zprávy v partii. Offset je pozice s rostoucím číslem, které začíná od 0 na začátku partie. Tato skupina konzumentů, na kterou odkazují v API prostřednictvím uživatelsky definovaného identifikátoru group_id, odpovídá jednomu logickému spotřebiteli nebo systému.
Většina systémů využívajících výměnu zpráv čte data z adresáta prostřednictvím několika instancí a vláken pro paralelní zpracování zpráv. Obvykle tedy bude mnoho instancí konzumentů, které společně využívají stejnou skupinu konzumentů.
Problém čtení lze vyjádřit následujícím způsobem:
- Téma má několik partičních částí
- Používání tématu může být současně mnoho skupin spotřebitelů
- Skupina spotřebitelů může mít několik samostatných instancí
Toto je netriviální problém "mnoho k mnoha". Abychom pochopili, jak Kafka zachází s vztahy mezi skupinami spotřebitelů, instancemi spotřebitelů a partičními částmi, prozkoumejme řadu postupně složitějších scénářů čtení.
Spotřebitelé a skupiny spotřebitelů
Vezměme jako výchozí bod téma s jednou partiční částí ().
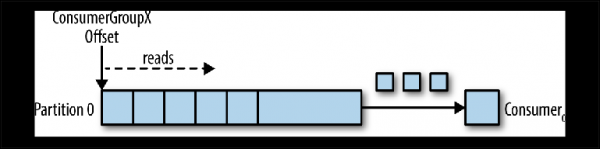
Obrázek 3-2. Spotřebitel čte z partiční části
Když se instance spotřebitele připojí se svým vlastním group_id k tomuto tématu, je jí přiřazena partiční část k čtení a offset v této partiční části. Poloha tohoto offsetu je konfigurována v klientovi, jakožto ukazatel na poslední pozici (nejnovější zprávu) nebo nejstarší pozici (nejstarší zprávu). Spotřebitel žádá (polls) zprávy z tématu, což vede k jejich sekvenčnímu čtení z deníku.
Poloha offsetu se pravidelně posílá zpět do Kafky a ukládá se jako zprávy ve vnitřním tématu _consumer_offsets. Přečtené zprávy se přesto neodstraňují, na rozdíl od běžného brokera, a klient může posunout (rewind) offset, aby znovu zpracoval již zobrazené zprávy.
Když se připojí druhý logický spotřebitel, používající jiný group_id, spravuje druhý ukazatel, který není závislý na prvním (). Tímto způsobem téma Kafka funguje jako fronta, kde existuje jeden spotřebitel a jako běžné téma publisher-subscriber (pub-sub), na které se přihlásilo několik spotřebitelů, s dalším výhodou, že všechny zprávy jsou uchovávány a mohou být zpracovány vícekrát.
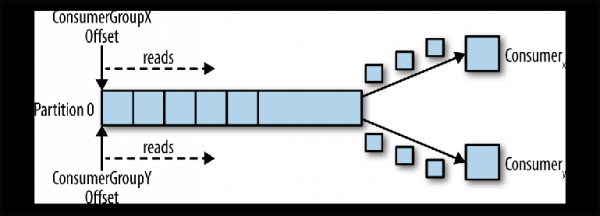
Obrázek 3-3. Dva spotřebitelé ve různých skupinách spotřebitelů čtou z jedné partiční části
Spotřebitelé ve skupině spotřebitelů
Když jedna instance spotřebitele čte data z partiční části, plně kontroluje ukazatel a zpracovává zprávy, jak je popsáno v předchozí sekci.
Pokud bylo několik instancí spotřebitelů připojeno se stejným group_id k tématu s jednou partiční, pak poslední připojený instanci bude předán kontrola nad ukazatelem a od této chvíle bude přijímat všechny zprávy ().
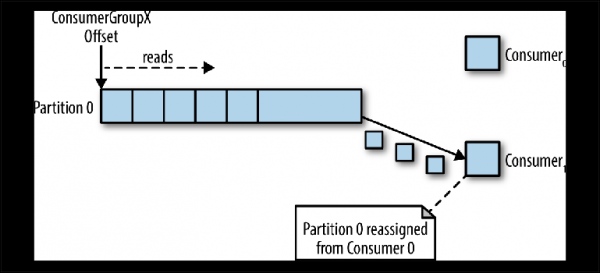
Obrázek 3-4. Dva spotřebitelé ve stejné skupině spotřebitelů čtou z jedné partiční
Tento způsob zpracování, ve kterém počet instancí spotřebitelů přesahuje počet partičních, lze považovat za variantu monopolního spotřebitele. Může být užitečné, pokud potřebujete 'aktivně-pasivní' (nebo 'horkou-teplou') klasteraci vašich instancí spotřebitelů, i když paralelní práce několika spotřebitelů ('aktivně-aktivní' nebo 'horká-horká') je mnohem běžnější než spotřebitelé v režimu čekání.
Takové chování distribuce zpráv, popsané výše, může být překvapivé ve srovnání s tím, jak funguje běžná fronta JMS. V tomto modelu budou zprávy odesílané do fronty rovnoměrně rozděleny mezi dva spotřebitele.
Nejčastěji, když vytváříme několik instancí spotřebitelů, děláme to buď pro paralelní zpracování zpráv, nebo pro zvýšení rychlosti čtení, nebo pro zvýšení odolnosti procesu čtení. Protože číst data z partiční může současně jen jedna instance spotřebitele, jak se to dosahuje v Kafce?
Jedním ze způsobů, jak toho dosáhnout, je použít jednu instanci spotřebitele, aby přečetla všechny zprávy a předala je do fondu vláken. Ačkoli tento přístup zvyšuje propustnost zpracování, zvyšuje složitost logiky spotřebitelů a nic nedělá pro zvýšení odolnosti systému čtení. Pokud jedna instance spotřebitele selže kvůli výpadku napájení nebo podobné události, pak čtení skončí.
Kanonickým způsobem řešení tohoto problému v Kafce je použít více partičních.OPartitioning
Partice jsou základním mechanismem paralelizace čtení a škálování tématu nad propustnost jednoho instance brokera. Abychom to lépe pochopili, podívejme se na situaci, kdy existuje téma se dvěma partičními a na toto téma se přihlásí jeden spotřebitel (
Obrázek 3-5).
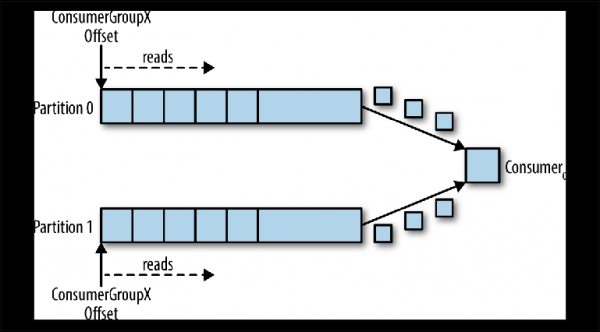
Obrázek 3-5. Jeden konzument čte z několika partiční
V tomto scénáři má konzument kontrolu nad ukazateli odpovídajícími jeho group_id v obou partičních a začíná číst zprávy z obou partičních.
Když je do tohoto tématu přidán další konzument pro stejné group_id, Kafka převede (reallocate) jednu z partiční z prvního na druhého konzumenta. Poté každý instance konzumenta bude číst z jedné partiční tématu ().
Aby byla zajištěna paralelní zpracování zpráv ve 20 vláknech, potřebujete alespoň 20 partiční. Pokud jich bude méně, zůstanou vám konzumenti, kteří nemají co dělat, což bylo popsáno dříve v diskusi o monopolních konzumentů.
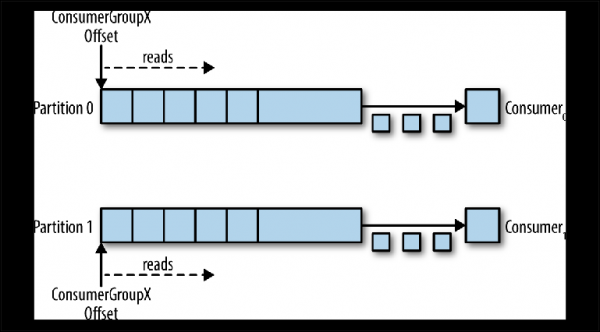
Obrázek 3-6. Dva konzumenti ve stejné skupině konzumentů čtou z různých partičních
Tento systém výrazně snižuje složitost práce brokera Kafka ve srovnání s distribucí zpráv, která je potřebná pro podporu fronty JMS. Zde není nutné se starat o následující záležitosti:
- Který konzument by měl obdržet další zprávu na základě cyklického (round-robin) rozdělení, aktuální kapacity bufferů předběžného výběru nebo předchozích zpráv (jak pro skupiny zpráv JMS).
- Jaké zprávy byly odeslány kterým konzumentům a měly by být znovu doručeny v případě selhání.
Vše, co broker Kafka musí udělat, je postupně předávat zprávy konzumentovi, když si je ten poslední vyžádá.
Avšak požadavky na paralelní čtení a znovu odesílání neúspěšných zpráv nikam nezmizely — odpovědnost za ně se jednoduše přesunula od brokera k klientovi. To znamená, že musí být zohledněny ve vašem kódu.
Odesílání zpráv
Odpovědnost za rozhodnutí, do které partiční odeslat zprávu, je na producentovi této zprávy. Abychom porozuměli mechanismu, kterým se to provádí, nejprve se musíme podívat na to, co vlastně odesíláme.
Zatímco v JMS používáme strukturu zprávy s metadaty (hlavičkami a vlastnostmi) a tělem obsahujícím užitečné zatížení (payload), v Kafce je zpráva párem „klíč-hodnota“Zpráva s užitečným zatížením je odeslána jako hodnota (value). Klíč se na druhé straně používá především pro partišování a měl by obsahovat klíč specifický pro obchodní logiku, aby se související zprávy umístily do stejné partice.
V kapitole 2 jsme diskutovali scénář online sázek, kdy by měly být související události zpracovávány v pořadí jedním spotřebitelem:
- Uživatelský účet je nastaven.
- Peníze jsou připsány na účet.
- Sázka je provedena, což vyžaduje peníze z účtu.
Pokud každá událost představuje zprávu odeslanou do tématu, pak přirozeným klíčem bude identifikátor účtu.
Když je zpráva odeslána pomocí Kafka Producer API, je předána funkci partišování, která, vezmouc v úvahu zprávu a aktuální stav klastra Kafka, vrací identifikátor partice, do které by měla být zpráva odeslána. Tato funkce je implementována v Javě prostřednictvím rozhraní Partitioner.
Toto rozhraní vypadá takto:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
Implementace Partitioner pro určení partice používá výchozí algoritmus hašování klíče (general-purpose hashing algorithm over the key) nebo cyklické procházení (round-robin), pokud není klíč uveden. Toto výchozí chování funguje dobře ve většině případů. V budoucnu však budete chtít napsat svou vlastní.
Napsání vlastní strategie partišování
Uvažujme příklad, kdy chcete odeslat metadata spolu s užitečným zatížením zprávy. Užitečné zatížení v našem příkladu je pokyn k provedení vkladu na herní účet. Pokyn je to, co bychom chtěli zaručeně neměnit při přenosu a chceme si být jisti, že pouze důvěryhodný nadřazený systém může tento pokyn iniciovat. V takovém případě se odesílající a přijímající systémy dohodnou na použití podpisu k ověření autenticity zprávy.
V běžném JMS jednoduše definujeme vlastnost „podpis zprávy“ a přidáváme ji k zprávě. Nicméně, Kafka nám neposkytuje mechanismus pro přenos metadat – pouze klíč a hodnotu.
Protože hodnota je užitečná zátěž bankovního převodu (bank transfer payload), jejíž integritu chceme zachovat, máme jedinou možnost, a to definovat strukturu dat pro použití v klíči. Předpokládáme, že potřebujeme identifikátor účtu pro partitioning, protože všechny zprávy týkající se účtu je nutné zpracovávat v pořadí, vymyslíme následující strukturu JSON:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Protože hodnota podpisu se bude lišit v závislosti na užitečné zátěži, výchozí strategie hashování rozhraní Partitioner nebude spolehlivě seskupovat související zprávy. Proto budeme potřebovat napsat vlastní strategii, která analyzuje tento klíč a rozdělí (partition) hodnotu accountId.
Kafka zahrnuje kontrolní součty pro detekci poškození zpráv v úložišti a má úplnou sadu bezpečnostních funkcí. I přesto se občas objevují specifické požadavky na odvětví, jako je uvedeno výše.
Vlastní strategie partitioningu by měla zajistit, že všechny související zprávy se ocitnou v jedné partition. I když se to zdá jednoduché, toto požadavek může být komplikován důležitostí uspořádání souvisejících zpráv a tím, jak pevně je počet partitions v tématu stanoven.
Počet partitions v tématu se může časem měnit, jelikož je možné je přidávat, pokud provoz přesáhne původní očekávání. Klíče zpráv tak mohou být spojeny s partition, do které byly původně odeslány, což naznačuje část stavu, která by měla být rozdělena mezi instance producenta.
Dalším faktorem, který je třeba zvážit, je rovnoměrnost distribuce zpráv mezi partitions. Obecně platí, že klíče nejsou rovnoměrně rozloženy mezi zprávy a hashovací funkce nezaručují spravedlivou distribuci zpráv pro malou skupinu klíčů.
Je důležité poznamenat, že bez ohledu na to, jak se rozhodnete rozdělit zprávy, bude pravděpodobně potřeba opětovně použít samotný dělitel.
Zvážíme požadavek na replikaci dat mezi klastrem Kafka v různých geografických polohách. K tomu účelu je Kafka dodávána s nástrojem příkazového řádku nazvaným MirrorMaker, který se používá k čtení zpráv z jednoho klastru a jejich přenosu do druhého.
MirrorMaker musí rozumět klíčům replikovaného tématu, aby udržel relativní pořadí mezi zprávami při replikaci mezi klastry, protože počet partition pro toto téma se může v obou klastrech lišit.
Uživatelské strategie partition se vyskytují relativně zřídka, protože výchozí hashování nebo cyklické rozdělení úspěšně fungují ve většině scénářů. Nicméně, pokud potřebujete přísné záruky pořadí nebo musíte extrahovat metadata z payloadů, mělo by vás partitionování zajímat víc.
Výhody škálovatelnosti a výkonu Kafka jsou způsobeny přenesením některých povinností tradičního brokera na klienta. V tomto případě se rozhoduje o rozdělení potenciálně souvisejících zpráv mezi několika paralelně pracujícími konsumenty.
JMS brokeři také musí řešit takové požadavky. Zajímavé je, že mechanismus posílání souvisejících zpráv jednomu a tomu samému consumerovi, realizovaný prostřednictvím JMS Message Groups (typ strategie vyvažování zátěže sticky load balancing (SLB)), také vyžaduje, aby odesílatel označil zprávy jako související. V případě JMS je broker odpovědný za odeslání této skupiny souvisejících zpráv jednomu konsumentovi z mnoha a přenos vlastnictví skupiny, pokud konsument selže.
Dohody o producentovi
Partitionování není jediná věc, kterou je třeba zvážit při odesílání zpráv. Pojďme se podívat na metody send() třídy Producer v Java API:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Je třeba hned poznamenat, že obě metody vracejí Future, což naznačuje, že operace odeslání není vykonána okamžitě. V důsledku toho se zpráva (ProducerRecord) zapisuje do odesílacího bufferu pro každou aktivní partition a je předávána brokerovi na pozadí klientské knihovny Kafka. Ačkoli to činí práci neuvěřitelně rychlou, znamená to, že neobratně napsaná aplikace může ztratit zprávy, pokud bude proces zastaven.
Jak už bylo řečeno, existuje způsob, jak učinit operaci odeslání spolehlivější na úkor výkonu. Velikost tohoto bufferu lze nastavit na 0, a tím bude vlákno odesílající aplikace muset čekat, až se přenos zprávy brokerovi dokončí, následujícím způsobem:
RecordMetadata metadata = producer.send(record).get();Znovu o čtení zpráv
Čtení zpráv má další složitosti, o kterých je třeba uvažovat. Na rozdíl od API JMS, které může spustit posluchače zpráv (message listener) jako reakci na příchozí zprávu, rozhraní Consumer Kafka pouze provádí poll (dotazování). Pojďme se podívat blíže na metodu poll (), která se používá k tomuto účelu:
ConsumerRecords poll(long timeout);Návratová hodnota metody je kontejnerová struktura obsahující několik objektů ConsumerRecord z potenciálně několika partition. ConsumerRecord sám o sobě je držitelem objektů pro pár klíč-hodnota s příslušnými metadaty, jako je partition, ze které byl získán.
Jak bylo prodiskutováno v kapitole 2, musíme neustále mít na paměti, co se děje se zprávami po jejich úspěšném nebo neúspěšném zpracování, například pokud klient nemůže zprávu zpracovat nebo pokud dojde k jeho selhání. V JMS bylo to řešeno prostřednictvím režimu potvrzení (acknowledgement mode). Broker buď odstraní úspěšně zpracovanou zprávu, nebo znovu doručí nezpracovanou nebo selhanou (za předpokladu, že byly použity transakce).
Kafka funguje úplně jinak. Zprávy nejsou odstraňovány brokerem po přečtení a odpovědnost za to, co se stane při selhání, leží na samotném čtecím kódu.
Jak jsme již zmínili, skupina konzumentů je spojena s offsetem v logu. Pozice v logu spojená s tímto offsetem odpovídá následující zprávě, která bude vyhozena jako odpověď na poll ()Rozhodující význam při čtení má okamžik, kdy se tento posun zvyšuje.
Pokud se vrátíme k modelu čtení, který byl diskutován dříve, zpracování zprávy se skládá ze tří fází:
- Extrahovat zprávu pro čtení.
- Zpracovat zprávu.
- Potvrdit zprávu.
Konzument Kafka přichází s možností konfigurace enable.auto.commit. To je často používané nastavení ve výchozím nastavení, jak je obvyklé u nastavení obsahujících slovo „auto“.
Před verzí Kafka 0.10 klient, který použil tento parametr, poslal posun poslední přečtené zprávy při následném vyvolání poll () po zpracování. To znamenalo, že všechny zprávy, které již byly extrahovány, mohly být znovu zpracovány, pokud je klient již zpracoval, ale byl neočekávaně zničen před vyvoláním poll (). Protože broker neuchovává žádný stav týkající se toho, kolikrát byla zpráva přečtena, další konzument, který extrahuje tuto zprávu, nebude vědět, že došlo k něčemu špatnému. Toto chování bylo pseudo-transakční. Posun byl potvrzen pouze v případě úspěšného zpracování zprávy, ale pokud klient přerušil činnost, broker znovu poslal tutéž zprávu jinému klientovi. Toto chování odpovídalo zárukám doručení zpráv „alespoň jednou«.
Ve verzi Kafka 0.10 byl kód klienta změněn tak, aby se potvrzení spouštělo periodicky knihovnou klienta, podle nastavení auto.commit.interval.ms. Toto chování leží někde mezi režimy JMS AUTO_ACKNOWLEDGE a DUPS_OK_ACKNOWLEDGE. Při používání auto potvrzení mohly být zprávy potvrzeny bez ohledu na to, zda byly skutečně zpracovány — mohlo k tomu dojít v případě pomalého konzumenta. Pokud klient přerušil činnost, zprávy byly extrahovány dalším konzumentem od potvrzené pozice, což mohlo vést k přeskočení zpráv. V tomto případě Kafka neztrácela zprávy, pouze kód čtoucí je nezpracovával.
Tento režim má stejné vyhlídky jako ve verzi 0.9: zprávy mohou být zpracovány, ale v případě selhání může být posun neopotvrzen, což potenciálně může vést k duplikaci doručení. Čím více zpráv extrahujete během poll (), tím větší je tento problém.
Jak bylo diskutováno v části „Čtení zpráv z fronty“ na str. 21, v systému zasílání zpráv neexistuje pojem o jednorázové dodávce zprávy, pokud vezmeme v úvahu režimy selhání.
V Kafce existují dva způsoby, jak potvrdit (komitovat) offset: automaticky a ručně. V obou případech mohou být zprávy zpracovány více než jednou, pokud byla zpráva zpracována, ale došlo k selhání před potvrzením. Také můžete zprávu vůbec nezpracovat, pokud bylo potvrzení provedeno na pozadí a váš kód byl ukončen dříve, než začal zpracovávat (to může být v Kafce 0.9 a starších verzích).
Spravovat proces potvrzování offsetu ručně lze v API konzumenta Kafky, nastavením parametru enable.auto.commit na hodnotu false a explicitním vyvoláním jednoho z následujících metod:
void commitSync();
void commitAsync();
Pokud se snažíte zpracovat zprávu „alespoň jednou“, musíte ručně potvrdit offset pomocí commitSync (), provedením tohoto příkazu ihned po zpracování zpráv.
Tyto metody neumožňují potvrzovat (acknowledged) zprávy, dokud nejsou zpracovány, ale nic nedělají k odstranění potenciálního zdvojení zpracování, přičemž vytvářejí dojem transakčnosti. V Kafce chybí transakce. Klient nemá možnost udělat následující:
- Automaticky vrátit (roll back) selhanou zprávu. Konzumenti musí sami zpracovat výjimky, které vznikají v důsledku problémových payloadů a odpojení backendu, jelikož nemohou spoléhat na opakovanou dodávku zpráv brokerem.
- Odeslat zprávy do několika témat v rámci jedné atomární operace. Jak brzy uvidíme, kontrola nad různými tématy a partitiony může být na různých strojích v klastru Kafky, které nekontrolují transakce při odesílání. K okamžiku napsání tohoto článku byla provedena určitá práce, aby se to stalo možným pomocí KIP-98.
- Svázat čtení jedné zprávy z jednoho tématu s odesláním jiné zprávy do jiného tématu. Znovu, architektura Kafky závisí na mnoha nezávislých strojích, které fungují jako jedna sběrnice a není dělána žádná snaha to skrýt. Například neexistují komponenty API, které by umožnily svázat Konzument a Producent v transakci. V JMS je to zajištěno objektem Session, ze kterého se vytvářejí MessageProducers a MessageConsumers.
Pokud se nemůžeme spoléhat na transakce, jak můžeme zajistit sémantiku, která se více blíží té, kterou poskytují tradiční systémy výměny zpráv?
Pokud existuje pravděpodobnost, že offset spotřebitele se může zvýšit dříve, než byla zpráva zpracována, například během selhání spotřebitele, nemá spotřebitel žádný způsob, jak zjistit, zda jeho skupina spotřebitelů zmeškala zprávy, když jí byla přidělena partition. Jednou ze strategií je vrátit (rewind) offset na předchozí pozici. API spotřebitele Kafka poskytuje následující metody pro to:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Metoda seek () lze použít s metodou
offsetsForTimes (Map timestampsToSearch) pro vrácení do stavu v nějakém konkrétním okamžiku v minulosti.
Zároveň používání tohoto přístupu znamená, že je vysoce pravděpodobné, že některé zprávy, které byly dříve zpracovány, budou přečteny a zpracovány znovu. Abychom tomu předešli, můžeme použít idempotentní čtení, jak je popsáno v kapitole 4, k sledování dříve sledovaných zpráv a vyloučení duplicit.
Jako alternativa může být kód vašeho spotřebitele jednoduchý, pokud je možné ztratit nebo duplikovat zprávy. Když zvažujeme scénáře použití, pro které je Kafka obvykle používána, například zpracování událostí logů, metrik, sledování kliknutí atd., pochopíme, že ztráta jednotlivých zpráv pravděpodobně nebude mít významný dopad na okolní aplikace. V těchto případech jsou výchozí hodnoty zcela přijatelné. Na druhé straně, pokud vaše aplikace potřebuje zpracovávat platby, musí pečlivě dbát na každou jednotlivou zprávu. Všechno se to odvíjí od kontextu.
Osobní pozorování ukazují, že s rostoucí intenzitou zpráv klesá hodnota každé jednotlivé zprávy. Velké objemy zpráv se obvykle stávají cennými, pokud jsou zvažovány v agregované formě.
Vysoká dostupnost (High Availability)
Přístup Kafka k vysoké dostupnosti se výrazně liší od přístupu ActiveMQ. Kafka je navržena na základě horizontálně škálovatelných klastrů, kde všechny instance brokera přijímají a distribuují zprávy současně.
Klastar Kafka se skládá z několika instancí brokera pracujících na různých serverech. Kafka byla navržena pro provoz na běžném autonomním hardwaru, přičemž každý uzel má své vlastní dedikované úložiště. Použití síťových úložišť (SAN) se nedoporučuje, protože více výpočetních uzlů může soutěžit o časové intervaly úložiště a vytvářet konflikty.Mí
Kafka je trvale zapnutá systém. Mnozí velcí uživatelé Kafka nikdy nevypínají své klastry a software vždy zajišťuje aktualizaci prostřednictvím sekvenčního restartu. Toho je dosaženo zajištěním kompatibility s předchozí verzí pro zprávy a interakce mezi brokery.
Brokery jsou připojeny k cloudu serverů , který funguje jako registr konfiguračních dat a slouží k udržování koordinace rolí každého brokera. ZooKeeper je také distribuovaný systém, který zajišťuje vysokou dostupnost prostřednictvím replikace informací pomocí nastavení kvóra..
V základním případě je téma vytvořeno v klastru Kafka s následujícími vlastnostmi:
- Počet partition. Jak již bylo dříve diskutováno, přesná hodnota používaná zde závisí na požadované úrovni paralelního čtení.
- Faktor replikace určuje, kolik instancí brokera v klastru by mělo mít protokoly pro tuto partition.
Díky koordinaci pomocí ZooKeepera se Kafka snaží spravedlivě rozdělit nové partition mezi brokery v klastru. Toho dosahuje jedna instance, která vykonává roli kontroléru.
V běhu pro každou partition tématu Ovladač přiřazuje brokerovi role lídera (leader, master, vedoucí) a následovníků (následovníků, otroků, podřízených). Broker, který slouží jako lídr pro tuto partition, je odpovědný za příjem všech zpráv, které mu producenti posílají, a za distribuci zpráv mezi spotřebitele. Při odesílání zpráv do partition tématu se replikují na všechny uzly brokera, které slouží jako následovníci pro tuto partition. Každý uzel, který má logy pro partition, se nazývá replikou. Broker může sloužit jako lídr pro některé partition a jako následovník pro jiné.
Následovník, který obsahuje všechny zprávy uložené u lídra, se nazývá synchronizovaná replika (replica in-sync). Pokud se broker, který slouží jako lídr pro partition, odpojí, jakýkoli broker, který je v koherentním nebo synchronizovaném stavu pro tuto partition, může převzít roli lídra. To je extrémně odolný design.
Součástí konfigurace producenta je parametr acks, který určuje, kolik replik musí potvrdit (acknowledge) přijetí zprávy, než aplikace pokračuje v odesílání: 0, 1 nebo všechno. Pokud je nastavena hodnota all, pak při přijetí zprávy lídr odešle potvrzení (confirmation) zpět producentovi, jakmile obdrží potvrzení (acknowledgements) zápisu od několika replik (včetně sebe), určených nastavením tématu min.insync.replicas (výchozí hodnota 1). Pokud se zprávu nelze úspěšně replikovat, producent vyvolá výjimku pro aplikaci (NotEnoughReplicas nebo NotEnoughReplicasAfterAppend).
V typické konfiguraci se vytváří téma s replikací 3 (1 lídr, 2 následovníci pro každou partition) a parametr min.insync.replicas je nastaven na hodnotu 2. V tomto případě cluster umožní, aby se jeden z brokerů spravujících partition tématu mohl odpojit bez vlivu na klientské aplikace.
To nás vrací k již známému kompromisu mezi výkonem a spolehlivostí. Replikace se děje na úkor dodatečného času potřebného na potvrzení (acknowledgments) od následovníků. I když se provádí paralelně, replikace, alespoň na tři uzly, má výkon stejný jako na dva (ignorujme zvýšené využití šířky pásma sítě).
Použitím tohoto schématu replikace se Kafka šikovně vyhýbá nutnosti fyzicky zapisovat každou zprávu na disk pomocí operace sync(). Každá zpráva odeslaná producentem bude zapsána do deníku partition, ale jak bylo diskutováno v Kapitole 2, zápis do souboru se nejprve provádí v paměti operačního systému. Pokud je tato zpráva replikována na jinou instanci Kafka a nachází se v její paměti, ztráta vůdce neznamená, že sama zpráva byla ztracena — jejímu převzetí se může ujmout synchronizovaná replikace.
Odstranění potřeby provádět operaci sync() znamená, že Kafka může přijímat zprávy rychlostí, s jakou je může zapisovat do paměti. A naopak, čím déle lze vyhnout vyprázdnění (flush) paměti na disk, tím lépe. Z tohoto důvodu není neobvyklé, že brokerům Kafka je přiděleno 64 GB paměti nebo více. Takové používání paměti znamená, že jedna instance Kafka může snadno fungovat při rychlostech tisíckrát rychlejších než tradiční broker zpráv.
Kafka může být také nakonfigurována pro aplikaci operace sync() na balíčky zpráv. Vzhledem k tomu, že vše v Kafka je zaměřeno na práci s balíčky, ve skutečnosti to dobře funguje pro mnohé využití a je to užitečný nástroj pro uživatele, kteří vyžadují velmi silné záruky. Většina čistého výkonu Kafka souvisí se zprávami, které jsou odesílány brokerovi ve formě balíčků, a s tím, že tyto zprávy jsou čteny z brokera po sekvenčních blocích pomocí operací (operacemi, během nichž se neprovádí úkol kopírování dat z jedné oblasti paměti do druhé). To poslední je velkým ziskem z hlediska výkonu a zdrojů a je možné pouze díky použití základní struktury datového deníku, která určuje schéma partition.
V klastru Kafka je možné dosáhnout mnohem vyššího výkonu než při použití jednoho brokera Kafka, protože partitiony tématu mohou horizontálně škálovat na mnoha samostatných strojích.
Závěry
V této kapitole jsme prozkoumali, jak architektura Kafka přehodnocuje vztahy mezi klienty a brokery, aby zajistila mimořádně odolný kanál pro přenos zpráv, s propustností mnohokrát vyšší než u běžného brokeru zpráv. Diskutovali jsme o funkcionalitě, kterou k dosažení tohoto cíle používá, a stručně se podívali na architekturu aplikací, které tuto funkcionalitu zajišťují. V následující kapitole se budeme zabývat běžnými problémy, které musí aplikace založené na výměně zpráv řešit, a prodiskutujeme strategie jejich řešení. Kapitolu zakončíme náčrtem, jak uvažovat o technologiích výměny zpráv obecně, abyste mohli posoudit jejich vhodnost pro vaše scénáře použití.
Předchozí přeložená část:
Překlad byl proveden:
Pokračování příště…
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
Používá se Kafka ve vaší organizaci?
Ano
Ne
Dříve se používala, nyní ne
Plánujeme používat
Hlasovalo 38 uživatelů. Zdrželo se 8 uživatelů.
Zdroj: habr.com
