

Vždy mě zajímalo, jak lépe uspořádat knihy ve své elektronické knihovně. Nakonec jsem dospěl k tomuto řešení, které automaticky spočítává počet stránek a přidává další užitečné funkce. Všechny zájemce prosím o kliknutí na 'read more'.
Část 1. Dropbox
Všechny knihy mám uložené na Dropboxu. Existují 4 kategorie, do kterých jsem vše rozdělil: Učebnice, Příručka, Beletrie, Odborná literatura. Příručky však do tabulky nepřidávám.
Většina knih je ve formátu .epub, ostatní jsou ve formátu .pdf. To znamená, že konečné řešení by mělo pokrýt oba formáty.
Cesty k knihám mám přibližně takovéto:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Pokud je kniha beletristická, kategorie (tedy „Design“ v předchozím případě) se odstraní.
Rozhodl jsem se nezabývat se API Dropboxu, protože mám nainstalovanou jejich aplikaci, která synchronizuje složku. Tedy plán je následující: vezmeme knihy ze složky, každou knihu projdeme počítačem slov, a přidáme ji do Notion.
Část 2. Přidáváme řádek
Tabulka by měla vypadat přibližně takto. POZOR: názvy sloupců je lepší psát latinkou.
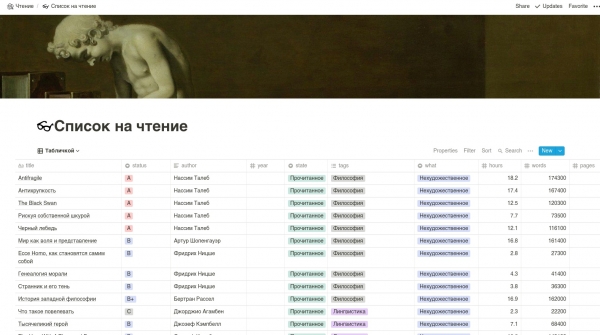
Použijeme neoficiální API Notionu, protože oficiální ještě nebylo vydáno.

Přejdeme do Notionu, stiskneme Ctrl + Shift + J, přejdeme do Application -> Cookies, zkopírujeme token_v2 a nazveme ho TOKEN. Poté přejdeme na požadovanou stránku s tabulkou knihovny a zkopírujeme odkaz. Přejmenujeme na NOTION.
Poté napíšeme kód pro připojení k Notionu.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Dále napíšeme funkci pro přidání řádku do tabulky.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Beletrie":
            row.author = tags[2]

        elif tags[0] == "Odborná literatura":
            row.tags = tags[2]

        elif tags[0] == "Učebnice":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Co se zde děje. Přidáváme nový řádek do tabulky v prvním řádku. Dále rozdělíme naši cestu podle „/“ a získáme tagy. Tagy představují „Beletrie“, „Design“, kdo je autorem a podobně. Dále nastavíme všechna potřebná pole tabulky.
Část 3. Počítáme slova, hodiny a další užitečné informace
Tohoto úkolu už je složitější. Jak si pamatujeme, máme dva formáty: ePub a PDF. Zatímco u ePub je vše jasné – slova tam pravděpodobně jsou, u PDF to tak jednoznačné není: může se skládat pouze z pospojovaných obrázků.
Takže funkce pro počítání slov v PDF bude vypadat takto: vezmeme počet stránek a vynásobíme ho určitou konstantou (průměrný počet slov na stránku).
Tady je:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Toto je WORDS_PER_PAGE pro stránku A4, přibližně 300.
Teď napišme funkci pro počítání stránek. Budeme používat .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Dále napíšeme kód pro počítání stránek v ePub. Použijeme . Tady vezmeme knihu, převedeme ji na řádky a pro každý řádek spočítáme slova.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Teď uděláme počítání času. Vezmeme naše oblíbené množství slov a vydělíme to vaší rychlostí čtení.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Část 4. Spojujeme všechny části
Musíme projít všechny možné cesty v naší složce s knihami. Zkontrolovat, zda už kniha je v Notion: pokud je — řádek vytvářet už nemusíme.
Pak musíme určit typ souboru, na základě toho spočítat počet slov. Na konci přidat knihu.
Takhle máme náš kód:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
A funkce pro kontrolu, zda byla kniha přidána, vypadá takto:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Závěr
Děkuji všem, kdo si přečetli tento článek. Doufám, že vám pomůže číst více 🙂
Zdroj: habr.com
