

Ahoj, čtenáři Habr. Tímto článkem zahajujeme cyklus, který bude vyprávět o naší vyvinuté hyperkonvergentní systému AERODISK vAIR. Původně jsme chtěli v prvním článku říci všechno o všem, ale systém je poměrně složitý, takže ho budeme „jíst“ po částech.
Začneme vyprávění historií vzniku systému, podrobíme se souborovému systému ARDFS, který tvoří základ vAIR, a také si trochu popovídáme o umístění tohoto řešení na ruském trhu.
V další článcích budeme podrobněji vyprávět o různých architektonických komponentách (klastr, hypervisor, vyrovnávač zatížení, monitorovací systém atd.), procesu konfigurace, zvedneme otázky licencování, samostatně ukážeme crash testy a samozřejmě napíšeme o zátěžovém testování a sizingu. Také samostatný článek věnujeme komunitní verzi vAIR.
AERODISK – je to spíše příběh o storage? Nebo proč jsme se vůbec začali zabývat hyperkonvergencí?
Původně nás myšlenka vytvořit vlastní hyperkonvergenci napadla někdy kolem roku 2010. Tehdy na trhu ještě nebyl ani AERODISK, ani podobná řešení (komerční boxy hyperkonvergentních systémů). Naším úkolem bylo udělat rozšířené úložiště z množství serverů s místními disky, sloučených interkonektem pomocí protokolu Ethernet, a zároveň spouštět virtuální stroje a softwarovou síť. To vše bylo potřebné realizovat bez storage (protože na storage a její připojení prostě nebyly peníze, a vlastní storage jsme tehdy ještě nevymysleli).
Vyzkoušeli jsme mnoho open source řešení a přece jsme tuto úlohu vyřešili, ale řešení bylo velmi složité a těžko se opakovalo. Kromě toho, toto řešení bylo ze série „Funguje? Neřeš!“. Takže poté, co jsme vyřešili tuto úlohu, jsme se dál nerozhodli vyvíjet myšlenku přetvoření výsledku naší práce na plnohodnotný produkt.
Po této zkušenosti jsme se od této myšlenky odklonili, ale stále nás neopustila představa, že tento úkol lze vyřešit a přínos takového řešení je více než zřejmý. V budoucnu vydané HCI produkty zahraničních společností tento pocit jen potvrdily.
V polovině roku 2016 jsme se tedy vrátili k tomuto úkolu v rámci vytváření plnohodnotného produktu. Tehdy jsme ještě neměli žádné vztahy s investory, proto jsme museli koupit vývojový stán za své poměrně malé peníze. Po sehnání použitých serverů a switchů na Avitu jsme se pustili do práce.
Naším hlavním počátečním úkolem bylo vytvořit vlastní, ačkoliv jednoduchý, souborový systém, který by mohl automaticky a rovnoměrně rozdělovat data ve formě virtuálních bloků na n-nom počtu uzlů clusteru, které byly spojeny interkonnektem přes Ethernet. Přitom by se měl systém snadno a dobře škálovat a být nezávislý na přidružených systémech, tj. být vyčleněn od vAIR ve formě "pouhozemního úložiště".
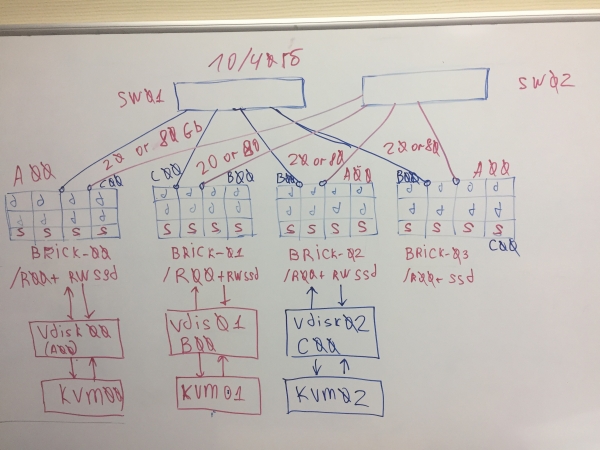
První koncept vAIR
Od záměru použít hotová open source řešení pro organizaci distribuovaného úložiště (ceph, gluster, lustre a podobně) jsme se záměrně vzdali ve prospěch našeho vlastního vývoje, protože jsme již měli s nimi mnoho projektového zkušenosti. Tyto řešení sama o sobě jsou bezpochyby skvělá a před prací na Aerodisku jsme s nimi realizovali několik integračních projektů. Ale jedno je realizovat konkrétní úkol pro jednoho zákazníka, vycvičit personál a možná zakoupit podporu od velkého dodavatele, a úplně něco jiného je vytvořit snadno reprodukovatelný produkt, který bude používán pro různé úkoly, o kterých možná jako dodavatel ani nebudeme vědět. Pro druhý cíl nám nevyhovovaly stávající open source produkty, a tak jsme se rozhodli vyvinout distribuovaný souborový systém sami.
Za dva roky díky úsilí několika vývojářů (kteří kombinovali práci na vAIR s prací na klasickém úložišti Engine) dosáhli určitého výsledku.
Do roku 2018 jsme napsali nejjednodušší souborový systém a doplnili ho o potřebné rozhraní. Systém spojoval fyzické (lokální) disky z různých serverů na základě vnitřního interkonektu do jednoho plochého poolu a "krájel" je na virtuální bloky, ze kterých byla dále vytvářena bloková zařízení s určitou úrovní odolnosti proti chybám, na kterých byly pomocí hypervisoru KVM vytvářeny a provozovány virtuální stroje.
Název souborového systému jsme nekomplikovali a jednoduše jsme ho nazvali ARDFS (uhodněte, co to znamená))
Tento prototyp vypadal dobře (samozřejmě ne vizuálně, tehdy ještě nebylo žádné vizuální zpracování) a vykazoval dobré výsledky co se týče výkonu a škálovatelnosti. Po prvním reálném výsledku jsme dali tomuto projektu zelenou, zorganizovali jsme plnohodnotné vývojové prostředí a tým, který se zabýval pouze vAIR.
Právě v té době byla dokončena celková architektura řešení, která dodnes neprodělala vážné změny.
Nahlížíme do souborového systému ARDFS
ARDFS je základem vAIR, který zajišťuje distribuované a redundantní uložení dat celého clusteru. Jednou z (ale ne jedinou) charakteristik ARDFS je to, že nepoužívá žádné další dedikovaných serverů pod metou a řízením. To bylo zamýšleno původně pro zjednodušení konfigurace řešení a pro jeho spolehlivost.
Struktura uložení
V rámci všech uzlů clusteru ARDFS organizuje logický pool z celého dostupného diskového prostoru. Je důležité chápat, že pool – to ještě nejsou data a neformátovaný prostor, ale pouze rozdělení, tedy jakékoliv uzly s nainstalovaným vAIRem se při přidání do clusteru automaticky přidávají do společného poolu ARDFS a diskové zdroje se automaticky stávají společnými pro celý cluster (a dostupnými pro budoucí uložení dat). Tento přístup umožňuje za chodu přidávat a odebírat uzly bez vážného vlivu na již fungující systém. Tedy systém se velmi snadno škáluje v "cihlách", přidáváním nebo odebíráním uzlů v clusteru podle potřeby.
Na pool ARDFS se přidávají virtuální disky (objekty uložení pro virtuální stroje), které se sestavují z virtuálních bloků o velikosti 4 megabajty. Na virtuálních discích se přímo ukládají data. Na úrovni virtuálních disků je taktéž nastavena schéma redundance.
Jak už bylo možné odhadnout, pro odolnost diskového subsystému nepoužíváme koncept RAID (Redundant array of independent Disks), ale používáme RAIN (Redundant array of independent Nodes). Tedy, odolnost je měřena, automatizována a řízena na základě uzlů, nikoli disků. Disky jsou samozřejmě také objektem úložiště, jsou, stejně jako všechno ostatní, monitorovány, lze s nimi provádět všechny standardní operace, včetně vytváření místního hardwarového RAIDu, ale klastry pracují výhradně s uzly.
V situaci, kdy velmi toužíte po RAIDu (například scénář, který podporuje více selhání na malých klastrech), nic nebrání použití místních RAID řadičů, a nad nimi vytvořit rozložené úložiště a RAIN architekturu. Takový scénář je zcela životaschopný a je námi podporován, proto o něm budeme hovořit v článku o typických scénářích použití vAIR.
Schémata odolnosti úložiště
Existují dvě schémata odolnosti virtuálních disků v vAIR:
1) Replication factor neboli jednoduše replikace – tato metoda odolnosti je jednoduchá „jako klacek a provaz“. Probíhá synchronní replikace mezi uzly s faktorem 2 (2 kopie na klastru) nebo 3 (3 kopie, odpovídajícím způsobem). RF-2 umožňuje virtuálnímu disku vydržet selhání jednoho uzlu v klastru, ale „sežere“ polovinu užitečného objemu, zatímco RF-3 vydrží selhání 2 uzlů v klastru, ale rezervuje si již 2/3 užitečného objemu pro své potřeby. Toto schéma velmi připomíná RAID-1, tedy virtuální disk nakonfigurovaný na RF-2 je odolný vůči selhání jakéhokoli jednoho uzlu klastru. V tomto případě bude s daty všechno v pořádku a dokonce i vstup-výstup se nezastaví. Když se selhaný uzel vrátí do provozu, začne automatické obnovování/synchronizace dat.
Níže jsou uvedeny příklady rozložení dat RF-2 a RF-3 v běžném provozu a v situaci selhání.
Máme virtuální stroj o velikosti 8 MB unikátních (užitečných) dat, který běží na 4 nodách vAIR. Je jasné, že v reálném světě nebude tak malý objem, ale pro schéma, které odráží logiku fungování ARDFS, je tento příklad nejlépe pochopitelný. AB – jsou virtuální bloky po 4 MB, obsahující unikátní data virtuálního stroje. Při RF-2 se vytvářejí dvě kopie těchto bloků A1+A2 a B1+B2, příslušně. Tyto bloky jsou „rozděleny“ mezi nody, aby se vyhnuly překrývání stejných dat na jedné nodě, to znamená, že kopie A1 nebude na jedné nodě s kopií A2. S B1 a B2 obdobně.
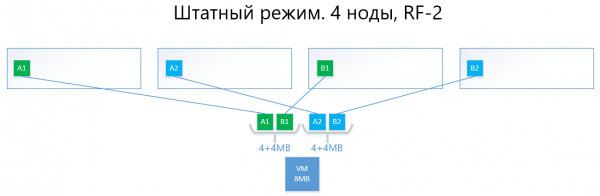
V případě selhání jedné z nod (například nody č. 3, kde se nachází kopie B1), bude tato kopie automaticky aktivována na nodě, kde není kopie její kopie (to znamená kopie B2).
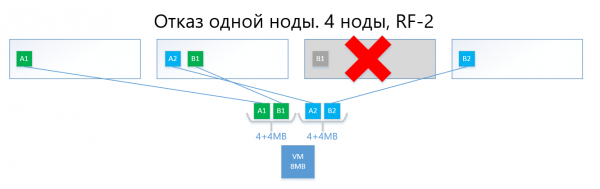
Díky tomu virtuální disk (a VM, příslušně) snadno přežije selhání jedné nod v schématu RF-2.
Schéma s replikací, i přes svou jednoduchost a spolehlivost, trpí stejnou nevýhodou jako RAID1 – málo užitečného prostoru.
2) Erasure coding nebo odstraňovací kódování (také známé pod názvy „redundantní kódování“, „mazací kódování“ nebo „kód redundancy“) existuje právě pro řešení výše uvedeného problému. EC – je schéma redundancy, které zajišťuje vysokou dostupnost dat při nižších nákladech na diskový prostor ve srovnání s replikací. Princip fungování tohoto mechanismu je podobný RAID 5, 6, 6P.
Při kódování proces EC dělí virtuální blok (ve výchozím nastavení 4 MB) na několik menších „datových kusů“ v závislosti na schématu EC (například schéma 2+1 dělí každý blok 4 MB na 2 kusy po 2 MB). Dále tento proces generuje pro „datové kusy“ „kusy parit“ o velikosti maximálně jedné z dříve rozdělených částí. Při dekódování EC generuje chybějící kusy, čtením „přeživších“ dat po celém clusteru.
Například virtuální disk se schématem EC 2+1, realizovaný na 4 nodech clusteru, bez problémů zvládne selhání jedné node v clusteru stejně jako RF-2. Přitom budou náklady nižší, konkrétně koeficient užitečné kapacity při RF-2 je 2, zatímco při EC 2+1 bude 1,5.
Jestliže to popíšeme jednodušeji, jde o to, že virtuální blok je rozdělen na 2-8 (proč od 2 do 8 viz níže) „kusů“, a pro tyto kusy se vypočítávají „kusy“ parity podobného objemu.
Data and parity are evenly distributed across all nodes of the cluster. Just like with replication, ARDFS automatically distributes data across nodes to prevent identical data (data copies and their parity) from being stored on the same node, thus eliminating the chance of losing data due to both the data and its parity being unexpectedly on the same storage node, which might fail.
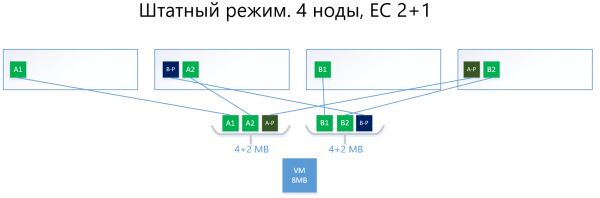
Below is an example with the same virtual machine of 8 MB and 4 nodes, but using the EC 2+1 scheme.
Blocks A and B are each divided into two pieces of 2 MB (into two because of 2+1), meaning A1+A2 and B1+B2. Unlike a replica, A1 is not a copy of A2; it is a virtual block A divided into two parts, and the same applies to block B. In total, we have two sets of 4 MB, each containing two two-megabyte pieces. Then, for each of these sets, parity is calculated, which does not exceed one piece (i.e., 2 MB), resulting in an additional + 2 pieces of parity (A-P and B-P). This gives us a total of 4×2 data + 2×2 parity.
Next, the pieces are "distributed" across the nodes so that the data does not overlap with their parity. That is, A1 and A2 will not reside on the same node as A-P.
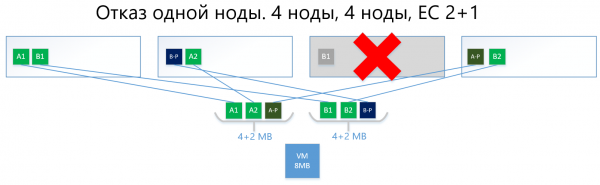
In the case of a failure of one node (let's say the third), the failed block B1 will be automatically restored from the parity B-P, which is stored on node No. 2, and will be activated on the node where there is no B-parity, i.e., the piece B-P. In this example, this is node No. 1.
I am sure the reader has a question:
"Everything you described has long been implemented by competitors and in open-source solutions; what distinguishes your EC implementation in ARDFS?"
Next, we will explore interesting features of ARDFS.
Erasure coding with a focus on flexibility.
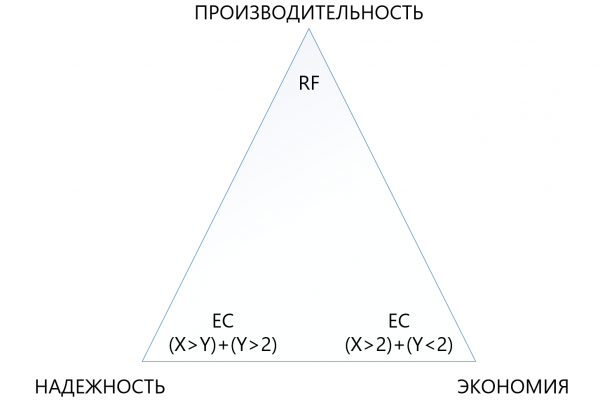
Initially, we provided a fairly flexible EC scheme X+Y, where X is a number from 2 to 8, and Y is a number from 1 to 8, but always less than or equal to X. This scheme is designed for flexibility. Increasing the number of data pieces (X) into which a virtual block is divided reduces overhead, thereby increasing useful space.
Increasing the number of parity pieces (Y) enhances the reliability of the virtual disk. The greater the value of Y, the more nodes in the cluster can fail. Naturally, increasing the volume of parity reduces the available capacity, but this is the price for reliability.
Závislost výkonu na EC schématech je téměř přímá: čím více "kousků", tím nižší výkon, zde je jasně potřeba vyvážený přístup.
Tento přístup umožňuje správcům maximálně flexibilně konfigurovat rozložené úložiště. V rámci ARDFS poolu lze používat jakékoli schéma odolnosti proti chybám a jejich kombinace, což je také velmi užitečné.
Níže je uvedena tabulka srovnání několika (ne všech možných) schémat RF a EC.
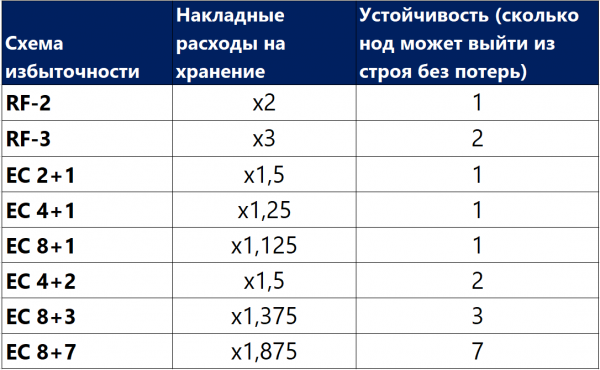
Z tabulky je jasné, že i ta nejsofistikovanější kombinace EC 8+7, která umožňuje ztrátu až 7 uzlů v clusteru, „zabírá“ méně užitečného prostoru (1,875 oproti 2) než standardní replikace, a chrání 7x lépe, což činí tento ochranný mechanismus sice složitějším, ale výrazně atraktivnějším v situacích, kdy je třeba zajistit maximální spolehlivost při nedostatku diskového prostoru. Je ovšem třeba mít na paměti, že každý „plus“ k X nebo Y nese dodatečné náklady na výkon, takže je třeba velmi pečlivě vybírat mezi spolehlivostí, úsporou a výkonem. Z tohoto důvodu věnujeme samostatný článek sizingu odstraňujícího kódování.
Spolehlivost a autonomnost souborového systému
ARDFS se lokálně spouští na všech uzlech clusteru a synchronizuje je prostřednictvím vlastních prostředků přes vyhrazené ethernetové rozhraní. Důležitým bodem je, že ARDFS synchronizuje nejen data, ale i metadata týkající se úložiště. Při práci na ARDFS jsme současně zkoumali řadu existujících řešení a zjistili jsme, že mnohé synchronizují metadata souborového systému pomocí externí distribuované DBMS, kterou také používáme pro synchronizaci, ale pouze konfigurací, nikoli metadata FS (o tom a dalších souvisejících subsystémech v příštím článku).
Synchronizace metadat FS pomocí externí DB je samozřejmě funkční řešení, ale v takovém případě by konzistence dat uložených na ARDFS závisela na externí DB a jejím chování (a ta, abychom byli upřímní, je dost rozmarná), což považujeme za problematické. Proč? Pokud dojde k poškození metadat FS, samotné údaje FS by také mohly říct "sbohem", proto jsme se rozhodli zvolit složitější, ale spolehlivější cestu.
Podsystem pro synchronizaci metadat pro ARDFS jsme vyvinuli sami, a funguje zcela nezávisle na sousedních subsystémech. Tj. žádný jiný subsystém nemůže poškodit data ARDFS. Naše přesvědčení je, že toto je nejspolehlivější a správná cesta, ale jak to vlastně bude, ukáže čas. Kromě toho, s tímto přístupem vzniká další výhoda. ARDFS lze použít nezávisle na vAIR, jednoduše jako rozšířenou úložnou jednotku, což určitě využijeme v budoucích produktech.
Vývojem ARDFS jsme získali flexibilní a spolehlivý souborový systém, který nabízí možnost, kde lze ušetřit na kapacitě nebo investovat vše do výkonu, nebo vytvořit úložiště s vysokou spolehlivostí za rozumnou cenu, ale s nižšími požadavky na výkon.
Spolu s jednoduchou licenční politikou a flexibilním modelem dodávky (v předstihu, licence vAIR se udělují podle uzlů, a dodává se buď softwarově, nebo jako AP) to umožňuje velmi přesně přizpůsobit řešení různým požadavkům zákazníků a následně snadno udržovat tuto rovnováhu.
Komu je tento zázrak určen?
Na jedné straně lze říci, že na trhu již existují hráči, kteří mají vážná řešení v oblasti hyperkonvergence, a kam vlastně jdeme. Zdá se, že toto tvrzení je pravdivé, ALE...
Na druhé straně, když jdeme 'do terénu' a komunikujeme se zákazníky, my i naši partneři vidíme, že to není tak. Úloh pro hyperkonvergenci je celá řada, někde lidé jednoduše nevěděli, že taková řešení existují, někde se to zdálo drahé, někde byly neúspěšné testy alternativních řešení, a někde je zakázáno nákupy, kvůli sankcím. Celkově se ukázalo, že pole je neorané, takže jsme se pustili do jeho obdělávání))).
Kdy je SDD lépe než GCS?
Při práci s trhem se nás často ptají, kdy je nejlepší použít tradiční schéma se SSK a kdy hyperkonvergenci? Mnohé společnosti výrobci GKS (zvláště ty, které nemají SSK ve svém portfoliu) říkají: „SSK má za sebou poslední léta, hyperkonvergence je cesta vpřed!“. To je odvážné tvrzení, ale ne zcela odráží realitu.
Pravda je, že trh SSK se skutečně posouvá směrem k hyperkonvergenci a podobným řešením, ale vždy je tu „ale“.
Za prvé, vybudované datové centra a IT infrastruktury podle tradičního schématu se SSK tak snadno nepřestavíte, takže modernizace a dostavba takových infrastruktur to bude ještě zátěž na 5-7 let.
Za druhé, většina infrastruktur, které se nyní vybudovávají (máme na mysli RF), je postavena podle tradičního schématu s použitím SSK, a to ne proto, že by lidé nevěděli o hyperkonvergenci, ale protože trh hyperkonvergence je nový, řešení a standardy ještě nejsou ustáleny, IT specialisté nejsou ještě vyškoleni, zkušeností je málo a datová centra je potřeba budovat tady a teď. A tento trend potrvá ještě 3-5 let (a pak další zátěž, viz bod 1).
Za třetí, existuje čistě technické omezení v dalších malých zpožděních 2 milisekundy při zápisu (kromě lokálního cachování, samozřejmě), což je cena za distribuované ukládání.
A nezapomeňme na použití velkých fyzických serverů, které upřednostňují vertikální škálování diskového subsystému.
Existuje mnoho důležitých a populárních úloh, kde se SSK chová lépe než GKS. S tím se samozřejmě neshodnou ti výrobci, kteří mají ve svém produktovém portfoliu žádné SSK, ale jsme připraveni argumentovaně se hádat. Samozřejmě my, jako vývojáři obou produktů, v jednom z budoucích publikací určitě provedeme srovnání SSK a GKS, kde názorně ukážeme, co je v jakých podmínkách lepší.
A kde budou hyperkonvergovaná řešení fungovat lépe než SSK?
Na základě výše uvedených tezí lze učinit tři zřejmé závěry:
- Tam, kde je dodatečných 2 milisekundy zpoždění při zápisu, které se stabilně vyskytují v jakémkoli produktivním prostředí (teď nemluvíme o syntetice, na syntetice může být i nanosekundy), jsou nekritické, hyperkonvergence bude vhodná.
- Tam, kde je možné přetvořit zátěž z velkých fyzických serverů na mnoho malých virtuálních a rozložit ji po uzlech, tam také hyperkonvergované řešení dobře zapadne.
- Tam, kde je horizontální škálování důležitější než vertikální, tam také GKS skvěle uspěje.
Jaké jsou to řešení?
- Všechny standardní infrastrukturní služby (služba adresářů, e-mail, EDS, souborové servery, malé nebo střední ERP a BI systémy atd.). Tomu říkáme „společné výpočty“.
- Infrastruktura cloudových poskytovatelů, kde je třeba rychle a standardizovaně horizontálně rozšiřovat a snadno "snižovat" velké množství virtuálních strojů pro klienty.
- Infrastruktura virtuálních pracovních ploch (VDI), kde se spouští mnoho malých uživatelských virtuálek a klidně "plavou" uvnitř jednotného clusteru.
- Pobočkové sítě, kde je v každé pobočce třeba získat standardní, vysoce odolnou, ale přitom levnou infrastrukturu z 15-20 virtuálních strojů.
- Jakékoli distribuované výpočty (například big data služby). Tam, kde zátěž jde ne "do hloubky", ale "do šířky".
- Testovací prostředí, kde jsou přípustné dodatečné malé zpoždění, ale existují rozpočtová omezení, protože se jedná o testy.
V současné době jsme právě pro tyto úkoly vytvořili AERODISK vAIR a na ně se soustředíme (zatím úspěšně). Možná, že se to brzy změní, protože svět nestojí na místě.
Takže...
Tímto končí první část velkého cyklu článků, v následujícím článku se podělíme o architekturu řešení a používané komponenty.
Budeme rádi za otázky, návrhy a konstruktivní diskuse.
Zdroj: habr.com
