

Představujeme vám třetí část překladu materiálu o cestě, kterou prošla společnost Dropbox při zavádění systému kontroly typů kódu Python.
→ Předchozí části: a
Dosáhnout 4 milionů řádků typizovaného kódu
Dalším důležitým úkolem (toto byla druhá nejpopulárnější otázka, která trápila ty, kteří se účastnili interních anket) bylo zvýšení objemu kódu v Dropboxu pokrytého kontrolami typů. Vyzkoušeli jsme několik přístupů k vyřešení tohoto úkolu — od přirozeného růstu objemu typizované kódové základny po zaměření úsilí členů týmu mypy na statické a dynamické automatizované odvozování typů. Nakonec vznikl dojem, že neexistuje jednoduchá vítězná strategie, ale dokázali jsme dosáhnout rychlého růstu objemu anotovaného kódu kombinací různých přístupů.
V důsledku toho v našem největším Python repozitáři (s backendovým kódem) dosáhl počet řádků anotovaného kódu téměř 4 miliony. Práce na statické typizaci kódu probíhala zhruba tři roky. Mypy nyní podporuje různé typy zpráv o pokrytí kódu typy, které usnadňují sledování postupu typizace. Zejména můžeme generovat zprávy o kódu s nejistotami v typech, jako jsou například explicitní použití typu Jakékoli v anotacích, které nelze ověřit, nebo jako jsou importy externích knihoven, které nemají anotace typů. V rámci projektu na zlepšení přesnosti kontroly typů v Dropboxu jsme přispěli k vylepšení definic typů (takzvaných stub souborů) pro některé populární open-source knihovny do centralizovaného Python repozitáře .
Implementovali jsme (a standardizovali v následujících PEP) nové funkce systému typů, které umožňují používat přesnější typy pro některé specifické vzory Pythonu. Významným příkladem toho je TypeDict, který poskytuje typy pro JSON-podobné slovníky, které mají pevnou sadu řetězcových klíčů, z nichž každý má hodnotu vlastního typu. Budeme pokračovat v rozšiřování systému typů. Pravděpodobně naším dalším krokem bude zlepšení podpory funkcí Pythonu pro práci s čísly.
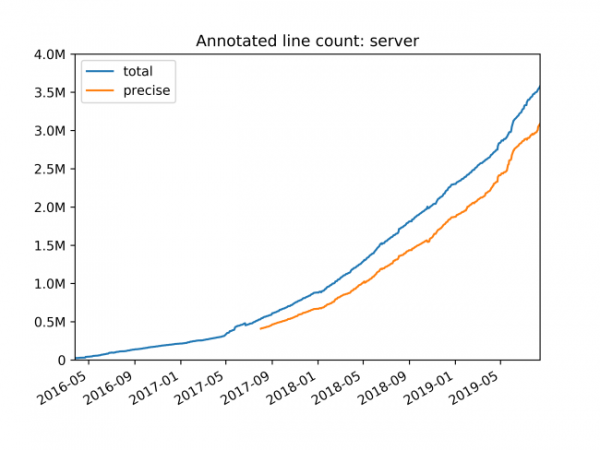
Počet řádků anotovaného kódu: server
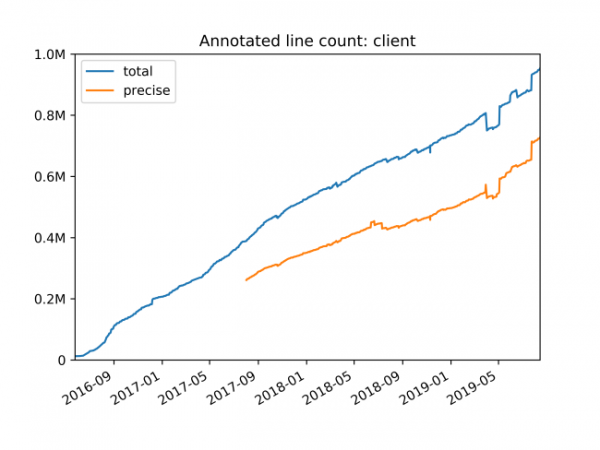
Počet řádků anotovaného kódu: klient
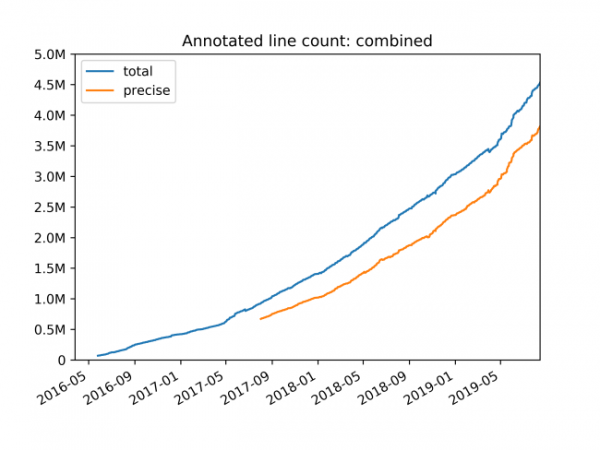
Celkový počet řádků anotovaného kódu
Zde je přehled hlavních funkcí akcí, které jsme podnikli k zvýšení objemu anotovaného kódu v Dropboxu:
Přísnost anotování. Postupně jsme zvyšovali požadavky na přísnost anotování nového kódu. Začali jsme doporučeními linteru, která navrhovala přidávat anotace do souborů, které už měly některé anotace. Nyní vyžadujeme přítomnost typových anotací v nových Python souborech a ve většině stávajících souborů.
Zprávy o typování. Každý týden rozesíláme týmům zprávy o úrovni typování jejich kódu a poskytujeme rady, co by mělo být prioritně anotováno.
Popularizace mypy. Hovoříme o mypy na různých akcích a komunikujeme s týmy, abychom jim pomohli začít používat anotace typů.
Průzkumy. Provádíme pravidelné průzkumy uživatelů, abychom zjistili hlavní problémy. Jsme připraveni jít dost daleko v řešení těchto problémů (až po vytvoření nového jazyka pro urychlení mypy!).
Výkon. Významně jsme zlepšili výkon mypy díky použití démona a mypyc. Bylo to provedeno, abychom zmírnili nepříjemnosti, které se objevily při anotování, a abychom mohli pracovat s velkými objemy kódu.
Integrace s editory. Vytvořili jsme nástroje pro podporu spuštění mypy v editorech, které jsou populární v Dropboxu. Patří sem PyCharm, Vim a VS Code. Toto výrazně zjednodušilo proces anotace kódu a jeho ověřování. Tyto akce jsou běžné při anotaci existujícího kódu.
Statická analýza. Vytvořili jsme nástroj pro výstup podpisů funkcí pomocí nástrojů statické analýzy. Tento nástroj funguje pouze v relativně jednoduchých situacích, ale pomohl nám snadno zvýšit pokrytí kódu typy.
Podpora třetích stran. V mnoha našich projektech používáme sadu nástrojů SQLAlchemy. V něm se používají dynamické vlastnosti Pythonu, které typy PEP 484 nejsou schopny přímo modelovat. V souladu s PEP 561 jsme vytvořili odpovídající stub soubor a napsali plugin pro mypy.), zlepšující podporu SQLAlchemy.
Obtíže, se kterými jsme se setkali
Cesta k 4 milionům řádků typovaného kódu nám nikdy nepřišla snadná. Během této cesty jsme narazili na řadu problémů a udělali několik chyb. Zde je několik problémů, se kterými jsme se setkali. Doufáme, že náš příběh pomůže jiným vyhnout se podobným potížím.
Chybějící soubory. Začínali jsme s testováním pouze malého objemu souborů. Vše, co nebylo v tomto počtu zahrnuto, se netestovalo. Součásti byly do testovacího seznamu přidávány, jakmile se v nich objevily první anotace. Pokud něco pocházelo z modulu, který byl mimo testovací oblast, šlo o práci s hodnotami typu Jakékoli, které se vůbec netestovaly. To vedlo k významné ztrátě přesnosti typování, zejména v raných fázích migrace. Tento přístup přesto fungoval překvapivě dobře, ačkoliv typickou situací bylo, že přidání souborů do testovací oblasti odhalilo problémy v jiných částech kódové základny. V nejhorším případě, když byly spojeny dvě izolované oblasti kódu, ve kterých byly typy již nezávisle ověřeny, vyšlo najevo, že typy těchto oblastí byly vzájemně nekompatibilní. To vedlo k nutnosti provést mnoho změn v anotacích. Dnes, když se ohlížíme zpět, chápeme, že jsme měli co nejdříve přidat základní knihovní moduly do testovací oblasti typů mypy. To by naši práci učinilo mnohem předvídatelnější.
Anotace starého kódu. Když jsme začali pracovat, měli jsme přibližně 4 miliony řádků již existujícího Python kódu. Bylo jasné, že anotace tohoto kódu je úkol, který není zrovna jednoduchý. Vytvořili jsme nástroj nazvaný PyAnnotate, který dokáže shromažďovat informace o typech během testování a přidávat anotace typů do kódu na základě shromážděných informací. Nicméně jsme si nevšimli, že by se tento nástroj obzvláště široce rozšířil. Shromažďování informací o typech bylo pomalé a automaticky generované anotace často vyžadovaly spoustu ručních oprav. Přemýšleli jsme o automatickém spuštění tohoto nástroje při každé kontrole kódu nebo o shromažďování informací o typech na základě analýzy určitého menšího objemu skutečných síťových požadavků, ale rozhodli jsme se to neudělat, protože jakýkoli z těchto přístupů by byl příliš riskantní.
Na závěr lze říci, že většina kódu byla manuálně anotována jeho vlastníky. Abychom tento proces nasměrovali správným směrem, připravujeme zprávy o zvlášť důležitých modulech a funkcích, které je třeba anotovat. Například je důležité opatřit anotacemi typů knihovní modul, který se používá na stovkách míst. Starou službu, kterou nahrazuje nová, však už není tak důležité anotovat. Kromě toho experimentujeme s využitím statické analýzy pro generování anotací typů pro starý kód.
Cyklické importy. Už jsem mluvil o cyklických importech (o „uzlících závislostí“), jejichž existence zkomplikovala zrychlení mypy. Museli jsme se také důkladně věnovat podpoře všech typů idiomů, jejichž vznik způsobují tyto cyklické importy. Nedávno jsme dokončili velký projekt redesignu systému, který opravil většinu problémů mypy souvisejících s cyklickými importy. Tyto problémy ve skutečnosti vycházely z velmi raných dní projektu, ještě z Alore, testovacího jazyka, na který byl projekt mypy původně zaměřen. Syntax Alore usnadňuje řešení problémů s cyklickými příkazy importu. Moderní mypy zdědil některá omezení ze své rané prosté implementace (která byla skvělá pro Alore). Python ztěžuje práci s cyklickými importy především kvůli nejasnostem výrazu. Například během přiřazení hodnoty může být ve skutečnosti definován alias typu. Mypy není vždy schopen takové věci odhalit, dokud většina cyklu importu není zpracována. V Alore takové nejasnosti nebyly. Neúspěšná rozhodnutí učiněná v raných fázích vývoje systému mohou programátorovi přinést nemilé překvapení po mnoha letech.
Úspěchy: cesta k 5 milionům řádků kódu a k novým horizontům
Projekt mypy urazil dlouhou cestu – od raných prototypů k systému, který kontroluje typy výrobního kódu o objemu 4 milionů řádků. Během vývoje mypy byla standardizována doporučení pro typy v Pythonu. Dnes kolem typizace Python kódu vznikl silný ekosystém. Místo zde má podpora knihoven, jsou zde nástroje pro IDE a editory, existuje několik systémů kontroly typů, z nichž každý má své výhody a nevýhody.
I když je kontrola typů již v Dropboxu považována za samozřejmost, jsem si jistý, že stále žijeme na prahu typizace Python kódu. Myslím, že technologie kontroly typů budou i nadále vyvíjeny a zdokonalovány.
Pokud jste dosud nevyužívali kontroly typů ve svém velkém Python projektu, vězte, že nyní je velmi vhodná doba na přechod na statickou typizaci. Hovořil jsem s těmi, kteří tento přechod uskutečnily. Nikdo z nich toho nelitoval. Kontrola typů dělá z Pythonu jazyk, který je mnohem lépe přizpůsoben pro vývoj velkých projektů než "běžný Python".
Vážení čtenáři! Používáte kontrolu typů ve svých Python projektech?
Zdroj: habr.com
