

Zabbix je monitorovací systém. Jako každý jiný systém čelí třem hlavním problémům všech monitorovacích systémů: shromažďování a zpracování dat, uchovávání historie a její údržba.
Fáze získávání, zpracování a ukládání dat zabere čas. Trochu, ale pro velký systém to může znamenat velké zpoždění. Problém uchovávání představuje otázku přístupu k datům. Ta se používají pro reporty, kontroly a spouštěče. Zpoždění při přístupu k datům také ovlivňuje výkon. Když se databáze zvětšují, zastaralá data je potřeba odstranit. Odstranění je náročná operace, která také spotřebovává část zdrojů.
Problémy se zpožděním při shromažďování a uchovávání v Zabbixu se řeší kešováním: několik typů keší, kešování v databázi. Pro řešení třetího problému však kešování nevyhovuje, a proto v Zabbixu používají TimescaleDB. O tom poví Andrej Guščin — inženýr technické podpory . V technické podpoře Zabbixu pracuje Andrej více než 6 let a přímo se setkává s výkonem.
Jak TimescaleDB funguje, jaký výkon může poskytnout ve srovnání s běžným PostgreSQL? Jakou roli hraje Zabbix pro databáze TimescaleDB? Jak spustit od nuly a jak migrovat z PostgreSQL a jaká konfigurace má nejlepší výkon? O všem tomto podrobně níže.

Výzvy výkonu
Každý monitorovací systém čelí určitým výzvám výkonu. Řeknu vám o třech z nich: shromažďování a zpracování dat, uchovávání a údržba historie.
Rychlé shromažďování a zpracování dat. Dobrý monitorovací systém by měl rychle získávat všechny údaje a zpracovávat je podle triggerových výrazů — podle svých kritérií. Po zpracování by měl systém také rychle uložit tato data do databáze, aby je později mohl využít.
Uchovávání historie. Dobrý monitorovací systém by měl uchovávat historii v databázi a poskytovat snadný přístup k metrikám. Historie je potřebná pro využití v reportech, grafech, triggerových prvcích, prahových hodnotách a vypočítávaných datových prvcích pro upozornění.
Údržba historie. Někdy nastane den, kdy nemusíte uchovávat metriky. Proč potřebujete data, která byla shromážděna před 5 lety, měsíc nebo dva: některé uzly byly odstraněny, některé hostitele nebo metriky už nejsou potřeba, protože jsou zastaralé a přestaly se shromažďovat. Dobrý monitorovací systém by měl uchovávat historická data a čas od času je odstraňovat, aby se databáze nevyrostla.
Odstranění zastaralých dat je naléhavá otázka, která má velký dopad na výkon databáze.
Kešování v Zabbixu
Ve Zabbixu byly první a druhé volání vyřešeny pomocí kešování. Pro shromažďování a zpracování dat se používá operační paměť. Pro uchovávání — historie v spouštěčích, grafech a počítaných datech. Na straně databáze existuje určité kešování pro hlavní výběry, například grafech.
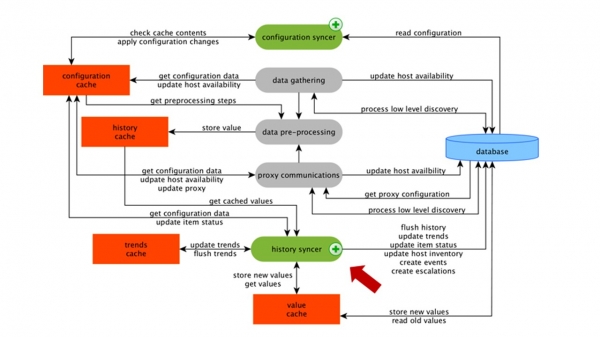
Kešování na straně samotného Zabbix serveru je:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Podívejme se na ně podrobněji.
ConfigurationCache
To je hlavní keš, ve které uchováváme metriky, hostitele, datové prvky, spouštěče — vše, co je potřeba pro PreProcessing a pro shromažďování dat.
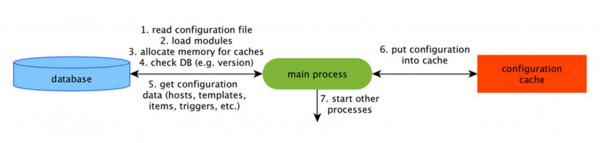
Všechny tyto informace jsou uchovávány v ConfigurationCache, aby nebyly vytvářeny zbytečné dotazy do databáze. Po spuštění serveru tento keš aktualizujeme, vytváříme a pravidelně aktualizujeme konfigurace.
Sběr dat
Schéma je dost rozsáhlé, ale hlavní je, že shromažďovače. Jsou to různé „pollery“ — procesy shromažďování. Ty odpovídají za různé typy shromažďování: shromažďují data přes SNMP, IPMI a předávají je na PreProcessing.
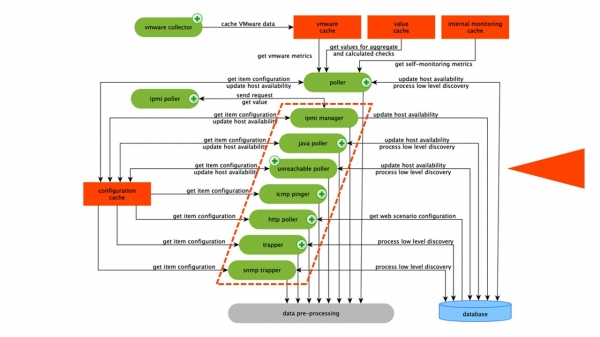 Shromažďovače jsou orámovány oranžovou linkou.
Ve Zabbixu existují počítané agregované datové prvky, které jsou potřebné k agregaci kontrol. Pokud je máme, bereme data pro ně přímo z ValueCache.
PreProcessing HistoryCache
Všechny shromažďovače používají ConfigurationCache, aby získaly úkoly. Dále je předávají na PreProcessing.
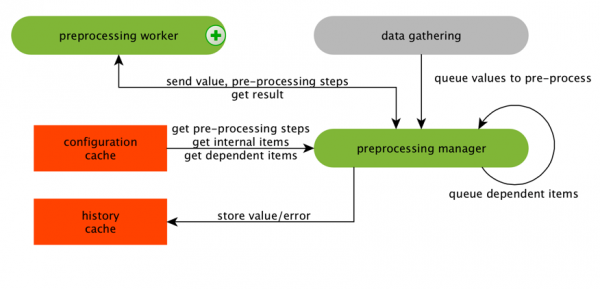
PreProcessing používá ConfigurationCache, aby získal kroky PreProcessing. Zpracovává tato data různými způsoby.
Po zpracování dat pomocí PreProcessing je ukládáme do HistoryCache, abychom je mohli zpracovat. Na tomto konci shromažďování dat přecházíme k hlavnímu procesu v Zabbixu — history syncer, jelikož se jedná o monolitní architekturu.
Poznámka: PreProcessing je dost náročná operace. Od verze 4.2 byl přesunut na proxy. Pokud máte velmi velký Zabbix s velkým množstvím datových prvků a frekvencí shromažďování, výrazně to usnadňuje práci.
ValueCache, history & trends cache
Synchronizátor historie je hlavní proces, který atomárně zpracovává každý datový prvek, tedy každou hodnotu.
Synchronizátor historie získává hodnoty z HistoryCache a kontroluje v konfiguraci přítomnost spouštěčů pro výpočty. Pokud nějaké existují, provádí výpočty.
Synchronizátor historie vytváří událost, eskalaci, aby v případě potřeby podle konfigurace generoval upozornění, a zaznamenává je. Pokud existují spouštěče pro následné zpracování, pamatuje si tuto hodnotu v ValueCache, aby nemusel přistupovat k tabulce historie. Tím se ValueCache plní daty, která jsou potřebná pro výpočty spouštěčů a vypočítávaných prvků.
Synchronizátor historie zapisuje všechna data do databáze, a ta pak na disk. Proces zpracování tímto končí.
Kešování v databázi
Na straně databáze existují různé keše, když chcete sledovat grafy nebo zprávy o událostech:
Innodb_buffer_poolna straně MySQL;shared_buffersna straně PostgreSQL;effective_cache_sizena straně Oracle;shared_poolna straně DB2.
Existuje také mnoho dalších keší, ale toto jsou hlavní pro všechny databáze. Umožňují uchovávat v operační paměti data, která jsou často potřebná pro dotazy. Mají své technologie pro toto.
Výkon databáze je kriticky důležitý.
Zabbix server neustále shromažďuje data a zapisuje je. Při restartu také čte z historie, aby naplnil ValueCache. Skripty a zprávy používá Zabbix API, které je postaveno na základě webového rozhraní. Zabbix API se obrací na databázi a získává potřebná data pro grafy, zprávy, seznamy událostí a poslední problémy.
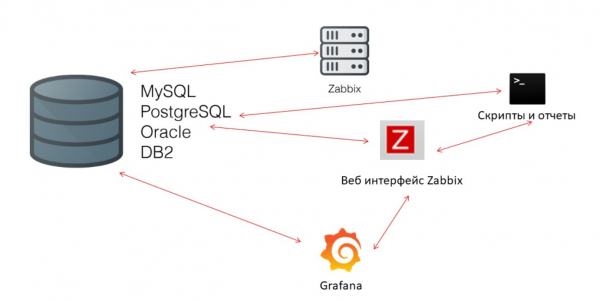
Pro vizualizaci — Grafana. Mezi našimi uživateli je to populární řešení. Umí přímo posílat dotazy přes Zabbix API jak do databáze, tak generuje určitou konkurenci pro získávání dat. Proto je potřeba jemnější a lepší nastavení databáze, aby vyhovovalo rychlému vydávání výsledků a testování.
Housekeeper
Třetí výzvou pro výkon v Zabbixu je úklid historie pomocí housekeeperu. Dodržuje všechna nastavení — v datových prvcích je uvedeno, jak dlouho uchovávat dynamiku změn (trendů) v dnech.
TrendsCache vypočítáváme za běhu. Při příjmu dat je agregujeme za jednu hodinu a zapisujeme do tabulek pro dynamiku změn trendů.
Housekeeper se spouští a odstraňuje informace z databáze běžnými 'selecty'. To není vždy efektivní, což lze poznat z grafů výkonu vnitřních procesů.
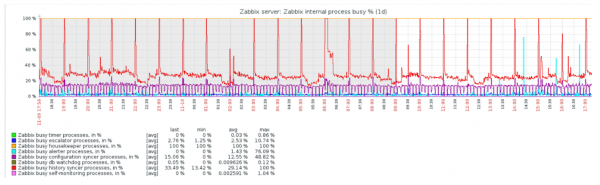
Červená křivka ukazuje, že synchronizátor historie je stále zaměstnán. Oranžová křivka nahoře představuje Housekeeper, který se neustále spouští. Čeká na databázi, kdy odstraní všechny řádky, které určil.
Kdy byste měli vypnout Housekeeper? Například máte 'Item ID' a potřebujete odstranit posledních 5 tisíc řádků za určité období. Samozřejmě, že se to děje podle indexů. Ale obvykle je dataset velmi velký a databáze stejně čte z disku a načítá do cache. To je vždy velmi nákladná operace pro databázi a v závislosti na velikosti databáze může vést k problémům s výkonem.
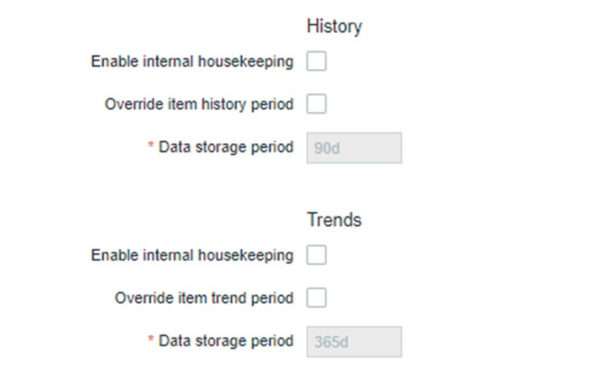
Housekeeper lze jednoduše vypnout. V webovém rozhraní je nastavení v 'Administration general' pro Housekeeper. Vypneme interní housekeeping pro interní historii trendů a on už tímto více neřídí.
Když jsme vypnuli Housekeeper a grafy se vyrovnaly — jaké mohou být v tomto případě problémy a co může pomoci v řešení třetího výzvy výkonu?
Partitioning — sekcionování nebo partioning
Obvykle se sekcionování nastavuje různými způsoby na každé relační databázi, kterou jsem uvedl. Každá má svou technologii, ale jsou celkově podobné. Vytvoření nové partition často vede k určitým problémům.
Obvykle se partitiony nastavují v závislosti na 'setup' — počtu dat, které jsou vytvářeny za jeden den. Obvykle se partitioning nastavuje na jeden den, což je minimum. Pro trendy nové partition — na 1 měsíc.
Hodnoty se mohou měnit v případě velmi velkého 'setup'. Pokud je malý 'setup' — do 5 000 nvps (nových hodnot za sekundu), střední — od 5 000 do 25 000, pak velký — nad 25 000 nvps. To jsou velké a velmi velké instalace, které vyžadují pečlivé nastavení přesně databáze.
Na velmi velkých instalacích úsek za jeden den nemusí být optimální. Viděl jsem na MySQL partitiony po 40 GB a více za den. To je velmi velký objem dat, který může vést k problémům, a je třeba ho zmenšit.
Co přináší partitioning?
Sekcionování tabulek. Často jsou to samostatné soubory na disku. Plán dotazů optimálněji vybírá jednu partition. Obvykle se partitioning používá podle rozsahu — pro Zabbix to platí také. Používáme tam 'timestamp' — čas od začátku éry. U nás to jsou obyčejná čísla. Určíte začátek a konec dne — to je partition.
Rychlé odstranění — DELETEVybírá se jeden soubor/subtabulka, nikoli výběr řádků k odstranění.
Výrazně zrychluje výběr dat. nebude prováděn při nepravdivosti první podmínky. Opravy pomocí — používá jednu nebo více partií, nikoli celou tabulku. Pokud žádáte o data dvoudenní starosti, jsou vybírána z DB rychleji, protože je třeba do cache načíst a vydat pouze jeden soubor, nikoli velkou tabulku.
Často také urychluje mnoho DB. INSERT — vkládání do child-tabulek.
TimescaleDB
Ve verzi 4.2 jsme se zaměřili na TimescaleDB. To je rozšíření pro PostgreSQL s nativním rozhraním. Rozšíření efektivně pracuje s časovými řadami, přičemž neztrácí výhody relačních DB. TimescaleDB také automaticky particionuje.
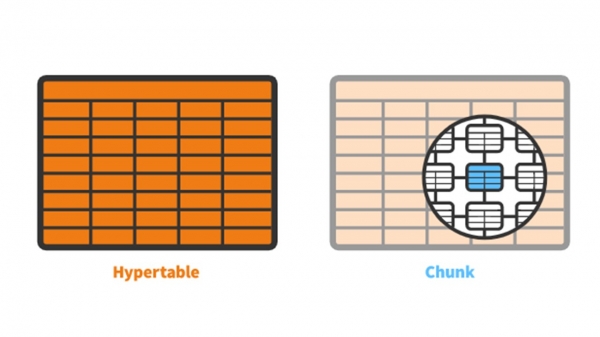
V TimescaleDB existuje pojem hypertabulka (hypertable), kterou vytváříte. Obsahuje chunky — partie. Chunky jsou automaticky řízené fragmenty hypertabulky, které neovlivňují ostatní fragmenty. Každý chunk má svůj vlastní časový rozsah.
TimescaleDB vs PostgreSQL
TimescaleDB pracuje skutečně efektivně. Výrobci rozšíření tvrdí, že používají správnější algoritmus pro zpracování dotazů, zejména <code>inserts</code>. Když velikosti dataset-vkládání rostou, algoritmus udržuje konstantní výkon.
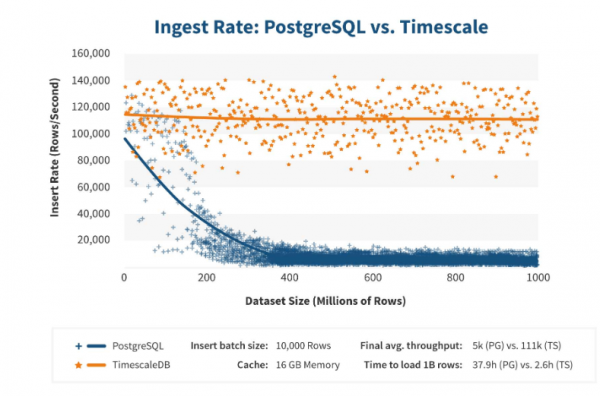
Po 200 milionech řádků obvykle PostgreSQL začíná výrazně zpomalovat a ztrácí výkon až na 0. TimescaleDB umožňuje efektivně vkládat "inserts" při jakémkoli objemu dat.
Instalace
Nainstalovat TimescaleDB je dost snadné pro jakékoli balíčky. V je vše podrobně popsáno — závisí na oficiálních balíčcích PostgreSQL. TimescaleDB lze také sestavit a zkompilovat ručně.
Pro DB Zabbix jednoduše aktivujeme rozšíření:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Aktivujete rozšíření a vytvoříte ho pro DB Zabbix. Posledním krokem je vytvoření hypertabulky.
Migrace tabulek historie na TimescaleDB
K tomu existuje speciální funkce create_hypertable:
VYBERTE create_hypertable(‘history’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VYBERTE create_hypertable(‘history_unit’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VYBERTE create_hypertable(‘history_log’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VYBERTE create_hypertable(‘history_text’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VYBERTE create_hypertable(‘history_str’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VYBERTE create_hypertable(‘trends’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
VYBERTE create_hypertable(‘trends_unit’, ‘clock’, chunk_time_interval => 86400, migrate_data => true);
AKTUALIZUJTE config SET db_extension=’timescaledb’, hk_history_global=1, hk_trends_global=1
Funkce má tři parametry. První — tabulka v databázi, pro kterou je třeba vytvořit hypertabuli. Druhý — pole, podle kterého je třeba vytvořit chunk_time_interval — interval chunků pro partition, které mají být použity. V mém případě je interval jeden den — 86 400.
Třetí parametr — migrovat_data. Pokud se nastaví true, pak se všechna aktuální data přesunou do předem vytvořených chunků. Osobně jsem použil migrovat_data. Měl jsem asi 1 TB, což trvalo více než hodinu. I v některých případech jsem během testování odstraňoval nepotřebná historická data symbolických typů, abych je nemusel přesouvat.
Poslední krok — AKTUALIZACE: v db_extension nastavit timescaledb, aby databáze chápala, že má toto rozšíření. Zabbix ho aktivuje a správně využívá syntax a dotazy již k databázi — ty funkce, které jsou nutné pro TimescaleDB.
Konfigurace hardwaru
Použil jsem dva servery. První — VMware stroj. Je docela malý: 20 procesorů Intel® Xeon® CPU E5-2630 v 4 @ 2.20GHz, 16 GB RAM a SSD disk o velikosti 200 GB.
Na něm jsem nainstaloval PostgreSQL 10.8 s OS Debian 10.8-1.pgdg90+1 a souborovým systémem xfs. Vše bylo minimálně nastaveno, aby se používala právě tato databáze, kromě toho, co bude používat sám Zabbix.
Na této stejné mašině běžel Zabbix server, PostgreSQL a loadovací agenty. Měl jsem 50 aktivních agentů, kteří používali LoadableModule, aby velmi rychle generovali různé výsledky: čísla, řetězce. Naplnil jsem databázi velkým množstvím dat.
Původní konfigurace obsahovala 5 000 položek dat na každý host. Téměř každá položka měla spouštěč, aby to bylo podobné reálným instalacím. V některých případech bylo více než jeden spouštěč. Na jeden uzel sítě připadalo 3 000-7 000 spouštěčů.
Interval aktualizace položek dat — 4-7 sekundZatížení jsem reguloval nejen pomocí 50 agentů, ale také přidáváním dalších. Pomocí datových prvků jsem dynamicky reguloval zatížení a snižoval interval aktualizace na 4 s.
PostgreSQL. 35 000 nvps
První spuštění na tomto zařízení jsem měl s čistým PostgreSQL — 35 tisíc hodnot za sekundu. Jak je vidět, vložení dat zabere zlomky sekundy — všechno jde hladce a rychle. Jediné, co, je, že SSD disk o kapacitě 200 GB se rychle zaplňuje.
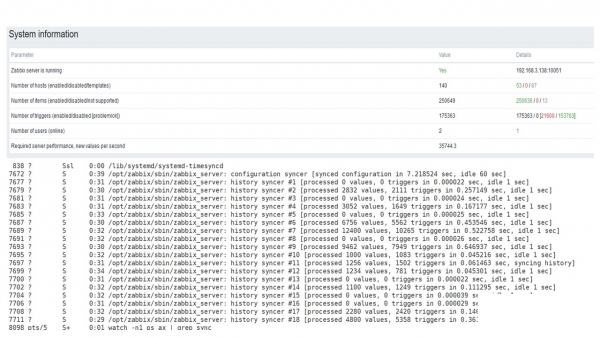
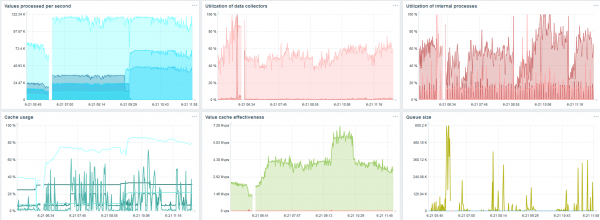
To je standardní přehled výkonnosti Zabbix — serverů.
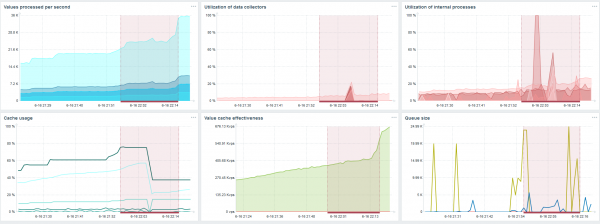
První modrý graf — počet hodnot za sekundu. Druhý graf vpravo — zatížení procesů shromažďování. Třetí — zatížení interních procesů shromažďování: history syncers a Housekeeper, který zde běžel dostatečně dlouho.
Čtvrtý graf ukazuje využití HistoryCache. To je jakýsi buffer před vložením do DB. Zelený pátý graf ukazuje využití ValueCache, tedy kolik hitů ValueCache pro spouštěče — to je několik tisíc hodnot za sekundu.
PostgreSQL. 50 000 nvps
Pak jsem zvýšil zátěž na 50 tisíc hodnot za sekundu na tomto stejném zařízení.
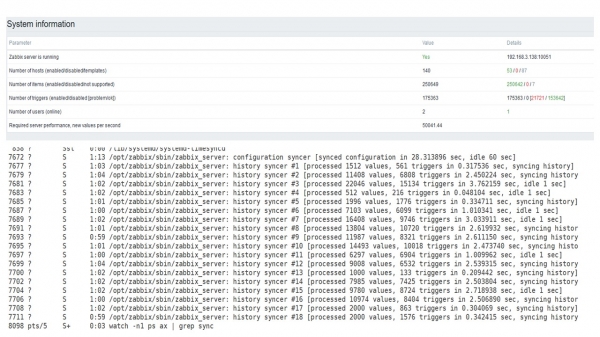
Při zatížení s Housekeeperem bylo vložení 10 tisíc hodnot zapisováno za 2-3 s.
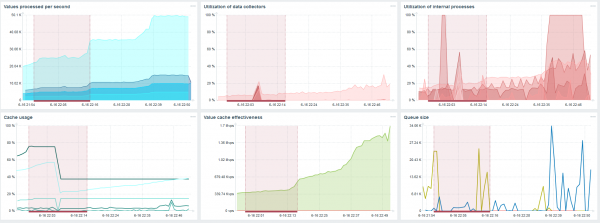
Housekeeper už začíná narušovat práci.
Na třetím grafu je patrné, že celkově zatížení trapperů a history syncers je stále na úrovni 60 %. Na čtvrtém grafu HistoryCache během práce Housekeepera již začíná poměrně aktivně plnit. Naplnil se na 20 % — to je asi 0,5 GB.
PostgreSQL. 80 000 nvps
Dále jsem zvýšil zátěž na 80 tisíc hodnot za sekundu. To je přibližně 400 tisíc datových prvků a 280 tisíc spouštěčů.
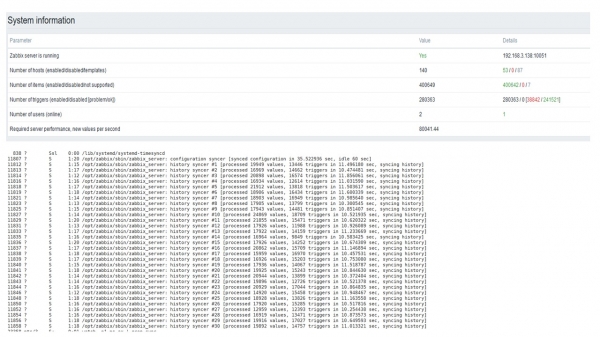
Vložení při zatížení třiceti history syncers je už dost vysoké.
Také jsem zvyšoval různé parametry: history syncers, cache.
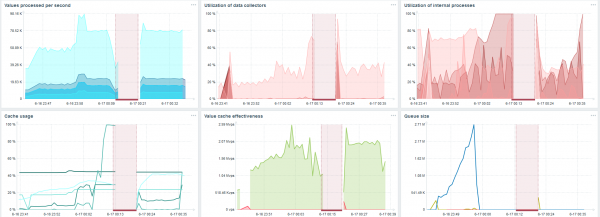
Na mém zařízení se zatížení history syncers zvyšovalo na maximum. HistoryCache se rychle naplnil daty — v bufferu se nahromadila data k zpracování.
Celou dobu jsem sledoval, jak je využíván procesor, operační paměť a další parametry systému, a zjistil jsem, že využití disků bylo maximální.
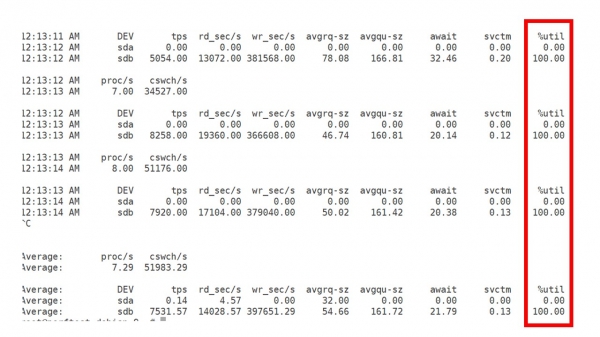
Dosáhl jsem využití maximálních možností disku na tomto zařízení a na této virtuální stroji. Při takové intenzitě začal PostgreSQL dost aktivně uvolňovat data, a disk už nestačil pracovat na zápis a čtení.
Druhý server
Vzala jsem jiný server, který měl už 48 procesorů a 128 GB RAM. Upravila jsem ho — nainstalovala jsem 60 history syncer a dosáhla přijatelných výkonů.
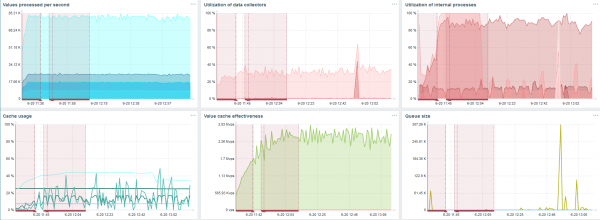
Skutečně, to již je limit výkonu, kde je potřeba něco podniknout.
TimescaleDB. 80 000 nvps
Mým hlavním úkolem je ověřit možnosti TimescaleDB pod zátěží Zabbix. 80 tisíc hodnot za sekundu je hodně, frekvence sběru metrik (kromě Yandexu, samozřejmě) a dost velký "setup".
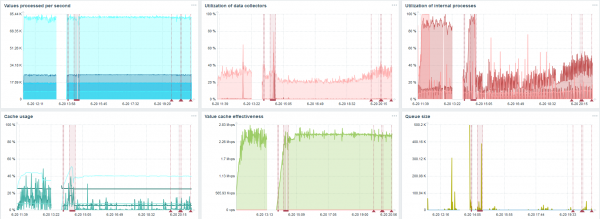
Na každém grafu je propad — to je právě migrace dat. Po propadech v Zabbix serveru se profil zátěže history syncer velmi změnil — klesl na třetinu.
TimescaleDB umožňuje vkládat data prakticky třikrát rychleji a používat méně HistoryCache.
Odpovídajícím způsobem vám budou včas dodávány data.
TimescaleDB. 120 000 nvps
Poté jsem zvýšil počet datových prvků na 500 tisíc. Hlavním úkolem bylo ověřit možnosti TimescaleDB — získal jsem odhadovanou hodnotu 125 tisíc hodnot za sekundu.
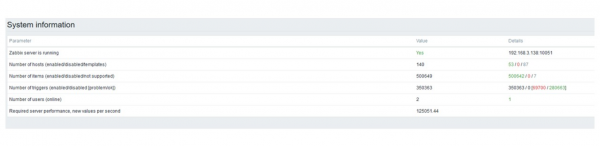
To je funkční "setup", který může dlouho fungovat. Ale protože můj disk měl pouze 1,5 TB, tak jsem ho naplnila za pár dní.
Nejdůležitější je, že v tuto dobu byly vytvářeny nové partitiony TimescaleDB.
Pro výkon je to naprosto nepozorovatelné. Když se vytvářejí partitiony v MySQL, například, všechno je jinak. Obvykle se to děje v noci, protože blokuje celkovou vložení, práci s tabulkami a může vytvářet degradaci služby. V případě TimescaleDB tomu tak není.
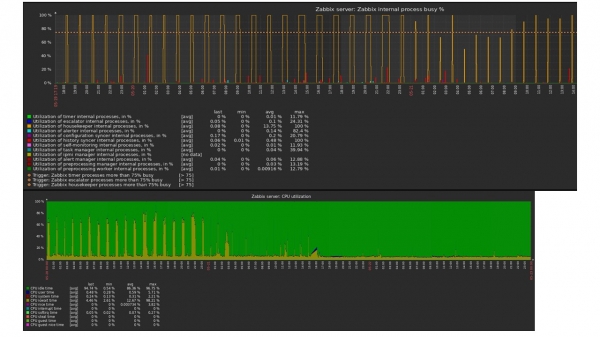
Jako příklad ukážu jeden graf z mnoha v komunitě. Na obrázku je zapnut TimescaleDB, díky čemuž zatížení podle použití io.weight na procesoru kleslo. Využití vnitřních procesů se také snížilo. Přičemž to je obyčejná virtuálka na obyčejných plechových discích, ne na SSD.
Závěry
TimescaleDB je dobré řešení pro malé "setup", které narážejí na výkonnost disku. Umožní to uchovat funkčnost až do migrace DB na rychlejší hardware.
TimescaleDB je snadno nastavitelné, poskytuje nárůst výkonu, dobře spolupracuje se Zabbix a má výhody v porovnání s PostgreSQL..
Pokud používáte PostgreSQL a neplánujete jej měnit, doporučuji používat PostgreSQL s rozšířením TimescaleDB v kombinaci se Zabbixem. Toto řešení efektivně funguje až do středních "setup".
Když mluvíme o "vysoké výkonu" — myslíme tím Čekání na seznámení s technologiemi a praktikami, které umožňují službám obsluhovat miliony uživatelů, netrvá dlouho. Seznam na 7. a 8. listopadu jsme již sestavili, ale ještě můžete navrhnout.
Přihlaste se k našemu a , na kterých odhalujeme zajímavosti nadcházející konference a zjistěte, jak co nejlépe využít příležitosti.
Zdroj: habr.com
