

Ředitel provozu portálu Banki.ru Andrej Nikolskij hovořil na loňské konferenci o problematice „sirotků“: jak rozpoznat sirotka v infrastruktuře, v čem jsou sirotci špatní, co s nimi dělat a jak postupovat, pokud nic nepomáhá.
Pod odkazem je textová verze zprávy.
Dobrý den, kolegové! Jmenuji se Andrej a vedu provoz ve společnosti Banki.ru.
Máme velké služby, to jsou monolitické služby, máme služby v klasickém smyslu, a také velmi malé. Ve své pracovní a zemědělské terminologii říkám, že pokud je služba jednoduchá a malá, je to mikro služba, a pokud není příliš jednoduchá a není malá, je to jednoduše služba.
Výhody služeb
Rychle projdu hlavní výhody služeb.
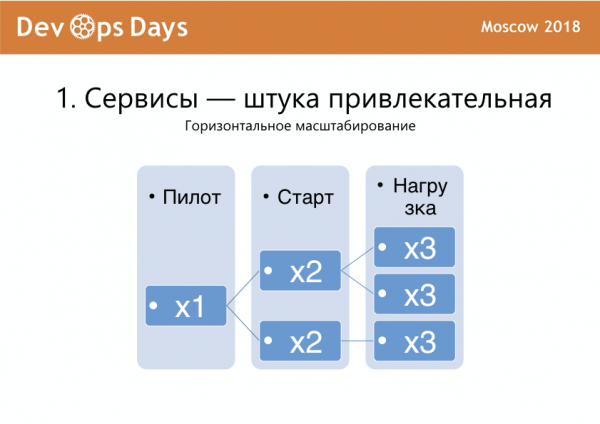
První – škálovatelnost. Můžete rychle něco udělat na službě a spustit to do produkce. Příjde k vám provoz, službu sklonujete. Příjde další provoz, znovu sklonujete a s tím žijete. To je dobrý bonus, a v podstatě, když jsme začínali, považoval se to za nejdůležitější důvod, proč to vůbec děláme.
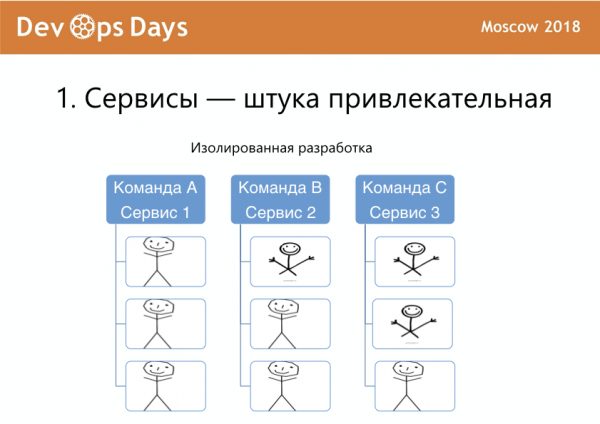
Za druhé, izolovaný vývoj, když máte několik vývojových týmů, několik různých vývojářů v každém týmu a každý tým vyvíjí svou vlastní službu.
V týmové práci vzniká nuance. Vývojáři jsou různí. Existují například . Poprvé jsem to viděl u Maxima Dorofejeva. Někdy jsou lidé-sněhové vločky v některých týmech, zatímco v jiných chybí. To dělá různé služby, které se ve společnosti používají, poněkud nerovnoměrnými.
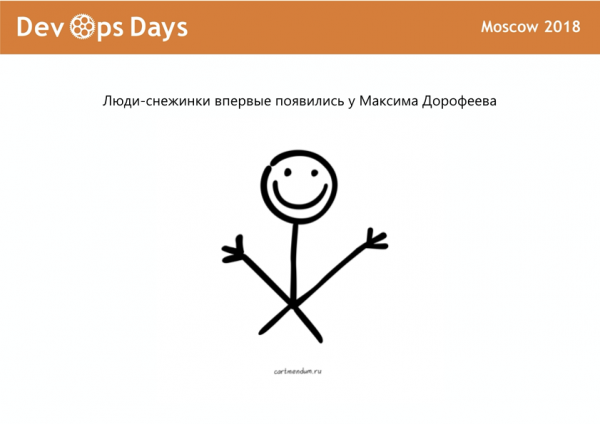
Podívejte se na obrázek: to je dobrý vývojář, má velké ruce, může dělat mnoho věcí. Hlavní problém – odkud tyto ruce vyrůstají.
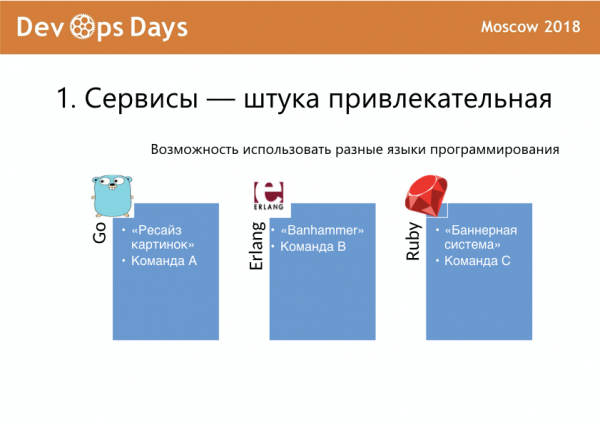
Služby umožňují používat různé programovací jazyky, které jsou lépe přizpůsobeny různým úkolům. Nějaká služba může být napsána v Go, jiná v Erlangu, další v Ruby, něco v PHP, něco v Pythonu. V podstatě se lze rozšířit velmi široce. I zde jsou nuance.
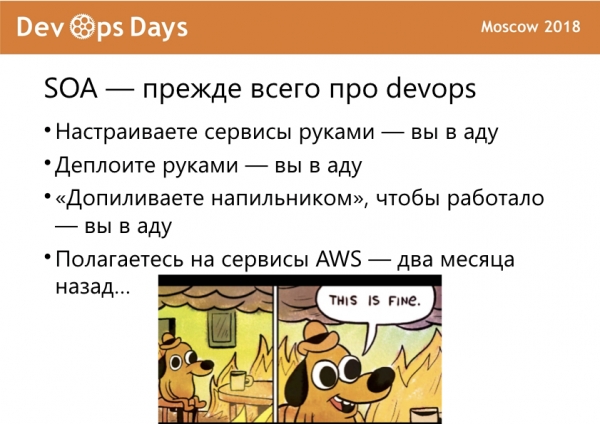
Architektura orientovaná na služby je především o devops. To znamená, že pokud nemáte automatizaci, nemáte proces nasazení, pokud nastavujete ručně, vaše konfigurace se mohou lišit mezi instancemi služby a budete muset něco dělat, pak jste v pekle.
Například máte 20 služeb a musíte je nasazovat ručně, máte 20 konzolí a současně mačkáte „enter“ jako ninja. To není ideální.
Pokud máte službu po testování (pokud je nějaké testování, samozřejmě) a je potřeba ji ještě doladit, aby fungovala v produkčním prostředí, mám pro vás také špatné zprávy.
Pokud se spoléháte na specifické služby Amazonu a přitom pracujete v Rusku, tak před dvěma měsíci jste měli také „Všechno kolem hoří, i’m fine, všechno je skvělé“.
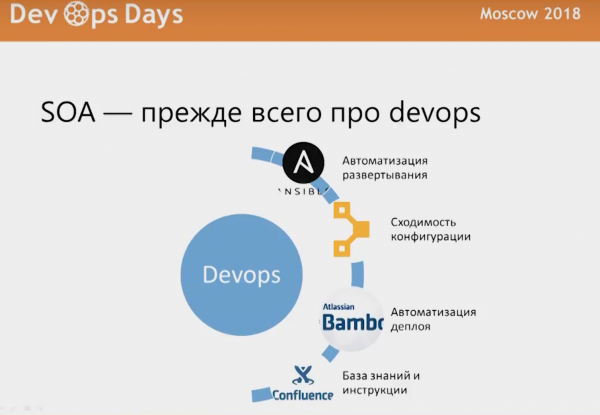
Používáme Ansible pro automatizaci nasazování, Puppet pro konvergenci, Bamboo pro automatizaci deploye, Confluence pro to, abychom to všechno nějak popsali.
Rozebírat to podrobně nebudu, protože prezentace je spíše o praktikách interakcí, než o technické realizaci.
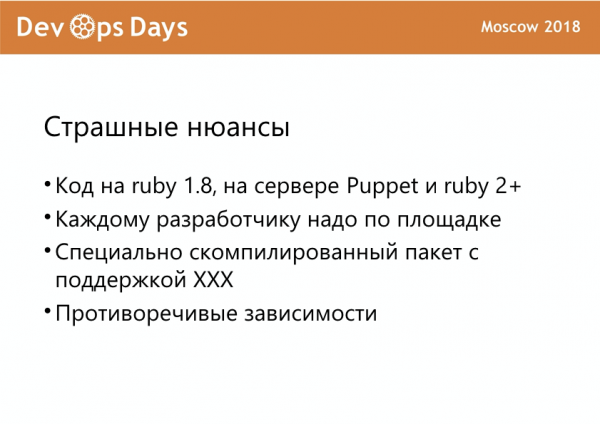
Měli jsme například problémy, kdy Puppet na serveru běžel na Ruby 2, a nějaká aplikace byla napsaná pro Ruby 1.8, a společně nefungovaly. Docházelo tam k nějakým problémům. A když potřebujete mít na jednom stroji několik verzí Ruby, obvykle začnou problémy.
Každému vývojáři například poskytujeme prostředí, na kterém je zhruba všechno, co máme, všechny služby, které se dají vyvíjet, aby měl izolované prostředí, mohl ho rozbít a stavět, jak se mu líbí.
Někdy potřebujete speciálně zkompilovaný balíček s podporou něčeho. To je docela tvrdé. Poslouchal jsem prezentaci, kde docker image vážil 45 GB. Na Linuxu je to samozřejmě jednodušší, tam je to menší, ale přesto, místa nebude dost.
A také se vyskytují protichůdné závislosti, kdy jedna část projektu závisí na knihovně jedné verze, druhá část projektu na jiné verzi, a knihovny se dohromady instalovat prostě nedají.
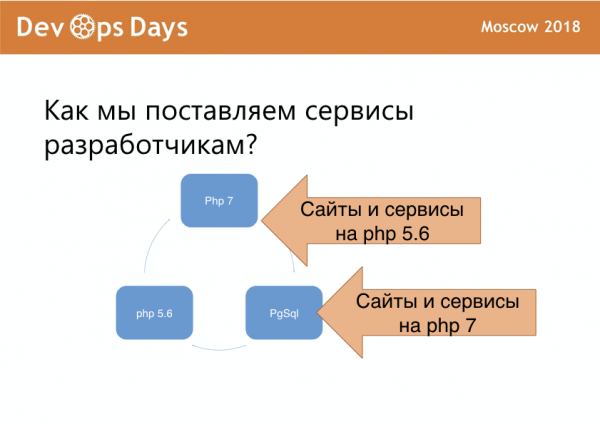
Máme weby a služby na PHP 5.6, je nám za ně trapně, ale co naděláte. To máme na jedné platformě. Jsou weby a služby na PHP 7, těch je více, za ně nám není trapně. A každý vývojář má svou vlastní databázi, kde si radostně vyvíjí.
Pokud ve firmě programujete jedním jazykem, tři virtuální stroje na vývojáře zní normálně. Pokud máte různé programovací jazyky, situace se zhoršuje.
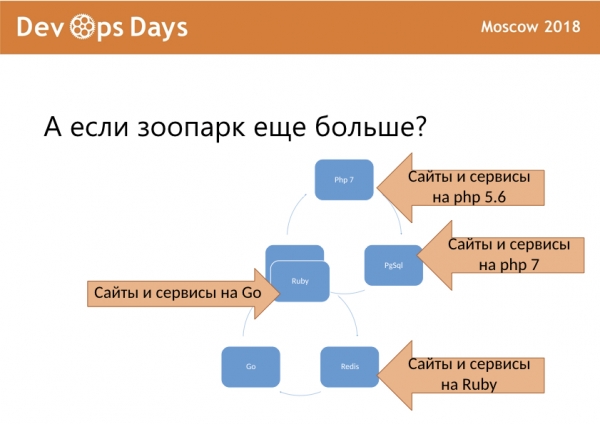
Máte webové stránky a služby na tom, na tom, pak další platformu pro Go, jednu platformu pro Ruby, a ještě nějaký Redis vedle. Nakonec se to všechno změní na velké pole pro údržbu a neustále se něco z toho může rozbít.
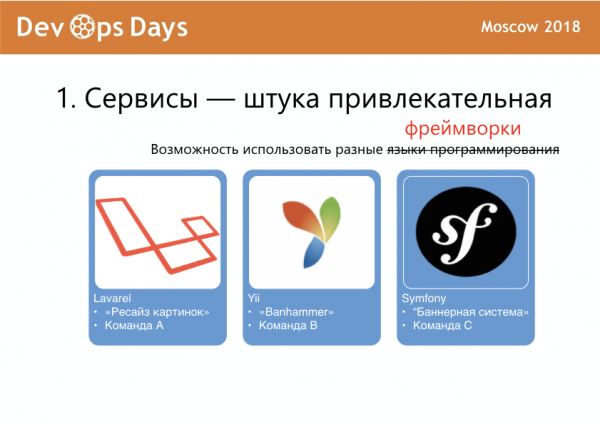
Proto jsme nahradili kouzla programovacího jazyka využíváním různých frameworků, protože frameworky na PHP jsou dost odlišné, mají různé možnosti, různé komunity, různé podpory. A můžete psát službu tak, aby už bylo něco hotového pro ni.
Každá služba má svůj tým.
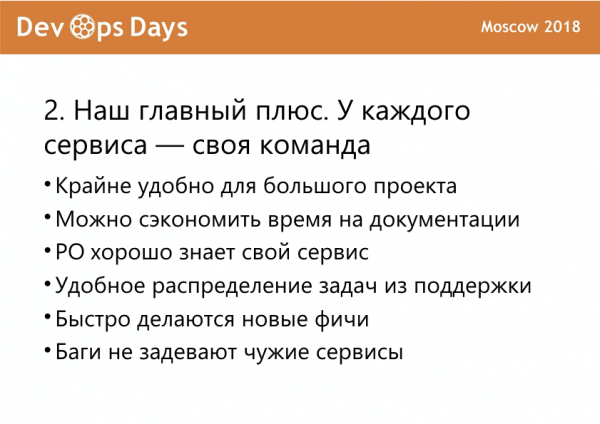
Naší hlavní výhodou, která se vykrystalizovala za několik let, je, že každá služba má svůj tým. To je výhodné pro velký projekt, lze ušetřit čas na dokumentaci, manažeři dobře znají svůj projekt.
Úkoly z údržby lze skvěle přenášet. Například, když se rozbije služba pojištění. A hned tým, který se zabývá pojištěním, jde ji opravit.
Nové funkce se snadno implementují, protože když máte nějakou atomární službu, můžete do ní rychle něco zavést.
A když se vám rozbije vaše služba, a to se nevyhnutelně stane, nezasáhnete ostatní služby, a k vám nepřicházejí vývojáři s kladivy z jiných týmů a neříkají: "Au, to nedělej."
Jak je vždycky, jsou tu nuance. Máme stabilní týmy, manažeři jsou do týmu pevně přiřazeni. Existují jasné dokumenty, manažeři na to všechno pečlivě dohlížejí. Každý tým má s manažerem několik služeb a existuje konkrétní kompetenční bod.
Pokud jsou týmy flexibilní (to u nás také občas funguje), existuje dobrá metoda, která se nazývá „hvězdná mapa“.
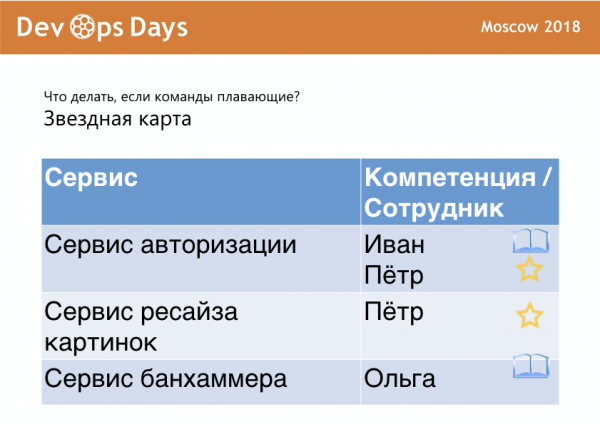
Máte seznam služeb a lidí. Hvězdička znamená, že člověk je expert v této službě, knížka znamená, že člověk studuje tuto službu. Úkolem člověka je vyměnit knížku za hvězdičku. A pokud proti službě není nic napsáno, začínají problémy, o kterých budu dále hovořit.
Jak vznikají služby sirotci?
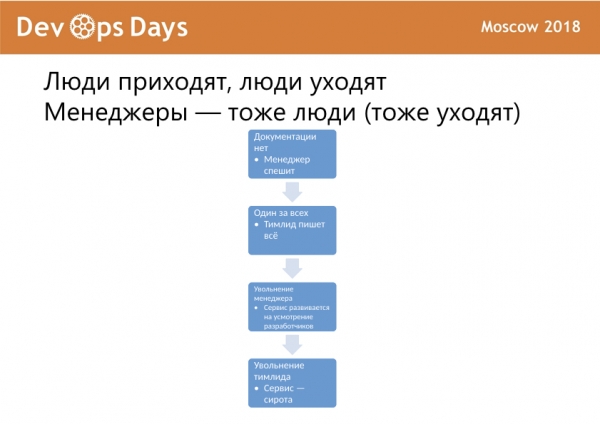
První problém, jak získat ve své infrastruktuře servis-orphan — to jsou propouštění lidí. Měl někdo zkušenosti, kdy do firmy dorazily termíny, ještě předtím než byly úkoly zhodnoceny? Někdy jsou termíny přísné a na dokumentaci prostě není čas. "Musíme službu nasadit do produkce, pak to doděláme."
Pokud je tým malý, může se stát, že je v něm jeden vývojář, který píše všechno, a ostatní jsou v pohotovosti. "Já jsem napsal hlavní architekturu, ty se pusť do návrhu rozhraní." Pak v nějakém okamžiku například manažer odejde. A v této době, kdy manažer odešel a nový ještě není jmenován, vývojáři sami rozhodují, kam služba směřuje, co se tam děje. A jak víme (vrátíme se o několik slidů zpět), v některých týmech jsou lidé – sněhové vločky, někdy je sněhová vločka-vedoucí týmu. Poté odejde a my máme servis-orphan.
Úkoly od podpory a od podnikání ale nikam nezmizí, usazují se v backlogu. Pokud při vývoji služby byly nějaké architektonické chyby, také se usazují v backlogu. Služba pomalu degraduje.
Jak rozpoznat orphan?
Tento seznam docela dobře popisuje situaci. Kdo v sobě rozpoznal něco ve své infrastruktuře?
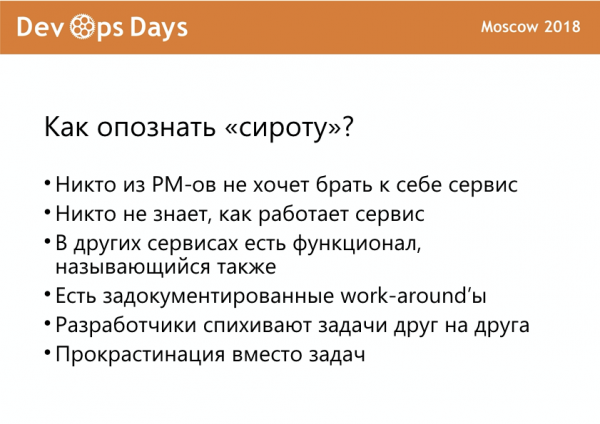
Ohledně zdokumentovaných work-aroundů: existuje služba a celkově funguje, má manuál na dvě stránky, jak s ní pracovat, ale jak funguje uvnitř, nikdo neví.
Nebo například existuje nějaký zkracovač odkazů. U nás například teď používáme tři zkracovače odkazů pro různé účely v různých službách. To jsou důsledky právě toho.
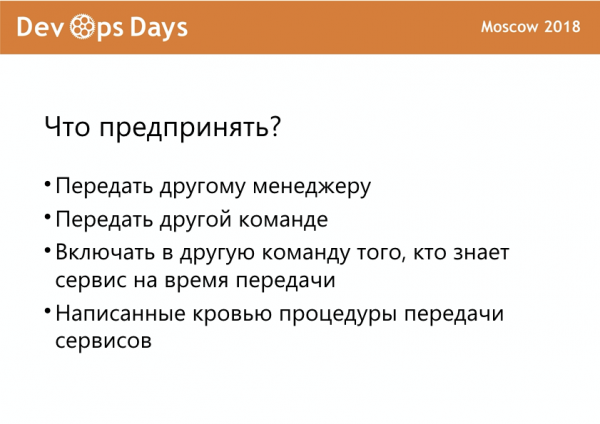
Teď budu kapitánem očividností. Co je potřeba udělat? Za prvé, je třeba předat službu jinému manažerovi, jinému týmu. Pokud váš vedoucí týmu ještě neodešel, pak do tohoto jiného týmu, když chápete, že služba vypadá jako orphan, je třeba zařadit někoho, kdo v ní alespoň něco rozumí.
Hlavní věc: musíte mít napsané procedury předání. V našem případě se obvykle o to starám já, protože potřebuji, aby to všechno fungovalo. Manažeři chtějí, aby to bylo rychle předáno, a co se s tím pak stane, už pro ně není tak důležité.
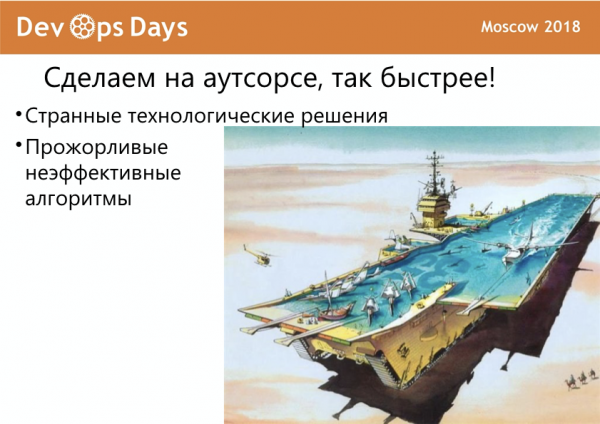
Další způsob, jak vytvořit osiřelý projekt, je: "Přeneseme ho na outsourcing, bude to rychlejší, a pak ho předáme týmu." Je jasné, že každý má v týmu nějaké plány, a někdy se čeká na řadu. Často si obchodní zadavatel myslí, že na outsourcingu udělají práci stejně jako technické oddělení ve firmě, přičemž motivace jsou odlišné. Na outsourcingu se mohou objevit zvláštní technologická a algoritmická řešení.
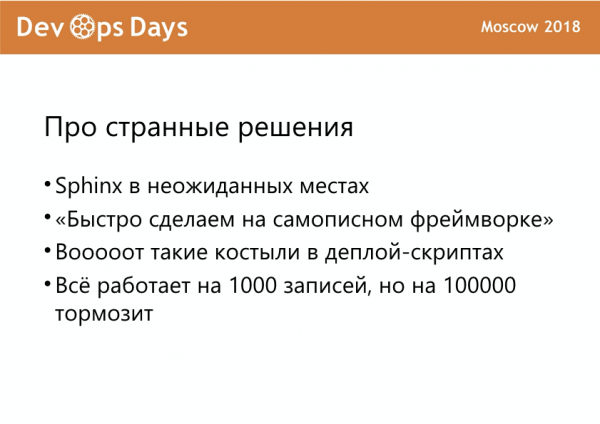
U nás byl například servis, kde byl Sphinx na různých neobvyklých místech. Později vám řeknu, co všechno jsme museli udělat.
Na outsourcingu najdete frameworky napsané na míru. To je prostě holý PHP s kopírováním a vkládáním z předchozího projektu, kde můžete najít cokoliv. V deploy skriptech se obvykle vyskytují velké kostitě, kdy potřebujete složitými Bash skripty změnit pár řádků v nějakém souboru, a tyto deploy skripty volá nějaký jiný skript. Nakonec změníte systém nasazení, vyberete něco jiného a bum, váš servis nefunguje. Protože tam mělo být ještě 8 odkazů mezi různými složkami. Nebo se může stát, že tisíc záznamů funguje, ale sto tisíc už ne.
Pokračuji v kapitánění. Převzetí servisu z outsourcingu je nezbytný proces. Měl někdo zkušenost, že servis z outsourcingu přijde a nikdo ho nepřijme? Není to tak populární jako osiřelý projekt, ale přesto.
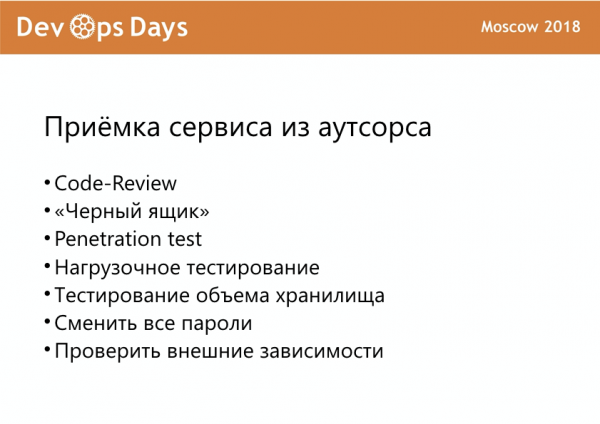
Servis je třeba kontrolovat, je třeba ho přezkoumat, měnit hesla. Měli jsme případ, kdy nám byl dodán servis, kde bylo v administraci napsáno "if login == 'admin' && password == 'admin'...", a to přímo v kódu. Sedíme a přemýšlíme, a tohle píší lidé v roce 2018?
Testování objemu úložiště je také důležité. Musíte zkoumat, co se stane při sta tisících záznamech, ještě předtím, než ten servis pustíte do produkce.
Poslat servis na úpravy by nemělo být ponižující. Když říkáte: "Tenhle servis nepřijmeme, máme 20 úkolů, udělejte je, pak přijmeme," je to normální. Svědomí by nemělo trpět tím, že zklamete manažera nebo že firma utratí peníze. Firma pak utratí více.
Měli jsme případ, kdy jsme se rozhodli udělat pilotní projekt na outsourcingu.
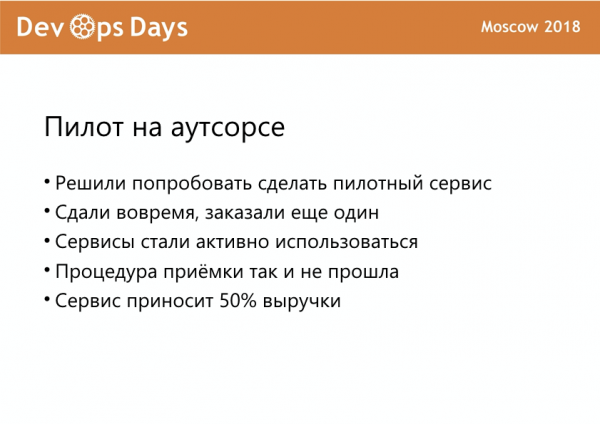
Byl dodán včas a to byl jediný kvalitativní kritérium. Proto byl vytvořen další pilotní projekt, který už ani není zcela pilotní. Tyto služby byly přijaté, administrativními metodami bylo řečeno: tady máte kód, tady je tým, tady je váš manažer. Služby skutečně začaly generovat zisk. Přitom ve skutečnosti zůstaly stále sirotci, nikdo nechápe, jak fungují, a manažeři se od jejich úkolů všemožně distancují.
Existuje ještě jeden skvělý koncept — partyzánský vývoj. Když nějaké oddělení, obvykle marketingové, chce ověřit hypotézu a objedná si službu kompletně na outsourcing. Začíná na ni proudit provoz, uzavírají dokumenty, podepisují protokoly s dodavatelem, přicházejí do provozu a říkají: „Kluci, tady máme službu, na ní už je provoz, generuje nám peníze, pojďme ji převzít.“ A my říkáme: „Co to? Jak se to stalo?“
A ještě jeden způsob, jak získat službu-sirotka: když je nějaký tým náhle přetížený, vedení říká: „Předáme tuto službu týmu, který má menší zátěž.“ A pak ji předáme třetímu týmu a změníme manažera. A nakonec máme opět sirotka.
Jaký je problém s sirotky?
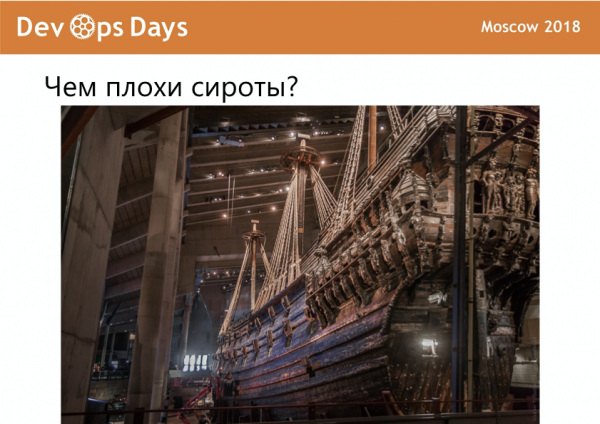
Kdo neví, je to slavná loď Vasa, která se potopila 5 minut po spuštění na vodu. A švédský král, mimochodem, nikoho za to nepopravil. Stavěli ji dvě generace inženýrů, kteří nevěděli, jak takové lodě budovat. Logický efekt.
Loď se mohla potopit, mimochodem, mnohem hůře, například když by na ní jel král někam v bouři. Takto se potopila hned, což je v souladu s agilní metodologií — selhat dříve.
Pokud selžeme brzy, obvykle s tím nejsou problémy. Například při převzetí bylo posláno k přepracování. A pokud už selžeme v produkci, kdy jsou investovány peníze, mohou být problémy. Důsledky, jak se tomu říká v byznysu.
Jaká jsou nebezpečí služeb-sirotků:
- Služba se může náhle porouchat.
- Služba se dlouho opravuje nebo se neopravuje vůbec.
- Problémy s bezpečností.
- Problémy s doplňky a aktualizacemi.
- Pokud se rozbije důležitá služba, utrpí reputace firmy.
Co dělat se službami-sirotky?
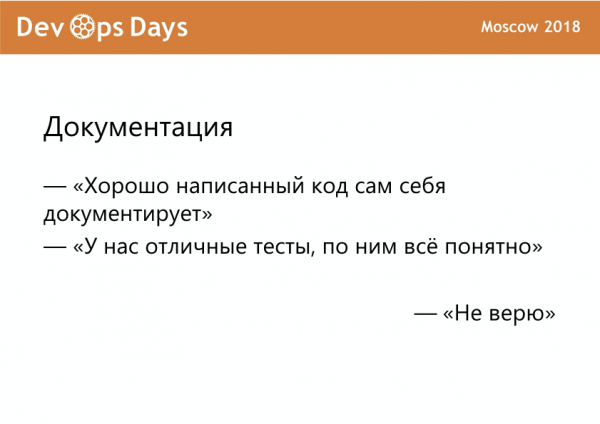
Znovu opakuji, co dělat. Za prvé, musí být dokumentace. Sedm let na Banki.ru mě naučilo, že testeři by se neměli spoléhat na slovo vývojářů a provoz by neměl důvěřovat nikomu bez ověření. Je třeba kontrolovat.
Za druhé, je nutné psát schémata interakcí, protože se může stát, že služby, které nejsou příliš dobře přijaté, obsahují závislosti, o kterých nikdo neřekl. Například vývojáři pomocí vlastního klíče připojili službu k nějakým Yandex.Mapám nebo Ddata. Když vám vypršel bezplatný limit, všechno se pokazilo, a vy nevíte, co se vlastně stalo. Všechny takové problémy by měly být popsány: ve službě se používá Ddata, Sms, ještě něco.
Za třetí, práce s technickým dluhem. Když děláte nějaké zástěry nebo přijmete službu a říkáte, že je třeba něco udělat, měli byste dbát na to, aby to skutečně dělali. Protože se může ukázat, že malá díra není tak malá a vy do ní spadnete.
S architektonickými úkoly jsme měli příběh právě ohledně Sphinx. V jedné ze služeb se Sphinx používal k zavádění seznamů. Jen seznam s paginací, ale každou noc se znovu indexoval. Byl složen ze dvou indexů: jeden se každou noc indexoval velký, a druhý byl malý index, který se k němu připojoval. Každý den, s pravděpodobností 50%, buď se to podařilo, nebo ne, při publikaci se index rozbil a novinky se na naší hlavní stránce přestaly aktualizovat. Zpočátku to bylo 5 minut, dokud se index znovu neindexoval, pak se index rozrostl, a v určitém okamžiku to začalo trvat 40 minut. Když jsme to odstranili, oddechli jsme si s úlevou, protože bylo jasné, že uplyne ještě nějaký čas a náš index se bude znovu indexovat po celý pracovní den. To by byl problém pro náš portál, osm hodin bez novinek — všechno, obchod se zastavil.
Plán práce se sirotčím servisem
Ve skutečnosti je to velmi těžké dělat, protože devops jsou o komunikaci. Člověk chce mít dobré vztahy se svými kolegy, a když své kolegy a manažery zasypáváš regulacemi, mohou mít smíšené pocity k těm, kteří to tak dělají.
Kromě všech těchto bodů existuje ještě jedna důležitá věc: za každý konkrétní službu, za každý konkrétní úsek procesu nasazení, musí odpovídat konkrétní lidé. Když lidé nejsou k dispozici a je třeba zapojit nějaké jiné lidi, kteří se to naučí, stává se to obtížným.
Pokud to všechno nepomohlo a služba sirotka vám stále zůstává sirotkem, nikdo ji nechce vzít, dokumentace se nepíše, tým, který byl pro tuto službu povolán, odmítá něco dělat, existuje jednoduchý způsob — všechno přepracovat.
Jinými slovy, vezmete požadavky na službu znovu a napíšete novou službu, lepší, na lepší platformě, bez zvláštních technologických řešení. A migrujete na ní za chodu.
Měli jsme situaci, kdy jsme vzali službu na Yii 1 a zjistili jsme, že ji nemůžeme dále rozvíjet, protože nám došli vývojáři, kteří umějí dobře psát na Yii 1. Všichni vývojáři umí dobře psát na třetím Symfony. Co dělat? Vyhradili jsme čas, určili tým, určili manažera, přepsali projekt a plynule přepnuli na něj provoz.
Po tom lze starou službu odstranit. To je můj oblíbený postup, když je třeba z systému správy konfigurací vzít a vyčistit nějakou službu a pak projít a zkontrolovat, jestli všechny servery v produkci byly vypnuty, aby po vývojářích nezůstaly žádné stopy. Repo v gitu zůstává.
To je vše, o čem jsem chtěl hovořit, jsem připraven diskutovat, téma je sporné, mnozí se v něm pohybovali.
Na slidech bylo o tom, že jste unifikovali jazyky. Jako příklad byl resize obrázků. Je opravdu nutné přísně do jednoho jazyka? Protože resize obrázku v PHP, no, bylo by to možné opravdu udělat i v Golangu.
Ve skutečnosti to není nutné, stejně jako všechny praktiky. V některých případech může být dokonce nežádoucí. Ale je třeba si uvědomit, že pokud máte ve firmě 50 lidí v technickém oddělení, z toho 45 jsou PHP vývojáři, 3 jsou devopsáci, kteří umí Python, Ansible, Puppet a podobné, a jen jeden z nich píše nějaký Go servis pro resize obrázků, tak když odejde, odborné znalosti odcházejí s ním. A v tomto případě budete muset hledat specifického vývojáře na trhu, který zná tento jazyk, zejména pokud je vzácný. To znamená, že z organizačního hlediska to je problematické. Z pohledu devopsu potřebujete ne jen klonovat nějakou hotovou sadu playbooků, které používáte k nasazení služeb, ale budete je muset napsat znovu.
Právě teď vyvíjíme službu na Node.js, a to bude právě platforma pro každého vývojáře s odděleným jazykem. Ale sedli jsme si a přemýšleli, že to stojí za to. Tedy otázka je sednout si a přemýšlet.
Jak monitorujete vaše služby? Jak shromažďujete a sledujete logy?
Logy shromažďujeme v Elasticsearch a ukládáme je do Kibana, a v závislosti na tom, jestli je to produkční nebo testovací prostředí, tam se používají různé sběrače. Kde něco jako Lumberjack, kde něco jiného, už si to nepamatuji. A jsou také některá místa v určitých službách, kde nasazujeme Telegraf a odesíláme údaje někam zvlášť.
Jak žít s Puppet a Ansible v jednom prostředí?
V současnosti máme dvě prostředí, jedno je Puppet, druhé Ansible. Pracujeme na tom, abychom je hybridizovali. Ansible je skvělé prostředí pro počáteční nastavení, Puppet je špatná věc pro počáteční nastavení, protože vyžaduje práci rukama přímo s platformou, a Puppet zajišťuje konvergenci konfigurace. To znamená, že platforma se sama udržuje v aktuálním stavu, a aby stroj s Ansible byl udržován v aktuálním stavu, musíte na něm pravidelně spouštět playbooky. Takový je rozdíl.
Jak udržujete kompatibilitu? Máte konfigurace jak v Ansible, tak v Puppet?
Tohoto se nám velmi těžko pracuje, snažíme se udržet kompatibilitu a přemýšlíme, jak se z toho všeho dostat pryč. Máme to tak, že Puppet nahrává balíčky a udržuje tam nějaké odkazy, zatímco Ansible například nahrává kód a přizpůsobuje tam nové konfigurace aplikací.
V prezentaci se mluvilo o různých verzích Ruby. Jaké řešení nabízíte?
Setkali jsme se s tím na jednom místě a musíme si to neustále uvědomovat. Jednoduše jsme vypnuli tu část, která běžela na Ruby, které bylo nekompatibilní s aplikacemi, a udržovali jsme ji odděleně.
Letos se konference uskuteční 7. prosince v „Technopolisu“. Do 11. listopadu přijímáme přihlášky na prezentace. nám, pokud chcete vystoupit.
Registrace pro účastníky je otevřená, připojte se!
Zdroj: habr.com
