

Pavel Selivanov, architekt řešení ve Southbridge a lektor Slery, přednesl přednášku na DevOpsConf 2019. Tato přednáška je součástí jednoho z témat pokročilého kurzu Kubernetes „Slery Mega”.
se koná v Moskvě od 18. do 20. listopadu.
— Moskva, 22. až 24. listopadu.
jsou dostupné kdykoli.
Pod článkem — přepis přednášky.
Dobrý den, kolegové a sympathici. Dnes budu mluvit o bezpečnosti.
Vidím, že v sále je dnes mnoho odborníků na bezpečnost. Omlouvám se předem, pokud některé termíny ze světa bezpečnosti nebudu používat přesně tak, jak jste zvyklí.
Před půl rokem mi do rukou přišel jeden veřejný cluster Kubernetes. Veřejný — to znamená, že tam je určité množství namespaces, v těchto namespaces jsou uživatelé, izolovaní ve svém namespace. Všichni tito uživatelé patří různým společnostem. Předpokládalo se, že tento cluster bude použit jako CDN. To znamená, že vám dají cluster, dají vám tam uživatele, přijdete do svého namespace a deployujete své fronty.
Mému předchozímu zaměstnavateli se pokusili takovou službu prodat. A požádali mě, abych otestoval, zda je takové řešení vhodné.
Přišel jsem do tohoto clusteru. Dali mi omezená práva, omezený namespace. Kluci tam chápali, co je bezpečnost. Četli, co je Role-based access control (RBAC) u Kubernetes — a nastavili to tak, že jsem nemohl spouštět pody samostatně od deployments. Nepamatuji si úkol, který jsem se snažil vyřešit, když jsem spouštěl pod bez deploymente, ale velmi jsem chtěl spustit prostě pod. Rozhodl jsem se, že se podívám, jaká práva mám v clusteru, co mohu a co nemohu, co tam nastavili. Ostatně vám povím, co měli v RBAC nastaveno špatně.
Podařilo se mi, že za dvě minuty jsem získal admin přístup k jejich clusteru, podíval jsem se do všech sousedních namespaces, viděl tam běžící produkční fronty společností, které již tuto službu zakoupily a nasadily se. Sotva jsem se udržel, abych někomu nevsunul na hlavní stránku nějaké vulgární slovo.
Povím příklady, jak jsem to udělal a jak se tomu bránit.
Nejprve se ale představím. Jmenuji se Pavel Selivanov. Jsem architektem společnosti Southbridge. Rozumím Kubernetes, DevOps a různým moderním technologiím. Spolu s inženýry ze Southbridge to všechno stavíme, zatímco já poskytuju konzultace.
Kromě naší hlavní činnosti jsme nedávno zahájili projekty, které se nazývají Slyrmy. Snažíme se sdílet naše dovednosti v práci s Kubernetes a učit ostatní, jak pracovat s K8s.
O čem dnes budu mluvit. Téma prezentace je jasné — o bezpečnosti Kubernetes clusterů. Hned chci říct, že tato téma je velmi rozsáhlé — a proto chci předem ujasnit, o čem rozhodně mluvit nebudu. Nebudu mluvit o ohrané terminologii, která byla na internetu už stokrát opakována. Různé RBAC a certifikáty.
Budu mluvit o problémech, které já a moji kolegové máme ohledně bezpečnosti Kubernetes clusterů. Tyto problémy vidíme u poskytovatelů, kteří nabízují Kubernetes clustery, a také u klientů, kteří k nám přicházejí. A dokonce i u klientů, kteří přicházejí k nám od jiných konzultačních administrativních společností. Takže rozsah tragédie je ve skutečnosti velmi velký.
Doslova tři body, o kterých dnes budu mluvit:
- Práva uživatelů vs práva podů. Práva uživatelů a práva podů — to nejsou totéž.
- Shromažďování informací o clusteru. Ukážu, jak lze shromáždit všechny informace z clusteru, aniž bychom měli speciální práva v tomto clusteru.
- DoS útok na cluster. Pokud nebudeme schopni shromáždit informace, budeme moci cluster přesto sabotovat. Budu mluvit o DoS útocích na řídicí prvky clusteru.
Ještě jedna obecná věc, o které zmíním — na čem jsem to všechno testoval, na čem mohu s jistotou říct, že to všechno funguje.
Za základ bereme nasazení clusteru Kubernetes pomocí Kubespray. Pokud to někdo neví, je to vlastně sada rolí pro Ansible. V práci ho neustále používáme. Je dobrý tím, že lze nasadit kamkoli — na fyzické stroje, stejně jako do cloudu. Jeden způsob nasazení vyhovuje v podstatě všemu.
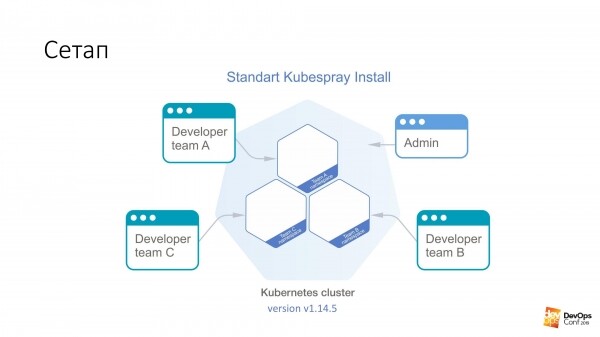
V tomto klastru budu mít Kubernetes v1.14.5. Celý klastr Kubernetes, který budeme zvažovat, je rozdělen na namespacy, přičemž každý namespace náleží jiné týmu a členové tohoto týmu mají přístup pouze do svého namespace. Do různých namespaces nemohou vstupovat. Ale existuje určitý administrativní účet, který má práva na celý klastr.
Sliboval jsem, že první, co uděláme, je získání administrativních práv na klastr. Potřebujeme speciálně připravený pod, který rozbije klastr Kubernetes. Všechno, co musíme udělat, je aplikovat ho do klastra Kubernetes.
kubectl apply -f pod.yamlTento pod k nám přijede na jeden z masterů klastru Kubernetes. A klastr nám po tom rádo vrátí soubor, který se nazývá admin.conf. V Kubernetes se v tomto souboru uchovávají všechny certifikáty admina a současně je nastaven API klastru. Takto jednoduše můžete získat administrativní přístup, myslím, že k 98% klastrů Kubernetes.
Opakuji, tento pod vytvořil jeden vývojář ve vašem klastru, který má přístup nasazovat své nabídky v jednom malém namespace, celý je zúžen RBAC. Neměl žádná práva. Přesto certifikát vrátil.
A nyní k speciálně přípravenému podu. Spouštíme na jakémkoli obrazu. Například použijeme debian:jessie.
Máme takovou věc:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Co je to toleration? Masterové uzly v klastru Kubernetes jsou obvykle označeny něčím, co se nazývá taint ("zároda" v angličtině). A podstata této "zárody" je taková, že na masterové uzly nelze přiřazovat pod. Ale nikdo nebrání v jakémkoli podu uvést, že je tolerantní k "zárodě". Sekce Toleration říká, že pokud na nějakém uzlu stojí NoSchedule, pak je náš pod tolerantní k takové zárodě — a žádné problémy.
Dále říkáme, že náš pod není jen tolerantní, ale také chce být speciálně přiřazen na mastera. Protože na masterech se nachází to nejzajímavější, co potřebujeme — všechny certifikáty. Proto říkáme nodeSelector — a máme standardní label na masterech, který umožňuje vybrat z všech uzlů klastru právě ty uzly, které jsou mastery.
S takovými dvěma sekcemi pod určitě přijede na master. A bude mu povoleno tam žít.
Ale jen přijít na master nám nestačí. To nám nic nedá. Proto máme dále takové dvě věci:
hostNetwork: true
hostPID: true
Uvádíme, že náš pod, který spouštíme, bude žít v name space jádra, v name space sítě a v name space PID. Jakmile se pod spustí na masteru, bude moci vidět všechny skutečné, živé rozhraní tohoto uzlu, poslouchat veškerý provoz a vidět PID všech procesů.
Dále je to už jednoduché. Vezmete etcd a čtete, co chcete.
Nejzajímavější je, že tuto schopnost má Kubernetes, která tam je ve výchozím nastavení.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
A její podstatou je, že můžeme v podu, který spouštíme, i bez práv na tento klastr, říci, že chceme vytvořit volume typu hostPath. To znamená vzít cestu z hostitele, na kterém se spustíme — a vzít ji jako volume. A poté ji nazýváme name: host. Celý tento hostPath montujeme dovnitř podu. V tomto příkladu do adresáře /host.
Ještě jednou opakuji. Řekli jsme podu, aby přišel na master, získal tam hostNetwork a hostPID — a celý root masteru byl namontován dovnitř tohoto podu.
Chápete, že v debianu máme spuštěný bash, a tento bash nám běží pod rootem. To znamená, že jsme právě získali roota na master, aniž bychom měli nějaká práva v klastru Kubernetes.
Dalším úkolem je dostat se do podu do adresáře /host /etc/kubernetes/pki, pokud se nemýlím, vzít tam všechny masterové certifikáty klastru a stát se tak administrátorem klastru.
Pokud se na to podíváte, to jsou jedno z nejnebezpečnějších práv v podech — bez ohledu na to, jaká práva má uživatel:
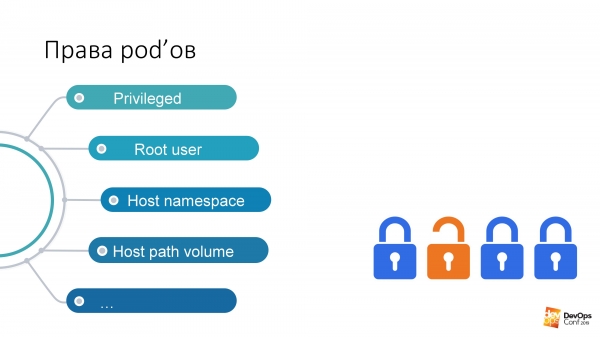
Pokud mám právo spustit pod v nějakém name space klastru, pak tento pod tato práva má výchozí. Mohu spouštět privilegované pody, a to znamená, že mám prakticky všechna práva, téměř root na uzlu.
Můj oblíbený — Root uživatel. A Kubernetes má tuto možnost Run As Non-Root. To je taková ochrana proti hackerovi. Víš, co je to „moldavský virus“? Pokud jste náhodou hacker a přišli jste do mého klastru Kubernetes, pak my, chudí administrátoři, prosíme: „Prosím, uveďte ve svých podech, kterými budete hackovat můj klastr, run as non-root. Protože tak by se mohlo stát, že spustíte proces ve svém pode pod rootem, a velmi snadno byste mě mohli hacknout. Prosím, chraňte se sami před sebou.“
Host path volume — podle mého názoru nejrychlejší způsob, jak získat požadovaný výsledek z klastru Kubernetes.
Co s tím vším dělat?
Myšlenky, které by měly přijít každému normálnímu administrátorovi, který se setkává s Kubernetes: „Aha, já jsem říkal, Kubernetes nefunguje. Má v sobě díry. A celý Kubernetes je blbost.“ Ve skutečnosti existuje něco jako dokumentace, a pokud se na ni podíváte, najdete tam sekci .
To je takový yaml-objekt – můžeme ho vytvářet v klastru Kubernetes – který řídí aspekty bezpečnosti týkající se samotných podů. To znamená, že fakticky řídí práva na používání různých hostNetwork, hostPID, určitých typů volume, které jsou v podech při spuštění. Pomocí Politiky zabezpečení podů lze toto všechno popsat.
Nejzajímavější na Politice zabezpečení podů je, že v klastru Kubernetes nejsou pro všechny instalace PSP vůbec popsány; jsou zkrátka ve výchozím nastavení vypnuté. Politika zabezpečení podů se aktivuje prostřednictvím admission pluginu.
Dobře, do klastru nasadíme Politiku zabezpečení podů, řekněme, že máme nějaké provozní pody v namespace, k němuž mají přístup pouze administrátoři. Řekněme, že ve všech ostatních podech mají omezená práva. Protože pravděpodobně vývojáři nemusí spouštět privilegované pody ve vašem klastru.
A zdá se, že vše je v pořádku. A náš klastr Kubernetes nelze hacknout za dvě minuty.
Je tu problém. Pravděpodobně, pokud máte klastr Kubernetes, máte v něm nainstalovaný monitoring. Dokonce bych se odvážil předpovědět, že pokud v vašem klastru existuje monitoring, jmenuje se Prometheus.
To, co teď povím, bude platné jak pro Prometheus-operator, tak i pro čistou instalaci Prometheus. Otázka je, že pokud nemohu rychle získat administrátora do klastru, znamená to, že musím více hledat. A hledat mohu s pomocí vašeho monitoringu.
Pravděpodobně všichni četli stejné články na habru a monitoring se nachází v namespace monitoring. Helm chart mají všichni zhruba stejné. Předpokládám, že pokud provedete helm install stable/prometheus, dostanete zhruba stejné názvy. A dokonce pravděpodobně nebudu muset hádat DNS-název ve vašem klastru. Protože je standardní.
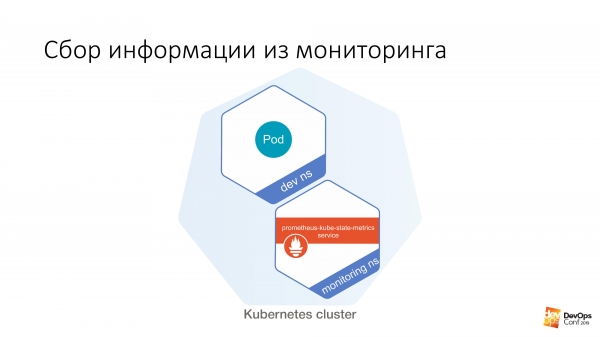
Dále máme nějaký dev ns, v němž lze spustit nějaký pod. A poté z tohoto podu je velmi snadné udělat toto:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics je jedním z exporterů Prometheuse, který sbírá metriky z API samotného Kubernetes. Existuje spousta dat o tom, co máte spuštěno ve vašem clusteru, jaké je to a jaké s tím máte problémy.
Jako jednoduchý příklad:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Provedením jednoduchého curl požadavku z nepř privileged podu můžete získat informace, které vypadají takto. Pokud nevíte, v jaké verzi Kubernetes běžíte, snadno vám to poví.
A nejzajímavější na tom je, že kromě toho, že se obracíte na kube-state-metrics, můžete se stejným úspěchem obrátit i na samotný Prometheus. Můžete z něj sbírat metriky. Dokonce můžete z něj konstruovat metriky. Teoreticky můžete vytvořit takový požadavek z clusteru do Prometheusu, který ho prostě vypne. A váš monitoring přestane fungovat.
A zde se již objevuje otázka, zda nějaký externí monitoring sleduje váš monitoring. Právě jsem získal možnost jednat v clusteru Kubernetes bez následků pro sebe. Ani nepoznáte, že tam jednám, protože monitoring už neexistuje.
Stejně jako s PSP se zdá, že problém spočívá v tom, že všechny tyto moderní technologie — Kubernetes, Prometheus — prostě nefungují a jsou plné děr. Ve skutečnosti to tak není.
Existuje taková věc — .
Pokud jste normální administrátor, pravděpodobně víte, že o Network Policy je to další yaml, kterých je v clusteru už spousta. A nějaké Network Policies rozhodně nejsou nutné. A i kdybyste si přečetli, co je to Network Policy, že to je yaml firewall Kubernetes, který umožňuje omezit přístupová práva mezi namespacemi a mezi podi, určitě jste si rozmysleli, že firewall ve formátu yaml v Kubernetes na dalších abstrakcích … Ne, to rozhodně není nutné.
I když vaši bezpečnostní specialisté nevědí, že s pomocí vašeho Kubernetes můžete snadno postavit velmi podrobnou firewall, pokud vám to ještě neřekli a netlačí vás: "No dejte, dejte..." V každém případě potřebujete Network Policy, abyste uzavřeli přístup k některým službám, které lze z vašeho clusteru vyžádat bez jakékoliv autorizace.
Jak jsem uvedl v příkladu, můžete požádat kube state metrics z jakéhokoli namespace v clusteru Kubernetes, aniž byste k tomu měli jakákoliv oprávnění. Network policies uzavřely přístup ze všech ostatních namespace do monitorovacího namespace a jakoby všechno: bez přístupu, bez problémů. Ve všech chartech, které jsou k dispozici, v standardním Prometheovi i v Prometheovi, který je v operatorovi, je ve values Helmu možnost jednoduše zapnout network policies pro ně. Je potřeba jen zapnout, a budou fungovat.
Zde je však jedna pravda. Jako normální vousatý administrátor jste pravděpodobně dospěli k názoru, že network policies nejsou potřeba. A po přečtení různých článků na zdrojích typu Habr jste se rozhodli, že flannel, zejména v režimu host-gateway, je vůbec to nejlepší, co můžete zvolit.
Co dělat?
Můžete se pokusit pře-deployovat síťové řešení, které máte ve svém clusteru Kubernetes, a zkusit ho nahradit něčím funkčnějším. Například tím samým Calico. Ale hned chci říct, že úkol změnit síťové řešení v pracovním clusteru Kubernetes je docela nejednoduchý. Řešil jsem ho dvakrát (oba případy byly pravda teoreticky), ale dokonce jsme na Sluormu ukázali, jak to udělat. Našim studentům jsme ukazovali, jak změnit síťové řešení v clusteru Kubernetes. V zásadě se můžete pokusit udělat to tak, abyste v produkčním clusteru neměli žádný výpadek. Ale pravděpodobně se vám to nepodaří.
A problém se skutečně řeší velmi jednoduše. V clusteru jsou certifikáty, a víte, že certifikáty vám za rok vyprší. Takže obvyklé řešení s certifikáty v clusteru je – proč si dělat starosti, vedle postavíme nový cluster, a ve starém ať vyprší, a všechno znovu deployneme. Pravda, když to vyprší, budeme mít den, kdy to všechno leží, ale přesto nový cluster.
Až budete zvedat nový cluster, nezapomeňte vložit Calico místo flannel.
Co dělat, pokud máte certifikáty vydané na sto let a neplánujete znovu nasadit cluster? Existuje nástroj Kube-RBAC-Proxy. To je skvělý nástroj, který se dá integrovat jako sidecar container do jakéhokoli podu v clusteru Kubernetes. A v podstatě přidává k tomuto podu autorizaci přes RBAC samotného Kubernetes.
Je tu však jeden problém. Dříve bylo toto řešení Kube-RBAC-Proxy integrované v Prometheus operátoru. Ale poté se to ztratilo. Moderní verze se spoléhají na to, že máte network policy a pomocí nich vše uzavíráte. A proto bude třeba trochu upravit chart. Ve skutečnosti, pokud se podíváte na , najdete příklady, jak to používat jako sidecars, a chart bude potřeba upravit minimálně.
Je tu také jeden malý problém. Nejen Prometheus poskytuje své metriky komukoli. Všechny komponenty clusteru Kubernetes také umí poskytovat své metriky.
Ale jak jsem již řekl, pokud nemůžete získat přístup k clusteru a shromáždit informace, můžete alespoň uškodit.
Takže rychle ukážu dva způsoby, jak můžete Kubernetes clusteru poškodit zdraví.
Budete se smát, když to uslyšíte, jsou to dva příklady z reálného života.
První způsob. Vyčerpání zdrojů.
Spustíme další speciální pod. Ten bude mít takovouto sekci.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Jak víte, requests — to je množství CPU a paměti, které je na hostiteli rezervováno pro konkrétní pody s requests. Pokud máme čtyřjádrový host v clusteru Kubernetes a dorazí tam pod s requests na čtyři CPU, tak na tento host už žádný další pod s requests dorazit nemůže.
Pokud spustím takový pod a poté provedu příkaz:
$ kubectl scale special-pod --replicas=...Pak už se nikdo do clusteru Kubernetes nebude moci nasadit. Protože na všech nodech dojdou requests. A tímto způsobem váš cluster Kubernetes zastavím. Pokud to udělám večer, mohu nasazení zastavit na docela dlouho.
Pokud se podíváme do dokumentace Kubernetes ještě jednou, uvidíme věc nazývanou Limit Range. Tato funkce stanovuje zdroje pro objekty v clusteru. Můžete vytvořit objekt Limit Range v yaml, aplikovat ho na určité namespace – a poté v tomto namespace můžete říct, že máte pro pody předdefinované, maximální a minimální zdroje.
Díky této funkci můžeme omezit uživatele v konkrétních produktových namespace na to, co mohou uvádět ve svých podech. Ale bohužel, i když uživateli řeknete, že si nemůže spustit pody s požadavky vyššími než jedno CPU, existuje příkaz scale, nebo mohou provést scale přes dashboard.
A odtud vychází druhý způsob. Spustíme 11 111 111 111 111 podů. To jsou jedenáct miliard. To není proto, že bych si vymyslel to číslo, ale protože jsem to sám viděl.
Skutečný příběh. Pozdě večer jsem se už chystal odejít z kanceláře. Viděl jsem skupinku vývojářů v rohu, jak něco panikaří s notebooky. Přistoupil jsem k nim a zeptal se: "Co se stalo?"
Chvíli předtím, kolem deváté hodiny večerní, se jeden z vývojářů chystal domů. A rozhodl se: "Teď to své aplikaci posunu na jedničku." Stiskl jedničku, ale internet trochu zpomalil. Znovu stiskl jedničku, zatlačil na jedničku, ťukl na Enter. Zkusil vše, co mohl. Pak internet ožil – a všechno se začalo škálovat na toto číslo.
Pravda je, že tento příběh se nestal na Kubernetes, tenkrát to byl Nomad. Skončilo to tím, že po hodině pokusů zastavit Nomad od neúnavného škálování, Nomad odpověděl, že škálování nepřestane a nebude se věnovat ničemu jinému. "Jsem unavený, odcházím." A vypnul se.
Samozřejmě jsem se pokusil udělat totéž na Kubernetes. Jedenáct miliard podů Kubernetes nepřijalo s radostí, řekl: "Nemohu. Převyšuje interní limity." Ale 1 000 000 000 podů zvládnul.
Na odpověď na jeden miliard Kub se sám nepřesunul. Opravu začal škálovat. Čím dále proces postupoval, tím více času mu to zabíralo na vytváření nových podů. Ale proces stále probíhal. Jediný problém je, že pokud mohu ve své jmenném prostoru bez omezení spouštět pody, mohu i bez požadavků a limitů spustit s určitými úkoly takové množství podů, že díky těmto úkolům začnou uzly spadnout z pohledu paměti a CPU. Když spouštím tolik podů, informace z nich musí dorazit do úložiště, tedy do etcd. A když tam přichází příliš mnoho informací, úložiště začne příliš pomalu vydávat — a Kubernetes začíná zpomalovat.
A ještě jeden problém… Jak víte, řídící prvky Kubernetes nejsou jen jedna centrální věc, ale několik komponentů. Mezi nimi je controller manager, scheduler a tak dále. Všichni tito lidé začnou vykonávat současně zbytečnou bezduchou práci, která s časem začne zabírat stále více a více času. Controller manager bude vytvářet nové pody. Scheduler se pokusí najít pro ně nové uzly. Nové uzly ve vašem clusteru pravděpodobně brzy dojdou. Cluster Kubernetes začne pracovat stále pomaleji.
Ale rozhodl jsem se jít ještě dál. Jak víte, v Kubernetes existuje něco, čemu se říká služba. A ve výchozím nastavení vaše služby ve clusterech pravděpodobně fungují pomocí IP tables.
Pokud spustíte miliardy podů, například, a pak pomocí skriptu přinutíte Kubernetes vytvářet nové služby:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
Na všech uzlech clustru se přibližně současně budou generovat stále nové a nové pravidla iptables. A pro každou službu bude generováno jedno miliarda pravidel iptables.
Tohle všechno jsem kontroloval na několika tisících, až po desítku. A problém je v tom, že už na této úrovni je docela problém udělat ssh na uzel. Protože pakety, procházející takovým množstvím řetězců, začínají nefungovat příliš dobře.
A to vše se dá vyřešit pomocí Kubernetes. Existuje objekt Resource quota. Nastavuje množství dostupných zdrojů a objektů pro namespace v clusteru. Můžeme vytvořit yaml objekt v každém namespace clusteru Kubernetes. Pomocí tohoto objektu můžeme říci, že pro tento namespace je vyhrazeno určité množství requestů a limitů, a dále můžeme říci, že v tomto namespace je možné vytvořit 10 služeb a 10 podů. A vývojář si může klidně večer odpočinout. Kubernetes mu řekne: „Nelze škálovat vaše pody do takového množství, protože přesahuje kvótu zdrojů.“ A je po problému. .
Jeden problémový bod v tomto ohledu nastává. Cítíte, jak obtížné se stává vytvoření namespace v Kubernetes. Abychom ho vytvořili, musíme zvážit mnoho faktorů.
Resource quota + Limit Range + RBAC
• Vytvořte namespace
• Vytvořte limit range uvnitř
• Vytvořte resource quota uvnitř
• Vytvořte service account pro CI
• Vytvořte rolebinding pro CI a uživatele
• Volitelně spusťte potřebné pomocné pody
Proto bych chtěl využít příležitosti a podělit se o své vývoje. Existuje nástroj zvaný Operator SDK. To je způsob, jak v clusteru Kubernetes psát operátory. Můžete psát operátory pomocí Ansible.
Nejprve jsme to měli napsáno v Ansible, a pak jsem zjistil, že existuje Operator SDK a přepsal Ansible roli na operator. Tento operator umožňuje vytvořit v clusteru Kubernetes objekt zvaný command. Uvnitř commandu umožňuje popisovat v yaml prostředí pro tento command. A uvnitř prostředí commandu umožňuje popisovat, kolik zdrojů vyčleňujeme.
Malá .
A závěrem. Co s tím vším dělat?
První. Pod Security Policy — to je dobré. A i když žádný z instalátorů Kubernetes to dosud nepoužívá, ve vašich clusterech to stále používat potřebujete.
Network Policy — to není jen nějaká další zbytečná funkce. To je něco, co je v clusteru skutečně potřeba.
Limit Range/ResourceQuota — už by bylo na čase to použít. Už jsme to začali používat dávno, a dlouho jsem byl přesvědčen, že to používají všichni. Ukázalo se, že je to vzácnost.
Kromě toho, co jsem zmínil během přednášky, existují nedokumentované funkce, které umožňují útok na klastr. Nedávno byl zveřejněn .
Některé věci jsou tak smutné a zklamávající. Například za určitých podmínek mohou kubelety v klastru Kubernetes vracet obsah adresáře warlocks neautorizovanému uživateli.
obsahují pokyny, jak reprodukovat vše, o čem jsem mluvil. Jsou tam soubory s ukázkami produkce, jak vypadají ResourceQuota, Pod Security Policy. A to všechno si můžete vyzkoušet.
Děkuji všem.
Zdroj: habr.com
