

Ahoj, Habr!
Po novoročních svátcích jsme znovu spustili katastroficky odolné cloudové řešení na dvou platformách. Dnes vám ukážeme, jak to funguje, a představíme, co se děje s klientskými virtuálními stroji při selhání jednotlivých prvků clusteru a pádu celého zařízení (spojler – všechno je v pořádku).
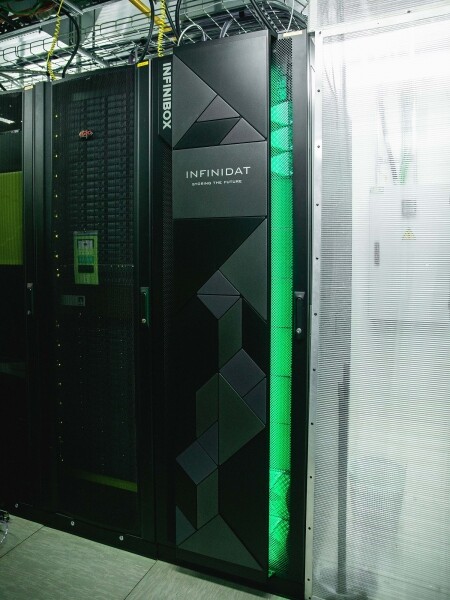
Systém SAN katastroficky odolného cloudu na platformě OST.
Co je uvnitř
Pod kapotou clusteru jsou servery Cisco UCS s hypervizorem VMware ESXi, dvě SAN řešení INFINIDAT InfiniBox F2240, síťové vybavení Cisco Nexus a SAN switche Brocade. Cluster je distribuován na dvě platformy – OST a NORD, tedy v každém datovém centru je identická sada vybavení. To ho činí katastroficky odolným.
V rámci jedné platformy jsou hlavní prvky také zdvojeny (hostitelé, SAN switche, síť).
Obě platformy jsou spojeny vyhrazenými optickými trasami, které také mají rezervu.
Pár slov o SAN. První varianta katastroficky odolného cloudu byla postavena na NetApp. Zde jsme zvolili INFINIDAT a to je důvod:
- Možnost Active-Active replikace. Ta umožňuje virtuálnímu stroji zůstat v provozuschopném stavu i při úplném selhání jednoho ze SAN. O replikaci se dozvíte více dále.
- Tři diskové kontrolery pro zvýšení odolnosti systému. Obvykle jsou dva.
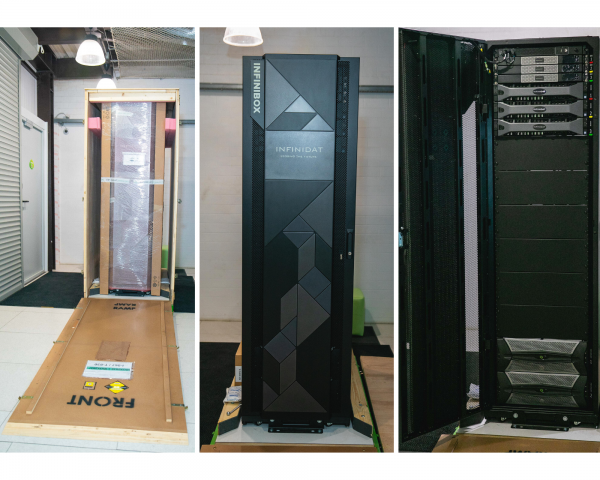
- Hotové řešení. Představili jsme si už sestavený rack, který stačí připojit k síti a nastavit.
- Pečlivá technická podpora. Inženýři INFINIDAT neustále analyzují protokoly a události SAN, instalují nové verze firmwaru, pomáhají s konfigurací.
Tady je pár fotek z unpacking’u:
Jak to funguje
Cloud je už sám o sobě odolný. Chrání klienta před jednotlivými hardwarovými a softwarovými selháními. Katastrofická odolnost však pomáhá chránit před hromadnými výpadky v rámci jedné platformy: například selhání SAN (nebo SDS clusteru, což se nestává zřídka 🙂 ), masivní chyby v úložné síti a podobně. A to nejdůležitější: takový cloud zachraňuje, když se celá platforma stane nedostupnou kvůli požáru, výpadku elektrického proudu, násilnému převzetí, nebo přistání mimozemšťanů.
Ve všech těchto případech klientské virtuální stroje pokračují v práci, a zde je důvod proč.
Schéma clustera je uspořádána tak, že jakýkoli ESXi host s klientskými virtuálními stroji může přistupovat k jakékoli ze dvou SAN. Pokud SAN na lokalitě OST selže, virtuální stroje budou pokračovat v provozu: hostitelé, na kterých běží, budou vyžadovat data z SAN na NORD.
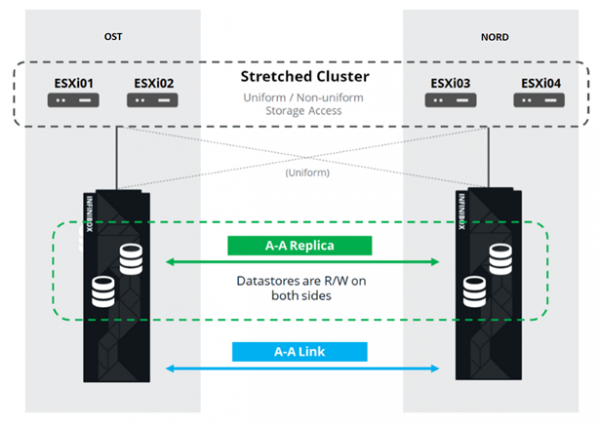
Takto vypadá schéma připojení v clusteru.
To je možné díky tomu, že mezi SAN switchi dvou lokalit je nastaven Inter-Switch Link: SAN switch Fabric A OST je spojen se SAN switchem Fabric A NORD, obdobně i pro SAN switche Fabric B.
Aby měly všechny tyto složité struktury SAN smysl, je mezi dvěma SAN nastavená aktivně-aktivní replikace: informace jsou téměř současně zapisovány do lokálního a vzdáleného SAN, RPO=0. To znamená, že na jednom SAN se uchovává originál dat, na druhém – jejich replikace. Data se replikují na úrovni oddílů SAN a na nich se uchovávají data VM (jeho disky, konfigurační soubor, swap soubor a další).
ESXi host vidí hlavní oddíl a jeho replikaci jako jedno diskové zařízení (Storage Device). K každému diskovému zařízení vedou od ESXi hosta 24 cest:
12 cest spojuje lokální SAN (optimální cesty) a zbývajících 12 – vzdáleným (neoptimální cesty). V normální situaci ESXi přistupuje k datům na lokálním SAN, využívajíc "optimální" cesty. Po selhání tohoto SAN ESXi ztrácí optimální cesty a přepíná se na "neoptimální". Takto to vypadá na schématu.
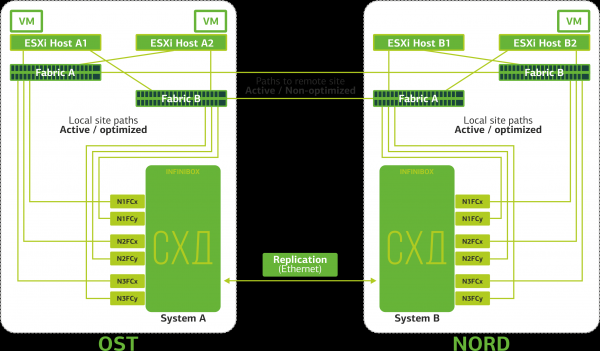
Schéma katastrofické odolnosti clustera.
Všechny klientské sítě jsou přivedeny na obě lokalitiy přes společnou síťovou strukturu. Na každé lokalitě funguje Provider Edge (PE), na kterém jsou ukončovány sítě klienta. PE jsou spojeny do společného clustera. Při selhání PE na jedné lokalitě je veškerý provoz přesměrován na druhou lokalitu. Díky tomu zůstávají virtuální stroje z lokality, která zůstala bez PE, dostupné na síti pro klienta.
Nyní se podívejme, co se stane s virtuálními stroji klienta při různých selháních. Začneme s nejslabšími variantami a skončíme tím nejzávažnějším – selháním celé lokality. V příkladech bude hlavní lokalitou OST a záložní, s replikami dat, NORD.
Co se stane s virtuálním strojem klienta, pokud…
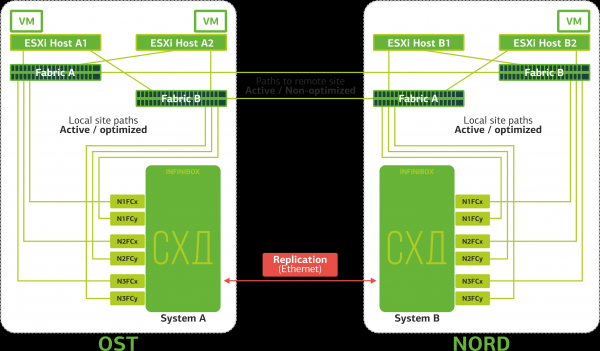
Selže Replication Link. Replikace mezi SAN dvou lokalit se přerušuje.
ESXi budou fungovat pouze s místními pevnými disky (podle optimálních cest).
Virtuální stroje pokračují v provozu.
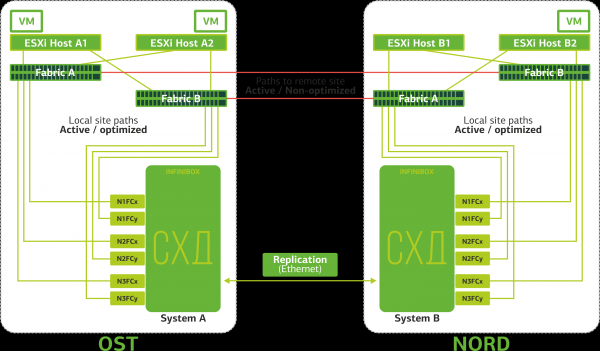
Dochází k přerušení ISL (Inter-Switch Link). Situace je nepravděpodobná. Snad jen nějaký šílený bagr překope najednou několik optických tras, které vedou nezávislými trasami a jsou zavedeny na místa skrze různé vstupy. Ale přesto. V tomto případě ESXi hostitelé ztrácejí polovinu cest a mohou se obracet pouze na své místní SAN. Repliky se shromažďují, ale hostitelé k nim nebudou mít přístup.
Virtuální stroje pracují standardně.
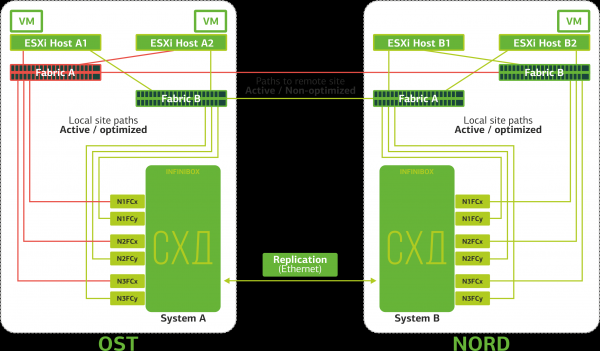
Selhává SAN switch na jednom z míst. ESXi hostitelé ztrácejí část cest k SAN. V takovém případě hostitelé na místě, kde došlo k selhání switche, budou fungovat pouze prostřednictvím svého jediného HBA.
Virtuální stroje v tomto případě nadále pracují standardně.
Selhávají všechny SAN switche na jednom z míst. Představme si, že taková potíž nastala na místě OST. V takovém případě ESXi hostitelé na tomto místě ztrácejí všechny cesty k svým pevným diskům. Zde se aktivuje standardní mechanismus VMware vSphere HA: restartuje všechny virtuální stroje na místě OST do NORDu maximálně za 140 sekund.
Virtuální stroje běžící na hostitelích na místě NORD fungují standardně.
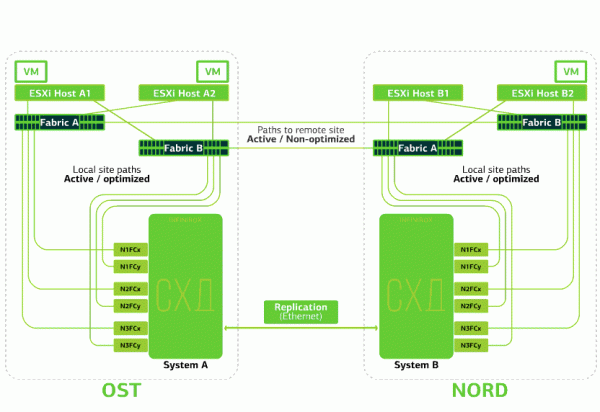
Selhává ESXi hostitel na jednom místě. Opět zde funguje mechanismus vSphere HA: virtuální stroje z nefunkčního hostitele se restartují na jiných hostitelích – na stejném nebo vzdáleném místě. Doba restartu virtuálního stroje – až 1 minuta.
Pokud selhávají všichni ESXi hostitelé na místě OST, zde už není jiná varianta: VM se restartují na jiném. Doba restartu je stejná.
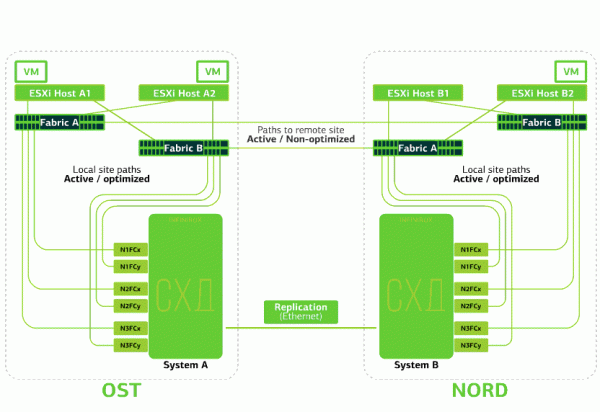
Selhává SAN na jednom místě. Představme si, že selhal SAN na místě OST. Potom ESXi hostitelé na místě OST přepnou na práci s replikami SAN v NORDu. Po návratu nefunkčního SAN do provozu dojde k nucené replikaci, ESXi hostitelé OST znovu začnou využívat místní SAN.
Virtuální stroje po celou dobu fungují standardně.
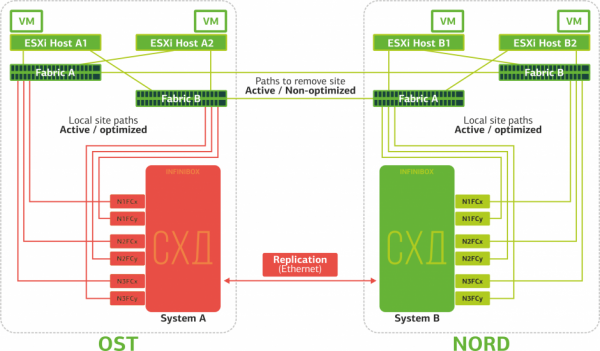
Selhává jedno z míst. V tomto případě budou všechny virtuální stroje restartovány na záložním místě pomocí mechanismu vSphere HA. Doba restartu VM je 140 sekund. Přitom všechna síťová nastavení virtuálního stroje zůstanou zachována a zůstává dostupná pro klienta po síti.
Aby restart strojů na záložní platformě proběhl bez problémů, je každá platforma zaplněna pouze z poloviny. Druhá polovina slouží jako rezerva pro případ přesunu všech virtuálních strojů z druhé, postižené, platformy.
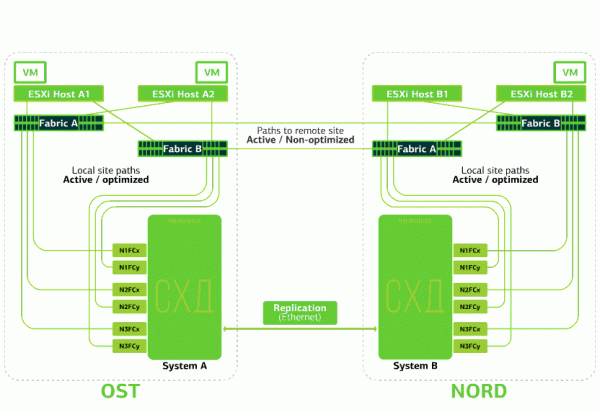
Před takovými selháními chrání katastrofálně odolné cloudové řešení založené na dvou datových centrech.
Tato služba není levná, protože vedle hlavních zdrojů je potřeba rezerva na druhé platformě. Proto se v takovém cloudu umisťují podnikově kritické služby, jejichž dlouhá odstávka může způsobit značné finanční a reputační ztráty, nebo pokud jsou na informační systém kladeny požadavky na katastrofální odolnost ze strany regulátorů nebo vnitřních předpisů firmy.
Zdroje:
Zdroj: habr.com
