

V roce 2010 měla firma 50 serverů a jednoduchý síťový model: backend, frontend a firewall. Počet serverů rostl, model se komplikoval: stagingy, izolované VLAN s ACL, poté VPN s VRF, VLAN s ACL na L2, VRF s ACL na L3. To je trochu matoucí? Dál to bude zábavnější.
Když vzrostl počet serverů na 16 000, práce s takovým množstvím různorodých segmentů se stala nemožnou. Proto jsme přišli s jiným řešením. Vzali jsme stack Netfilter, přidali k němu Consul jako zdroj dat, a vznikl rychlý distribuovaný firewall. Ten nahradil ACL na routerech a sloužil jako externí i interní firewall. Pro dynamické řízení nástroje jsme vyvinuli systém BEFW, který jsme použili všude: od řízení přístupu uživatelů do produktové sítě po izolaci síťových segmentů od sebe.
Jak to všechno funguje a proč byste měli věnovat pozornost tomuto systému, vám poví Ivan Agarov () — vedoucí skupiny zabezpečení infrastruktury oddělení Maintenance v Minské vývojové centrále firmy. Ivan je fanoušek SELinuxu, miluje Perl a píše kód. Jako vedoucí skupiny IŽ pravidelně pracuje s logy, zálohami a výzkumem a vývojem, aby chránil Wargaming před hackery a zajistil provoz všech herních serverů ve firmě.
Historie
Než povím, jak jsme to dělali, povím, jak jsme se k tomu dostali a proč to bylo potřeba. K tomu se přeneseme o 9 let zpět: rok 2010, právě se objevily World of Tanks. Firma Wargaming měla asi 50 serverů.
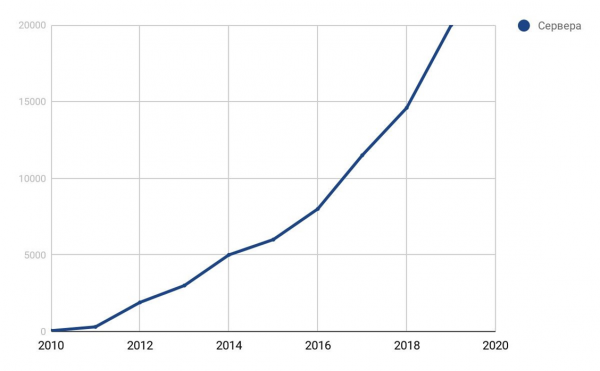
Graf růstu serverů firmy.
Měli jsme síťový model. Pro tu dobu byl optimální.
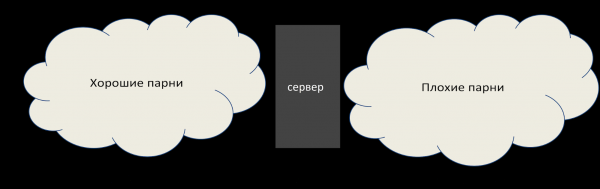
Síťový model v roce 2010.
Na frontendu žijí špatní kluci, kteří nás chtějí zničit, ale tam je firewall. Na backendu firewall není, ale máme tam 50 serverů, všechny je známe. Všechno funguje dobře.
Za 4 roky vzrostl park serverů sto násobně, na 5000. Objevily se první izolované sítě — stagingy: nemohou jít do produkce, a tam často běželo něco, co mohlo být nebezpečné.
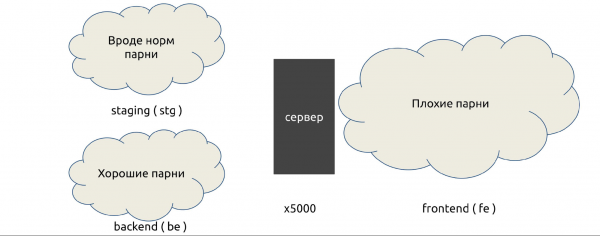
Síťový model v roce 2014.
Z setrvačnosti jsme používali stále stejná zařízení a celá práce probíhala na izolovaných VLAN: na VLAN se zapisují ACL, které povolují nebo zakazují určité spojení.
V roce 2016 počet serverů dosáhl 8000. Wargaming převzal další studia a vznikly další partnerské sítě. Vypadají, že jsou naše, ale nejsou úplně: pro partnery VLAN často nefunguje, je potřeba použít VPN s VRF, izolace se komplikují. Směs izolací ACL rostla.
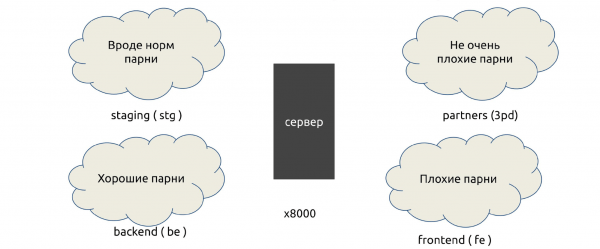
Síťový model v roce 2016.
Na začátku roku 2018 se počet strojů zvýšil na 16 000. Segmentů bylo 6, ostatní jsme nepočítali, včetně uzavřených, kde byly uchovávány finanční údaje. Objevily se kontejnerové sítě (Kubernetes), DevOps, cloudové sítě připojené přes VPN, například z IVS. Pravidel bylo přespříliš — bylo to bolestivé.
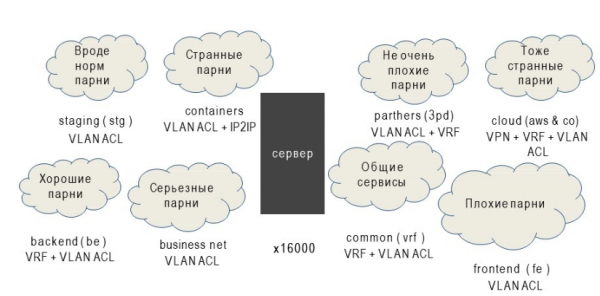
Síťový model a metody izolace v roce 2018.
Pro izolaci jsme používali: VLAN s ACL na L2, VRF s ACL na L3, VPN a mnoho dalšího. Příliš mnoho.
Problémy
Všichni žijí s ACL a VLAN. Co je vlastně špatně? Na tuto otázku odpoví Harold, který skrývá bolest.
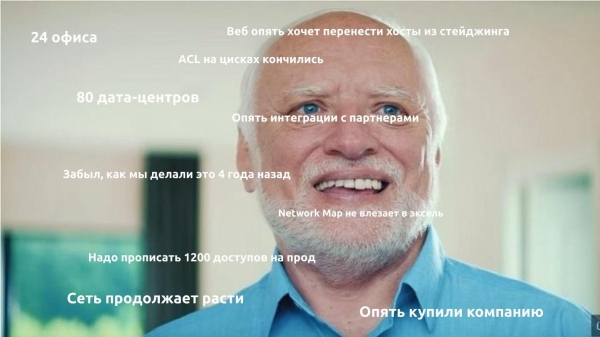
Problémů bylo mnoho, ale masivních — pět.
- Geometrický nárůst ceny pro nová pravidla.. Každé nové pravidlo se zavádělo déle než to předchozí, protože bylo třeba nejprve zkontrolovat, zda už takové pravidlo neexistuje.
- Není firewall uvnitř segmentů.. Segmenty se nějak oddělily, uvnitř už zdrojů není dostatek.
- Pravidla se aplikovala dlouho. Jedno místní pravidlo mohli operátoři napsat za hodinu. Globální trvalo několik dní.
- Obtížnosti s auditem pravidel.. Přesněji, audit nebyl možný. První pravidla byla psána už v roce 2010 a většina jejich autorů již v společnosti nepracovala.
- Nízká úroveň kontroly nad infrastrukturou.. To je hlavní problém — špatně jsme věděli, co se u nás vlastně děje.
Tak vypadal síťový inženýr v roce 2018, když slyšel: „Potřebujeme ještě trochu ACL.“
Řešení.
Na začátku roku 2018 bylo rozhodnuto s tím něco udělat.
Cena integrací neustále roste. Výchozím bodem bylo to, že velké datové centra přestala podporovat izolované VLAN a ACL, protože došly paměti na zařízeních.
Řešení: odstranili jsme lidský faktor a co nejvíce automatizovali poskytování přístupu.
Nová pravidla se aplikují dlouho. Řešení: urychlit aplikaci pravidel, udělat ji distribuovanou a paralelní. K tomu je potřeba distribuovaný systém, aby se pravidla doručovala samy, bez rsync nebo SFTP na tisíc systémů.
Nedostatek firewallu uvnitř segmentů. Firewall uvnitř segmentů začal být problém, když se v rámci jedné sítě objevily různé služby. Řešení: používat firewall na úrovni hostitele – host-based firewalls. Prakticky všude máme Linux, a všude je k dispozici iptables, to není problém.
Obtíže s auditem pravidel. Řešení: uchovávat všechna pravidla na jednom místě pro přehled a správu, takto budeme moci provést audit.
Nízká úroveň kontroly nad infrastrukturou. Řešení: provést inventarizaci všech služeb a přístupů mezi nimi.
Je to spíše administrativní proces než technický. Někdy máme 200-300 nových releaseů za týden, zejména během akcí a o svátcích. A to je pouze pro jeden tým našich DevOps. S takovým množstvím releaseů je nemožné pochopit, jaké porty, IP adresy a integrace jsou potřeba. Proto jsme potřebovali speciálně vyškolené servisní manažery, kteří se dotazovali týmů: „Co vůbec existuje a proč jste to zprovoznili?“
Po všem, co jsme spustili, v roce 2019 se síťový inženýr již začal jevit takto.
Consul
Rozhodli jsme se, že vše, co jsme našli pomocí servisních manažerů, vložíme do Consulu a odtud budeme psát pravidla iptables.
Jak jsme se rozhodli to udělat?
- Shromáždíme všechny služby, sítě a uživatele.
- Na jejich základě vytvoříme pravidla iptables.
- Automatizujeme kontrolu.
- ….
- ZISK.
Consul není vzdálené API, může fungovat na každém uzlu a psát do iptables. Zbývá vymyslet automatické kontrolní prostředky, které budou odstraňovat zbytečné, a většina problémů bude vyřešena! Zbytek se doladí v průběhu.
Proč Consul?
Osvědčil se. V letech 2014-15 jsme ho používali jako backend pro Vault, kde uchováváme hesla.
Netratí data.. Během používání Consulu jsme neztratili data ani při jedné havárii. To je obrovská výhoda pro systém správy firewallu.
P2P spojení zrychlují distribuci změn.. S P2P přicházejí všechny změny rychle, není potřeba čekat hodiny.
Pohodlné REST API. Zvažovali jsme také Apache ZooKeeper, ale nemá REST API, budeme muset udělat nějaké workaroundy.
Funguje jak jako úložiště klíčů (KV), tak jako katalog (Service Discovery).. Lze ukládat služby, katalogy, datová centra. To je pohodlné nejen pro nás, ale i pro sousední týmy, protože při budování globální služby myslíme ve velkém.
Napsán v Go, který je součástí technologického stacku Wargaming. Máme rádi tento jazyk, máme mnoho vývojářů Go.
Silný systém ACL. S pomocí ACL lze v Consul spravovat, kdo a co může zapisovat. Zaručujeme, že pravidla firewallu se nebudou křížit s ničím jiným a nebudeme s tím mít problémy.
Ale Consul má i nevýhody.
- Neskalovatelné v rámci datového centra, pokud nemáte firemní verzi. Škaluje se pouze federací.
- Velmi závislé na kvalitě sítě a zatížení serverů. Consul nebude správně fungovat jako server na zatíženém serveru, pokud v síti existují nějaké zpoždění, například kolísavá rychlost. To souvisí s P2P připojeními a modely šíření aktualizací.
- Obtíže s monitorováním dostupnosti. Ve stavu Consul může být uvedeno, že vše je v pořádku, ale on už dávno nefunguje.
Většinu těchto problémů jsme vyřešili během používání Consul, proto jsme si ho vybrali. Společnost má plány na alternativní backend, ale naučili jsme se bojovat s problémy a zatím žijeme s Consul.
Jak funguje Consul
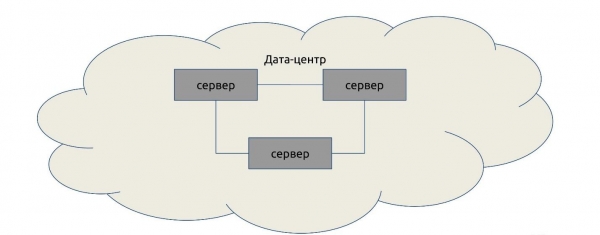
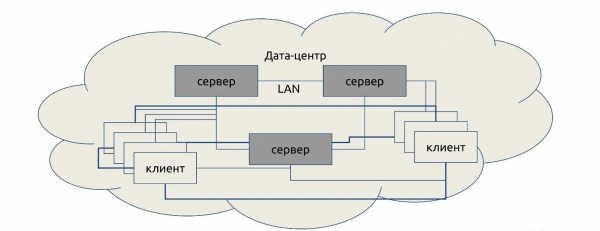
V určitých datových centrech nainstalujeme servery - od tří do pěti. Jeden nebo dva servery nejsou vhodné: nejsou schopny organizovat kvórum a rozhodnout, kdo má pravdu, když se data neshodují. Více než pět nemá smysl, výkon klesne.
Klienti se připojují k serverům v libovolném pořadí: ti samí agenti, pouze s flagem server = false.
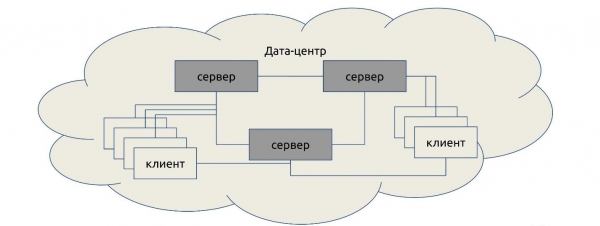
Poté klienti obdrží seznam P2P připojení a budují mezi sebou vazby.
Na globální úrovni propojujeme několik datových center. Ta se také propojují P2P a komunikují.
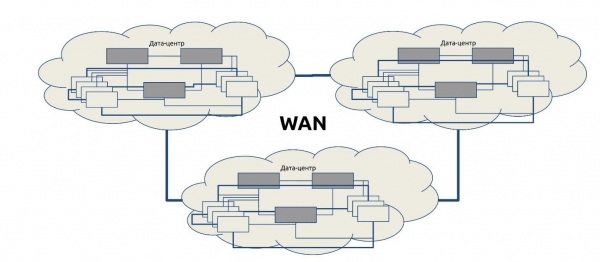
Když chceme získat data z jiného datového centra, žádost jde od serveru k serveru. Tento způsob se nazývá protokol Serf. Protokol Serf, stejně jako Consul, je vývoj společnosti HashiCorp.
Několik důležitých faktů o Consul
Consul má dokumentaci popisující jeho fungování. Uvedu pouze vybrané fakta, která stojí za to vědět.
Consul servery vybírají master z hlasujících. Consul vybírá master ze seznamu serverů pro každé datové centrum a všechny žádosti jdou pouze k němu, bez ohledu na počet serverů. Zaseknutí mastera nevede k novým volbám. Pokud master není zvolen, žádosti není nikdo obsluhují.
Chtěli jste horizontální škálování? Omlouváme se, není.
Žádost do jiného datového centra jde od mistra k mistrovi, bez ohledu na to, na který server přišla. Vybraný mistr přebírá 100 % zátěže, kromě zátěže na přesměrování žádostí. Aktuální kopie dat jsou k dispozici na všech serverech datového centra, ale odpovídá pouze jeden.
Jediný způsob, jak škálovat, je aktivovat režim stale na klientovi.
V režimu stale lze odpovídat bez kvóra. Je to režim, ve kterém se vzdáváme konzistence dat, ale čtení je o něco rychlejší než obvykle a může odpovědět jakýkoli server. Samozřejmě, zápis probíhá pouze přes mistra.
Consul nekopíruje data mezi datovými centry.Při shromažďování federace má každý server pouze svá data. Ostatní informace získává vždy od někoho jiného.
Atonomnost operací není zaručena mimo transakci.Pamatujte, že něco měnit můžete nejen vy. Pokud chcete jinak, provádějte transakci s blokováním.
Blokující operace nezaručují blokaci.Žádost jde od mistra k mistrovi, a ne přímo, takže není zaručeno, že blokace uspěje, pokud provádíte blokaci například v jiném datovém centru.
ACL také nezaručuje přístup (v mnoha případech).ACL nemusí fungovat, protože se uchovává v jednom datovém centru federace — v ACL datovém centru (Primární DC). Pokud vám DC neodpoví, ACL nebude fungovat.
Jedna visící mistr způsobí visení celé federace.Například v federaci 10 datových center, přičemž jedno má špatnou síť, a jeden mistr selže. Všichni, kdo s ním komunikují, se zacyklí: dochází k žádosti, na kterou není odpověď, vlákno se visí. Není možné zjistit, kdy k tomu dojde, prostě za hodinu nebo dvě spadne celá federace. S tím nic nenaděláte.
Status, kvórum a volby jsou zpracovávány odděleným vláknem. Nedošlo k opětovnému výběru, status nic neukáže. Myslíte si, že máte živý Consul, žádáte a nic se neděje — není žádná odpověď. Přitom status ukazuje, že je vše v pořádku.
Setkali jsme se s tímto problémem, museli jsme přestavovat konkrétní části datových center, abychom se mu vyhnuli.
V podnikové verzi Consul Enterprise chybí některé výše uvedené недостатки.Má mnoho užitečných funkcí: volby hlasujících, rozdělení, škálování. Je tu ale jedno "ale" — licenční systém pro distribuovaný systém je velmi drahý.
Tip: rm -rf /var/lib/consul — lék na všechny bolesti agenta. Pokud vám něco nefunguje, stačí smazat svá data a nahrát data z kopie. Pravděpodobně bude Consul fungovat.
BEFW
Nyní si povíme, co jsme přidali k Consul.
— je to akronym od BackEndFireWall. Musel jsem nějak pojmenovat produkt, když jsem vytvářel repozitář, abych do něj umístil první testovací commity. Toto jméno zůstalo.
Šablony pravidel
Pravidla jsou napsána v syntaxi iptables.
- -N BEFW
- -P INPUT DROP
- -A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
- -A INPUT -i lo -j ACCEPT
- -A INPUT -j BEFW
Všechno prochází do řetězce BEFW, kromě ESTABLISHED, RELATED a localhost. Šablona může být jakákoli, je to jen příklad.
Jak je BEFW užitečné?
Služby
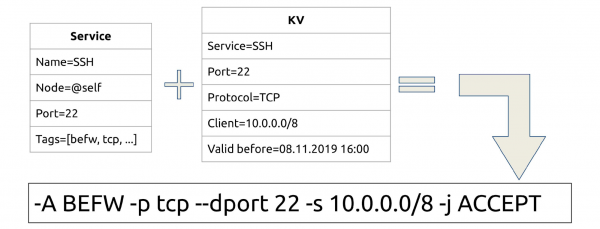
Máme službu, vždy má port, na kterém běží, uzel. Z naší uzlu se můžeme místně zeptat agenta a zjistit, že máme nějakou službu. Také můžeme přidávat tagy.
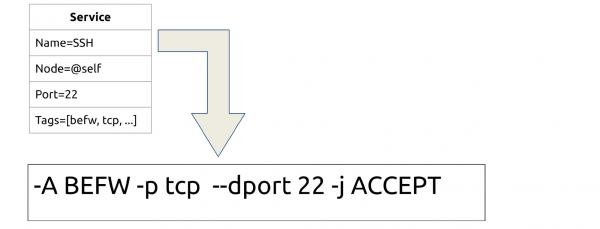
Každá služba, která běží a je registrována v Consul, se mění na pravidlo iptables. Máme SSH — otevíráme port 22. Bash skript je jednoduchý: curl a iptables, nic víc nepotřebujeme.
Klienti
Jak otevřít přístup ne všem, ale selektivně? Po názvu služby ukládat do KV úložiště seznamy IP.
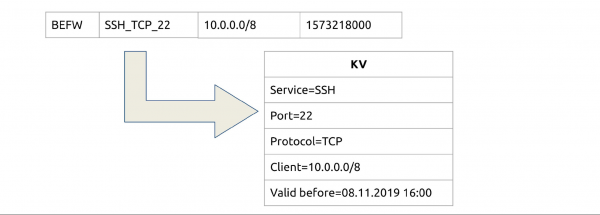
Například chceme, aby všichni z desáté sítě mohli přistupovat k službě SSH_TCP_22. Přidáme jedno malé pole TTL? a nyní máme dočasná povolení, například na jeden den.
Přístupy
Spojujeme služby a klienty: máme službu, na každou je připraveno KV úložiště. Nyní dáváme přístup ne všem, ale selektivně.
Skupiny
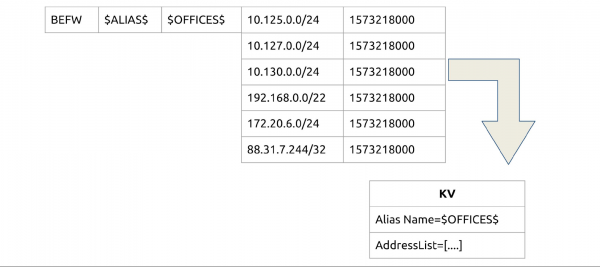
Pokud budeme pokaždé psát tisíce IP pro přístupy, unavíme se. Vymyslíme skupiny — samostatný subset v KV. Nazveme ho Alias (nebo skupiny) a budeme tam ukládat skupiny podle stejného principu.
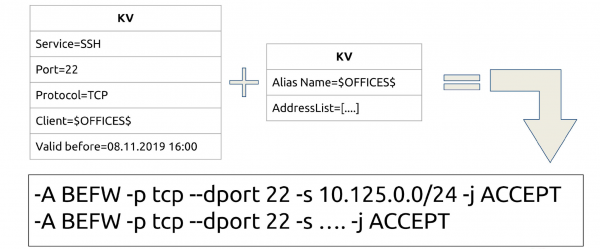
Spojujeme: nyní můžeme otevřít SSH ne konkrétně na P2P, ale na celou skupinu nebo několik skupin. Stejně tak existuje TTL — můžeme do skupiny přidávat a dočasně odstraňovat.
Integrace
Náš problém — lidský faktor a automatizace. Zatím jsme ho vyřešili takto.
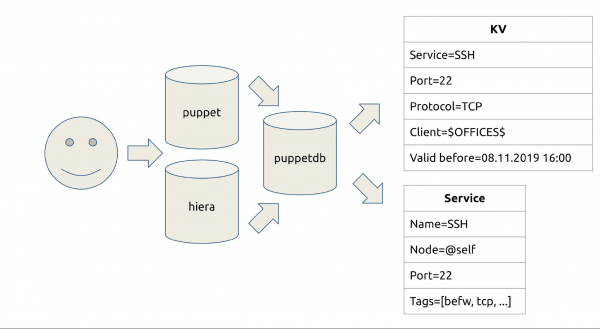
Pracujeme s Puppet a přenášíme všechny informace týkající se systému (kód aplikací). V puppetdb (běžný PostgreSQL) se uchovává seznam služeb, které tam běží, a lze je vyhledat podle typu zdroje. Tam také najdete, kdo kam přistupuje. Dále máme systém pull request a merge request pro toto.
Napsali jsme befw-sync — nejjednodušší řešení, které pomáhá přenášet data. Nejprve se sync cookies obracejí na puppetdb. Tam je nastaveno HTTP API: dotazujeme se, jaké máme služby a co je třeba udělat. Poté se provede dotaz na Consul.
Je integrace? Ano: napsali jsme pravidla a povolili přijímat Pull Requesty. Potřebujete nějaký port nebo přidat hosta do nějaké skupiny? Pull Request, revize — žádné další "Najdi 200 dalších ACL a zkus něco udělat s tím".
Optimalizace
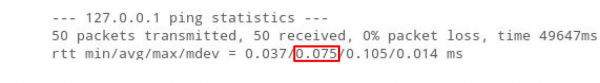
Ping localhost s prázdným řetězcem pravidel trvá 0,075 ms.
Přidáme do tohoto řetězce 10 000 adres iptables. V důsledku toho se ping zvýší pětkrát: iptables je zcela lineární, zpracování každé adresy trvá nějaký čas.
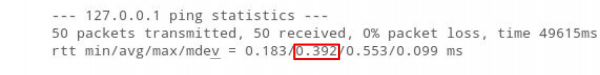
Pro firewall, do kterého migrujeme tisíce ACL, máme hodně pravidel a to způsobuje zpoždění. Pro herní protokoly je to špatné.
Ale pokud umístíme 10 000 adres do ipsetu ping se dokonce zkrátí.
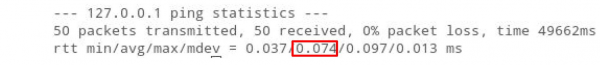
Smyslem je, že "O" (složitost algoritmu) pro ipset je vždy rovno 1, bez ohledu na to, kolik tam pravidel je. Pravda, je tam omezení — pravidel nemůže být více než 65535. Zatím s tím žijeme: lze je kombinovat, rozšiřovat, udělat dva ipsety v jednom.
Úložiště
Logické pokračování procesu iterací je uchovávání informací o klientech pro službu v ipsetu.
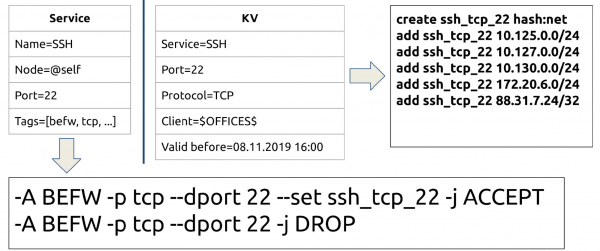
Nyní máme stejný SSH a ihned nepíšeme 100 IP, ale zadáváme název ipsetu, se kterým je třeba komunikovat, a následující pravidlo DROP. Můžeme to předělat na jedno pravidlo "Kdokoli tu není, ten DROP", ale tak je to přehlednější.
Nyní máme pravidla a sady. Hlavním úkolem je vytvořit sadu před napsáním pravidla, protože jinak iptables pravidlo nezapíše.
Obecná schéma
Ve schématu to, co jsem popsal, vypadá takto.
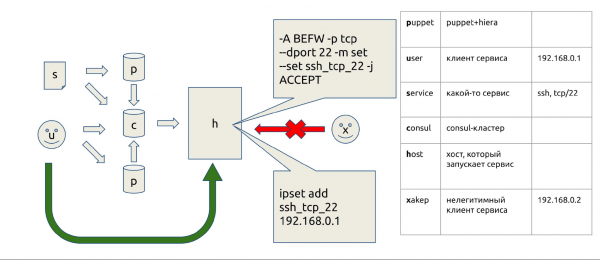
Zavazujeme do Puppet, všechno se odešle na hostitele, služby jsou zde, ipset tam, a kdo tam není uveden, toho nepouštějí.
Allow & deny
Abychom rychle zachraňovali svět nebo rychle někoho odpojili, na začátku všech řetězců jsme vytvořili dvě ipsety: rules_allow a rules_deny. Jak to funguje?
Například, někdo vytváří zátěž na našem webu pomocí botů. Dříve bylo nutné najít podle logů jeho IP, předat ji síťovým inženýrům, aby našli zdroj provozu a zablokovali ho. Teď to vypadá jinak.
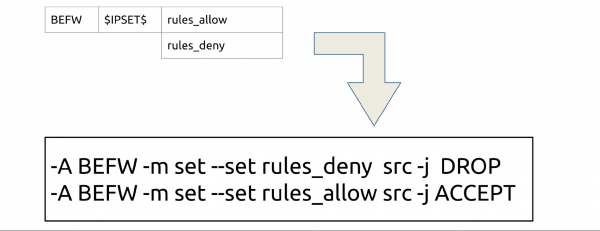
Odesíláme do Consul, čekáme 2,5 s a hotovo. Vzhledem k tomu, že Consul rychle rozděluje díky P2P, funguje to všude na světě.
Jednou jsem úplně zastavil WOT, když jsem se spletl s firewallem. rules_allow — to je naše pojistka pro takové případy. Pokud jsme někde udělali chybu s firewallem, něco se zablokuje, vždy můžeme poslat podmíněný 0.0/0, abychom rychle všechno zvedli. Později všechno opravíme ručně.
Další sady
Můžeme přidat jakékoli jiné sady do prostoru $IPSETS$.
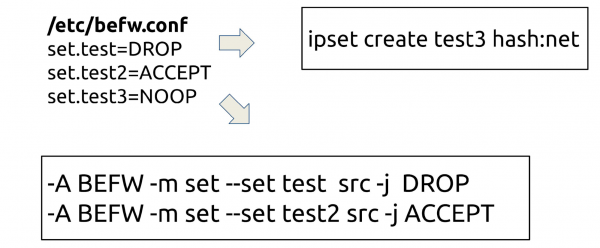
Proč? Někdy někdo potřebuje ipset, například aby emuloval odpojení nějaké části clusteru. Každý může přinést jakékoli sady, pojmenovat je a ty budou brány z Consul. Tyto sady mohou jak účastnit v pravidlech iptables, tak být jako by příkazem NOOP: konzistence bude udržována démonem.
Uživatelé
Dříve to bylo tak: uživatel se připojil k síti a přes doménu získal parametry. Před zavedením nových generací firewallů Cisco nedokázala rozlišit, kde je uživatel a kde IP. Proto byl přístup udělován pouze přes hostname stroje.
Co jsme udělali? Vklínili jsme se do okamžiku získávání adresy. Obvykle je to dot1x, Wi-Fi nebo VPN — vše jde přes RADIUS. Pro každého uživatele vytváříme skupinu podle jeho jména a umisťujeme do ní IP s TTL, který odpovídá jeho dhcp.lease — jakmile vyprší, pravidlo zmizí.
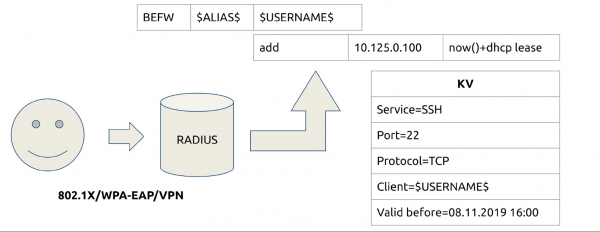
Teď můžeme otevírat přístup k službám, stejně jako v jiných skupinách, podle uživatelského jména. Zbavili jsme se bolesti s hostname, když se mění, a snížili zátěž na síťové inženýry, protože už to nepotřebují Cisco. Teď si inženýři sami zapisují přístupy na svých serverech.
Izolace
Současně jsme začali rozebírat izolaci. Správci služeb provedli inventarizaci, a my jsme analyzovali všechny naše sítě. Rozložíme je na stejné skupiny, a na potřebných serverech jsme skupiny přidali, například do deny. Teď ta samá izolace stagingu jde do rules_deny na produkci, ale ne do samotné produkce.
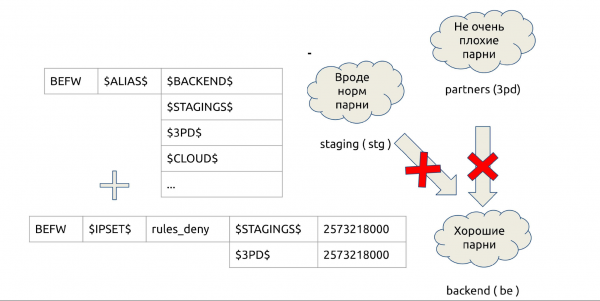
Schema funguje rychle a jednoduše: odstraňujeme všechny ACL ze serverů, uvolňujeme hardware, snižujeme počet izolovaných VLAN.
Kontrola integrity
Dříve jsme měli speciální spouštěč, který nás informoval, když někdo ručně měnil pravidlo firewallu. Psal jsem obrovský linter pro kontrolu pravidel firewallu, bylo to složité. Nyní integritu kontroluje BEFW. Pečlivě dbá na to, aby se pravidla, která vytváří, neměnila. Pokud někdo změní pravidla firewallu, vrátí všechno zpět. „Rychle jsem zprovoznil proxy, abych mohl pracovat z domova“ – takové možnosti už neexistují.
BEFW kontroluje ipset ze služeb a seznamu v befw.conf, pravidla služeb v řetězci BEFW. Ale nesleduje jiné řetězce a pravidla a další ipset.
Ochrana proti haváriím
BEFW vždy ukládá poslední úspěšný stav přímo do binární struktury state.bin. Pokud se něco pokazí, vždy se vrátí zpět k tomuto state.bin.
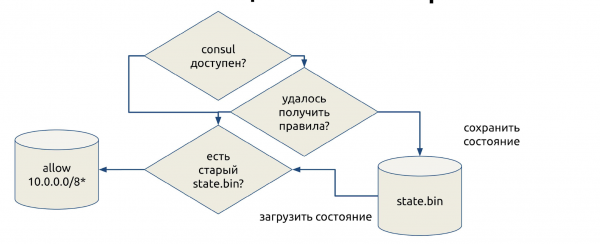
Je to pojistka proti nestabilnímu chování Consulu, když neodeslal data nebo někdo udělal chybu a použil pravidla, která nelze aplikovat. Abychom nezůstali bez firewallu, BEFW se vrátí k poslednímu stavu, pokud v nějakém okamžiku dojde k chybě.
V kritických situacích je to záruka, že zůstaneme s funkčním firewallem. Otevíráme všechny šedé sítě v naději, že správce přijde a opraví to. Někdy to přenesu do konfigurací, ale teď máme prostě tři šedé sítě: 10/8, 172/12 a 192.168/16. V rámci našeho Consulu je to důležitá vlastnost, která nám pomáhá dále se rozvíjet.
Demo: během prezentace Ivan demonstruje demo režim BEFW. Je pohodlnější sledovat demonstrování na . Zdrojový kód dema je k dispozici .
Úskalí
Povím o chybách, se kterými jsme se setkali.
ipset add set 0.0.0.0/0. Co se stane, když do ipset přidáte 0.0.0.0/0? Přidají se všechny IP adresy? Otevře se přístup na internet?
Ne, dostaneme chybu, která nás stála dvě hodiny výpadku. A to chyba nefunguje od roku 2016, leží v RedHat Bugzilla pod číslem #1297092, a našli jsme ji náhodou – z reportu vývojáře.
Nyní v BEFW platí přísné pravidlo, že 0.0.0.0/0 se mění na dvě adresy: 0.0.0.0/1 a 128.0.0.0/1.
ipset restore set < file. Co ipset dělá, když mu řeknete, že restore? Вы думаете, он работает также, как iptables? Восстановит данные?
Není to tak – dělá merge a staré adresy nikam nezmizí, přístup nezavíráte.
Našli jsme chybu, když jsme testovali izolaci. Nyní tam je docela složitý systém – místo restore probíhá create temp, pak restore flush temp a restore temp. Na konci swap: pro atomaritu, protože pokud nejprve provádíte flush A v tu chvíli přijde nějaký balík, který bude odmítnut, a něco se pokazí. Proto je zde trochu černé magie.
consul kv get -datacenter=other. Jak jsem již říkal, myslíme si, že žádáme o nějaká data, ale dostaneme buď data, nebo chybu. Můžeme to dělat přes Consul lokálně, ale i v tomto případě se to oboje zasekne.
Lokální klient Consul je obálka nad HTTP API. Ale prostě zamrzne a nereaguje ani na Ctrl+C, ani na Ctrl+Z, prostě na nic, pouze na kill -9 v vedlejší konzole. S tím jsme se setkali, když jsme budovali velký klastr. Ale zatím nemáme řešení, chystáme se opravit tuto chybu v Consul.
Consul leader nereaguje. Náš master v datovém centru nereaguje, myslíme si: "Snad nyní spustí algoritmus převolby?"
Ne, nespustí, a monitoring nic neukáže: Consul říká, že commit index existuje, leader nalezen, vše v pořádku.
Jak se s tím vyrovnáváme? service consul restart v cron každou hodinu. Pokud máte 50 serverů, není to strašné. Až jich bude 16 000, pochopíte, jak to funguje.
Závěr
Nakonec jsme získali následující výhody:
- 100% pokrytí všech Linuxových strojů.
- Rychlost.
- Automatizaci.
- Osvobodili jsme hardware a síťové inženýry z otroctví.
- Objevily se možnosti integrace, které jsou prakticky nekonečné: ať už s Kubernetes, Ansible nebo Python.
Nevýhody: Consul, se kterým teď musíme žít, a velmi vysoká cena chyby. Například jednou jsem v 6 odpoledne (v hlavním čase v Rusku) něco upravoval ve výčtech sítí. Právě jsme budovali izolaci na BEFW. Někde jsem se zmýlil, zdá se, že jsem uvedl nesprávnou masku, ale vše spadlo během dvou sekund. Monitoring se rozsvítil, přiběhl technik podpory: "Všechno nám padá!" Vedoucí oddělení zestárl, když vysvětloval byznysu, proč k tomu došlo.
Cena chyby je tak vysoká, že jsme vymysleli vlastní složitou proceduru prevence. Pokud to budete implementovat na velkém produkčním prostředí, nedávejte master token nad Consul všem bez výběru. To skončí špatně.
Náklady. Napsal jsem kód 400 hodin sám. Na podporu moje tým o 4 lidech tráví 10 hodin měsíčně na všechny. Ve srovnání s cenou jakéhokoli firewallu nové generace je to zadarmo.
Plány. Dlouhodobý plán je hledání alternativní dopravy jako náhrady nebo doplnění k Consul. Možná to bude Kafka nebo něco podobného. Ale v příštích letech budeme žít na Consul.
Nejbližší plány: integrace s Fail2ban, s monitorováním, s nftables, možná s jinými distribucemi, metriky, rozšířené monitorování, optimalizace. Podpora Kubernetes je také někde v plánech, protože nyní máme několik klastrů a zájem.
Další plány:
- vyhledávání anomálií v provozu;
- správa mapy sítě;
- podpora Kubernetes;
- kompilace balíčků pro všechny systémy;
- Web-UI.
Neustále pracujeme na rozšíření konfigurace, zvyšování metrik a optimalizaci.
Připojte se k projektu. Projekt se vydařil, ale bohužel je to zatím projekt jedné osoby. Přijďte na a zkuste něco udělat: přispět, otestovat, něco navrhnout, dát svou zpětnou vazbu.
Mezitím se připravujeme na , který se koná 6. a 7. dubna v Petrohradě, a zveme vývojáře vysoce zatěžovaných systémů, . Zkušení řečníci už vědí, co dělat, a nováčkům doporučujeme alespoň . Účast na konferenci jako řečník má řadu výhod. Jaké, si můžete přečíst například na konci .
Zdroj: habr.com
