

Ahoj, Habr! Představuji vám překlad článku
.
Když se mluví o relačních databázích, nemohu si pomoct, myslet si, že něco chybí. Používají se všude. Existuje mnoho různých databází: od malé a užitečné SQLite po výkonnou Teradata. Ale existuje jen několik článků, které vysvětlují, jak databáze fungují. Můžete sami vyhledávat s dotazem "jakfungujerelacnidatabaze" abyste viděli, kolik málo výsledků existuje. Kromě toho jsou tyto články krátké. Pokud však hledáte nejnovější trendy (BigData, NoSQL nebo JavaScript), najdete více podrobných článků, které vysvětlují, jak fungují.
Jsou relační databáze příliš zastaralé a nudné na to, aby je bylo možné vysvětlit mimo univerzitní kurzy, výzkumné práce a knihy?
Jako vývojář nesnáším používat to, čemu nerozumím. A pokud se databáze používají více než 40 let, musí být důvod. Během těchto let jsem strávil stovky hodin, abych skutečně porozuměl těmto podivným černým skříňkám, které používám každý den. Relační databáze jsou velmi zajímavé, protože jsou založeny na užitečných a opakovaně použitelných konceptech. Pokud vás zajímá porozumění databázi, ale nikdy jste neměli čas nebo chuť ponořit se do této široké problematiky, tato článek se vám bude líbit.
I když je název tohoto článku jasný, cílem tohoto článku není pochopit, jak používat databázi. Protože už byste měli vědět, jak napsat jednoduchý dotaz pro spojení a základní dotazy CRUD; jinak byste mohli tomuto článku nerozumět. To je jediné, co potřebujete vědět, vysvětlím všechno ostatní.
Začnu s některými základy informatiky, jako je časová složitost algoritmů (BigO). Vím, že někteří z vás tuto koncepci nenávidí, ale bez ní nebudete moci pochopit nuance uvnitř databáze. Protože je to obrovské téma, zaměřím se na to, co považuji za důležité: jak databáze zpracovává SQL žádost. Představím pouze základní koncepty databáze, aby na konci článku jste měli představu o tom, co se děje pod kapotou.
Protože se jedná o dlouhý a technický článek, který obsahuje řadu algoritmů a datových struktur, nechte si čas na jeho přečtení. Některé koncepty mohou být složité na pochopení; můžete je přeskočit a přesto získat celkový přehled.
Pro ty z vás, kteří máte více znalostí, je tento článek rozdělen do 3 částí:
- Přehled nízkoúrovňových a vysokoúrovňových komponent databáze
- Přehled procesu optimalizace dotazů
- Přehled správy transakcí a vyrovnávací paměti
Vrátíme se k základům
Před mnoha lety (v jedné, jediné galaxii…) museli vývojáři přesně znát počet operací, které kódovali. Znali své algoritmy a datové struktury zpaměti, protože si nemohli dovolit plýtvat CPU a pamětí svých pomalých počítačů.
V této části vám připomenu některé z těchto konceptů, protože jsou nezbytné pro pochopení databáze. Také zavádím pojem databázového indexu.
O(1) vs O(n2)
Dnes se mnoho vývojářů nezabývá časovou složitostí algoritmů … a mají pravdu!
Ale když pracujete s velkým množstvím dat (nemluvím o tisících) nebo se snažíte o milisekundy, stává se kriticky důležité pochopit tento koncept. A jak chápete, databáze se musí vyrovnat s oběma situacemi! Nechci vás nutit trávit více času, než je nutné k uchopení podstaty. To nám později pomůže pochopit koncept nákladové optimalizace (cost based optimization).
Koncept
Časová složitost algoritmu se používá k určení, kolik času zabere provedení algoritmu pro daný objem dat.. K popisu této složitosti se používají matematické notace velkého O. Tato notace se používá s funkcí, která popisuje, kolik operací je třeba algoritmu pro dané množství vstupních dat.
Například když řeknu "tento algoritmus má složitost O (some_function() )", znamená to, že pro zpracování určitého objemu dat potřebuje algoritmus some_function(a_certain_amount_of_data) operací.
Přitom je důležité, kolik dat**, ale jak, ** se zvyšuje počet operací se zvyšujícím se objemem dat.. Časová složitost neposkytuje přesný počet operací, ale je dobrým způsobem pro odhad doby vykonávání.
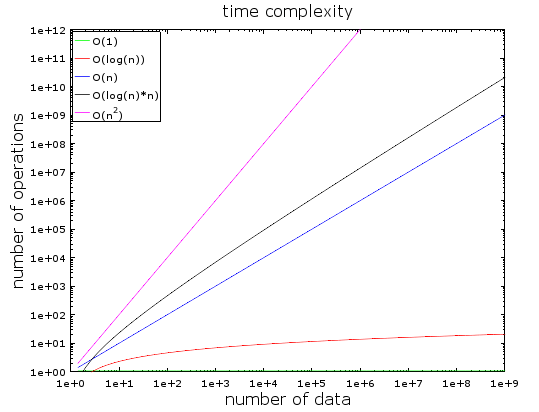
V tomto grafu můžete vidět vztah mezi počtem operací a velikostí vstupních dat pro různé typy časových složitostí algoritmů. Použil jsem logaritmickou stupnici, abych je zobrazil. Jinými slovy, množství dat rychle roste z 1 na 1 miliardu. Můžeme vidět, že:
- O(1) nebo konstantní složitost zůstávají konstantní (jinak by to nebylo považováno za konstantní složitost).
- útoky jsou dnes velmi rozšířené ve světě počítačových serverů. Jejich hlavním cílem je vyřadit servery z provozu pomocí mnoha požadavků. V důsledku takového útoku jsou servery zahlceny požadavky a vypínají se. Tento typ útoku je nyní velmi populární mezi hackery. Vydírají peníze za zastavení takového útoku. Obvykle je organizován pomocí „trojských koní“, které se do počítače dostanou často z internetu.(log(n)) zůstává nízká i při miliardách dat.
- Nejhorší složitost je - O(n2), kde počet operací rychle roste.
- Obě další složitosti se také rychle zvyšují.
Příklady
Při malém množství dat je rozdíl mezi O(1) a O(n2) zanedbatelný. Například předpokládejme, že máte algoritmus, který musí zpracovat 2000 prvků.
- Algoritmus O(1) vás vyjde na 1 operaci
- Algoritmus O(log(n)) vás vyjde na 7 operací
- Algoritmus O(n) vás vyjde na 2000 operací
- Algoritmus O(n * log(n)) vás vyjde na 14 000 operací
- Algoritmus O(n2) vás vyjde na 4 000 000 operací
Rozdíl mezi O(1) a O(n2) se zdá být velký (4 miliony operací), ale ztratíte maximálně 2 ms, jen čas na mrknutí očima. Skutečně, moderní procesory mohou zpracovat . Proto výkon a optimalizace nejsou problémem v mnoha IT projektech.
Jak jsem již řekl, stále je důležité znát tuto koncepci při práci s obrovským množstvím dat. Pokud nyní algoritmus musí zpracovat 1 000 000 prvků (což není příliš mnoho pro databázi):
- Algoritmus O(1) vás vyjde na 1 operaci
- Algoritmus O(log(n)) vás vyjde na 14 operací
- Algoritmus O(n) vás vyjde na 1 000 000 operací
- Algoritmus O(n * log(n)) vás vyjde na 14 000 000 operací
- Algoritmus O(n2) vás vyjde na 1 000 000 000 000 operací
Nedělal jsem výpočty, ale řekl bych, že s algoritmem O(n2) máte čas na kávu (dokonce i dva!). Pokud k objemu dat přidáte další 0, máte čas si zdřímnout.
Jdeme hlouběji
Pro informaci:
- Vyhledávání v dobré hashovací tabulce najde prvek za O(1).
- Vyhledávání ve dobře vyváženém stromu dává výsledek za O(log(n)).
- Vyhledávání v poli dává výsledek za O(n).
- Nejlepší algoritmy řazení mají složitost O(n * log(n)).
- Špatný algoritmus řazení má složitost O(n2).
Poznámka: V následujících částech uvidíme tyto algoritmy a datové struktury.
Existuje několik typů časové složitosti algoritmu:
- scénář průměrného případu
- nejlepší případ
- a nejhorší scénář
Časová složitost často představuje nejhorší scénář.
Mluvil jsem pouze o časové složitosti algoritmu, ale složitost se také vztahuje na:
- spotřebu paměti algoritmem
- spotřebu diskového vstupu/výstupu algoritmem
Samozřejmě, existují složitosti horší než n², například:
- n⁴: to je katastrofa! Některé z uvedených algoritmů mají takovou složitost.
- 3n: to je ještě horší! Jeden z algoritmů, který uvidíme v polovině tohoto článku, má tuto složitost (a skutečně se používá ve většině databází).
- faktoriál n: nikdy nedostanete své výsledky ani s malým množstvím dat.
- nⁿ: pokud se setkáte s touto složitostí, měli byste se ptát, zda je to opravdu vaše oblast …
Poznámka: Dal jsem vám pouze myšlenku, nikoli skutečnou definici označení „velké O“. Můžete si přečíst tento článek v pro skutečnou (asymptotickou) definici.
MergeSort (Související třídění)
Co děláte, když potřebujete seřadit kolekci? Co? Zavoláte funkci sort()… Oka, dobrá odpověď… Ale pro databázi musíte rozumět tomu, jak funguje tato funkce sort().
Existuje několik dobrých algoritmů třídění, takže se zaměřím na ten nejdůležitější: třídění sloučením. Možná teď nechápete, proč je třídění dat užitečné, ale budete muset pochopit, až se dostaneme k části věnované optimalizaci dotazů. Navíc porozumění třídění sloučením nám pomůže později pochopit společnou databázovou operaci zvanou sloučit připojit (sloučení).
Merge (sloučení)
Stejně jako mnoho užitečných algoritmů, třídění sloučením se zakládá na fintu: sloučení 2 seřazených polí o velikosti N/2 do N-prvkového seřazeného pole vyžaduje pouze N operací. Tato operace se nazývá sloučení.
Podívejme se, co to znamená na jednoduchém příkladu:
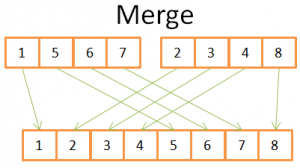
Na tomto obrázku vidíte, že pro vytvoření konečného seřazeného pole o 8 prvcích potřebujete pouze jednu iteraci v 2 čtyřprvkových polích. Protože obě čtyřprvková pole jsou již seřazena:
- 1) porovnáte oba aktuální prvky v dvou polích (na začátku aktuální = prvnímu)
- 2) poté vezměte ten nejmenší a vložte ho do pole o 8 prvcích
- 3) a přejděte k dalšímu prvku v poli, kde jste vzali nejmenší prvek
- a opakujte 1, 2, 3, dokud nedosáhnete posledního prvku jednoho z polí.
- Pak vezmete zbývající prvky druhého pole, aby se umístily do pole o 8 prvcích.
To funguje, protože obě pole o 4 prvcích jsou seřazena, a proto se v těchto polích nemusíte 'vracet'.
Nyní, když jsme tento trik pochopili, zde je můj pseudokód pro merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //rekurzivní volání
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //sloučení 2 malých seřazených polí do jednoho velkého
   array result := merge(new_left_array,new_right_array);
   return result;
Slučovací třídění rozděluje úkol na menší úkoly a poté získává výsledky menších úkolů k získání výsledku původního úkolu (poznámka: tento typ algoritmů se nazývá rozděluj a panuj). Pokud tento algoritmus nechápete, nebojte se; také jsem to poprvé nepochopil, když jsem to viděl. Pokud vám to může pomoci, vidím tento algoritmus jako dvoufázový algoritmus:
- Fáze rozdělení, kdy se pole dělí na menší pole
- Fáze třídění, kdy se malá pole spojují (pomocí sloučení) a vytvářejí větší pole.
Fáze rozdělení
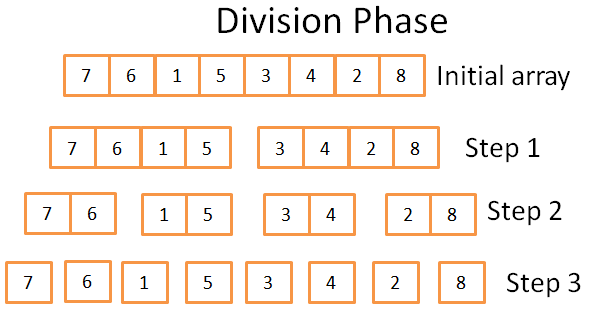
Ve fázi rozdělení je pole rozděleno na jednotková pole ve 3 krocích. Formální počet kroků je log(N) (protože N=8, log(N) = 3).
Odkud to vím?
Jsem génius! Jinými slovy — matematika. Myšlenka spočívá v tom, že každý krok dělí velikost původního pole na 2. Počet kroků je početkrát, které můžete rozdělit původní pole na dva. To je přesná definice logaritmu (se základem 2).
Fáze třídění
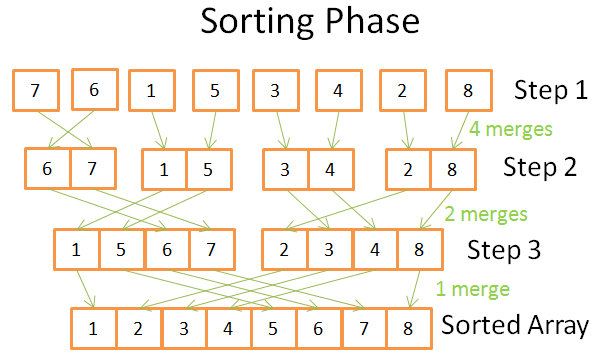
Ve fázi třídění začínáte s jednotkovými (jednoelementními) poli. Během každé fáze aplikujete několik sloučovacích operací a celkové náklady činí N = 8 operací:
- V první fázi máte 4 sloučení, které stojí 2 operace každý
- Ve druhém kroku máte 2 sloučení, která stojí 4 operace každé
- Ve třetím kroku máte 1 sloučení, které stojí 8 operací
Jelikož existuje log (N) kroků, celkové náklady N * log(N) operací.
Výhody sloučení sort
Proč je tento algoritmus tak mocný?
Protože:
- Můžete ho upravit tak, aby snížil objem paměti, tím, že nebudete vytvářet nové pole, ale přímo měnit vstupní pole.
Poznámka: Tento typ algoritmů se nazývá (řazení bez dalších paměťových nároků).
- Můžete ho upravit tak, aby současně využíval diskový prostor a malý objem paměti bez významných nákladů na diskové vstupy/výstupy. Myšlenka spočívá v tom, že do paměti se načítají pouze ty části, které jsou právě zpracovávány. To je důležité, když potřebujete seřadit tabulku o velikosti několika gigabajtů s pouze 100 megabajty paměti.
Poznámka: Tento typ algoritmů se nazývá .
- Můžete ho upravit pro běh na několika procesech / vláknech / serverech.
Například distribuované řazení sloučením je jednou z klíčových komponent (která je strukturou ve velkých datech).
- Tento algoritmus dokáže přetavit olovo ve zlato (opravdu!).
Tento řadicí algoritmus se používá ve většině (pokud ne ve všech) databázích, ale není jediný. Pokud se chcete dozvědět více, můžete si přečíst tuto , která diskutuje o výhodách a nevýhodách běžných řadících algoritmů v databázích.
Pole, Strom a Hašovací tabulka
Nyní, když rozumíme myšlence časové složitosti a řazení, musím vám říct o 3 datových strukturách. To je důležité, protože jsou základem moderních databází. Také uvedu pojem databázového indexu.
Pole
Dvourozměrné pole — nejjednodušší datová struktura. Tabulka může být považována za pole. Například:
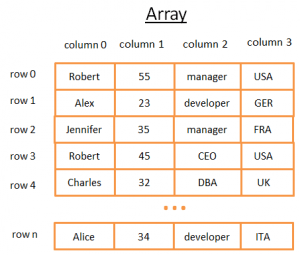
Toto 2-dimenzionální pole představuje tabulku seřazenou do řad a sloupců:
- Každý řádek představuje entitu
- Sloupce uchovávají vlastnosti, které popisují entitu.
- Každý sloupec uchovává data určitého typu (celé číslo, řetězec, datum …).
Je pohodlné uchovávat a vizualizovat data, avšak když potřebujete najít určitou hodnotu, to není vhodné.
Například pokud chcete najít všechny kluky, kteří pracují ve Velké Británii, budete muset projít každý řádek, abyste určili, zda daný řádek patří k Velké Británii. To vás bude stát N operací, kde N — počet řádků, což není špatné, ale existuje rychlejší cesta? Nyní je čas se seznámit se stromy.
Poznámka: většina moderních databází poskytuje rozšířené pole pro efektivní ukládání tabulek: heap-organizedtables a index-organizedtables. To však neřeší problém rychlého vyhledávání určité podmínky ve skupině sloupců.
Strom a index databáze
Binarni vyhledávací strom je binární strom se speciálním vlastnictvím, klíč v každém uzlu musí být:
- větší než všechny klíče uložené v levém podstromu
- menší než všechny klíče uložené v pravém podstromu
Podívejme se, co to znamená vizuálně
Nápad
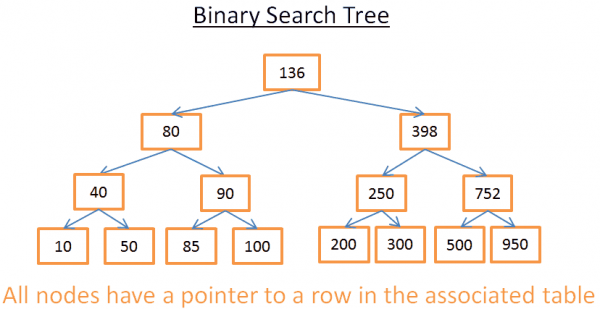
Tento strom má N = 15 prvků. Předpokládejme, že hledám 208:
- Začínám u kořene, jehož klíč je 136. Protože 136<208, hledám v pravém podstromu uzlu 136.
- 398>208, takže hledám v levém podstromu uzlu 398
- 250>208, takže hledám v levém podstromu uzlu 250
- 200<208, takže hledám v pravém podstromu uzlu 200. Ale 200 nemá pravý podstrom, hodnota neexistuje (protože, pokud by existovala, byla by v pravém podstromu 200).
Nyní říkejme, že hledám 40
- Začínám u kořene, jehož klíč je 136. Protože 136 > 40, hledám v levém podstromu uzlu 136.
- 80 > 40, takže hledám v levém podstromu uzlu 80
- 40= 40, uzel existuje. Vytáhnu identifikátor řádku uvnitř uzlu (ten na obrázku není) a podívám se do tabulky pro daný identifikátor řádku.
- Znalost identifikátoru řádku mi umožňuje zjistit, kde přesně se data v tabulce nacházejí, a tedy je mohu získat okamžitě.
Nakonec oba vyhledávání mě stála počet úrovní uvnitř stromu. Pokud pečlivě přečtete část o sloučení, měli byste vidět, že zde jsou úrovně log (N). Výsledkem je, náklady na vyhledávání log(N), není to špatné!
Vracíme se k našemu problému
Ale to je velmi abstraktní, tak se vraťme k našemu problému. Místo jednoduchého celého čísla si představte řetězec, který představuje zemi někoho v předchozí tabulce. Předpokládejme, že máte strom, který obsahuje pole "country" (sloupec 3) tabulky:
- Pokud chcete vědět, kdo pracuje ve Velké Británii
- podíváte se na strom, abyste získali uzel, který představuje Velkou Británii
- uvnitř "UKnode" najdete umístění záznamů pracovníků ve Velké Británii.
Tento vyhledávání bude stát log(N) operací místo N operací, pokud nebudete přímo používat pole. To, co jste právě představili, bylo index databáze.
Můžete postavit indexové strom pro jakoukoli skupinu polí (řetězec, číslo, 2 řetězce, číslo a řetězec, datum ...) za předpokladu, že máte funkci pro porovnání klíčů (tj. skupin polí), aby bylo možné určit pořadí mezi klíči (což platí pro jakékoli základní typy v databázi).
B+TreeIndex
Ačkoli tento strom dobře funguje pro získání konkrétní hodnoty, existuje VELKÝ problém, když potřebujete získat několik prvků mezi dvěma hodnotami. To bude stát O(N), protože budete muset projít každý uzel ve stromu a zkontrolovat, zda se nachází mezi těmito dvěma hodnotami (například pomocí seřazeného průchodu stromem). Navíc, tato operace není výhodná pro diskový vstup/výstup, protože budete muset přečíst celý strom. Musíme najít způsob, jak efektivně provést rozsahový dotaz. K vyřešení tohoto problému moderní databáze používají upravenou verzi předchozího stromu nazvanou B+Tree. V B+Tree:
- pouze nejnižší uzly (listy) uchovávají informace (umístění řádků ve spojené tabulce)
- ostatní uzly jsou zde pro směrování k správnému uzlu během vyhledávání.
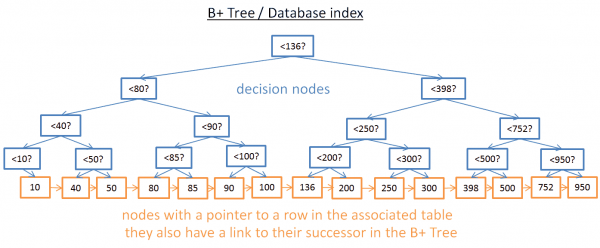
Jak vidíte, zde je více uzlů (dvojnásobek). Odkud jste, máte další uzly, 'uzly rozhodování', které vám pomohou najít správný uzel (který uchovává umístění řádků ve spojené tabulce). Ale složitost vyhledávání je stále O(log(N)) (je zde pouze další úroveň). Velký rozdíl spočívá v tom, že uzly na dolní úrovni jsou propojeny se svými následovníky.
S tímto B+Tree, pokud hledáte hodnoty od 40 do 100:
- Musíte jednoduše hledat 40 (nebo nejbližší hodnotu po 40, pokud 40 neexistuje), jak jste to dělali s předchozím stromem.
- Pak shromážděte následovníky 40, pomocí přímých odkazů na následovníky, dokud nedosáhnete 100.
Předpokládejme, že jste našli M následovníků, a strom má N uzlů. Hledání konkrétního uzlu stojí log(N) podobně jako předchozí strom. Ale, jakmile máte tento uzel, obdržíte M následovníků v M operacích s odkazy na jejich následovníky. Toto hledání stojí pouze M+log(N) operací v porovnání s N operacemi u předchozího stromu. Navíc nemusíte číst celý strom (pouze M + log (N) uzlů), což znamená menší využití disku. Pokud je M malé (například 200 řádků) a N velké (1 000 000 řádků), bude to VELKÝ rozdíl.
Ale tady jsou nové problémy (znovu!). Pokud přidáte nebo odstraníte řádek v databázi (a tedy v souvisejícím indexu B+Tree):
- musíte udržovat pořádek mezi uzly uvnitř stromu B+Tree, jinak nebudete moci najít uzly uvnitř neuspořádaného stromu.
- musíte udržet minimální možný počet úrovní v B+Tree, jinak se časová složitost v O (log (N)) stane O (N).
Jinými slovy, B+Tree musí být samouspořádávací a vyvážené. Naštěstí je to možné se sofistikovanými operacemi odstranění a vložení. Ale je to drahé: vložení a odstranění ve stromu B+ stojí O (log (N)). Proto někteří z vás slyšeli, že používání příliš velkého počtu indexů není příliš dobrý nápad. Opravdu, příliš zpomalujete rychlé vložení / aktualizaci / odstranění řádku v tabulce, protože databázi je třeba aktualizovat indexy tabulky pomocí nákladné operace O (log (N)) pro každý index. Navíc přidání indexů znamená větší zátěž pro správce transakcí (bude popsán na konci článku).
Pro podrobnější informace se můžete podívat na článek na Wikipedii o . Pokud chcete příklad implementace B+Tree v databázi, podívejte se na a od hlavního vývojáře MySQL. Obojí se zaměřuje na to, jak InnoDB (motor MySQL) zpracovává indexy.
Poznámka: čtenář mi řekl, že kvůli nízkoúrovňovým optimalizacím musí být strom B+ zcela vyvážený.
Hashtable (Hash tabulka)
Naší poslední důležitou datovou strukturou je hash tabulka. Je to velmi užitečné, když chcete rychle vyhledávat hodnoty. Navíc pochopení hash tabulky nám pomůže později pochopit obecnou operaci spojení s databází, nazývanou hash join ( hash join). Tato datová struktura se také používá databází k ukládání některých vnitřních věcí (např., tabulka zámků nebo buffer pool, obě tyto koncepty uvidíme později).
Hash table je datová struktura, která rychle vyhledává prvek podle jeho klíče. Pro vytvoření hash tabulky musíte definovat:
- klíč pro vaše prvky
- hashovací funkci pro klíče. Vypočítané hash kódy klíčů určují umístění prvků (nazývaných segmenty ).
- funkci pro porovnání klíčů. Jakmile najdete správný segment, musíte najít prvek, který hledáte uvnitř segmentu, pomocí tohoto porovnání.
Jednoduchý příklad
Podívejme se na názorný příklad:
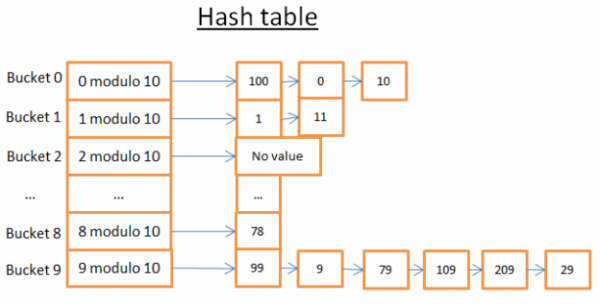
Tato hash tabulka má 10 segmentů. Protože jsem líný, zobrazil jsem pouze 5 segmentů, ale vím, že jste chytří, a tak vám dovolím představit si dalších 5 sami. Použil jsem hashovací funkci podle modu 10 klíče. Jinými slovy, uchovávám pouze poslední číslici klíče prvku, abych našel jeho segment:
- pokud je poslední číslice 0, prvek patří do segmentu 0,
- pokud je poslední číslice 1, prvek patří do segmentu 1,
- pokud je poslední číslice 2, prvek patří do oblasti 2,
- …
Funkce porovnání, kterou jsem použil, je prostě rovnost mezi dvěma celými čísly.
Řekněme, že chcete získat prvek 78:
- Hash tabulka vypočítá hash kód pro 78, který je 8.
- Hash tabulka se dívá do segmentu 8 a první prvek, který najde, je 78.
- Vrací vám prvek 78
- Vyhledávání stálo pouze 2 operace (jedna pro výpočet hodnoty hashovací funkce a druhá pro hledání prvku uvnitř segmentu).
Teď si představte, že chcete získat prvek 59:
- Hash tabulka vypočítá hash kód pro 59, který je 9.
- Hash tabulka hledá v segmentu 9, první nalezený prvek je 99. Protože 99!=59, prvek 99 není správný prvek.
- Pomocí této samé logiky se bere druhý prvek (9), třetí (79), …, poslední (29).
- Prvek nebyl nalezen.
- Vyhledávání stálo 7 operací..
Dobrá hashovací funkce
Jak vidíte, v závislosti na hodnotě, kterou hledáte, není cena stejná!
Pokud nyní změním hashovací funkci podle modu 1 000 000 od klíče (tj. vezmu posledních 6 číslic), druhé hledání bude stát pouze 1 operaci, protože v segmentu 000059 nejsou žádné prvky. Skutečnou výzvou je najít dobrou hashovací funkci, která bude vytvářet segmenty obsahující velmi malé množství prvků..
Ve svém příkladu je snadné najít dobrou hash funkci. Ale pokud jde o složitější případy, je těžší najít dobrou hash funkci, když je klíčem:
- řetězec (například příjmení)
- 2 řetězce (například příjmení a jméno)
- 2 řetězce a datum (například příjmení, jméno a datum narození)
- …
S dobrou hash funkcí je vyhledávání v hash tabulce v O(1).
Pole vs hash tabulka
Proč nepoužít pole?
Hmm, dobrá otázka.
- Hash tabulka může být částečně načtena do paměti, zatímco ostatní segmenty mohou zůstat na disku.
- S polem musíte použít souvislý prostor v paměti. Pokud načítáte velkou tabulku, je velmi obtížné najít dostatečně souvislý prostor..
- Pro hash tabulku si můžete vybrat požadovaný klíč (například zemi a příjmení člověka).
Pro další informace si můžete přečíst článek o , která je efektivní implementací hash tabulky; nemusíte rozumět Javě, abyste pochopili koncepty uvedené v tomto článku.
Zdroj: habr.com
