

Ahoj všichni.
Jsem linuxový administrátor, který se v roce 2015 přestěhoval z Ruska do Austrálie na nezávislou profesní vízu, ale článek nebude o tom, jak prasátko sehnat traktor. Takových článků je už dost (pokud by byl zájem — napíšu o tom také), chtěl bych se podělit o to, jak jsem na své práci v Austrálii v pozici linux ops inženýra inicioval migraci z jednoho monitorovacího systému na druhý. Konkrétně — z Nagiosu na Icinga2.
Článek je částečně technický a částečně o komunikaci s lidmi a problémech spojených s rozdíly v kultuře a pracovních metodách.
Bohužel tag „code“ neoznačuje kód Puppet a yaml, takže jsem musel použít „plaintext“.
Nic nenasvědčovalo problémům ráno 21. prosince 2016. Jako obvykle jsem prvních půl hodiny pracovního dne četl Habr jako neregistrovaný anonymní uživatel, popíjel kávu a narazil na .
Jelikož v mé firmě se zrovna používal Nagios, bez váhání jsem vytvořil tiket v Redmine a poslal odkaz do společného chatu, protože jsem to považoval za důležité. Iniciativa je trestána i v Austrálii, takže hlavní inženýr přiřadil tento problém mně, když jsem ho objevil.
Snímek z Redmine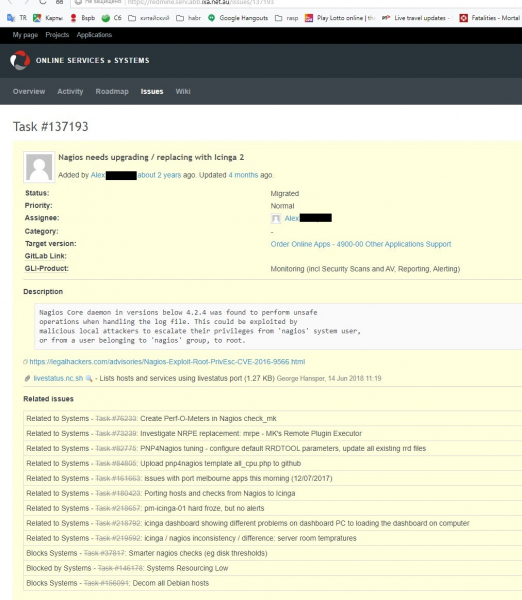
V našem oddělení je zvykem při vyjadřování názoru navrhnout alespoň jednu alternativu, i když je výběr zřejmý, takže jsem začal vyhledáváním, jaké monitorovací systémy jsou v současnosti relevantní, protože v Rusku, na posledním místě práce, jsem měl vlastní jednoduchý systém, který byl velmi primitivní, ale přesto plně funkční a splňoval všechny úkoly. Python, Petrohradský polytechnický institut a metro jsou top. Ne, metro — je hrozné. To je osobní (11 let práce) a zaslouží si samostatný článek, ale teď ne.
Trochu o pravidlech pro provádění změn v konfiguraci infrastruktury na mém současném pracovišti. Používáme Puppet, Gitlab a princip Infrastructure as Code, takže:
- Žádné ruční změny přes SSH tím, že se ručně mění jakékoli soubory na virtuálních strojích. Během tří let práce jsem za to dostal vynadáno mnohokrát, naposledy před týdnem a nemyslím, že to byla poslední výtka. No opravdu — opravit jeden řádek v konfiguraci, restartovat službu a zkontrolovat, zda se problém vyřešil — 10 sekund. Vytvořit novou větev v Gitlabu, pushnout změny, počkat, až r10k zpracuje na Puppetmasteru, spustit Puppet —environment=mybranch a ještě pár minut počkat, než to vše proběhne — minimálně 5 minut.
- Jakékoli změny se provádějí vytvořením Merge Request v Gitlabu a je třeba získat schválení minimálně od jednoho člena týmu. Závažné změny na základě rozhodnutí týmového lídra vyžadují dvě nebo tři schválení.
- Všechny změny jsou víceméně textové (protože manifesty Puppet, skripty a data Hiera jsou text), binační soubory jsou velmi nedoporučované a pro schválení takových souborů jsou potřeba vážné důvody.
Takže možnosti, které jsem zvážil:
- Munin — pokud je v infrastruktuře více než 10 serverů, správa se stává peklem (z . Neměl jsem zvláštní chuť to ověřovat, takže jsem věřil na slovo).
- Zabbix — už jsem na něj koukal, ještě v Rusku, ale tehdy byl pro mé úkoly nadbytečný. Tady — musel jsem ho odmítnout kvůli používání Puppet jako správce konfigurace a Gitlab jako systému pro řízení verzí. V té době, jak jsem pochopil — Zabbix ukládá veškerou konfiguraci do databáze, a proto nebylo jasné, jak spravovat konfiguraci v aktuálních podmínkách a jak sledovat změny.
- Prometheus — na co nakonec dojdeme, soudě podle nálady v oddělení, ale v té době jsem to nezvládl a nedokázal jsem předvést skutečně funkční vzorek (Proof of Concept), takže jsem musel ustoupit.
- Ještě bylo několik dalších možností, které buď vyžadovaly kompletní přepracování systému, nebo byly v počátečním stádiu / opuštěny, a proto byly také odmítnuty.
Nakonec jsem se rozhodl pro Icinga2 ze tří důvodů:
1 — kompatibilita s Nrpe (klientskou službou, která spouští kontroly na příkazy od Nagiosu). To bylo velmi důležité, protože jsme v té době měli 135 (nyní v roce 2019 jich je 165) virtuálních strojů s mnoha vlastním napsanými službami/zkouškami a předělávat to všechno by bylo pořádné peklo.
2 — všechny konfigurační soubory jsou textové, což umožňuje snadno je upravit, vytvářet merge requesty s možností vidět, co bylo přidáno nebo odstraněno.
3 — jedná se o živý a vyvíjející se projekt OpenSource. My máme OpenSource velmi rádi a přispíváme ho tím, že vytváříme Pull Requests a Issues pro řešení problémů.
Takže, jdeme na to, Icinga2.
První, s čím jsem se musel potýkat — inertnost kolegů. Všichni byli zvyklí na Nagios/Nadgios (i když ani zde jsme se neshodli, jak to správně vyslovovat) a rozhraní CheckMK. U Icinga vypadá rozhraní úplně jinak (to byla nevýhoda), ale je tu možnost flexibilně nastavovat to, co potřebujete vidět, pomocí filtrů doslova podle jakéhokoliv parametru (to byla výhoda, ale za tu jsem musel dost bojovat).
Filtry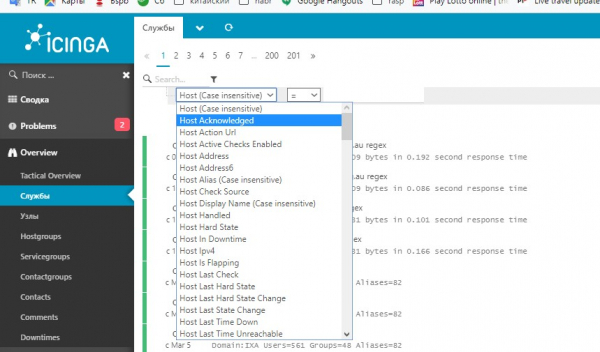
Zhodnoťte poměr velikosti posuvníku k velikosti oblasti pro posouvání.
Druhá věc — všichni byli zvyklí vidět celou infrastrukturu na jednom monitoru, protože CheckMK umožňuje pracovat s několika hostiteli Nagios, ale rozhraní Icinga to neumělo (ve skutečnosti umělo, ale o tom níže). Alternativou byla věc zvaná Thruk, ale její design vyvolával zvracení u všech členů týmu, kromě jednoho — toho, kdo to navrhl (ne já).
Thruk do čerta — jednohlasné rozhodnutí týmu.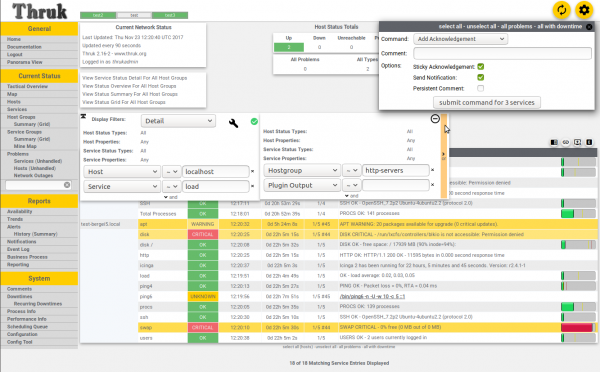
Po několika dnech brainstormingu jsem navrhl myšlenku clusterového monitoringu, kdy je jeden master host v produkční zóně a dva podřízené – jeden v dev/test a jeden externí host umístěný u jiného poskytovatele, za účelem monitorování našich služeb z pohledu zákazníka nebo externího pozorovatele. Taková konfigurace umožňovala vidět všechny problémy v jednom webovém rozhraní a celkem fungovala, ale Puppet… Problém s Puppet byl v tom, že master host nyní musel vědět o všech hostech a službách/zkouškách v systému a musel je rozdělovat mezi zóny (dev-test, staging-prod, ext), ale odesílání změn přes Icinga API trvá pár sekund, zatímco kompilace katalogu Puppet všech služeb pro všechny hosty trvá pár minut. To mi stále vyčítají, i když jsem už několikrát vysvětloval, jak to funguje a proč to celé trvá tak dlouho.
Třetí – spousta SnowFlakes (sněhových vloček) – věcí, které se vymykají obvyklému systému, protože mají něco zvláštního, takže obecné pravidla se na ně nevztahují. Řešilo se to přímým tlakem – pokud jsou alarmy, ale ve skutečnosti je všechno v pořádku, znamená to, že je třeba hlouběji zkoumat, proč to vyvolává alarm, i když by nemělo. Nebo naopak – proč Nagios panikaří, zatímco Icinga ne.
Čtvrté – Nagios tu pracoval tři roky předtím a mu bylo zpočátku důvěřováno více než mé moderní hipsterovské systému, takže pokaždé, když Icinga vyvolala paniku, nikdo nic nedělal, dokud se Nagios nerozčílil ohledně stejného problému. Ale velmi zřídka Icinga vyhazovala skutečné alarmy dříve než Nagios, a to považuji za vážný problém, o kterém budu hovořit v části 'Závěry'.
Nakonec byl uvedení do provozu zpožděno o více než 5 měsíců (plánováno na 28. června 2018, fakticky – 3. prosince 2018), převážně kvůli 'parity check' – té věci, kdy je několik služeb v Nagios, o nichž nikdo nic neslyšel poslední pár let, ale PRÁVĚ TEĎ, sakra, vydaly kritický alarm bez jakéhokoli důvodu a musel jsem vysvětlovat, proč nejsou na mé panelu a musel jsem je přidat do Icinga, aby 'parity check byl kompletní' (Všechny služby/zkoušky v Nagios odpovídají službám/zkouškám v Icinga).
Implementace:
První — válka Code vs Data, něco jako Puppet Style. Všechna data, opravdu všechna, musí být v Hiera a jinak tomu nebude. Všechno kódové — ve .pp souborech. Proměnné, abstrakce, funkce — všechno jde do pp.
V důsledku — máme spoustu virtuálních strojů (165 v době psaní článku) a 68 webových aplikací, které je třeba sledovat z hlediska funkčnosti a platnosti SSL certifikátů. Ale kvůli historickým problémům se informace pro monitorování aplikací získávají z jiného gitlab repozitáře a formát dat se nezměnil od dob Puppet 3, což způsobuje další komplikace v konfiguraci.
Kód Puppet pro aplikace, chraňte si oči
definovat profily::služby::monitoring::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APLIKACE ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # přidává oznámení pro výchozí skupinu (systémy) + jakoukoli skupinu definovanou v int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Vyberte regex pro kontrolu

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '\/'' },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Rozdělte aplikaci podle domén, pokud jich je dvě nebo více
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Ujistěte se, že IP adresa je pole, pokud není, protože askizzy má 2 ips a je to pole
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Sloučte výchozí zónu (kde je aplikace definována) a další zóny, pokud existují
      $web_ipaddress.each | String $ip_address | {            # Pro každou IP (pokud máme více)
        $suffix = length($web_ipaddress) ? {                  # Pokud máme více než jednu - přidejte IP jako příponu k tomuto názvu hostitele, abyste se vyhnuli duplicitním zdrojům
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Použití posledního oktetu způsobuje kolizi mezi nginx-vip 203.15.70.94 a ext. ip 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Pokud je to hostitel pro ext - prefix se stává 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
Kód konfigurace hostitelů a služeb také vypadá hrozně:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <> # bude aktivováno, když přejdeme na icingu úplně
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Ujistěte se, že má uzel nastavený fakt $location (int, pm, ext)')
    }
  }

  file { '/etc/icinga2/conf.d/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"/etc/icinga2/conf.d/${file_name}":
      ensure => present,
      source => "puppet:///modules/profiles/services/monitoring/default_config/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <> # Toto je pro invazi vesmírných lodí, až to bude připravené.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Rozdělení seznamů webů podle hostgroup - docker_host/gluster_host/atd
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Rozdělení seznamů podle hostů
      # Je tento host v poli $hosts_has_large_disks? Pokud ano, nastavte host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Merging vars zvlášť

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Všechny hosty spravované API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Rozdělit hlavičky API podle zón
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Rozdělení seznamů webů podle hostgroup - docker_host/gluster_host/atd
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Rozdělení seznamů podle hostů
          # Je tento host v poli $hosts_has_large_disks? Pokud ano, nastavte host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}/${zone}/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### KONEC HOSTŮ ####

####   SLUŽBY   ####

  $services.each | String $service_group, Hash $s_list |{             # Skupina služeb a seznam služeb v této skupině
    $service_list = $s_list['checks']                                 # Seznam skutečných kontrol, odděleně od nastavení SG
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # globální výchozí nastavení služby + výchozí nastavení skupiny služeb
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Pokud přepisujeme výchozí check_timeout, ale ne nrpe_timeout, nastavíme nrpe_timeout na stejnou hodnotu jako check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # POZOR: Icinga automaticky převede 1m na 60!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Ve výchozím nastavení používáme nrpe a všechny příkazy se provádí prostřednictvím nrpe. Takže vars.nrpe_command = $service_name je výchozí hodnota
      # Pokud je to server-side Icinga příkaz - nepotřebujeme 'nrpe_command'
      # ale není na škodu mít tuhle proměnnou a kód je kratší

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Sestavení $vars z celkových výchozích nastavení služby, nastavení skupiny služeb, nastavení tohoto konkrétního kontroly a nezapomínejme na nrpe nastavení.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick je požadováno všude, jinak se stává "Hodnota '' nemůže být převedena na číselnou"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Přiřazení výchozí skupiny (systémy), pokud nejsou definovány žádné jiné skupiny

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Toto musí být sloučeno zvlášť, protože slučování jako součást MERGED_DATA přepisuje pole namísto jejich slučování, takže ztrácíme některé "přiřaď" a "ignoruj" hodnoty

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### KONEC SLUŽEB ####

#### DALŠÍ NUDNÉ VĚCI ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Slučování nastavení oznámení pro uživatele s jinými nastaveními
  $users_oncall = deep_merge($users, $oncall)
  # Kouzlo. Nedotýkejte se.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles/os/redhat/centos7/sudoers/icinga.erb',
  }

}
Stále pracuji na této kódu a zlepšuji ho, jak jen to jde. Přesně takový kód umožňuje používat jednoduchou a srozumitelnou syntaxi v Hiera:
Údaje
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Všechny kontroly jsou rozděleny do skupin, každá skupina má výchozí nastavení ohledně toho, kde a jak často tyto kontroly spouštět, jaká oznámení posílat a komu.
U každé kontroly lze přepsat jakoukoli možnost a vše se nakonec spočítá i s výchozími nastaveními všech kontrol jako celku. Proto v config.pp je napsána tato struktura – zde dochází ke sloučení všech výchozích nastavení s nastaveními skupin a poté ještě s každou individuální kontrolou.
Další důležitou změnou byla možnost používat funkce v nastaveních, například funkci pro změnu portu, adresy a URL pro kontrolu http_regex.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
To znamená— pokud je v definici hosta proměnná http_port — použít ji, jinak 443. Například, webové rozhraní jabber běží na 9090, zatímco Unifi běží na 7443.
http_vhost znamená ignorovat DNS a vzít tuto adresu.
Pokud je v hostu uveden uri— jít podle něj, jinak vzít "\/".
S http_ssl vznikl vtipný problém— tato funkce se nechtěla vypnout na požádání. Dlouho jsem se trápil s tímto řádkem, dokud mi nedošlo, že v proměnné v definici hosta:
http_ssl: falseVkládá se do výrazu
if(host.vars.http_ssl) { return false } else { return true }jak false a nakonec to vychází
if(false) { return false } else { return true }tedy kontrola ssl je vždy aktivní. Vyřešilo se to změnou syntaxe:
http_ssl: noZávěry:
Plusy:
- Teď máme jeden monitorovací systém, ne dva, jak tomu bylo posledních 7-8 měsíců, nebo jeden zastaralý a zranitelný.
- Struktura dat hostitelů/služeb (kontrol) je teď (podle mého názoru) mnohem čitelnější a srozumitelnější. Pro ostatní to nebylo tak zřejmé, takže jsem musel vytvořit pár stránek v místní wiki, abych objasnil, jak to všechno funguje a co kde upravit.
- Existuje možnost flexibilního nastavení kontrol pomocí proměnných a funkcí, například pro kontrolu http_regexp lze vzor, kód návratu, url a port nastavit v nastavení hostitele.
- Existuje několik panelů (dashboards), pro každý z nichž lze určit vlastní seznam zobrazovaných upozornění a spravovat to vše přes Puppet a merge requesty.
Nevýhody:
- Inertnost členů týmu — Nagios pracoval, pracoval a pracoval, a tahle tvoje Icinga neustále laguje a zamrzá. A jak tu mám vidět historii? Ach, sakra, ta se přece neaktualizuje… (Skutečný problém — historie upozornění se automaticky neaktualizuje, jen na F5)
- Inertnost systému — když kliknu v webovém rozhraní na „aktualizovat“ (check now) — výsledek provedení závisí na počasí na Marsu, obzvlášť u složitých služeb, které vyžadují desítky sekund na provedení. Takový výsledek je normální věc.

- Celkově podle půlroční statistiky fungování obou systémů vedle sebe Nagios vždy reagoval rychleji než Icinga a to mě velmi rozčilovalo. Domnívám se, že tam něco pokazili s časovači a kontrola každých pět minut se de facto provádí jednou za 5:30 nebo tak něco.
- Pokud restartuji službu v jakémkoli okamžiku (systemctl restart icinga2) — všechny kontroly, které byly v té době v procesu, dají kritické upozornění <terminated by signal 15> na obrazovku a zprvu to vypadá, jako by všechno spadlo ().
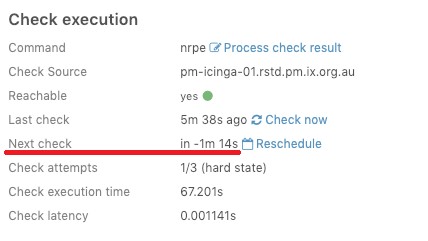
Ale celkově — funguje to.
Zdroj: habr.com
