

Takže shromažďujete metriky. Stejně jako my. My také shromažďujeme metriky. Samozřejmě, že ty potřebné pro podnikání. Dnes vám povíme o prvním článku v systému našeho monitorování — serveru pro agregaci kompatibilním se statsd. , proč jsme jej napsali a proč jsme se vzdali brubecku.
Z našich předchozích článků (, ) se můžete dozvědět, že do určité doby jsme značky shromažďovali pomocí . Je napsán v C. Z pohledu kódu — jednoduchý jako zátka (to je důležité, když chcete přispět) a, což je nejdůležitější, zvládá naše objemy 2 miliony metrik za sekundu (MPS) v maximální zátěži bez větších problémů. Dokumentace uvádí podporu 4 miliony MPS s hvězdičkou. To znamená, že uvedený údaj dosáhnete, pokud správně nastavíte síť na Linuxu. (Kolik MPS lze dosáhnout, pokud síť necháte tak jak je, nevíme). Navzdory těmto výhodám jsme měli k brubecku několik vážných výhrad.
Výhrada 1. Github — vývojář projektu — přestal jej podporovat: publikovat opravy a záplaty, přijímat naše a (nejen naše) PR. V posledních několika měsících (někdy od února-března 2018) se aktivita obnovila, ale předtím byla téměř 2 roky úplného ticha. Kromě toho je projekt vyvíjen , což může představovat vážnou překážku pro zavádění nových funkcí.
Výhrada 2. Přesnost výpočtů. Brubeck shromažďuje pro agregaci pouze 65536 hodnot. V našem případě může během agregačního období (30 s) přicházet mnohem více hodnot (1 527 392 v maximálním zatížení). V důsledku tohoto vzorkování hodnoty maxim a minimů vypadají naprosto bezcenně. Například takto:
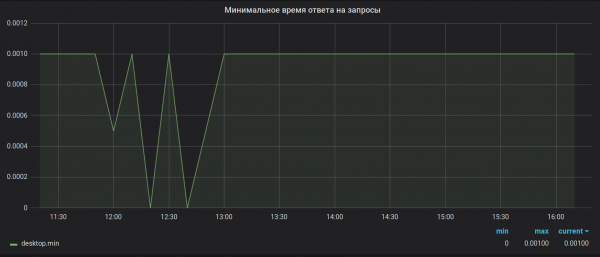
Jak bylo
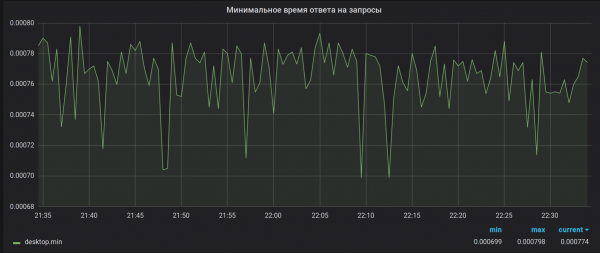
Jak mělo být
Z toho důvodu jsou součty považovány za zcela nepřesné. Přidejte sem chybu s přetečením 32-bitového floatu, která server zcela posílá do segfaultu při přijímání na pohled nevinné metriky, a je to dokonalé. Chyba, mimochodem, ještě nebyla opravena.
A nakonec, Výhrada X. V době psaní tohoto článku jsme připraveni ukázat ji všem 14 víceméně fungujícím implementacím statsd, které se nám podařilo najít. Představme si, že nějaká konkrétní infrastruktura vyrostla natolik, že přijímat 4 miliony MPS už nestačí. Nebo možná ještě nevyrostla, ale metriky jsou pro vás už natolik důležité, že i krátké, 2-3 minutové výpadky na grafech mohou být kritické a vyvolat neodolatelné deprese u manažerů. Protože léčení deprese je vděčné, potřebujeme technická řešení.
Za prvé, odolnost vůči chybám, aby náhlý problém na serveru nezpůsobil v kanceláři psychiatrický zombie apokalypsu. Za druhé, škálovatelnost, abychom měli možnost přijímat více než 4 miliony MPS, aniž bychom museli kopat do jádra síťového stacku Linux a klidně růst „do šířky“ na požadované rozměry.
Jelikož jsme měli rezervy pro škálování, rozhodli jsme se začít s odolností vůči chybám. „Oh! Odolnost vůči chybám! To je snadné, to umíme,“ pomysleli jsme si a spustili 2 servery, přičemž na každém jsme zprovoznili kopii brubeck. K tomu jsme museli zkopírovat provoz s metrikami na oba servery a dokonce jsme napsali pro to . Tento problém odolnosti vůči chybám jsme tím vyřešili, ale… ne příliš dobře. Zpočátku to vypadalo docela dobře: každý brubeck sbírá svůj variant agregace, zapisuje data do Graphite každých 30 sekund, přičemž přepisuje starý interval (to se děje na straně Graphite). Pokud jeden server selže, vždy máme druhý s vlastní kopií agregovaných dat. Ale je tu problém: pokud server selže, na grafech vzniká „pila“. To souvisí s tím, že 30sekundové intervaly u brubeck nejsou synchronizovány, a v okamžiku selhání se jeden z nich nepřepisuje. V okamžiku spuštění druhého serveru se děje to samé. Je to vcelku snesitelné, ale chtěli bysme něco lepšího! Problém škálovatelnosti také nezmizel. Všechny metriky stále „letí“ na jediný server, a proto jsme omezeni těmi samými 2-4 miliony MPS v závislosti na síťovém výkonu.
Pokud se na problém zamyslíme a zároveň budeme hrabat lopatou ve sněhu, může nás napadnout jasná myšlenka: potřebujeme statsd, který umí fungovat v distribuovaném režimu. To znamená, že by měla být implementována synchronizace mezi uzly podle času a metrik. „Samozřejmě, takové řešení už jistě existuje,“ řekli jsme a šli to googlit... A nic jsme nenašli. Po prozkoumání dokumentace k různým statsd ( k datu 11.12.2017), jsme nenalezli naprosto nic. Zřejmě se s takovým množstvím metrik dosud nesetkali ani vývojáři, ani uživatelé těchto řešení, jinak by určitě něco vymysleli.
A tady jsme si vzpomněli na „hračkový“ statsd — bioyino, který jsme vyvinuli na hackathonu jen tak pro zábavu (název projektu vygeneroval skript před začátkem hackathonu) a uvědomili si, že naléhavě potřebujeme vlastní statsd. Proč?
- protože na světě je příliš málo klonů statsd,
- protože můžeme zajistit požadovanou nebo blízkou požadované odolnost proti selhání a škálovatelnost (včetně synchronizace agregovaných metrik mezi servery a vyřešení problémů s konflikty při odesílání),
- protože můžeme měřit metriky přesněji, než to dělá brubeck,
- protože si můžeme samostatně sbírat podrobnější statistiky, které nám brubeck prakticky neposkytoval,
- protože se nám naskytla příležitost naprogramovat naši vlastní hypervýkonnostní distribuovanou aplikaci, která nebude zcela kopírovat architekturu jiné takové hypervýkonnostní… nůvyponeli.
Na čem psát? Pochopitelně na Rust. Proč?
- protože už existoval prototyp řešení,
- protože autor článku v té době už znal Rust a chtěl na něm napsat něco pro produkční prostředí s možností to zveřejnit jako open-source,
- protože jazyky s GC nám nevyhovují díky povaze přijímaného provozu (prakticky realtime) a pauzy GC jsou prakticky nepřijatelné,
- protože potřebujeme maximální výkon srovnatelný s C,
- protože Rust nám poskytuje bezstarostnou souběžnost, a začneme-li to psát v C/C++, nabrali bychom ještě víc zranitelností, přetečení bufferů, race conditions a dalších hrozných slov.
Existoval také argument proti Rustu. Společnost neměla žádné zkušenosti s tvorbou projektů v Rustu a nyní také neplánujeme jeho použití v hlavním projektu. Proto byly vážné obavy, že se nám nic nepodaří, ale rozhodli jsme se risknout a zkusili jsme to.
Čas plynul...
Konečně, po několika neúspěšných pokusech byla připravena první funkční verze. Co se stalo? Vypadalo to takto.
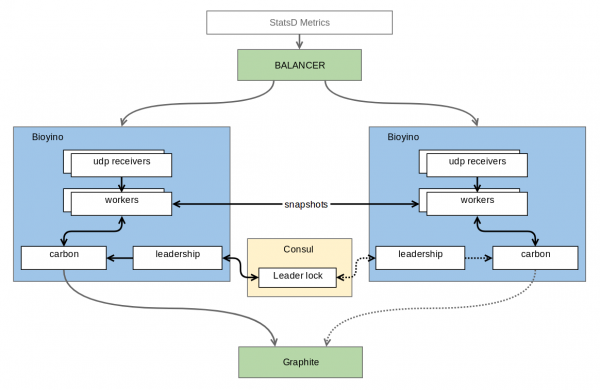
Každý uzel přijímá svůj vlastní soubor metrik a ukládá je u sebe, přičemž neagreguje metriky pro ty typy, kde je pro konečnou agregaci potřebný jejich plný soubor. Uzel jsou mezi sebou spojeny určitým protokolem distribuované zámky (distributed lock), který umožňuje vybrat z nich ten jeden (tady jsme plakali), který je hoden odesílat metriky Velkému. V tuto chvíli je tento problém vyřešen prostředky , ale v budoucnu se autorovy ambice rozprostírají k Raft, kde ten jediný hoden bude, samozřejmě, uzel-lídr konsensu. Kromě konsensu uzly dost často (ve výchozím nastavení jednou za sekundu) odesílají svým sousedům ty části předagregovaných metrik, které se jim podařilo za tuto sekundu shromáždit. Výsledkem je, že škálovatelnost a odolnost proti poruchám zůstávají zachovány — každý z uzlů si stále uchovává úplný soubor metrik, ale metriky jsou nyní odesílány již agregovaně, přes TCP a s kódováním v binárním protokolu, což znamená, že náklady na duplicitu v porovnání s UDP se výrazně snižují. I přes poměrně velké množství příchozích metrik si akumulace žádá jen velmi málo paměti a ještě méně CPU. Pro naše dobře komprimovatelné metriky to jsou pouhé desítky megabajtů dat. Dalším bonusem je absence zbytečných přepisů dat v Graphite, jak tomu bylo v případě burbeck.
UDP pakety s metrikami jsou vyváženy mezi uzly na síťovém zařízení pomocí jednoduchého Round Robin. Samozřejmě, síťové zařízení nerozlišuje obsah paketů, a proto může zpracovávat mnohem více než 4M paketů za sekundu, nemluvě o metrikách, o kterých vůbec nic neví. Vzhledem k tomu, že metriky přicházejí ne po jedné v každém paketu, neočekáváme žádné problémy s výkonem na tomto místě. V případě pádu serveru síťové zařízení rychle (během 1-2 sekund) zjistí tento fakt a odstraní spuštěný server z rotace. V důsledku toho mohou být pasivní (tzn. nejsou-li vedoucí) uzly zapínány a vypínány, aniž by byly na grafech znatelné poklesy. Maximálně ztrácíme část metrik, které přišly za poslední sekundu. Náhlá ztráta/vypnutí/přepnutí lídra stále vykreslí malou anomálii (30sekundový interval je stále nesynchronizován), ale při zachování spojení mezi uzly lze tyto problémy minimalizovat například rozesíláním synchronizačních paketů.
Něco o vnitřní struktuře. Aplikace je samozřejmě vícerozměrná, ale architektura vláken se liší od té, která byla použita v brubeck. Vláken v brubeck je stejných — každé z nich odpovídá zároveň za sběr informací, tak i za agregaci. Ve bioyino jsou pracovní vlákna (workers) rozdělena do dvou skupin: odpovědné za síť a odpovědné za agregaci. Toto rozdělení umožňuje flexibilnější řízení aplikace v závislosti na typu metrik: tam, kde je potřebná intenzivní agregace, lze přidat agregátory, tam, kde je vysoký síťový provoz — zvýšit počet síťových vláken. V současné době na našich serverech pracujeme se 8 síťovými a 4 agregujícími vlákny.
Agregační část je dost nudná. Naplněné síťovými vlákny buffery se rozdělují mezi agregující vlákna, kde jsou dále parsovány a agregovány. Na požádání jsou metriky odesílány na jiné uzly. To vše, včetně přenosu dat mezi uzly a práce s Consul, se provádí asynchronně na rámci .
Mnohem více problémů při vývoji způsobila síťová část zodpovědná za příjem metrik. Hlavním cílem oddělení síťových toků do samostatných entit bylo snížit čas, který tok stráví ne při čtení dat ze socketu. Varianta s použitím asynchronního UDP a běžného recvmsg brzy odpadla: první spotřebovává příliš mnoho CPU v uživatelském prostoru na zpracování událostí, druhý — příliš mnoho přepínání kontextu. Proto se nyní používá s velkými buffery (a buffery, pánové důstojníci, to není jen tak!). Podpora běžného UDP byla ponechána pro nenáročné případy, kdy není potřeba recvmmsg. V režimu multimessage se daří dosáhnout hlavního cíle: drtivá většina času síťový tok zpracovává frontu OS — čte data ze socketu a přesouvá je do bufferu uživatelského prostoru, jen občas přepíná, aby odevzdal naplněný buffer agregátorům. Fronta v socketu se prakticky nenakupí, počet odmítnutých paketů téměř neroste.
Poznámka
V nastavení je výchozí velikost bufferu nastavena na poměrně velkou. Pokud se náhodou rozhodnete vyzkoušet server samostatně, možná se setkáte s tím, že po odeslání malého množství metrik nedorazí do Graphite, zůstávají v bufferu síťového toku. Pro práci s malým množstvím metrik je potřeba v konfiguraci nastavit bufsize a task-queue-size na menší hodnoty.
Nakonec — několik grafů pro milovníky grafů.
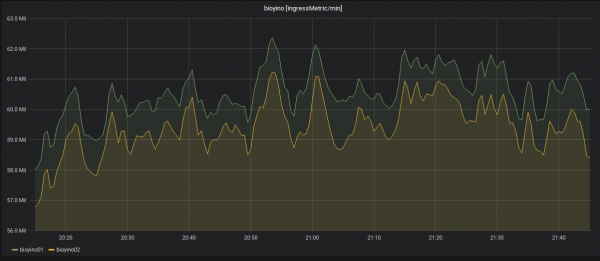
Statistika počtu příchozích metrik na každý server: více než 2 miliony MPS.
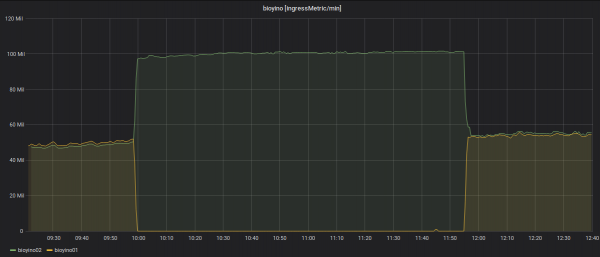
Vypnutí jednoho z uzlů a přerozdělení příchozích metrik.
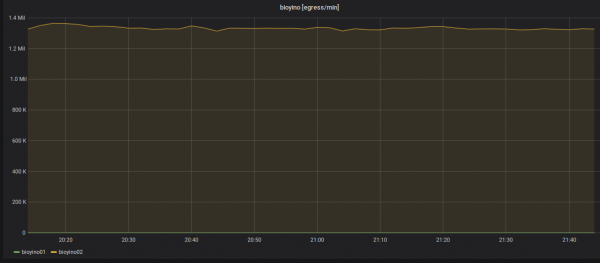
Statistika o odchozích metrikách: odesílá vždy pouze jeden uzel — raidboss.
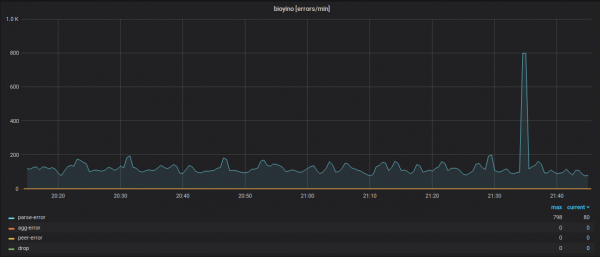
Statistika fungování každého uzlu s ohledem na chyby v různých modulech systému.
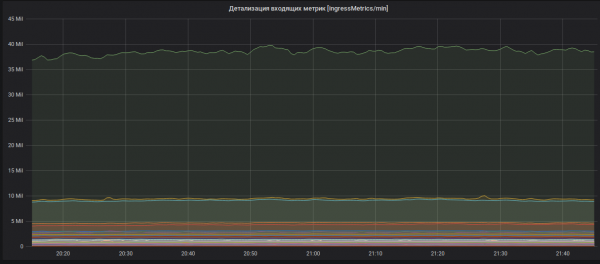
Detailizace příchozích metrik (názvy metrik jsou skryty).
Co plánujeme s tím vším dělat dál? Samozřejmě psát kód, bl…! Projekt byl od počátku plánován jako open-source a zůstane tak po celou svou existenci. V blízkých plánech — přechod na vlastní verzi Raft, změna peer-protokolu na přenosnější, zavedení dodatečné vnitřní statistiky, nové typy metrik, opravy chyb a další vylepšení.
Samozřejmě vítáme všechny, kteří chtějí pomoci s rozvojem projektu: vytvářejte PR, Issues, budeme se snažit odpovídat a vylepšovat, apod.
Na tomto, jak se říká, to je vše, kupujte naše slony!
Zdroj: habr.com
