

Narazil jsem na zajímavý materiál o umělé inteligenci ve hrách. Obsahuje vysvětlení základních pojmů o AI na jednoduchých příkladech a také mnoho užitečných nástrojů a metod pro pohodlný vývoj a návrh. Jak, kde a kdy je používat — to také najdete.
Většina příkladů je napsána v pseudokódu, takže hluboké znalosti programování nejsou nutné. Pod perexem je 35 stránek textu s obrázky a gifkami, tak se připravte.
UPD. Omlouvám se, ale svůj vlastní překlad tohoto článku jsem už dělal na Habru . Jeho verzi si můžete přečíst , ale z nějakého důvodu mi článek unikl (používal jsem vyhledávání, ale něco nevyšlo). A jelikož píšu blog věnovaný hernímu vývoji, rozhodl jsem se ponechat svůj překlad pro své čtenáře (některé body mám zpracovány jinak, některé — úmyslně vynechány na doporučení vývojářů).
Co je AI?
Herní AI se soustředí na to, jaké akce by měl objekt vykonávat na základě podmínek, ve kterých se nachází. Obvykle se tomu říká řízení „inteligentních agentů“, kde agentem je herní postava, vozidlo, bot, a někdy i něco abstraktnějšího: celá skupina entit nebo dokonce civilizace. V každém případě je to něco, co musí vidět své okolí, vyhodnocovat na jeho základě rozhodnutí a jednat v souladu s nimi. To se nazývá cyklus Sense/Think/Act (Vnímat/Přemýšlet/Jednat):
- Sense: agent nalezne nebo obdrží informace o věcech ve svém prostředí, které mohou ovlivnit jeho chování (blízké hrozby, předměty k sebrání, zajímavá místa k prozkoumání).
- Think: agent se rozhoduje, jak reagovat (zvažuje, zda je dostatečně bezpečné sbírat předměty, nebo zda se nejprve musí bránit/schovávat).
- Act: agent vykonává akce produktem předchozího rozhodnutí (začne se pohybovat k protivníkovi nebo předmětu).
- …nyní se situace změnila v důsledku akcí postav, takže se cyklus opakuje s novými údaji.
AI se obvykle zaměřuje na část cyklu Sense. Například autonomní automobily pořizují snímky silnice, kombinují je s radarovými a lidarovými daty a interpretují je. Obvykle to dělá strojové učení, které zpracovává přicházející data a dává jim smysl tím, že extrahuje sémantické informace, jako například: „před vámi je ještě jedno auto ve vzdálenosti 20 yardů“. To jsou tzv. classification problems.
Hry nepotřebují složitý systém pro extrakci informací, protože většina dat je již nedílnou součástí. Není potřeba spouštět algoritmy pro rozpoznávání obrazů, aby se zjistilo, zda je před hráčem nepřítel — hra to již ví a poskytuje informace přímo během rozhodovacího procesu. Proto je část cyklu Sense často mnohem jednodušší než Think a Act.
Omezení herního AI
AI má řadu omezení, která je třeba dodržovat:
- AI není potřeba předem trénovat, jako by to byl algoritmus strojového učení. Je bezpředmětné psát neuronovou síť během vývoje, aby bylo možné sledovat desítky tisíc hráčů a studovat, jak nejlépe hrát proti nim. Proč? Protože hra nebyla vydána a hráči neexistují.
- Hra musí bavit a klást výzvy, takže agenti by neměli nacházet nejlepší přístup proti lidem.
- Agenti musí vypadat realisticky, aby hráči cítili, že hrají proti skutečným lidem. Program AlphaGo překonal člověka, ale zvolené tahy byly výrazně daleko od tradičního chápání hry. Pokud hra imituje lidského protivníka, tento pocit by neměl existovat. Algoritmus musí být upraven tak, aby přijal věrohodná rozhodnutí, a ne dokonalá.
- AI musí fungovat v reálném čase. To znamená, že algoritmus nemůže monopolizovat využití procesoru po dlouhou dobu pro rozhodování. I 10 milisekund je příliš dlouho, protože většině her stačí mezi 16 a 33 milisekund, aby provedly veškeré zpracování a přešly na další snímek grafiky.
- Ideální je, pokud alespoň část systému je řízena daty, aby ‚nekodéři‘ mohli provádět změny, a aby úpravy probíhaly rychleji.
Podívejme se na přístupy AI, které pokrývají celý cyklus Sense/Think/Act.
Přijetí základních rozhodnutí
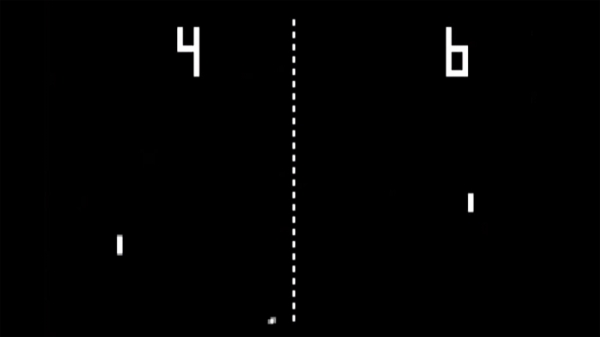
Začněme s nejjednodušší hrou — Pong. Cíl: posunout platformu (paddle) tak, aby se míč odrážel od ní, a neproletěl kolem. Je to jako tenis, kde prohráváte, pokud míč neodrazíte. Pro AI je zde relativně snadný úkol — rozhodnout, kterým směrem posunout platformu.
Podmínkové operátory
Pro AI v Pongu existuje nejviditelnější řešení — vždy se snažit umístit platformu pod míčem.
Jednoduchý algoritmus pro to, napsaný v pseudokódu:
každý snímek/aktualizace, zatímco hra běží:
pokud je míč vlevo od platformy:
posunout platformu vlevo
jinak pokud je míč vpravo od platformy:
posunout platformu vpravo
Pokud se platforma pohybuje rychlostí míče, je to ideální algoritmus pro AI v Pongu. Není třeba nic komplikovat, pokud není tolik dat a možných akcí pro agenta.
Tento přístup je natolik jednoduchý, že celý cyklus Sense/Think/Act je téměř neviditelný. Ale existuje:
- Část Sense je ve dvou podmínkových operátorech if. Hra ví, kde je míč a kde je platforma, takže AI se na ni obrací pro tuto informaci.
- Část Think také zahrnuje dva podmínkové operátory if. Ty představují dvě rozhodnutí, která jsou v tomto případě vzájemně se vylučující. V důsledku toho se vybere jedna ze tří akcí — posunout platformu vlevo, posunout ji vpravo, nebo nic neudělat, pokud je už správně umístěna.
- Část Act se nachází v operátorech Move Paddle Left a Move Paddle Right. V závislosti na designu hry mohou tyto operátory posunout platformu okamžitě nebo s určitou rychlostí.
Takové přístupy se nazývají reaktivní — existuje jednoduchá sada pravidel (v tomto případě podmínkové operátory if v kódu), které reagují na aktuální stav světa a jednají.
Rozhodovací strom
Příklad se hrou Pong vlastně odpovídá formální konceptu AI, zvanému rozhodovací strom. Algoritmus jím prochází, aby dosáhl 'listu' — rozhodnutí, jakou akci podniknout.
Vytvoříme blokové schéma rozhodovacího stromu pro algoritmus naší platformy:
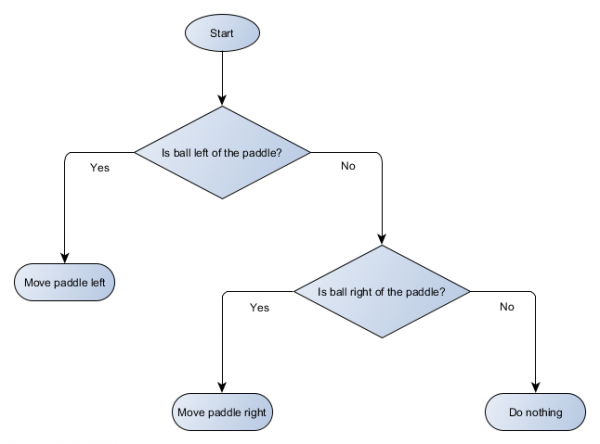
Každá část stromu se nazývá uzel (node) — AI používá teorii grafů k popisu takových struktur. Existují dva typy uzlů:
- Uzly rozhodování: výběr mezi dvěma alternativami na základě kontroly určité podmínky, kde každá alternativa je představena jako samostatný uzel.
- Koncové uzly: akce k provedení, představují konečné rozhodnutí.
Algoritmus začíná u prvního uzlu („kořene“ stromu). Buď se rozhodne, do kterého poduzlu přejít, nebo provede akci uloženou v uzlu a končí.
Jaký je tedy přínos, když strom rozhodnutí vykonává stejnou práci jako if-ces na předchozí stránce? Existuje zde obecný systém, kde každé rozhodnutí má pouze jednu podmínku a dva možné výsledky. To umožňuje vývojáři vytvářet AI z údajů představujících rozhodnutí ve stromu, a tím se vyhnout jeho hardcodování. Představme si to formou tabulky:
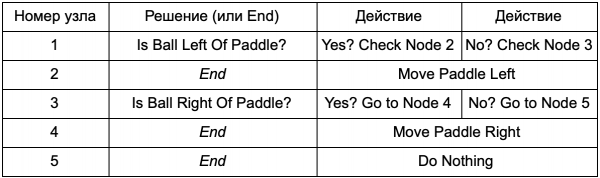
Na straně kódu dostanete systém pro čtení řetězců. Vytvořte uzel pro každý z nich, připojte rozhodovací logiku na základě druhého sloupce a poduzly na základě třetího a čtvrtého sloupce. Stále budete muset naprogramovat podmínky a akce, ale nyní bude struktura hry složitější. Přidáváte dodatečná rozhodnutí a akce, a poté můžete nastavit celé AI jednoduše změnou textového souboru s definicí stromu. Poté předáte soubor hernímu designérovi, který bude mít možnost měnit chování bez přeprogramování hry a změny kódu.
Stromy rozhodnutí jsou velmi užitečné, když jsou automaticky vytvářeny na základě velkého množství příkladů (např. pomocí algoritmu ID3). To je činí efektivním a vysoce výkonným nástrojem pro klasifikaci situací na základě získaných dat. Nicméně překračujeme rámec jednoduchého systému pro vybírání akcí agenty.
Scénáře
Probrali jsme systém stromu rozhodnutí, který využíval předem vytvořené podmínky a akce. Člověk, který navrhuje AI, může uspořádat strom podle svého uvážení, ale stále se musí spoléhat na programátora, který to celé naprogramoval. Co kdybychom mohli poskytnout designérovi nástroje pro vytváření vlastních podmínek nebo akcí?
Aby programátor nemusel psát kód pro podmínky Is Ball Left Of Paddle a Is Ball Right Of Paddle, může vytvořit systém, ve kterém designér zapíše podmínky pro kontrolu těchto hodnot. Pak budou data stromu rozhodnutí vypadat takto:
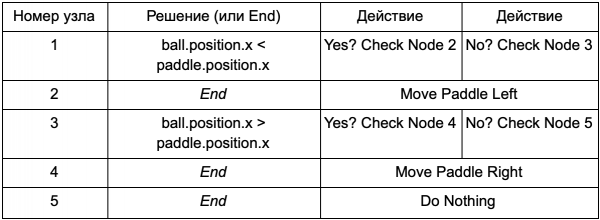
V podstatě se jedná o to samé, co v první tabulce, ale řešení uvnitř mají svůj vlastní kód, který je poněkud podobný podmínkové části příkazu if. Na straně kódu by to bylo přečteno ve druhém sloupci pro uzly rozhodovacího procesu, ale místo hledání konkrétní podmínky k vykonání (Je míč vlevo od pálky) vyhodnocuje podmínkový výraz a vrací true nebo false podle potřeby. To se provádí pomocí skriptovacího jazyka Lua nebo Angelscript. S jejich pomocí může vývojář přijímat objekty ve své hře (míč a pálku) a vytvářet proměnné, které budou dostupné ve skriptu (ball.position). Navíc je skriptovací jazyk jednodušší než C++. Nevyžaduje plnou kompilaci, takže je ideální pro rychlé úpravy herní logiky a umožňuje „nekodérům“ vytvářet potřebné funkce samostatně.
Ve zmíněném příkladu se skriptovací jazyk používá pouze k vyhodnocení podmínkového výrazu, ale může se také použít k akcím. Například příkaz Move Paddle Right může být skriptovací příkaz (ball.position.x += 10). Takže akce může být také definována ve skriptu, aniž by bylo nutné programovat Move Paddle Right.
Je možné zajít ještě dál a napsat celé rozhodovací strom na skriptovacím jazyce. Bude to kód ve formě pevně naprogramovaných (hardcoded) podmínkových příkazů, ale ty budou umístěny v externích skriptovacích souborech, což znamená, že mohou být měněny bez nutnosti kompilace celé aplikace. Často je možné změnit skriptovací soubor přímo během hry, abyste rychle testovali různé reakce AI.
Reagování na události
Příklady výše se skvěle hodí pro Pong. Nepřetržitě spouštějí cyklus Sense/Think/Act a jednají na základě posledního stavu světa. Ale ve složitějších hrách je třeba reagovat na jednotlivé události, nikoli vyhodnocovat vše najednou. Pong už v tomhle případě není nejlepší příklad. Zvolme jiný.
Představte si střílečku, kde jsou nepřátelé nehybní, dokud neodhalí hráče, poté jednají v závislosti na své „specializaci“: někteří budou „rushovat“, jiní budou útočit z dálky. To je stále základní reagující systém — „pokud je hráč spatřen, udělejte něco“ — ale lze jej logicky rozdělit na událost Player Seen (hráč spatřen) a reakci (vyberte odpověď a vykonejte ji).
Tohle nás vrací k cyklu Sense/Think/Act. Můžeme naprogramovat část Sense, která v každém snímku zkontroluje, zda AI vidí hráče. Pokud ne, neděje se nic, ale pokud ano, vytvoří se událost Player Seen. Kód bude mít samostatnou sekci, která říká: „když dojde k události Player Seen, udělej“, kde je reakce, kterou potřebujete pro volání částí Think a Act. Tímto způsobem nakonfigurujete reakce na událost Player Seen: na „rushující“ postavu – ChargeAndAttack, a na snipera – HideAndSnipe. Tyto vazby lze vytvořit v datovém souboru pro rychlé úpravy bez nutnosti opětovně kompilovat. A zde lze také použít skriptovací jazyk.
Přijímání složitých rozhodnutí
I když jednoduché reakční systémy jsou velmi účinné, existuje mnoho situací, kdy nestačí. Někdy je třeba přijímat různá rozhodnutí založená na tom, co agent dělá v daném okamžiku, ale představit to jako podmínku je obtížné. Někdy existuje příliš mnoho podmínek na efektivní vyjádření v rozhodovacím stromu nebo skriptu. Někdy je třeba dopředu posoudit, jak se situace změní, než učiníte rozhodnutí o dalším kroku. K vyřešení těchto problémů jsou potřeba složitější přístupy.
Konečný automat (Finite State Machine)
Konečný automat neboli FSM (Finite State Machine) je způsob, jak říci, že náš agent se v současnosti nachází v jednom z několika možných stavů, a že se může přepínat z jednoho stavu do druhého. Takových stavů je určité množství – odtud název. Nejlepší příklad z reality je semafor. Na různých místech jsou různé sekvence světel, ale princip je stejný – každý stav představuje něco (stůj, jdi, atd.). Semafor se nachází pouze v jednom stavu v každém okamžiku a přechází z jednoho stavu do druhého na základě jednoduchých pravidel.
S NPC ve hrách je to podobný příběh. Pro příklad vezměme strážného s následujícími stavy:
- Patrolling (Pohybující se).
- Attacking (Útočící).
- Fleeing (Utíkající).
A s těmito podmínkami pro změnu jeho stavu:
- Pokud strážný vidí protivníka, zaútočí.
- Pokud strážný útočí, ale už nevidí protivníka, vrátí se k patrolování.
- Pokud strážný útočí, ale je vážně zraněn, utíká.
Lze také psát if-odesílací bloky se stavovou proměnnou strážce a různé kontroly: je v blízkosti nepřítel, jaká je úroveň zdraví NPC atd. Přidáme několik dalších stavů:
- Nečinnost (Idling) — mezi hlídkami.
- Hledání (Searching) — když se zjistí nepřítel, který se skryl.
- Žádat o pomoc (Finding Help) — když je nepřítel zaznamenán, ale je příliš silný na to, aby s ním bylo možné bojovat osamoceně.
Možnost pro každého z nich je omezená — například strážce se nevydá hledat skrytého nepřítele, pokud má nízké zdraví.
Nakonec může být obrovský seznam 'pokud' <x и y, но не z>, pak <p>, příliš rozsáhlý, a proto by mělo být zformulováno řešení, které nám umožní mít na paměti stavy a přechody mezi nimi. Abyste toho dosáhli, zvážíme všechny stavy a pod každým stavem zapíšeme do seznamu všechny přechody do jiných stavů spolu se potřebnými podmínkami.
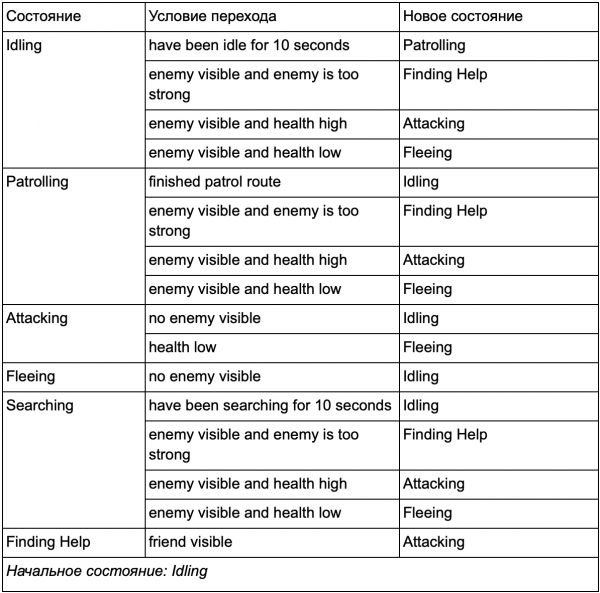
Toto je tabulka přechodů stavů — komplexní způsob představování FSM. Nakreslíme diagram a získáme úplný přehled o tom, jak se mění chování NPC.
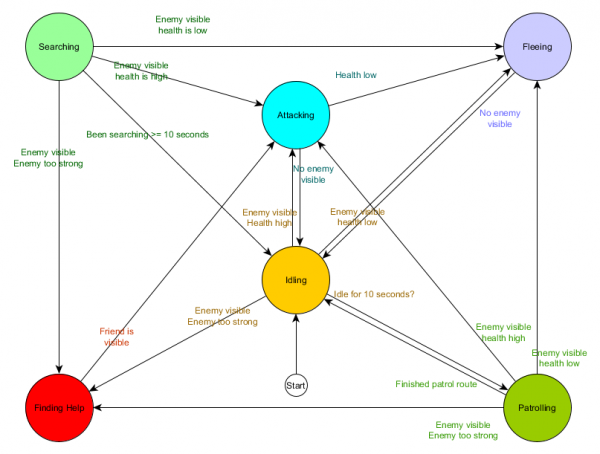
Diagram odráží podstatu rozhodování tohoto agenta na základě aktuální situace. Každá šipka ukazuje přechod mezi stavy, pokud je podmínka vedle ní pravdivá.
Při každé aktualizaci kontrolujeme aktuální stav agenta, procházíme seznam přechodů a pokud jsou splněny podmínky pro přechod, přejme do nového stavu. Například, při každém snímku se kontroluje, jestli vypršel 10 sekundový časovač, a pokud ano, strážce přechází ze stavu Nečinnosti (Idling) do stavu Hlídání (Patrolling). Stejným způsobem, stav Útočení (Attacking) kontroluje zdraví agenta — pokud je nízké, přechází do stavu Útěku (Fleeing).
Toto je zpracování přechodů mezi stavy, ale co chování spojené s těmito stavy? Pokud jde o realizaci skutečného chování pro konkrétní stav, obvykle existují dva typy „háčku“, kde přiřazujeme akce k FSM:
- Akce, které periodicky vykonáváme pro aktuální stav.
- Akce, které podnikáme při přechodu z jednoho stavu do druhého.
Příklady pro první typ. Stav Hlídání (Patrolling) každým snímkem posune agenta po trase hlídání. Stav Útočení (Attacking) každým snímkem se pokusí zahájit útok nebo přejít do stavu, když je to možné.
Pro druhý typ zvažujeme přechod „pokud je nepřítel viditelný a nepřítel je příliš silný, pak přejít do stavu Hledání Pomoci. Agent musí vybrat, kam jít pro pomoc, a uchovat tuto informaci, aby stav Hledání Pomoci věděl, kam se obrátit. Jakmile je pomoc nalezena, agent se vrátí zpět do stavu Útoku. V tomto okamžiku chce informovat spojence o hrozbě, a proto může vzniknout akce InformovatSpojenceOHrozbě.
Opět můžeme na tento systém nahlížet skrze cyklus Vnímat/Přemýšlet/Jednat. Vnímat je materializováno v datech používaných logikou přechodu. Přemýšlet — to jsou přechody dostupné v každém stavu. A Jednat se provádí akcemi, které se periodicky vykonávají uvnitř stavu nebo na přechodech mezi stavy.
Někdy může být kontinuální dotazování podmínek přechodu nákladné. Například, pokud každý agent provádí složité výpočty každý snímek, aby určil, zda vidí nepřátele a zda je možné přejít ze stavu Hlídání do Útoku — to zabere spoustu procesorového času.
Důležité změny ve stavu světa lze považovat za události, které budou zpracovány, jakmile nastanou. Místo toho, aby FSM kontrolovala podmínku přechodu „může můj agent vidět hráče?“ každý snímek, lze nastavit samostatný systém, který provádí kontroly méně často (například 5krát za sekundu). A výsledkem je vyhlášení Hráč Viděn, když kontrola projde.
To se předává do FSM, která nyní musí přejít na podmínku Přijata událost Hráč Viděn a odpovídajícím způsobem reagovat. Konečné chování je stejné s výjimkou téměř nepostřehnutelného zpoždění před odpovědí. Na oplátku se výkon zlepšil oddělením části Vnímat do samostatné části programu.
Hierarchická konečná stavová automat
Práce s velkými FSM však není vždy pohodlná. Pokud bychom chtěli rozšířit stav útoku, nahrazením jej samostatnými BlízkýÚtok (melee) a DálkovýÚtok (ranged), budeme muset změnit přechody ze všech ostatních stavů, které vedou do stavu Útoku (současné i budoucí).
Určitě jste si všimli, že v našem příkladu je mnoho duplicitních přechodů. Většina přechodů ve stavu Idling je identická s přechody ve stavu Patrolling. Bylo by dobré se neopakovat, zejména pokud přidáme více podobných stavů. Má smysl seskupit Idling a Patrolling pod společným označením „nebojové“, kde existuje pouze jeden společný soubor přechodů do bojových stavů. Pokud si toto označení představíme jako stav, pak se Idling a Patrolling stanou podstavy. Příklad použití samostatné tabulky přechodů pro nový nebojový podstav:
Hlavní stavy:
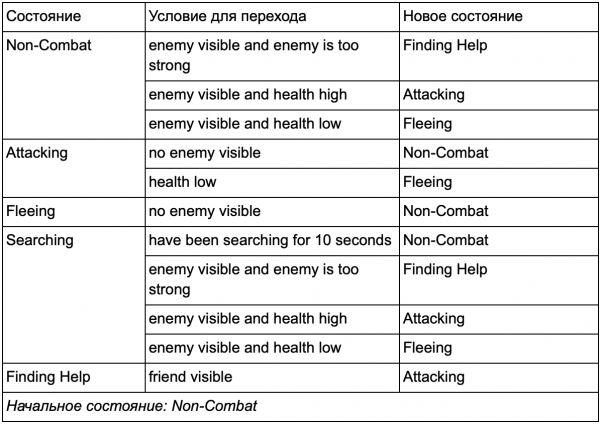
Stav mimo boj:
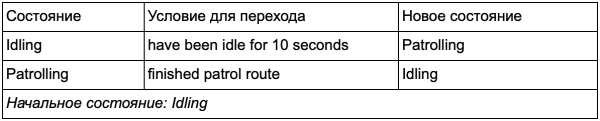
A ve formě diagramu:
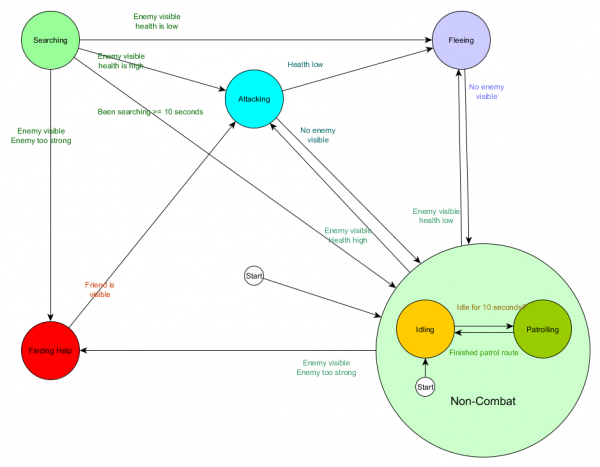
To je stejný systém, ale s novým nebojovým stavem, který zahrnuje Idling a Patrolling. Každý stav obsahující FSM s podstavami (a tyto podstavy, na druhé straně, obsahují vlastní FSM – a tak dále, kolik potřebujete), získáváme Hierarchical Finite State Machine nebo HFSM (hierarchický konečný automat). Seskládáním nebojového stavu jsme odstranili spoustu nadbytečných přechodů. Totéž můžeme udělat pro jakékoli nové stavy se společnými přechody. Například pokud v budoucnu rozšíříme stav Attacking na stavy MeleeAttacking a MissileAttacking, stanou se podstavami, které přecházejí mezi sebou na základě vzdálenosti k nepříteli a dostupnosti munice. Výsledkem jsou složité modely chování a podmodely chování, které lze představit s minimem duplicitních přechodů.
Strom chování
S HFSM se vytvářejí složité kombinace chování jednoduchým způsobem. Nicméně, existuje malá obtížnost, že rozhodování ve formě pravidel přechodu je úzce spojeno s aktuálním stavem. A v mnoha hrách je to přesně to, co je potřeba. Pečlivé využití hierarchie stavů může snížit množství opakování při přechodu. Ale někdy jsou potřeba pravidla, která fungují nezávisle na tom, v jakém stavu se nacházíte, nebo která se aplikují téměř v jakýchkoli stavech. Například, pokud zdraví agenta klesne na 25 %, budete chtít, aby utekl bez ohledu na to, zda byl v boji, nic nedělal nebo mluvil – to budete muset přidávat do každého stavu. A pokud váš designer později chce změnit práh nízkého zdraví z 25 % na 10 %, pak se tím znovu budete muset zabývat.
Ideálně by v této situaci měl být systém, kde jsou rozhodnutí o tom, "v jakém stavu by měl být", mimo samotné stavy, aby bylo možné provádět změny pouze na jednom místě a nedotýkat se podmínek přechodu. Zde přicházejí na scénu stromy chování.
Existuje několik způsobů jejich implementace, ale podstata je pro všechny přibližně stejná a podobá se rozhodovacímu stromu: algoritmus začíná "kořenovým" uzlem a ve stromu se nacházejí uzly představující buď rozhodnutí, nebo akce. Existují však několik klíčových rozdílů:
- Nyní uzly vracejí jednu ze tří hodnot: Succeeded (pokud byla práce dokončena), Failed (pokud nelze zahájit) nebo Running (pokud stále probíhá a není konečný výsledek).
- Už neexistují uzly rozhodnutí pro výběr mezi dvěma alternativami. Místo toho se používají uzly Decorator, které mají jeden podřízený uzel. Pokud uspějí, vykonají svůj jediný podřízený uzel.
- Uzly vykonávající akce vracejí hodnotu Running pro reprezentaci prováděných akcí.
Tento malý soubor uzlů může být kombinován k vytvoření velkého množství složitých modelů chování. Představme si HFSM strážce z předchozího příkladu ve formě chování stromu:
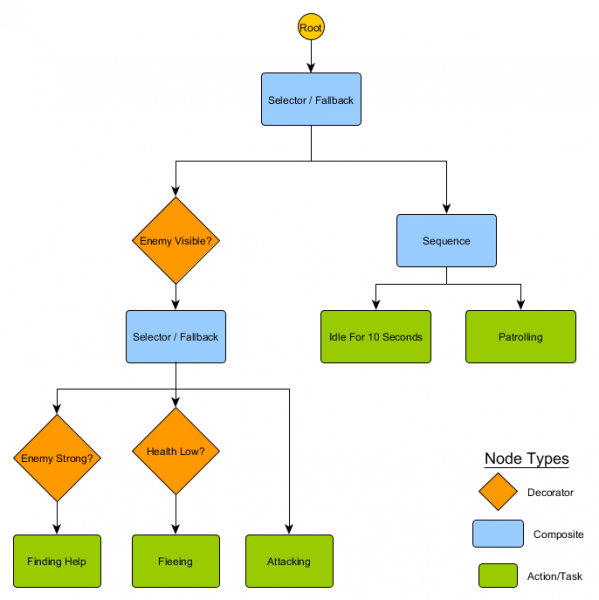
S touto strukturou by neměl existovat přímý přechod mezi stavy Idling/Patrolling a stavem Attacking nebo jakýmikoli jinými. Pokud je nepřítel viditelný a zdraví postavy je nízké, provádění se zastaví na uzlu Fleeing, bez ohledu na to, který uzel dříve vykonával — Patrolling, Idling, Attacking nebo jakýkoli jiný.
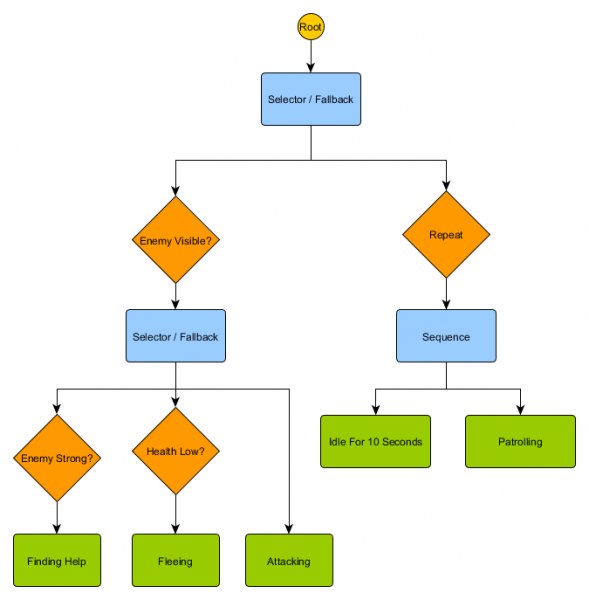
Stromy chování jsou složité — existuje mnoho způsobů, jak je sestavit, a také nalezení správné kombinace dekorátorů a složených uzlů může být problematické. Jsou zde také otázky o tom, jak často kontrolovat strom — chceme projít každou jeho část, nebo pouze tehdy, když se jedno z podmínek změnilo? Jak uchovávat stav vztahující se k uzlům — jak zjistit, kdy jsme byli ve stavu Idling po dobu 10 sekund, nebo jak zjistit, které uzly byly prováděny naposledy, abychom správně zpracovali sekvenci?
Právě proto existuje mnoho implementací. Například v některých systémech byly uzly dekorátoru nahrazeny vestavěnými dekorátory. Ty znovu vyhodnocují strom při změně podmínek dekorátoru, pomáhají připojit uzly a zajišťují periodické aktualizace.
Systém založený na užitečnosti
Některé hry mají mnoho různých mechanik. Je žádoucí, aby měly všechny výhody jednoduchých a obecných pravidel přechodu, ale nemusí se nutně vyjadřovat jako plné chování stromu. Místo toho, abychom měli jasnou sadu výběrů nebo strom možných akcí, je snazší studovat všechny akce a vybrat tu nejvhodnější v daném okamžiku.
Systém založený na užitečnosti právě v tom pomůže. Je to systém, kde má agent k dispozici mnoho akcí a sám si vybírá, kterou vykonat, na základě relativní užitečnosti každé z nich. Kde užitečnost je libovolná míra toho, jak důležité nebo žádoucí je vykonání této akce pro agenta.
Spočítanou užitečnost akce na základě aktuálního stavu a prostředí může agent zkontrolovat a kdykoliv vybrat nejvhodnější další stav. Je to podobné jako FSM, s výjimkou toho, že přechody jsou určeny hodnocením pro každý potenciální stav, včetně aktuálního. Všimněte si, že vybíráme nejvíce užitečnou akci k přechodu (nebo zůstáváme, pokud jsme ji již provedli). Pro větší rozmanitost to může být vážený, ale náhodný výběr z malého seznamu.
Systém přiděluje libovolný rozsah hodnot užitečnosti — například od 0 (zcela nežádoucí) do 100 (zcela žádoucí). Každá akce má řadu parametrů, které ovlivňují výpočet této hodnoty. Návrat k našemu příkladu se strážcem:
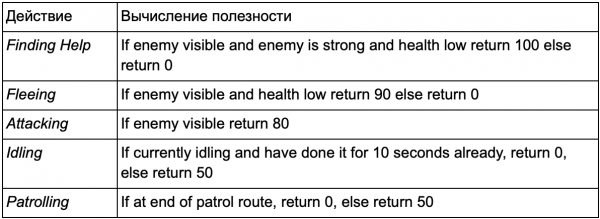
Přechody mezi akcemi nejsou jednoznačné — jakýkoliv stav může následovat jakýkoliv jiný. Priorita akcí se určuje na základě vrácených hodnot užitečnosti. Pokud je nepřítel viditelný a je silný, zatímco zdraví postavy je nízké, pak jak Fleeing, tak FindingHelp vrátí vysoké nenulové hodnoty. Avšak FindingHelp bude vždy vyšší. Podobně, nebojové akce nikdy nevrací více než 50, a tak budou vždy nižší než bojové. Je třeba to zohlednit při vytváření akcí a výpočtu jejich užitečnosti.
V našem příkladu akce vracejí buď fixní hodnotu, nebo jednu ze dvou pevných hodnot. Realističtější systém by předpokládal návrat hodnoty z kontinuálního rozmezí hodnot. Například akce Útěk vrací vyšší hodnoty užitečnosti, pokud je zdraví agenta nízké, zatímco akce Útok vrací nižší hodnoty, když je nepřítel příliš silný. Z tohoto důvodu má akce Útěk v jakékoli situaci, kdy agent cítí, že nemá dost zdraví na vítězství nad protivníkem, přednost před Útokem. To umožňuje měnit priority akcí na základě různých kritérií, což činí tento přístup flexibilnějším a variabilnějším než strom chování nebo FSM.
Každá akce má mnoho podmínek pro výpočet programu. Ty lze napsat ve skriptovacím jazyce nebo ve formě série matematických vzorců. V The Sims, které modeluje každodenní život postavy, se přidává další úroveň výpočtů — agent dostává řadu „motivací“, které ovlivňují hodnocení užitečnosti. Pokud je postava hladová, postupem času bude hladovět ještě více, a výsledek užitečnosti akce Jíst jídlo poroste, dokud ji postava neprovede, čímž sníží úroveň hladu a vrátí hodnotu Jíst jídlo na nulu.
Myšlenka výběru akcí na základě systému hodnocení je docela jednoduchá, a proto lze systém založený na užitečnosti používat jako součást procesů rozhodování AI, nikoli jako jejich úplnou náhradu. Rozhodovací strom může požádat o hodnocení užitečnosti dvou dceřiných uzlů a vybrat vyšší z nich. Podobně může mít strom chování složený uzel Užitečnost pro hodnocení užitečnosti akcí, aby se rozhodl, který dceřiný prvek provést.
Pohyb a navigace
V předchozích příkladech jsme měli platformu, kterou jsme pohybovali vlevo nebo vpravo, a strážného, který patroloval nebo útočil. Ale jak vlastně zpracováváme pohyb agenta po určitém časovém období? Jak nastavujeme rychlost, jak se vyhýbáme překážkám a jak plánujeme trasu, pokud je důležité dostat se na cílové místo složitější než jen se pohybovat rovně? Pojďme se na to podívat.
Správa
V počáteční fázi budeme předpokládat, že každý agent má hodnotu rychlosti, která zahrnuje to, jak rychle se pohybuje a kterým směrem. Ta může být měřena v metrech za sekundu, kilometrech za hodinu, pixelech za sekundu atd. Při vzpomínání na cyklus Sense/Think/Act si můžeme představit, že část Think volí rychlost, zatímco část Act tuto rychlost aplikuje na agenta. Obvykle ve hrách existuje fyzikální systém, který tuto úlohu vykonává za vás, posuzující hodnotu rychlosti každého objektu a upravující ji. Proto může být úkol AI pouze rozhodnout, jakou rychlost by měl agent mít. Pokud je známo, kde by se agent měl nacházet, je třeba ho přesunout správným směrem s nastavenou rychlostí. Velmi triviální rovnice:
desired_travel = destination_position – agent_position
Představte si 2D svět. Agent se nachází v bodě (-2,-2), cíl je někde na severovýchodě v bodě (30, 20), a potřebná cesta pro agenta, aby se tam dostal, je (32, 22). Předpokládejme, že tyto pozice jsou měřeny v metrech — pokud přijmeme rychlost agenta jako 5 metrů za sekundu, budeme škálovat náš vektor pohybu a dostaneme rychlost přibližně (4.12, 2.83). S těmito parametry by agent dorazil na místo určení skoro za 8 sekund.
Hodnoty lze přepočítat kdykoli. Pokud byl agent na půli cesty k cíli, jeho pohyb by byl polovinou délky, ale vzhledem k tomu, že maximální rychlost agenta je 5 m/s (jak jsme se rozhodli výše), rychlost zůstane stejná. To také funguje pro se pohybující cíle, což agentovi umožňuje provádět drobné úpravy, jak se pohybují.
Ale chceme více variabilnosti — například pomalu zvyšovat rychlost, aby se simulovala postava, která se pohybuje ze stojící pozice a přechází k běhu. Totéž lze udělat na konci před zastavením. Tyto funkce jsou známy jako steering behaviours, z nichž každá má konkrétní názvy: Seek (hledání), Flee (útěk), Arrival (příjezd) atd. Myšlenka spočívá v tom, že síly zrychlení mohou být aplikovány na rychlost agenta na základě porovnání polohy agenta a aktuální rychlosti s cílovým bodem, aby se využily různé způsoby pohybu k cíli.
Každé chování má trochu jiný cíl. Seek a Arrival jsou způsoby, jak přesunout agenta k cílovému bodu. Obstacle Avoidance (vyhýbání se překážkám) a Separation (oddělení) korigují pohyb agenta, aby se vyhýbal překážkám na cestě k cíli. Alignment (vyrovnání) a Cohesion (sblížení) udržují agenty pohromadě při jejich pohybu. Jakékoliv množství různých steering behaviours může být sečteno a vytvořit jeden směr pohybu, který bere v úvahu všechny faktory. Agent používající chování Arrival, Separation a Obstacle Avoidance, aby se držel dál od zdí a dalších agentů. Tento přístup funguje dobře na otevřených místech bez zbytečných detailů.
Ve složitějších podmínkách však sečítání různých chování funguje hůře — například agent se může zaseknout ve zdi kvůli konfliktu mezi Arrival a Obstacle Avoidance. Proto je třeba zvažovat možnosti, které jsou složitější než pouhé sečítání všech hodnot. Jedním z přístupů je: místo sečítání výsledků každého chování se mohou zvažovat pohyby v různých směrech a vybrat nejlepší možnost.
Avšak ve složitém prostředí s кřižovatkami a výběrem směru se budete potřebovat něco ještě pokročilejšího.
Hledání cesty
Steering behaviours skvěle fungují pro jednoduchý pohyb na otevřeném prostranství (fotbalové hřiště nebo aréna), kde cesta z A do B je přímá s malými odchylkami kolem překážek. Pro složitější trasy potřebujeme pathfinding (hledání cesty), což je prostředek k prozkoumání světa a rozhodování o trase skrze něj.
Nejjednodušší je překrýt každé políčko mřížkou a vyhodnotit, v jakých z nich je možné se pohybovat. Pokud je nějaké z nich cílovým místem, pak sledujte z něj trasu zpět z každého políčka do předchozího, dokud se nedostanete na začátek. To je trasa. Jinak opakujte proces s nejbližšími dalšími políčky, dokud nenajdete cílové místo nebo se vám nevyčerpají políčka (to znamená, že neexistuje možná trasa). To, co je formálně známé jako prohledávání do šířky, nebo BFS (Breadth-First Search). Při každém kroku se dívá všemi směry (proto šířka). Prostor pro vyhledávání se chová jako vlnový front, který se pohybuje, dokud nedosáhne hledaného místa — oblast vyhledávání se rozšiřuje v každém kroku, dokud nezachytí cílový bod, po kterém lze sledovat cestu zpět na začátek.
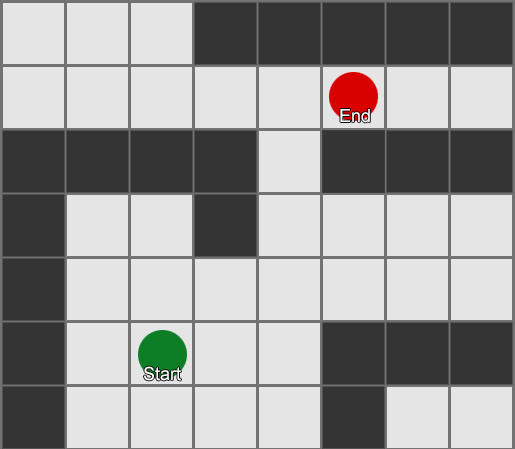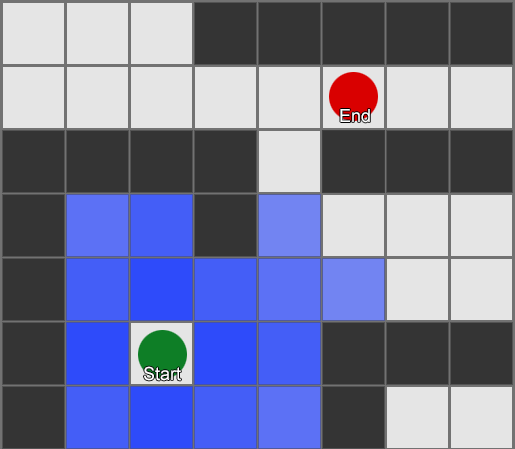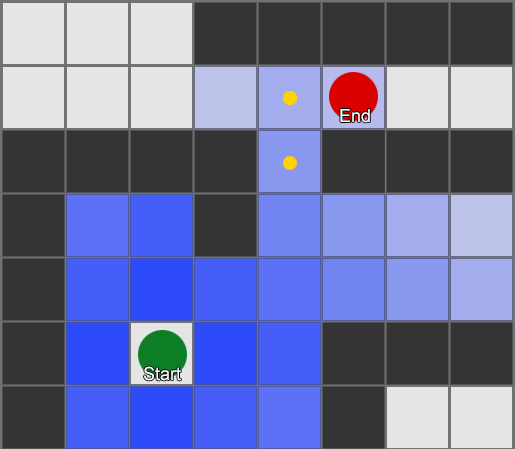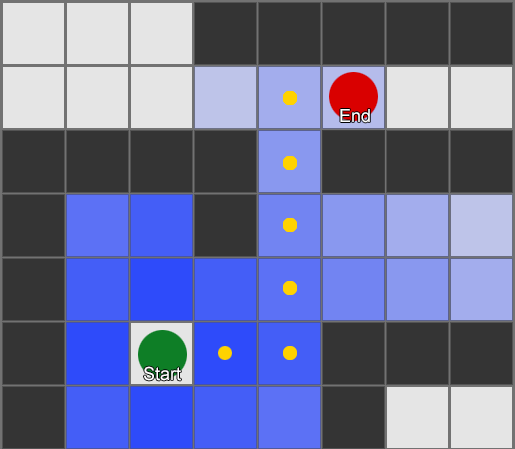
Jako výsledek získáte seznam políček, podle kterých se sestaví potřebná trasa. To je cesta (odtud nacházení cesty) — seznam míst, která agent navštíví, když jde za cílem.
Vzhledem k tomu, že známe polohu každého políčka ve světě, můžeme použít steering behaviours k pohybu po cestě — od uzlu 1 k uzlu 2, poté od uzlu 2 k uzlu 3 a tak dále. Nejjednodušší varianta je zamířit do středu následujícího políčka, ale ještě lepší je zastavit se uprostřed hrany mezi aktuálním políčkem a dalším. To umožní agentovi zkrátit zatáčky v ostrých obloucích.
Algoritmus BFS má také nevýhody — prozkoumá tolik políček v "nesprávném" směru, kolik v "správném". Zde přichází složitější algoritmus nazvaný A* (A star). Funguje to podobně, ale místo slepého prozkoumávání sousedních políček (poté sousedů sousedů, poté sousedů sousedů sousedů atd.) shromažďuje uzly do seznamu a třídí je tak, že další prozkoumávaný uzel je vždy ten, který povede k nejkratší trase. Uzly jsou tříděny na základě heuristiky, která zohledňuje dvě věci — "náklady" hypotetické trasy k požadovanému políčku (včetně jakýchkoli nákladů na pohyb) a odhad vzdálenosti tohoto políčka od cíle (posunující vyhledávání správným směrem).
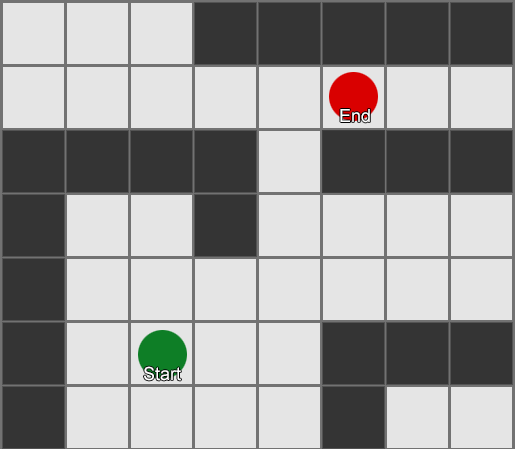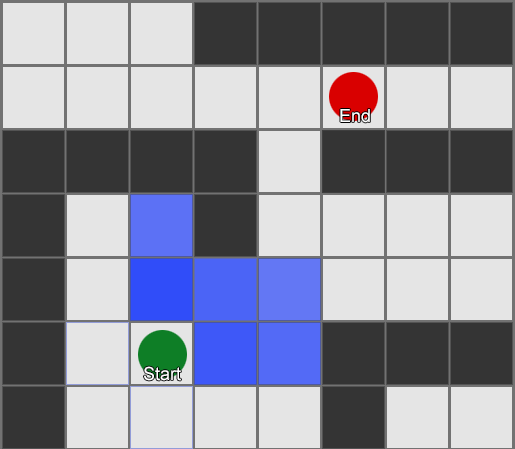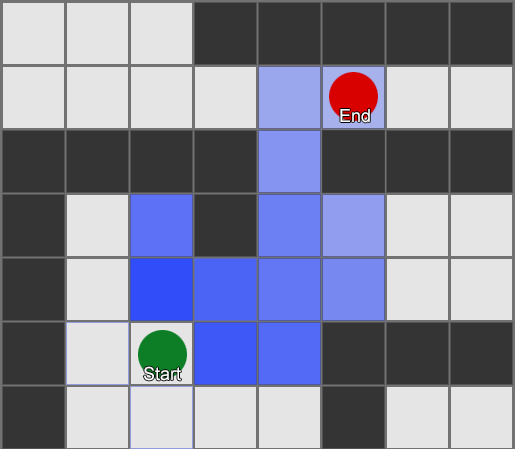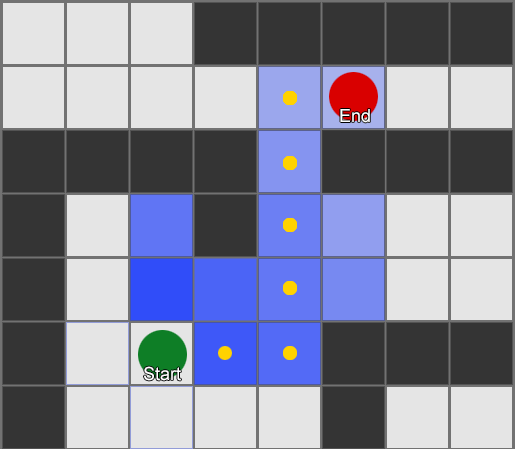
V tomto příkladu agent prozkoumává jedno čtverce po druhém, vždy vybírá sousední, který je nejperspektivnější. Získaná cesta je stejná jako při BFS, ale během procesu bylo zkoumáno méně čtverců — což má velký význam pro výkon hry.
Pohyb bez mřížky
Většina her však není postavena na mřížce a často je nemožné ji vytvořit, aniž by došlo k poškození realismu. Je potřeba udělat kompromisy. Jak velké by měly být čtverce? Příliš velké — a nebudou schopny správně reprezentovat úzké chodby nebo zatáčky, příliš malé — bude příliš mnoho čtverců k prohledání, což zabere spoustu času.
První věc, kterou je třeba pochopit — mřížka nám dává graf propojených uzlů. Algoritmy A* a BFS vlastně pracují na grafech a vůbec se nestarají o naši mřížku. Mohli bychom umístit uzly kdekoli ve herním světě: pokud bude mezi jakýmikoli dvěma propojenými uzly spojení, včetně počáteční a koncové bodu a alespoň jednoho z uzlů — algoritmus bude fungovat stejně dobře jako dříve. Často se tomu říká systém waypointů, protože každý uzel představuje významnou pozici ve světě, která může být součástí jakéhokoli počtu hypotetických cest.
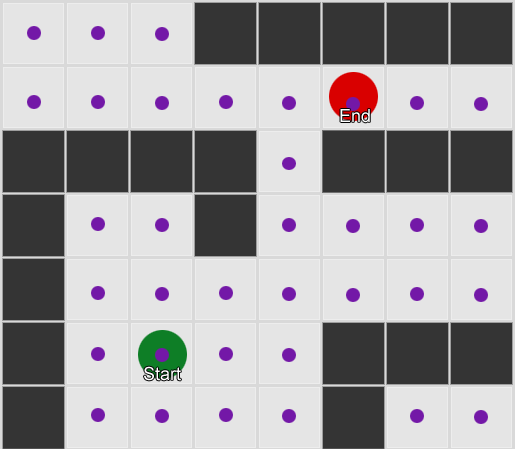
Příklad 1: uzel v každém čtverci. Hledání začíná z uzlu, ve kterém se nachází agent, a končí v uzlu požadovaného čtverce.
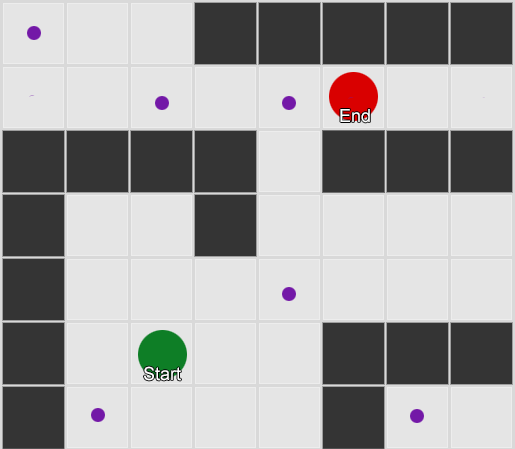
Příklad 2: menší sada uzlů (waypointů). Hledání začíná v čtverci s agentem, prochází potřebným počtem uzlů a poté pokračuje k cílovému bodu.
To je poměrně flexibilní a mocný systém. Ale je potřeba být opatrný při rozhodování, kde a jak umístit waypoint, jinak agenti jednoduše neuvidí nejbližší bod a nebudou schopni zahájit cestu. Bylo by jednodušší, kdybychom mohli automaticky umístit waypointy na základě geometrie světa.
Zde přichází na řadu navigation mesh neboli navmesh (navigační síť). To je obvykle 2D síť trojúhelníků, která se překrývá s geometrií světa — všude, kde je agentovi povoleno chodit. Každý z trojúhelníků v síti se stává uzlem v grafu a má až tři sousední trojúhelníky, které se stávají sousedními uzly v grafu.
Tento obrázek je příkladem z enginu Unity — analyzoval geometrii ve světě a vytvořil navmesh (na screenshotu světle modrou barvou). Každý polygon v navmesh je oblast, na které může agent stát nebo se přesunout z jednoho polygonu do druhého. V tomto příkladu jsou polygony menší než patra, na kterých se nachází — bylo to uděláno, aby se zohlednily rozměry agenta, který přesahuje jeho nominální polohu.
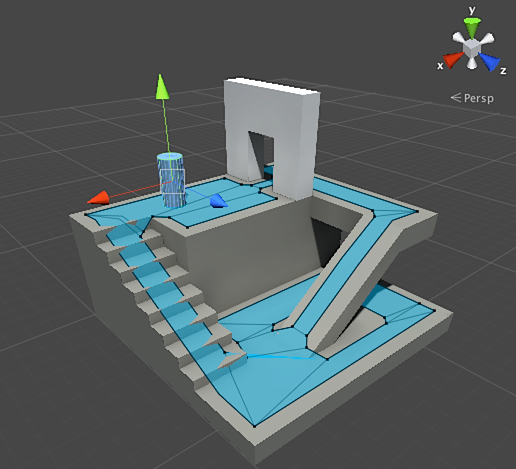
Můžeme hledat trasu přes tuto síť, opět pomocí algoritmu A*. To nám poskytne prakticky ideální trasu ve světě, která zohledňuje celou geometrii a přitom nevyžaduje nadbytečné uzly a vytváření kontrolních bodů.
Pathfinding je příliš obsáhlé téma, které se nevejde do jedné sekce článku. Pokud chcete studovat toto téma podrobněji, pomůže vám to .
Plánování
Ujistili jsme se u pathfindingu, že někdy nestačí jen vybrat směr a pohybovat se — musíme vybrat trasu a udělat několik zatáček, abychom se dostali na správné místo. Tuto myšlenku můžeme shrnout: dosáhnout cíle není jen další krok, ale celá sekvence, kde někdy musíme pohlédnout dopředu na pár kroků, abychom zjistili, jaký by měl být první. Tomu se říká plánování. Pathfinding lze považovat za jeden z několika doplňků plánování. Z hlediska našeho cyklu Sense/Think/Act je to místo, kde část Think plánuje několik částí Act do budoucna.
Podívejme se na příklad deskové hry Magic: The Gathering. Aktuálně hrajeme první s následujícím souborem karet:
- Swamp — dává 1 černou manu (karta země).
- Forest — dává 1 zelenou manu (karta země).
- Fugitive Wizard — vyžaduje 1 modrou manu k vyvolání.
- Elvish Mystic — vyžaduje 1 zelenou manu k vyvolání.
Zbylé tři karty ignorujeme, aby to bylo jednodušší. Podle pravidel má hráč povoleno zahrát 1 kartu země za kolo, může tuto kartu „tapnout“, aby získal manu, a poté použít kouzla (včetně vyvolání tvora) podle množství many. V této situaci ví hráč-člověk, že by měl zahrát Forest, „tapnout“ 1 zelenou manu a poté vyvolat Elvish Mystic. Ale jak to má odhadnout herní AI?
Jednoduché plánování
Triviální přístup — vyzkoušet každou akci postupně, dokud nezůstanou žádné vhodné. Když se dívá na karty, AI vidí, že může zahrát Swamp. A tak ho zahraje. Zůstaly na tomto tahu ještě další akce? Nemůže vyvolat ani Elvish Mystic, ani Fugitive Wizard, protože k jejich vyvolání je potřeba zelená a modrá mana a Swamp dává pouze černou manu. A již nebude moci zahrát Forest, protože již hrál Swamp. Takže herní AI hrálo podle pravidel, ale udělalo to špatně. Lze to zlepšit.
Plánování může najít seznam akcí, které přivádějí hru do požadovaného stavu. Stejně jako každý čtverec na cestě měl sousedy (v pathfindingu), každá akce v plánu také má sousedy nebo následovníky. Můžeme hledat tyto akce a následující akce, dokud nedosáhneme požadovaného stavu.
V našem příkladu je požadovaný výsledek „vyvolat bytost, pokud je to možné“. Na začátku tahu vidíme pouze dvě možné akce povolené pravidly hry:
1. Zahrát Swamp (výsledek: Swamp ve hře)
2. Zahrát Forest (výsledek: Forest ve hře)
Každá přijatá akce může vést k dalším akcím a uzavřít jiné, opět v závislosti na pravidlech hry. Představte si, že jsme zahráli Swamp — to odstraní Swamp jako další krok (už jsme ho zahráli), také to odstraní Forest (protože podle pravidel lze zahrát pouze jednu zemní kartu za tah). Poté AI přidá jako další krok — získání 1 černé many, protože nejsou žádné další možnosti. Pokud půjde dál a vybere Tap the Swamp, získá 1 jednotku černé many a nic s ní nebude moci udělat.
1. Zahrát Swamp (výsledek: Swamp ve hře)
1.1 „Tapnout“ Swamp (výsledek: Swamp „tapnutá“, +1 jednotka černé many)
Není dostupná žádná akce – KONEC
2. Zahrát Forest (výsledek: Forest ve hře)
Seznam akcí se ukázal jako krátký, dostali jsme se do slepé uličky. Opakujeme proces pro další akci. Hrajeme Forest, otevíráme akci „získat 1 zelenou manu“, která zase otevře třetí akci — vyvolání Elvish Mystic.
1. Zahrát Swamp (výsledek: Swamp ve hře)
1.1 „Tapnout“ Swamp (výsledek: Swamp „tapnutá“, +1 jednotka černé many)
Není dostupná žádná akce – KONEC
2. Zahrát Forest (výsledek: Forest ve hře)
2.1 „Tapnout“ Forest (výsledek: Forest „tapnutá“, +1 jednotka zelené many)
2.1.1 Vyvolat Elvish Mystic (výsledek: Elvish Mystic ve hře, -1 jednotka zelené many)
Není dostupná žádná akce – KONEC
Nakonec jsme prozkoumali všechny možné akce a našli plán, který vyvolává bytost.
Toto je velmi zjednodušený příklad. Je lepší zvolit nejlepší možný plán, než jen jakýkoli, který splňuje nějaká kritéria. Obecně lze potenciální plány posoudit na základě konečného výsledku nebo celkového prospěchu z jejich provedení. Můžete si připsat 1 bod za zahrání země a 3 body za vyvolání bytosti. Zahrát Swamp by znamenalo získat 1 bod. A zahrát Forest → Tap the Forest → vyvolat Elvish Mystic — to by hned dalo 4 body.
Takto funguje plánování v Magic: The Gathering, ale stejná logika se používá i v dalších situacích. Například posunout pěšce, aby se uvolnilo místo pro tah střelce v šachu. Nebo se schovat za zdí, abyste bezpečně stříleli v XCOM. Celkově, pochopili jste podstatu.
Vylepšené plánování
Někdy je příliš mnoho potenciálních akcí, než abyste zvažovali každou možnou variantu. Vrátíme-li se k příkladu z Magic: The Gathering: předpokládejme, že máte ve hře v ruce několik karet země a bytostí — počet možných kombinací tahů se může počítat na desítky. Existuje několik řešení problému.
První způsob — backward chaining (zpětné řetězení). Místo procházení všech kombinací, je lepší začít s konečným výsledkem a pokusit se najít přímou cestu. Místo cesty od kořene stromu k určitému listu se pohybujeme opačným směrem — od listu k kořeni. Tento způsob je jednodušší a rychlejší.
Pokud má protivník 1 bod zdraví, můžete nalézt plán „způsobit 1 nebo více bodů poškození“. Abyste toho dosáhli, musíte splnit řadu podmínek:
1. Poškození může způsobit kouzlo — to musí být v ruce.
2. Aby bylo možné zahrát kouzlo — potřebujete manu.
3. Abyste získali manu — musíte zahrát kartu země.
4. Abyste zahráli kartu země — musíte ji mít v ruce.
Další způsob — best-first search (nejlepší první vyhledávání). Místo procházení všech cest vybíráme tu nejvhodnější. Tento způsob obvykle poskytuje optimální plán bez zbytečných nákladů na vyhledávání. A* je formou nejlepšího prvního vyhledávání — zkoumáním nejperspektivnějších tras od samého začátku může najít nejlepší cestu, aniž by bylo nutné kontrolovat ostatní varianty.
Zajímavou a stále populárnější variantou best-first search je Monte Carlo Tree Search. Místo hádání, které plány jsou lepší než jiné při výběru každé následující akce, algoritmus na každém kroku volí náhodné následovníky, dokud nedosáhne konce (kdy plán vedl k vítězství nebo porážce). Poté se konečný výsledek používá ke zvýšení nebo snížení hodnocení "váhy" předchozích možností. Opakováním tohoto procesu několikrát za sebou algoritmus poskytuje dobré hodnocení toho, jaký další krok je nejlepší, i když se situace změní (pokud se protivník snaží hráče zablokovat).
V příběhu o plánování ve hrách nelze opomenout Goal-Oriented Action Planning neboli GOAP (cílené plánování akcí). Toto je široce používaná a diskutovaná metoda, ale kromě několika charakteristických detailů je to v podstatě metoda backwards chaining, o které jsme hovořili dříve. Pokud úkol byl „zničit hráče“, a hráč je za krytím, plán může být následující: znič granát, vezmi ho, hoď.
Obvykle existuje několik cílů, každý s vlastním prioritou. Pokud nelze splnit cíl s nejvyšší prioritou (žádná kombinace akcí nevytváří plán „zničit hráče“, protože hráč není vidět), AI se vrátí k cílům s nižší prioritou.
Učení a adaptace
Již jsme zmínili, že herní AI obvykle nepoužívá strojové učení, protože to není vhodné pro řízení agentů v reálném čase. Ale to neznamená, že se z této oblasti nedá nic převzít. Chceme nepřítele ve střílečce, od kterého se můžeme něco naučit. Například zjistit o nejlepších pozicích na mapě. Nebo protivníka ve fightingu, který by blokoval často používané kombo-techniky hráče, čímž by ho motivoval používat jiné. Strojové učení v takových situacích může být velmi užitečné.
Statistika a pravděpodobnosti
Než přejdeme ke složitějším příkladům, podívejme se, jak daleko se můžeme dostat, když provedeme několik jednoduchých měření a použijeme je k rozhodování. Například, strategie v reálném čase – jak určíme, zda hráč může začít útok v prvních několika minutách hry a jakou obranu proti tomu připravit? Můžeme prozkoumat minulou zkušenost hráče, abychom pochopili, jaká může být jeho budoucí reakce. Začněme tím, že nemáme taková výchozí data, ale můžeme je shromáždit – pokaždé, když AI hraje proti člověku, může zaznamenávat čas prvního útoku. Po několika sezeních získáme průměrnou hodnotu času, po kterém hráč zaútočí v budoucnu.
Průměrné hodnoty mají také problém: pokud hráč 20krát „rushoval“ a 20krát hrál pomalu, potřebné hodnoty budou kdesi uprostřed, což nám neposkytne nic užitečného. Jedno z řešení je omezit vstupní data – můžeme vzít v úvahu posledních 20 z nich.
Podobný přístup se používá při hodnocení pravděpodobnosti určitých akcí, předpokládajíc, že minulé preference hráče budou v budoucnu podobné. Pokud nás hráč pětkrát zaútočí kouzlem ohnivého balónu, dvakrát bleskem a jednou v těsném boji, je jasné, že preferuje ohnivý balón. Extrapolujeme a vidíme pravděpodobnost použití různých zbraní: ohnivý balón = 62,5 %, blesk = 25 % a těsný boj = 12,5 %. Našemu hernímu AI se musí připravit na obranu před ohněm.
Další zajímavou metodou je použití Naivního Bayesova klasifikátoru k prozkoumání velkých objemů vstupních dat a klasifikaci situace, aby AI reagovalo správným způsobem. Bayesovy klasifikátory jsou nejznámější za použití ve filtrech spamu e-mailu. Zkoumá slova, porovnává je s tím, kde se tato slova objevila dříve (ve spamu či nikoliv), a dělá závěry o příchozích e-mailech. Můžeme udělat to samé i s menším množstvím vstupních dat. Na základě všech užitečných informací, které AI vidí (například, jaké nepřátelské jednotky byly vytvořeny, jaká kouzla používají nebo jaké technologie zkoumali) a konečného výsledku (válka nebo mír, „rushovat“ nebo bránit se atd.) – vybereme požadované chování AI.
Všechny tyto metody učení jsou dostatečné, ale bylo by vhodné je používat na základě dat z testování. AI se naučí přizpůsobovat různým strategiím, které používali vaši playtesteři. AI, která se přizpůsobuje hráči po vydání, se může stát příliš předvídatelnou nebo naopak příliš složitou na poražení.
Přizpůsobení na základě hodnot
Vzhledem k obsahu našeho herního světa a pravidel můžeme změnit soubor hodnot, které ovlivňují rozhodování, a ne jen používat vstupní data. Děláme to takto:
- Nechme AI shromažďovat data o stavu světa a klíčových událostech během hry (jak bylo uvedeno výše).
- Změníme několik důležitých hodnot (value) na základě těchto dat.
- Realizujeme svá rozhodnutí, která vychází z analýzy nebo hodnocení těchto hodnot.
Například agent má na výběr několik místností na mapě střílečky z pohledu první osoby. Každá místnost má svou hodnotu, která určuje, jak žádaná je k návštěvě. AI náhodně vybírá, do které místnosti půjde, na základě hodnoty. Poté si agent zapamatuje, v které místnosti byl zabit, a její hodnotu sníží (pravděpodobnost, že se tam vrátí). Podobně je to v opačné situaci - pokud agent zlikviduje mnoho protivníků, hodnota místnosti se zvýší.
Markovův model
Co kdybychom použili shromážděná data k predikci? Pokud si zapamatujeme každou místnost, ve které jsme hráče viděli po určité období, budeme schopni předpovědět, do které místnosti hráč může přejít. Sledováním a zaznamenáváním pohybů hráče mezi místnostmi (values) můžeme predikovat jejich chování.
Vezměme tři místnosti: červenou, zelenou a modrou. A také pozorování, která jsme zaznamenali při sledování herní relace:
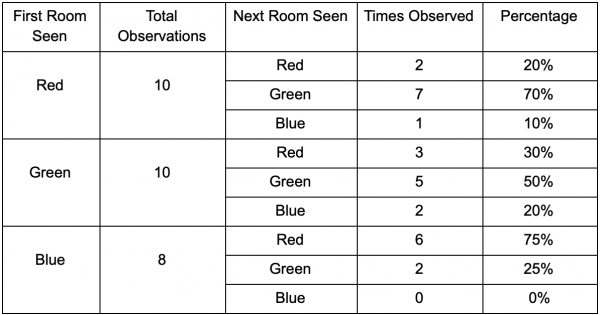
Počet pozorování každé místnosti je téměř stejný - zatím nevíme, kde udělat dobré místo pro léčku. Sběr statistik také komplikuje respawn hráčů, kteří se objevují rovnoměrně po celé mapě. Ale data o další místnosti, do které vstoupí po respawnu - už jsou užitečná.
Je zřejmé, že zelená místnost vyhovuje hráčům — většina lidí z červené přechází do ní, přičemž 50 % zůstává i nadále. Modrá místnost naopak není populární, téměř se do ní nechodí, a pokud ano, tak se tam dlouho nezdržují.
Ale data nám říkají něco důležitějšího — když je hráč v modré místnosti, je pravděpodobné, že se další místnost, ve které ho uvidíme, bude červená, a ne zelená. I když je zelená místnost populárnější než červená, situace se mění, pokud je hráč v modré. Další stav (to znamená místnost, do které hráč přejde) závisí na předchozím stavu (to znamená místnosti, ve které hráč právě je). Díky výzkumu závislostí budeme moci provádět předpovědi přesněji, než kdybychom jen počítali pozorování nezávisle na sobě.
Předpovídání budoucího stavu na základě dat z minulého stavu se nazývá Markovův model (Markov model), a takové příklady (s místnostmi) se nazývají Markovské řetězce. Jelikož modely představují pravděpodobnosti změn mezi po sobě jdoucími stavy, vizuálně jsou znázorňovány jako FSM s pravděpodobností u každého přechodu. Dříve jsme používali FSM k reprezentaci behaviorálního stavu, v němž se agent nacházel, ale tento koncept se vztahuje na jakýkoli stav, bez ohledu na to, zda je spojen s agentem. V tomto případě stavy představují místnost, kterou agent obsazuje:
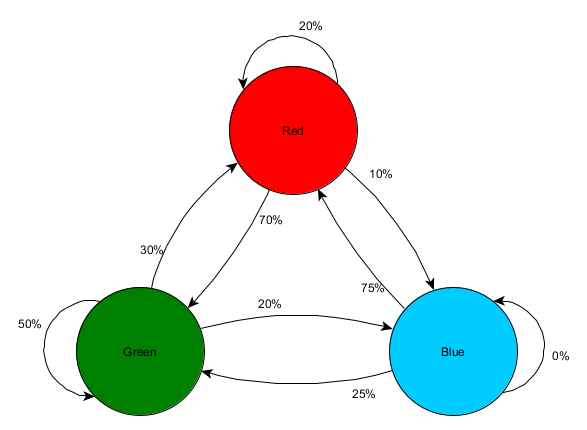
To je jednoduchá varianta reprezentace relativní pravděpodobnosti změn stavů, která dává AI určitou schopnost předpovídat další stav. Můžeme předvídat několik kroků dopředu.
Pokud je hráč v zelené místnosti, je pravděpodobnost, že tam zůstane při dalším pozorování, 50 %. Ale jaká je pravděpodobnost, že tam bude i později? Existuje nejen šance, že hráč zůstal v zelené místnosti po dvou pozorováních, ale také šance, že odešel a vrátil se. Zde je nová tabulka, která zohledňuje nová data:
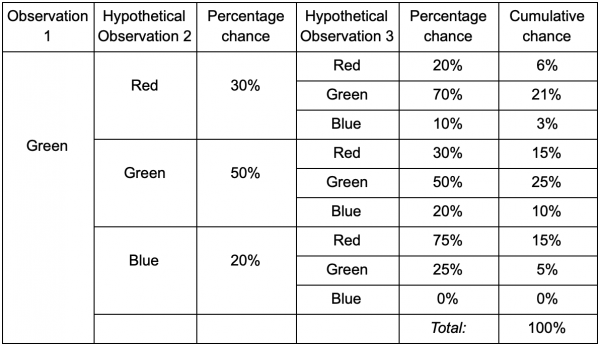
Z ní vyplývá, že šance vidět hráče v zelené místnosti po dvou pozorováních bude 51 % — 21 %, že přejde z červené místnosti, 5 %, že navštíví modrou místnost mezi nimi, a 25 %, že hráč vůbec neopustí zelenou místnost.
Tabulka je jednoduše vizuálním nástrojem – postup vyžaduje pouze násobení pravděpodobností na každém kroku. To znamená, že se můžete dívat daleko do budoucnosti s jednou výhradou: předpokládáme, že šance vstoupit do místnosti zcela závisí na aktuální místnosti. To se nazývá Markovským vlastnictvím (Markov Property) – budoucí stav závisí pouze na přítomném. Ale není to stoprocentně přesné. Hráči mohou měnit rozhodnutí v závislosti na dalších faktorech: úroveň zdraví nebo množství munice. Protože tyto hodnoty nezařazujeme, naše předpovědi budou méně přesné.
N-Gramy
A co takový příklad s bojem a předpovědí komba úderů hráče? Stejné! Ale místo jednoho stavu nebo události budeme zkoumat celé sekvence, které tvoří kombinační úder.
Jedním ze způsobů, jak to udělat, je uchovávat každý vstup (například Kick, Punch nebo Block) v bufferu a zaznamenat celý buffer jako událost. Takže hráč opakovaně stiskne Kick, Kick, Punch, aby použil útok SuperDeathFist, systém AI uchovává všechny vstupy v bufferu a pamatuje si poslední tři, které byly použity na každém kroku.
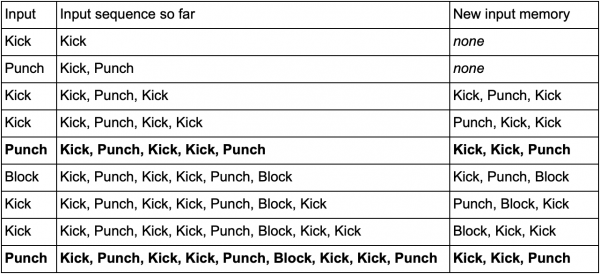
(Tučně zvýrazněny jsou řádky, kdy hráč spouští útok SuperDeathFist.)
AI uvidí všechny možnosti, kdy hráč zvolil Kick, následované dalším Kick, a pak si všimne, že další vstup je vždy Punch. To umožní agentovi předpovědět kombinační úder SuperDeathFist a zablokovat ho, pokud to bude možné.
Tyto sekvence událostí se nazývají N-gramy (N-grams), kde N je počet uchovávaných prvků. V předchozím příkladu to byla 3-grama (trigram), což znamená: první dvě položky se používají k předpovědi třetí. Odpovídajícím způsobem v 5-gramě první čtyři položky předpovídají pátou a tak dále.
Vývojář musí pečlivě vybírat velikost N-gramů. Menší číslo N vyžaduje méně paměti, ale také uchovává méně historie. Například 2-grama (bigram) by zaznamenávala Kick, Kick nebo Kick, Punch, ale nemohla by uchovávat Kick, Kick, Punch, takže AI by na kombinaci SuperDeathFist nereagovalo.
Na druhou stranu, větší čísla vyžadují více paměti a AI se bude složitěji učit, protože se objeví mnohem více možných variant. Pokud máte tři možné vstupy Kick, Punch nebo Block, a použili jsme 10-gramu, vyjde to na přibližně 60 tisíc různých variant.
Model bigramu je jednoduchý Markovův řetězec — každá dvojice „minulý stav / současný stav“ je bigram, a na základě prvního můžete předpovědět druhý stav. 3-gramy a větší N-gramy lze také považovat za Markovy řetězce, kde všechny prvky (kromě posledního v N-gramu) dohromady tvoří první stav, a poslední prvek je druhý. Příklad s bojem ukazuje šanci přechodu ze stavu Kick a Kick do stavu Kick a Punch. Pokud postupujeme tak, že několik záznamů o vstupní historii považujeme za jednu jednotku, v podstatě převádíme vstupní sekvenci na část celku. To nám dává Markovskou vlastnost, která umožňuje používat Markovy řetězce k předpovědi následujícího vstupu a uhádnout, který combo pohyb bude následující.
Závěr
Hovořili jsme o nejběžnějších nástrojích a přístupech v oblasti umělé inteligence. Také jsme probrali situace, ve kterých je třeba je aplikovat, a kde jsou zvlášť užitečné.
To by mělo stačit k pochopení základních aspektů herní AI. Ale samozřejmě to není zdaleka všechno. Mezi méně populární, ale stejně účinné metody patří:
- algoritmy optimalizace, včetně stoupání po kopcích, gradientního sestupu a genetických algoritmů
- soutěžní vyhledávací/plánovací algoritmy (minimax a alpha-beta pruning)
- metody klasifikace (perceptrony, neuronové sítě a stroje podpůrných vektorů)
- systémy pro zpracování vnímání a paměti agentů
- architektonické přístupy k AI (hybridní systémy, podmnožiny architektur a další způsoby překrývání AI systémů)
- nástroje pro animaci (plánování a synchronizace pohybu)
- faktory výkonu (úroveň detailu, algoritmy anytime a timeslicing)
Internetové zdroje na toto téma:
1. Na GameDev.net je , a také .
2. obsahuje mnoho prezentací a článků o širokém spektru souvisejících s vývojem herní AI.
3. obsahuje témata ze summitu GDC AI, z nichž mnohé jsou k dispozici zdarma.
4. Užitečné materiály lze také najít na webu .
5. Tommy Thompson, výzkumník AI a vývojář her, zveřejňuje videa na YouTube kanálu s vysvětlením a zkoumáním AI v komerčních hrách.
Knihy na toto téma:
1. Série knih Game AI Pro představuje sborníky krátkých článků, které vysvětlují, jak implementovat konkrétní funkce nebo jak řešit specifické problémy.
2. Série AI Game Programming Wisdom — předchůdce série Game AI Pro. Obsahuje starší metody, ale většina z nich je i dnes relevantních.
3. — to je jedna z klíčových knih pro všechny, kteří chtějí porozumět obecné oblasti umělé inteligence. Tato kniha není o herním vývoji — učí základní principy AI.
Zdroj: habr.com
