

Ahoj, Habr! Jsem Artem Karamyšev, vedoucí týmu správy systémů. . Za poslední rok jsme spustili mnoho nových produktů. Chtěli jsme zajistit, aby API služby snadno škálovaly, byly odolné vůči výpadkům a připravené na rychlý nárůst uživatelského zatížení. Naše platforma je postavena na OpenStacku a chci se podělit o to, jaké problémy s odolností komponentů jsme museli vyřešit, abychom získali odolný systém. Myslím, že to bude zajímat i ty, kteří vyvíjejí produkty na OpenStacku.
Celková odolnost platformy vychází z odolnosti jejích komponent. Takže postupně projdeme všemi úrovněmi, na kterých jsme zjistili rizika a odstranili je.
Videoverzi tohoto příběhu, jejímž prvotním zdrojem byl příspěvek na konferenci Uptime day 4, pořádané , si můžete prohlédnout .
Odolnost fyzické architektury
Veřejná část cloudu MCS nyní sídlí ve dvou datových centrech úrovně Tier III, mezi kterými je vlastní temná vlákna, rezervovaná na fyzické úrovni různými trasami, s propustností 200 Gbit/s. Úroveň Tier III zajišťuje potřebnou úroveň odolnosti fyzické infrastruktury.
Temná vlákna jsou rezervována jak na fyzické, tak na logické úrovni. Proces rezervace kanálů byl iterativní, objevovaly se problémy a neustále zlepšujeme spojení mezi datovými centry.
Například nedávno při práci v šachtě vedle jednoho z datových center vykopávací stroj prorazil trubku, uvnitř této trubky se nacházely jak hlavní, tak záložní optické kabely. Naše odolná komunikační linka s datovým centrem se ukázala být zranitelná na jednom místě, v šachtě. Bohužel jsme ztratili část infrastruktury. Poučili jsme se, podnikli jsme řadu kroků, včetně položení dodatečné optiky kolem sousední šachty.
V datových centrech jsou umístění poskytovatelů komunikace, kterým přenášíme naše prefixy přes BGP. Pro každý síťový směr se vybírá nejlepší metrika, což umožňuje zajistit různým klientům nejlepší kvalitu připojení. Pokud dojde k výpadku připojení přes jednoho poskytovatele, přizpůsobujeme naši routingu dostupným poskytovatelům.
V případě výpadku poskytovatele automaticky přepínáme na dalšího. V případě výpadku jednoho z datových center máme zrcadlovou kopii našich služeb ve druhém datovém centru, které přebírají veškeré zatížení.
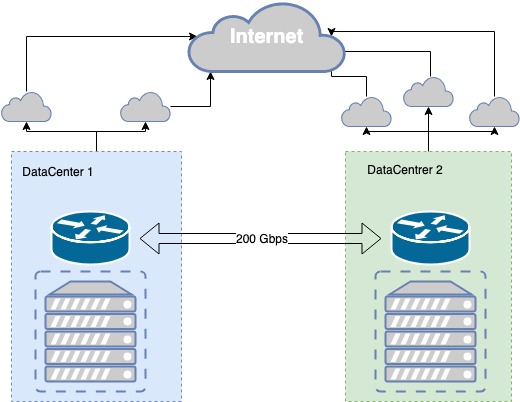
Odolnost fyzické infrastruktury
Co používáme pro odolnost na úrovni aplikací
Naše služba je postavena na řadě komponentů opensource.
ExaBGP — služba, která implementuje řadu funkcí pomocí protokolu dynamického směrování založeného na BGP. Aktivně ji používáme k oznamování našich bílých IP adres, přes které uživatelé získávají přístup k API.
Dále klientský dotaz vcházel do HAProxy, které řešilo následující úkoly: — vysoce zatížený vyvažovač, který umožňuje nastavovat velmi flexibilní pravidla vyvažování provozu na různých úrovních modelu OSI. Používáme ho k vyvažování před všemi službami: databázemi, zprostředkovateli zpráv, API službami, webovými službami, našimi interními projekty — všechno stojí za HAProxy.
API aplikace — webová aplikace napsaná v pythonu, pomocí které uživatel spravuje svou infrastrukturu, svůj servis.
Worker aplikace (dále jen worker) — v službách OpenStack je to infrastrukturní démon, který umožňuje přenášet API příkazy na infrastrukturu. Například, vytvoření disku probíhá právě v workeru, zatímco požadavek na vytvoření — v API aplikaci.
Standardní architektura OpenStack aplikace
Většina služeb vyvíjených pro OpenStack se snaží dodržovat jednotnou paradigmu. Služba obvykle sestává ze dvou částí: API a workerů (vykonavatelé backendu). Obecně je API WSGI aplikace v Pythonu, která běží buď jako samostatný proces (daemon), nebo pomocí již připraveného webového serveru Nginx, Apache. API zpracovává požadavek uživatele a předává další instrukce k vykonání aplikaci worker. Předávání probíhá pomocí zprostředkovatele zpráv, obvykle RabbitMQ, ostatní jsou podporovány špatně. Když zprávy dorazí do zprostředkovatele, zpracovávají je workeři a v případě potřeby vrátí odpověď.
Tato paradigma předpokládá izolované společné body selhání: RabbitMQ a databázi. RabbitMQ je izolován v rámci jedné služby a v ideálním případě může být individuální pro každou službu. V MCS tedy co nejvíce oddělujeme tyto služby, pro každý samostatný projekt vytváříme samostatnou databázi, samostatný RabbitMQ. Tento přístup je dobrý v tom, že v případě havarie na nějakých zranitelných místech se neporuší celá služba, ale pouze její část.
Počet aplikací worker není ničím omezen, proto může API snadno horizontálně škálovat za load balancingem za účelem zvýšení výkonu a odolnosti proti selhání.
V některých službách je nezbytná koordinace uvnitř služby — když dochází ke složitým sekvenčním operacím mezi API a workery. V tomto případě se používá jednotné centrum koordinace, clusterový systém typu Redis, Memcache, etcd, který umožňuje jednomu workeru říci druhému, že tato úloha je mu přidělena („prosím, neber si ji“). Používáme etcd. Obecně workeři aktivně komunikují s databází, píší a čtou z ní informace. Jako databázi používáme MariaDB, která se nachází v multimaster clusteru.
Taková klasická samostatná služba je organizována obvyklým způsobem pro OpenStack. Může být považována za uzavřený systém, pro který jsou dost jasné způsoby škálování a odolnosti proti selhání. Například pro odolnost proti selhání je dostačující umístit před API load balancer. Škálování workerů se dosahuje zvýšením jejich počtu.
Hlavní slabinou celého systému jsou RabbitMQ a MariaDB. Jejich architektura si zaslouží samostatný článek. V tomto článku se chci zaměřit na odolnost API.
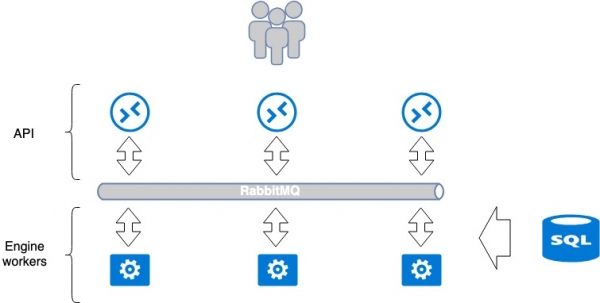
Architektura OpenStack Application. Vyvažování a odolnost cloudové platformy.
Zajišťujeme odolnost vyvažovače HAProxy pomocí ExaBGP.
Aby naše API byla škálovatelná, rychlá a odolná, nasadili jsme před ně vyvažovač. Zvolili jsme HAProxy. Podle mého názoru má všechny nezbytné vlastnosti pro náš úkol: vyvažování na několika úrovních OSI, ovládací rozhraní, flexibilitu a škálovatelnost, velké množství metod vyvažování, podporu tabulek sezení.
První problém, který bylo třeba vyřešit, byla odolnost samotného vyvažovače. Pouhé nasazení vyvažovače také vytváří kritické místo: pokud se vyvažovač porouchá, služba spadne. Abychom tomu předešli, použili jsme HAProxy společně s ExaBGP.
ExaBGP umožňuje implementovat mechanismus kontroly stavu služby. Tento mechanismus jsme použili k ověřování funkčnosti HAProxy a v případě problémů jsme vypli službu HAProxy z BGP.
Schéma ExaBGP+HAProxy.
- Na tři servery nainstalujeme potřebný software, ExaBGP a HAProxy.
- Na každém ze serverů vytvoříme loopback rozhraní.
- Na všech třech serverech nastavíme na toto rozhraní stejnou veřejnou IP adresu.
- Veřejná IP adresa je inzerována na internetu přes ExaBGP.
Odolnosti dosahujeme inzerováním stejné IP adresy ze všech tří serverů. Z pohledu sítě je stejná adresa dostupná ze tří různých next hopů. Směrovač vidí tři totožné trasy, vybírá podle své metriky tu nejprioritnější (to bývá obvykle stejný variant) a provoz směřuje pouze na jeden ze serverů.
V případě problémů s funkcionalitou HAProxy nebo výpadku serveru ExaBGP přestává inzerovat trasu a provoz se plynule přepne na jiný server.
Tímto způsobem jsme dosáhli odolnosti vyvažovače.
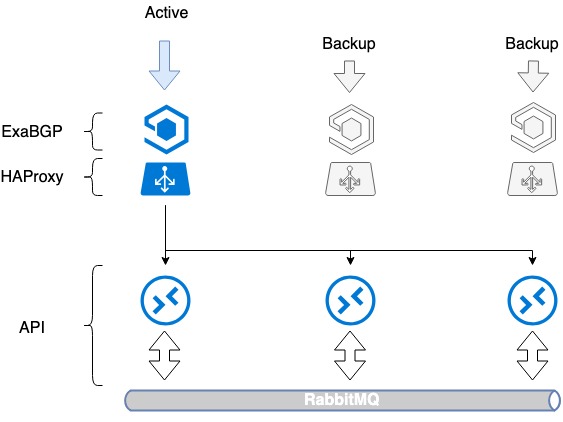
Odolnost vyvažovačů HAProxy.
Schéma se ukázalo jako nedokonalé: naučili jsme se rezervovat HAProxy, ale nenaučili jsme se rozdělovat zátěž v rámci služeb. Proto jsme tuto schéma mírně rozšířili: přešli jsme na vyvažování mezi několika veřejnými IP adresami.
DNS založená vyváženost plus BGP
Otázka vyvážení zátěže před našimi HAProxy stále zůstává nevyrěšena. Nicméně, je možné ji řešit poměrně jednoduše, jak jsme udělali u nás.
Pro vyvážení tří serverů bude potřeba 3 veřejné IP adresy a starý dobrý DNS. Každá z těchto adres je přiřazena k loopback rozhraní každého HAProxy a je oznámena na internetu.
V OpenStacku se pro správu zdrojů používá katalog služeb, ve kterém se zadává endpoint API určité služby. V tomto katalogu uvádíme doménové jméno — public.infra.mail.ru, které se pomocí DNS překládá na tři různé IP adresy. V důsledku toho získáváme rozložení zátěže mezi třemi adresami prostřednictvím DNS.
Ale protože při oznámení veřejných IP adres neřídíme priority volby serveru, zatím to není vyvážení. Obvykle bude vybrán pouze jeden server podle staršího IP adresy, zatímco dva další budou nečinné, protože v BGP nejsou specifikovány žádné metriky.
Začali jsme přenášet trasy přes ExaBGP s různou metrikou. Každý vyvažovač oznámí všechny tři veřejné IP adresy, ale jedna z nich, hlavní pro daný vyvažovač, je oznámena s minimální metrikou. Takže zatímco všechny tři vyvažovače jsou v provozu, požadavky na první IP adresu směřují na první vyvažovač, požadavky na druhou na druhý, na třetí na třetí.
Co se stane v okamžiku, kdy jeden z vyvažovačů selže? Při selhání jakéhokoli vyvažovače je jeho hlavní adresa stále oznámena z dvou dalších, provoz mezi nimi je přerozdělen. Takto okamžitě nabízíme uživateli přes DNS několik IP adres. Pomocí vyvážení na základě DNS a různé metriky přibýváme rovnoměrně rozloženou zátěž na všechny tři vyvažovače. A zároveň neztrácíme odolnost proti selhání.
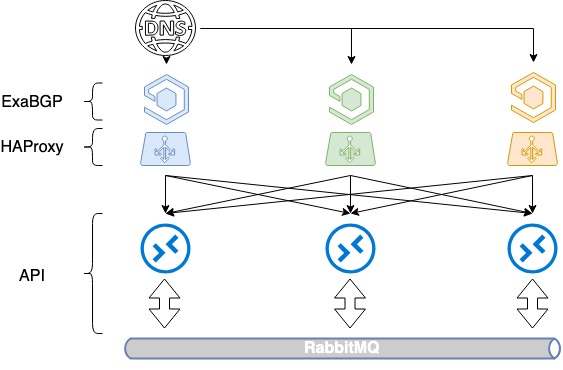
Vyvažování HAProxy na bázi DNS + BGP
Interakce mezi ExaBGP a HAProxy
Takže jsme implementovali odolnost v případě výpadku serveru na základě ukončení oznámení tras. Ale HAProxy může selhat i z dalších důvodů, než je výpadek serveru: chyby správy, selhání uvnitř služby. Chceme vyřadit nefunkční vyvažovač z provozu i v těchto případech a potřebujeme jiný mechanismus.
Proto tedy, rozšířením předchozího systému jsme implementovali heartbeat mezi ExaBGP a HAProxy. Toto je softwarová реалizace interakce mezi ExaBGP a HAProxy, kdy ExaBGP používá vlastní skripty pro kontrolu stavu aplikací.
K tomu je potřeba v konfiguračním souboru ExaBGP nastavit health checker, který bude moci kontrolovat stav HAProxy. V našem případě jsme nastavili health backend v HAProxy a z ExaBGP kontrolujeme jednoduchým GET požadavkem. Pokud se oznámení přestane uskutečňovat, znamená to, že HAProxy pravděpodobně nefunguje a nelze jej oznámit.
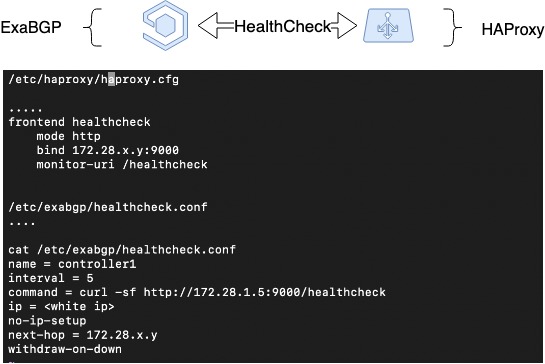
HAProxy Health Check
HAProxy Peers: synchronizace relací
Další, co bylo potřeba udělat, bylo synchronizovat relace. Při práci přes distribuované vyvažovače je obtížné uspořádat uchovávání informací o relacích klientů. Ale HAProxy je jedním z mála vyvažovačů, které to umí díky funkci Peers — možnosti předávat mezi různými procesy HAProxy tabulky relací.
Existují různé metody vyvažování: jednoduché, jako je , a pokročilé, kdy je relace klienta zapamatována a on se vždy dostane na ten stejný server, co předtím. My jsme chtěli implementovat druhou variantu.
V HAProxy se pro uchovávání relací klienta používá mechanismus stick-tables. Ty uchovávají původní IP adresu klienta, zvolenou cílovou adresu (backend) a nějaké pomocné informace. Obvykle se stick-tables používají pro uložení páru source-IP + destination-IP, což je zvlášť užitečné pro aplikace, které nemohou předat kontext relace uživatele při přepínání na jiný vyvažovač, například — v režimu vyvažování RoundRobin.
Pokud se stick-table naučí pohybovat mezi různými procesy HAProxy (mezi kterými probíhá vyvažování), naši vyvažovači budou moci pracovat s jedním pool kontrolních tabulek. To umožní bezproblémové přepínání sítě klienta při výpadku jednoho z vyvažovačů, práce s relacemi klientů bude pokračovat na těch stejných backendech, které byly zvoleny dříve.
Pro správnou funkci je třeba vyřešit problém s IP adresou vyvažovače, ze kterého byla relace navázána. V našem případě jde o dynamickou adresu na loopback rozhraní.
Správná funkce peers je dosažitelná pouze za určitých podmínek. To znamená, že TCP timeouty musí být dostatečně dlouhé, nebo přepínání musí být dostatečně rychlé, aby TCP relace nedošlo k přerušení. Přesto to umožňuje bezproblémové přepínání.
V našem IaaS máme službu, která je postavena na stejné technologii. To je , která se nazývá Octavia. Je postavena na dvou procesech HAProxy, ve které je od začátku zakotvena podpora peers. Tato služba se osvědčila.
Na obrázku je schematicky znázorněno přesouvání peers tabulek mezi třemi instancemi HAProxy, je navržená konfigurace, jak to lze nastavit:
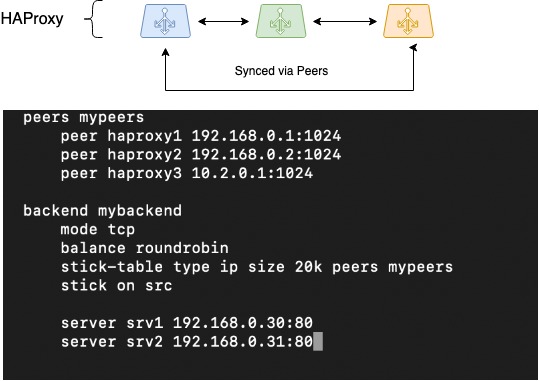
HAProxy Peers (synchronizace relací)
Pokud budete realizovat stejný systém, je třeba pečlivě testovat jeho funkčnost. Není zaručeno, že to bude fungovat ve stejné podobě ve 100 % případů. Ale aspoň nebudete ztrácet stick tabulky, když je třeba si pamatovat source IP klienta.
Omezení počtu současných požadavků od jednoho a toho samého klienta
Jakékoliv služby, které jsou veřejně dostupné, včetně našich API, mohou být vystaveny lavinám požadavků. Důvody mohou být zcela různé, od chyb uživatelů, po cílené útoky. Pravidelně jsme DDoS-ováni podle IP adres. Klienti často dělají chyby ve svých skriptech, což způsobuje mini-DDoSy.
Tak či onak je nutné předvídat dodatečnou ochranu. Očividným řešením se stává omezení počtu požadavků na API a neztrácení procesorového času na zpracování škodlivých požadavků.
Pro realizaci těchto omezení používáme rate limits, organizované na základě HAProxy, pomocí stejných stick tabulek. Limity se nastavují poměrně jednoduše a umožňují omezit uživatele podle počtu požadavků na API. Algoritmus si pamatuje source IP, ze které jsou požadavky prováděny, a omezuje počet současných požadavků od jednoho uživatele. Samozřejmě jsme vypočítali průměrný profil zátěže na API pro každou službu a nastavili limit přibližně 10krát vyšší než tato hodnota. Nadále pečlivě sledujeme situaci a máme ruku na tepně.
Jak to vypadá v praxi? Máme klienty, kteří neustále využívají naše API pro automatické škálování. Vytvářejí asi dvě stě až tři sta virtuálních strojů blíže k ránu a odstraňují je blíže k večeru. Pro OpenStack vytvoření virtuálního stroje, ještě s PaaS službami, znamená minimálně 1000 API požadavků, protože interakce mezi službami také probíhá prostřednictvím API.
Takové přesuny úloh generují poměrně velké zatížení. Tímto zatížením jsme se zabývali, shromáždili jsme denní špičky, které jsme zvýšili desetinásobně, a to se stalo naším rate limitem. Držíme ruku na tepu. Často vidíme boty a skenery, které se snaží zjistit, zda máme nějaké CGA skripty, které by bylo možné spustit; aktivně je likvidujeme.
Jak nezpozorovaně aktualizovat kódovou základnu
Implementujeme odolnost vůči chybám také na úrovni procesů nasazení kódu. Při nasazování dochází k selháním, ale jejich vliv na dostupnost služeb lze minimalizovat.
Neustále aktualizujeme své služby a musíme zajistit proces aktualizace kódové základny bez dopadu na uživatele. Tohoto úkolu jsme dosáhli využitím možnosti správy HAProxy a implementací Graceful Shutdown v našich službách.
Pro řešení tohoto úkolu bylo třeba zajistit správu load balanceru a "správné" vypnutí služeb:
- V případě HAProxy je správa prováděna prostřednictvím stats souboru, který v podstatě představuje socket a je definován v konfiguraci HAProxy. Příkazy mu lze předávat prostřednictvím stdio. Naším hlavním nástrojem pro kontrolu konfigurací je však ansible, takže obsahuje vestavěný modul pro správu HAProxy, který aktivně využíváme.
- Většina našich API a Engine služeb podporuje technologii graceful shutdown: při vypnutí čekají na dokončení aktuální úlohy, ať už je to http požadavek nebo nějaký administrativní úkol. To stejné platí i pro pracovníka. Ten zná všechny úkoly, které vykonává, a končí, když je všechno úspěšně dokončeno.
Díky těmto dvěma aspektům vypadá bezpečný algoritmus našeho nasazení následovně.
- Vývojář sestaví nový balík kódu (u nás je to RPM), testuje v dev prostředí, testuje ve stage a ponechá ve stage repozitáři.
- Vývojář nastavuje úkol pro nasazení s co nejpodrobnějším popisem „artefaktů“: verze nového balíčku, popis nové funkčnosti a další detaily o nasazení v případě potřeby.
- Systémový administrátor zahájí aktualizaci. Spustí Ansible playbook, který následně provádí následující:
- Vezme balíček ze stage-repozitáře a podle něj aktualizuje verzi balíčku v produkčním repozitáři.
- Sestaví seznam backendů aktualizované služby.
- Vypne první aktualizovanou službu v HAProxy a čeká na ukončení jejích procesů. Díky graceful shutdown jsme si jisti, že všechny aktuální požadavky klientů budou úspěšně dokončeny.
- Po úplném zastavení API, workerů a vypnutí HAProxy dojde k aktualizaci kódu.
- Ansible spouští služby.
- Pro každou službu spouští určité „páčky“, které provádějí unit testování pro řadu předem definovaných klíčových testů. Probíhá základní kontrola nového kódu.
- Pokud v předchozím kroku nebyly nalezeny žádné chyby, backend se aktivuje.
- Přejdeme k dalšímu backendu.
- Po aktualizaci všech backendů se spouští funkční testy. Pokud chybí, vývojář zkontroluje jakoukoli novou funkčnost, kterou vytvářel.
Tímto je nasazení ukončeno.
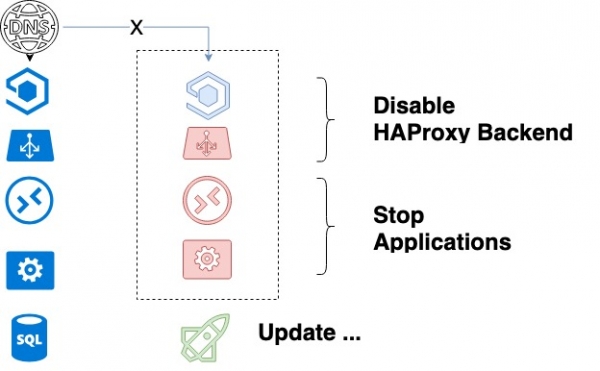
Cyklus aktualizace služby
Tento schéma by nebyla funkční, pokud bychom neměli jedno pravidlo. Podporujeme v produkci současně starou a novou verzi. Na předchozím vývojovém stupni softwaru je dohodnuto, že i když dojde ke změnám v databázi služby, nepoškodí předchozí kód. Výsledkem je postupná aktualizace kódové základny.
Závěr
Sdílejíc své vlastní myšlenky o odolné WEB-architektuře, chci ještě jednou zdůraznit její klíčové body:
- fyzická odolnost;
- síťová odolnost (vyvažovače, BGP);
- odolnost používaného a vyvíjeného softwaru.
Všem stabilní uptime!
Zdroj: habr.com
