

Odolnost proti chybám a vysoká dostupnost jsou rozsáhlá témata, proto věnujeme RabbitMQ a Kafka samostatné články. Tento článek je o RabbitMQ a následující bude o Kafka, ve srovnání s RabbitMQ. Článek je dlouhý, takže se pohodlně usaďte.
Podíváme se na strategie odolnosti proti chybám, konzistence a vysoké dostupnosti (HA), a také na kompromisy, kterým je třeba čelit v každé strategii. RabbitMQ může fungovat na clusteru uzlů — a pak je klasifikováno jako distribuovaný systém. Když mluvíme o distribuovaných systémech, často hovoříme o konzistenci a dostupnosti.
Tyto pojmy popisují, jak se systém chová při selhání. Selhání síťového připojení, selhání serveru, selhání pevného disku, dočasná nedostupnost serveru kvůli vyčištění paměti, ztráta paketů nebo zpomalení síťového připojení. To vše může vést ke ztrátě dat nebo konfliktům. Ukazuje se, že je prakticky nemožné vybudovat systém, který by byl současně úplně konzistentní (bez ztráty dat, bez nesouladu dat) a dostupný (bude akceptovat operace čtení a zápisu) pro všechny typy selhání.
Uvidíme, že konzistence a dostupnost jsou na opačných koncích spektra, a musíte si vybrat, kterou stranu chcete optimalizovat. Dobrou zprávou je, že s RabbitMQ je taková volba možná. Můžete manipulačními 'nerdy' páčkami posouvat rovnováhu směrem k větší konzistenci nebo větší dostupnosti.
Zvláštní pozornost věnujeme tomu, jaké konfigurace vedou ke ztrátě dat v důsledku potvrzených záznamů. Existuje řetězec odpovědnosti mezi publikátory, brokery a spotřebiteli. Jakmile je zpráva předána brokerovi, je jeho úkolem zprávu neztratit. Když broker potvrdí publikátorovi přijetí zprávy, nečekáme, že bude ztracena. Ale uvidíme, že se to skutečně může stát v závislosti na konfiguraci vašeho brokera a vydavatele.
Primitivy odolnosti jednoho uzlu
Odolné fronty/řešení
V RabbitMQ existují dva typy front: trvalé (durable) a netrvalé (non-durable). Všechny fronty jsou ukládány do databáze Mnesia. Trvalé fronty se znovu deklarují při spuštění uzlu a tím pádem přežijí restart, selhání systému nebo selhání serveru (pokud jsou data uchována). To znamená, že pokud deklarujete směrování (exchange) a frontu jako trvalé, infrastruktura front/směrování se vrátí do provozního režimu.
Netrvalé fronty a směrování se odstraňují při restartu uzlu.
Trvalé zprávy
Jednoduše to, že je fronta trvalá, neznamená, že všechny její zprávy přežijí restart uzlu. Obnoveny budou pouze zprávy, které pubisher označil jako trvalé (persistent). Trvalé zprávy skutečně vytvářejí dodatečné zatížení pro brokera, ale pokud je ztráta zprávy nepřijatelná, není jiná možnost.
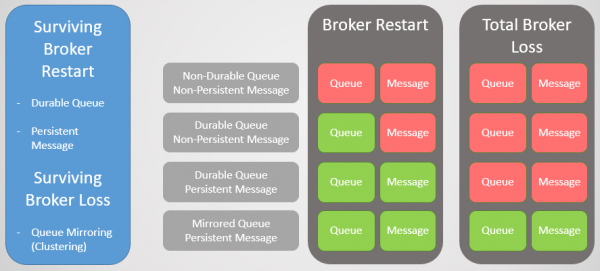
Obr. 1. Matice trvanlivosti
Klasterizace se zrcadlením fronty
Abychom přežili ztrátu brokera, potřebujeme redundanci. Můžeme spojit několik uzlů RabbitMQ do klastru a poté přidat další redundanci replikací front mezi několika uzly. Tak, i když jeden uzel selže, neztrácíme data a zůstáváme dostupní.
Zrcadlení fronty:
- jedna hlavní fronta (master), která přijímá všechny příkazy k zápisu a čtení
- jedno nebo více zrcadel, které přijímají všechny zprávy a metadata z hlavní fronty. Tato zrcadla neexistují pro škálování, ale výhradně pro redundanci.
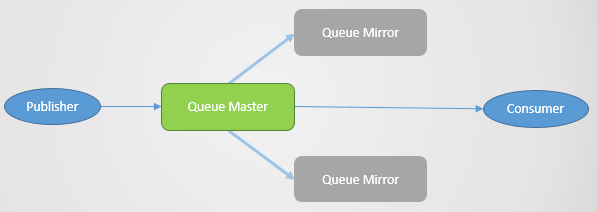
Obr. 2. Zrcadlení fronty
Zrcadlení se nastavuje odpovídající politikou. V ní lze zvolit koeficient replikace a dokonce uzly, na kterých by měla být fronta umístěna. Příklady:
ha-mode: allha-mode: exactly, ha-params: 2(jeden master a jedno zrcadlo)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Potvrzení publisherovi
Pro dosažení konzistentního zápisu jsou vyžadována potvrzení od publika (Publisher Confirms). Bez nich je pravděpodobnost ztráty zpráv. Potvrzení je zasíláno publiku po zápisu zprávy na disk. RabbitMQ zapisuje zprávy na disk nikoli při přijetí, ale na periodické bázi, v řádu několika set milisekund. Když je fronta replikována, potvrzení je posláno až poté, co všechna zrcadla také zapsala svou kopii zprávy na disk. To znamená, že použití potvrzení zvyšuje zpoždění, ale pokud je důležitá bezpečnost dat, jsou nezbytná.
Odolná fronta
Když broker skončí nebo spadne, všechny hlavní fronty (master) na tomto uzlu selžou spolu s ním. Poté klastr vybere nejstarší zrcadlo každého masteru a povýší ho na nového mastera.
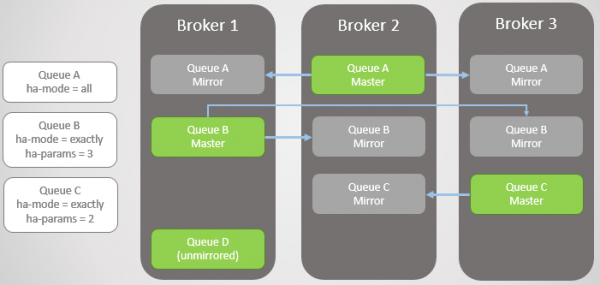
Obr. 3. Několik zrcadlených front a jejich politiky
Broker 3 spadne. Všimněte si, že zrcadlo Fronty C na Brokeru 2 se povyšuje na mastera. Také si všimněte, že pro Frontu C bylo vytvořeno nové zrcadlo na Brokeru 1. RabbitMQ se vždy snaží udržovat koeficient replikace, uvedený ve vašich politikách.
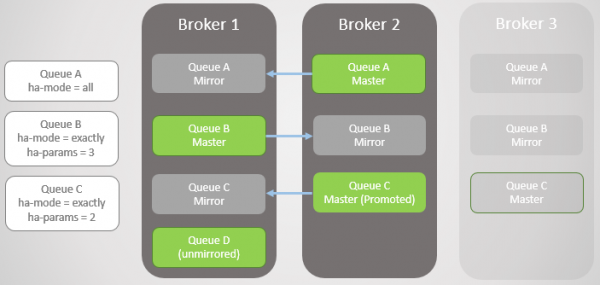
Obr. 4. Broker 3 selhává, což způsobuje selhání fronty C
Padá také Broker 1! Zůstáváme pouze s jedním brokerem. Zrcadlo Fronty B se povyšuje na mastera.
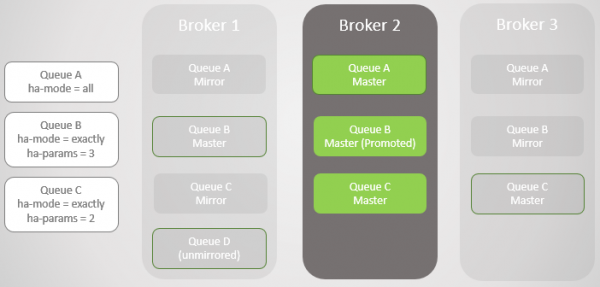
Obr. 5
Vrátili jsme Broker 1. Bez ohledu na to, jak úspěšně data přežila ztrátu a obnovení brokera, všechny zrcadlené zprávy fronty jsou při restartu vyřazeny. Je důležité to poznamenat, protože to má důsledky. Tyto důsledky si brzy probereme. Takto se Broker 1 nyní znovu stává členem klastru a klastr se snaží dodržovat politiky a proto vytváří zrcadla na Brokeru 1.
V tomto případě byla ztráta Brokera 1 úplná, stejně jako dat, takže nezrcadlená Fronta B byla zcela ztracena.
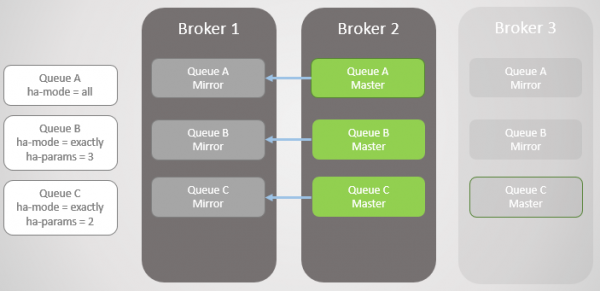
Obr. 6. Broker 1 se vrací do provozu
Broker 3 se vrátil do provozu, takže fronty A a B znovu získávají vytvořené na něm zrcadla, aby splnily své HA politiky. Ale nyní jsou všechny hlavní fronty na jednom uzlu! To není ideální, lepší by bylo rovnoměrné rozložení mezi uzly. Bohužel zde nejsou žádné speciální možnosti pro přebalancování masterů. K této otázce se vrátíme později, protože nejprve musíme zvážit synchronizaci fronty.
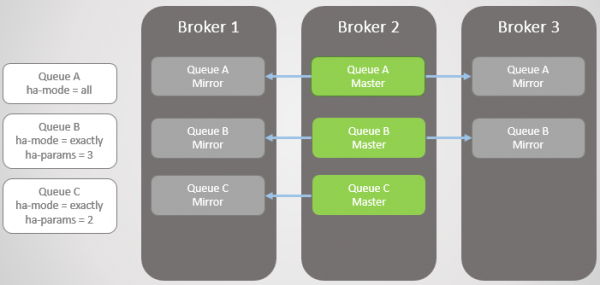
Obr. 7. Broker 3 se vrací do provozu. Všechny hlavní fronty na jednom uzlu!
Tímto způsobem byste měli mít nyní představu o tom, jak zrcadla zajišťují redundantnost a odolnost vůči výpadkům. To zaručuje dostupnost v případě selhání jednoho uzlu a chrání před ztrátou dat. Ale ještě jsme neskončili, protože je to ve skutečnosti mnohem složitější.
Synchronizace
Při vytvoření nového zrcadla budou všechny nové zprávy vždy replikovány na toto zrcadlo a jakákoli další. Co se týče existujících dat v hlavní frontě, můžeme je replikovat do nového zrcadla, které se stává úplnou kopií masteru. Také můžeme neprovádět replikaci existujících zpráv a nechat hlavní frontu a nové zrcadlo se scházet v čase, když nové zprávy přicházejí na konec a existující zprávy odcházejí z hlavy hlavní fronty.
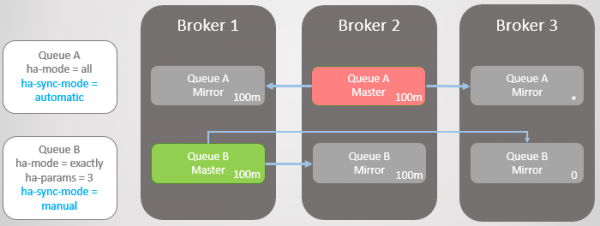
Taková synchronizace je prováděna automaticky nebo ručně a je řízena politikou front. Zvažme příklad.
Máme dvě zrcadlené fronty. Fronta A se synchronizuje automaticky, zatímco Fronta B ručně. V obou frontách je po deseti zprávách.
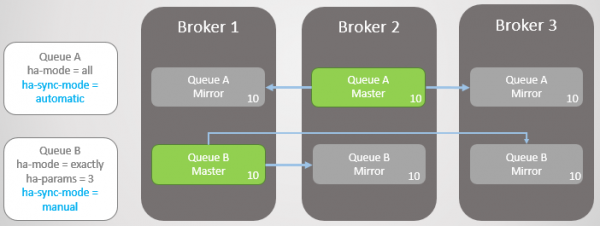
Obr. 8. Dvě fronty s různými režimy synchronizace
Nyní ztrácíme Broker 3.
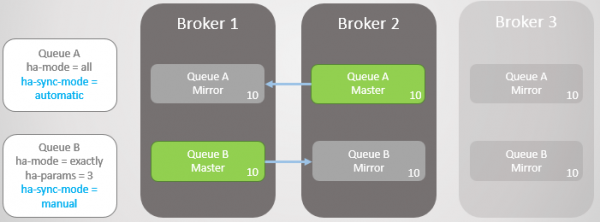
Obr. 9. Broker 3 selhal
Broker 3 se vrací do provozu. Kluster vytváří zrcadlo pro každou frontu na novém uzlu a automaticky synchronizuje novou Frontu A s masterem. Nicméně zrcadlo nové Fronty B zůstává prázdné. Tím máme plnou redundantnost Fronty A a pouze jedno zrcadlo pro existující zprávy Fronty B.
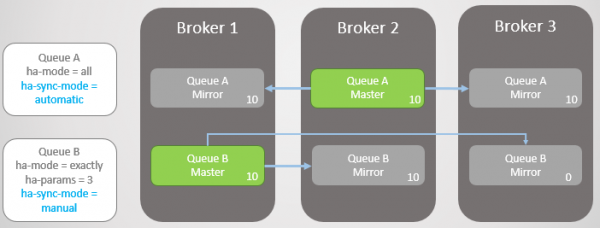
Obr. 10. Nové zrcadlo Fronty A přijímá všechny existující zprávy, zatímco nové zrcadlo Fronty B — ne.
Do obou front se přidá ještě deset zpráv. Poté Broker 2 selže a Fronta A se vrací k nejstarší replikaci, která je na Brokeru 1. Při selhání nedochází ke ztrátě dat. Ve Frontě B je dvacet zpráv v hlavním režimu a pouze deset v replikaci, protože tato fronta nikdy nereplikovala původních deset zpráv.
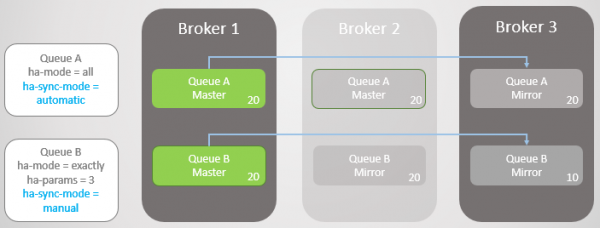
Obr. 11. Fronta A se vrací na Broker 1 bez ztráty zpráv
Do obou front se nyní přidá ještě deset zpráv. Nyní selže Broker 1. Fronta A se bez problémů přepne na replikaci bez ztráty zpráv. Nicméně Frontě B vzniknou problémy. V této fázi můžeme optimalizovat buď dostupnost, nebo konzistenci.
Pokud chceme optimalizovat dostupnost, měli bychom nastavit politiku ha-promote-on-failure na always. Toto je výchozí hodnota, takže politiku lze jednoduše neuvedout. V takovém případě v podstatě přijímáme selhání nesynchronizovaných replikací. To povede ke ztrátě zpráv, ale fronta zůstane dostupná pro čtení a zápis.
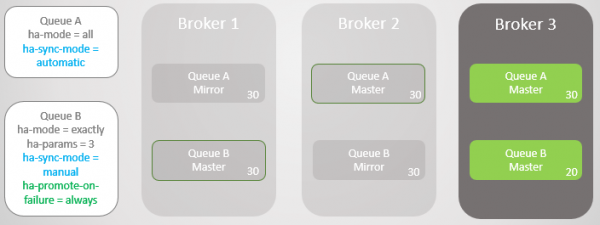
Obr. 12. Fronta A se vrací na Broker 3 bez ztráty zpráv. Fronta B se vrací na Broker 3 se ztrátou deseti zpráv
Můžeme také nastavit ha-promote-on-failure na hodnotu when-synced. V tomto případě místo vrácení na replikaci fronta počká, až se Broker 1 s jeho daty vrátí do provozu. Po jeho návratu se hlavní fronta opět nachází na Brokeru 1 bez ztráty dat. Dostupnost je obětována bezpečnosti dat. Ale je to riskantní režim, který může vést dokonce k úplné ztrátě dat, což si brzy ukážeme.
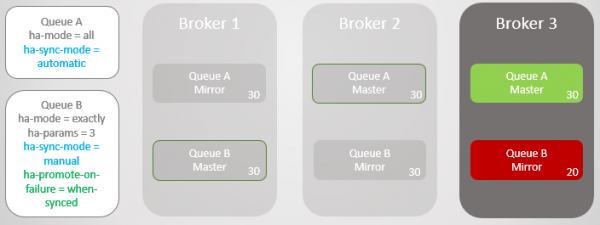
Obr. 13. Fronta B zůstává nedostupná po ztrátě Brokeru 1
Můžete se ptát: „Možná je lepší nikdy nepoužívat automatickou synchronizaci?“. Odpověď spočívá v tom, že synchronizace je blokující operace. Během synchronizace nemůže hlavní fronta provádět žádné čtecí nebo zápisové operace!
Zvažte příklad. Nyní máme velmi velké fronty. Jak se mohou dostat do takové velikosti? Z několika důvodů:
- Fronty nejsou aktivně využívány
- Jedná se o vysokorychlostní fronty, a právě teď spotřebitelé pracují pomalu
- Jedná se o vysokorychlostní fronty, došlo k selhání a spotřebitelé dohánějí
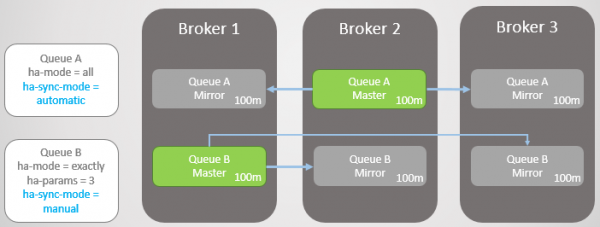
Obr. 14. Dvě velké fronty s různými režimy synchronizace
Nyní selhává Broker 3.
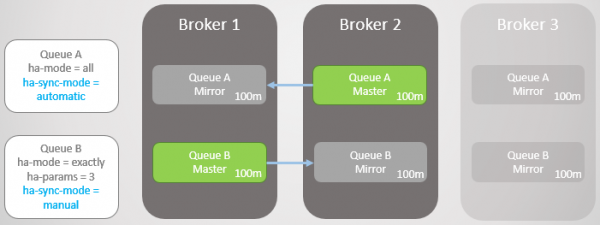
Obr. 15. Broker 3 selhává, zanechávající po jednom masteru a zrcadle v každé frontě
Broker 3 se vrací do provozu a vytvářejí se nová zrcadla. Hlavní Fronta A začíná replikovat existující zprávy na nové zrcadlo, a během této doby je Fronta nedostupná. K replikaci dat jsou potřebné dvě hodiny, což znamená dvě hodiny prostojů pro tuto Frontu!
Nicméně Fronta B zůstává dostupná po celé období. Obětovala část nadbytečnosti pro zajištění dostupnosti.
Obr. 16. Fronta zůstává nedostupná během synchronizace
Po dvou hodinách se Fronta A také stává dostupnou a může znovu začít přijímat operace čtení a zápisu.
Aktualizace
Takové blokující chování během synchronizace ztěžuje aktualizaci clusterů s velmi velkými frontami. V určitém okamžiku je třeba restartovat uzel s masterem, což znamená buď přepnutí na zrcadlo, nebo odpojení fronty během aktualizace serveru. Pokud zvolíme přepnutí, ztratíme zprávy, pokud zrcadla nejsou synchronizována. Ve výchozím nastavení při odpojení brokera nedochází k přepnutí na nesynchronizované zrcadlo. To znamená, že jakmile se broker vrátí, žádné zprávy neztratíme, jedinou ztrátou byl pouze prostoj fronty. Pravidla chování při odpojení brokera jsou určena politikou ha-promote-on-shutdown. Lze nastavit jednu z dvou hodnot:
always= je povoleno přepnutí na nesynchronizovaná zrcadlawhen-synced= přepnutí pouze na synchronizované zrcadlo, jinak se fronta stává nedostupnou pro čtení a zápis. Fronta se vrací do provozu, jakmile se broker vrátí
Ať tak či onak, s velkými frontami se musíme rozhodnout mezi ztrátou dat a nedostupností.
Když dostupnost zvyšuje bezpečnost dat
Před přijetím rozhodnutí je třeba zohlednit ještě jedno komplikování. I když je automatická synchronizace lepší pro nadbytečnost, jak ovlivňuje bezpečnost dat? Samozřejmě, díky lepší nadbytečnosti má RabbitMQ menší pravděpodobnost ztráty existujících zpráv, ale co nově přicházející zprávy od publikátorů?
Zde je třeba zvážit následující:
- Může publisher jednoduše vrátit chybu a následně se to pokusí znovu vyšší služba nebo uživatel?
- Může publisher uložit zprávu lokálně nebo do databáze, aby to zkusil znovu později?
Pokud publisher může pouze zahodit zprávu, pak vlastně zlepšení dostupnosti také zvyšuje bezpečnost dat.
Je tedy nutné hledat rovnováhu a rozhodnutí závisí na konkrétní situaci.
Problémy s ha-promote-on-failure=when-synced
Nápad ha-promote-on-failure= when-synced spočívá v tom, že bráníme přepnutí na nesynchronizované zrcadlo a tím se vyhýbáme ztrátě dat. Fronta zůstává nedostupná pro čtení nebo zápis. Místo toho se snažíme obnovit selhávající broker s neporušenými daty, aby mohl znovu fungovat jako master bez ztráty dat.
Ale (a to je velké ale) pokud broker ztratil svá data, máme velký problém: fronta je ztracena! Všechna data zmizela! I když máte zrcadla, která většinou dohoní hlavní frontu, tato zrcadla jsou také odhozena.
Chcete-li znovu přidat uzel se stejným názvem, říkáme clusteru, aby zapomněl ztracený uzel (příkazem rabbitmqctl forget_cluster_node) a spustit nový broker se stejným názvem hostitele. Dokud cluster pamatuje ztracený uzel, pamatuje si také starou frontu a nesynchronizovaná zrcadla. Když je clusteru řečeno, aby zapomněl ztracený uzel, tato fronta je také zapomenuta. Nyní je třeba ji znovu vyhlásit. Ztratili jsme všechna data, i když jsme měli zrcadla s částečnou sadou dat. Bylo by lepší přepnout na nesynchronizované zrcadlo!
Proto je ruční synchronizace (a neprovádění synchronizace) v kombinaci s ha-promote-on-failure=when-synced, podle mého názoru, poměrně riskantní. Dokumenty tvrdí, že taková varianta existuje pro bezpečnost dat, ale je to oboustranný nůž.
Přebalancování masterů
Jak bylo slíbeno, vracíme se k problému shromažďování všech masterů na jednom nebo více uzlech. To může nastat i v důsledku "klouzavé" (rolling) aktualizace clustru. V clustru se třemi uzly se všechny hlavní fronty shromáždí na jednom nebo dvou uzlech.
Přebalancování masterů může být problematické ze dvou důvodů:
- Neexistují dobré nástroje na provádění přebalancování
- Synchronizace front
Pro přebalancování existuje třetí strana , která není oficiálně podporována. Co se týče pluginů třetích stran, v příručce RabbitMQ : „Plugin poskytuje některé další nástroje pro konfiguraci a reportování, ale není podporován a nebyl zkontrolován týmem RabbitMQ. Používejte na vlastní riziko.“
Existuje ještě jeden trik, jak přesunout hlavní frontu prostřednictvím politik HA. V příručce se zmiňuje o tom. Funguje to takto:
- Odstraní všechna zrcadla pomocí dočasné politiky s vyšší prioritou než stávající politika HA.
- Změní dočasnou politiku HA na režim „uzly“ se specifikací uzlu, na který je třeba přesunout hlavní frontu.
- Synchronizuje frontu pro nucenou migraci.
- Po dokončení migrace odstraní dočasnou politiku. Aktivuje se původní politika HA a vytvoří se požadovaný počet zrcadel.
Nevýhodou je, že takový přístup nemusí fungovat, pokud máte velké fronty nebo přísné požadavky na redundanci.
Nyní se podívejme, jak clustery RabbitMQ fungují se síťovými odděleními.
Narušení soudržnosti
Uzly distribuovaného systému jsou propojeny síťovými vazbami, a tyto vazby se mohou a budou odpojovat. Frekvence odpojení závisí na místní infrastruktuře nebo spolehlivosti vybraného cloudu. V každém případě by distribuované systémy měly být schopny se s nimi vyrovnat. Znovu se před námi objevuje volba mezi dostupností a konzistencí, a opět je dobrou zprávou, že RabbitMQ poskytuje obě možnosti (pouze ne současně).
S RabbitMQ máme dvě základní možnosti:
- Povolit logické rozdělení (split-brain). To poskytuje dostupnost, ale může vyvolat ztrátu dat.
- Zakázat logické rozdělení. Může to vést ke krátkodobé ztrátě dostupnosti v závislosti na tom, jak se klienti připojují k clustru. Také může vést k úplné nedostupnosti v klastru ze dvou uzlů.
Ale co je to logické rozdělení? To nastává, když se klastr rozděluje na dvě části kvůli ztrátě síťových vazeb. Na každé straně se zrcadla povyšují na mistra, takže v důsledku toho má každá fronta několik mistrů.
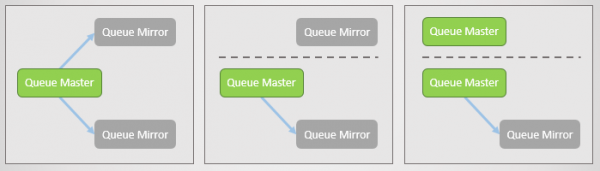
Obr. 17. Hlavní fronta a dvě zrcadla, každé na samostatném uzlu. Pak dojde k síťovému výpadku a jedno zrcadlo se oddělí. Oddělený uzel vidí, že dva ostatní jsou offline, a povyšuje svá zrcadla na master. Nyní máme dvě hlavní fronty, obě povolují zápis a čtení.
Pokud publikátoři posílají data do obou masterů, vzniknou nám dvě rozcházející se kopie fronty.
Různé režimy RabbitMQ zajišťují buď dostupnost, nebo konzistenci.
Režim Ignore (výchozí)
Tento režim zajišťuje dostupnost. Po ztrátě konektivity dojde k logickému rozdělení. Po obnovení konektivity musí administrátor rozhodnout, které rozdělení upřednostnit. Prohrávající strana bude restartována a všechna uložená data z této strany budou ztracena.
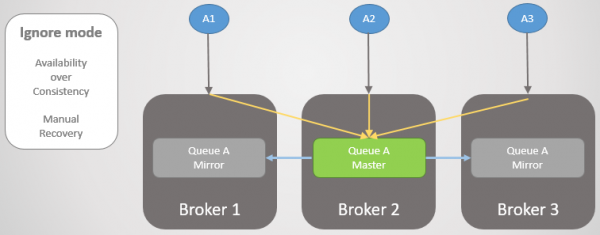
Obr. 18. Tři publikátoři jsou spojení se třemi brokery. Vnitřně klastr směruje všechny požadavky do hlavní fronty na Brokeru 2.
Nyní ztrácíme Broker 3. Vidí, že ostatní brokeři jsou offline, a povyšuje své zrcadlo na master. Tak dochází k logickému rozdělení.
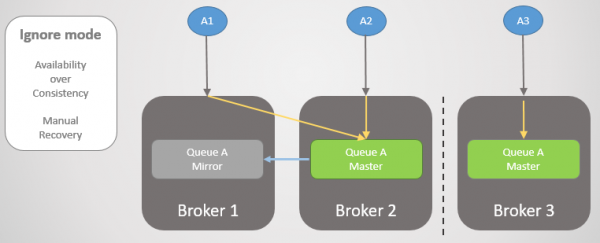
Obr. 19. Logické rozdělení (split-brain). Zápisy jsou rozděleny do dvou hlavních front, a dvě kopie se rozcházejí.
Konektivita se obnovuje, ale logické rozdělení zůstává. Administrátor musí ručně vybrat prohrávající stranu. V uvedeném případu administrátor restartuje Broker 3. Ztrácí se všechny zprávy, které nestihl předat.
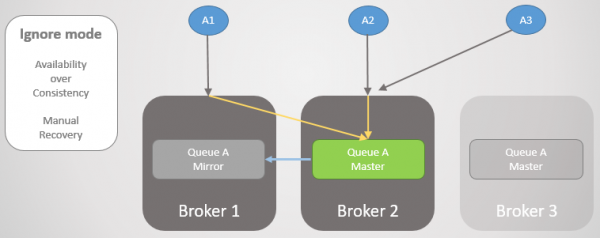
Obr. 20. Administrátor vypíná Broker 3.
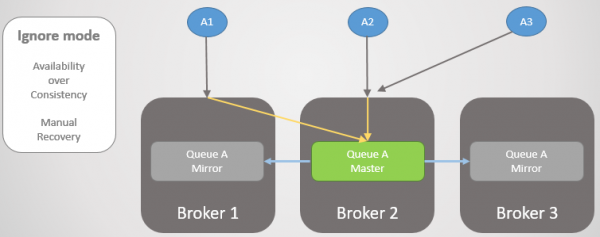
Obr. 21. Administrátor spouští Broker 3 a ten se připojuje k klastru, přičemž ztrácí všechny zprávy, které tam zůstaly.
Během ztráty konektivity a po jejím obnovení byl klastr a tato fronta dostupná pro čtení a zápis.
Režim Autoheal
Funguje podobně jako režim Ignore, s výjimkou toho, že samotný klastr automaticky vybírá prohrávající stranu po rozdělení a obnovení konektivity. Prohrávající strana se vrací do klastru prázdná a fronta ztrácí všechny zprávy, které byly zaslány pouze na tuto stranu.
Režim Pause Minority
Pokud nechceme povolit logické oddělení, je naším jediným řešením zcela se vzdát čtení a zápisu na menší straně po oddělení clusteru. Když broker zjistí, že se nachází na menší straně, zastaví provoz, tedy uzavře všechna existující spojení a odmítne jakákoli nová. Jednou za sekundu kontroluje obnovení konektivity. Jakmile je konektivita obnovena, obnoví provoz a připojí se zpět do clusteru.
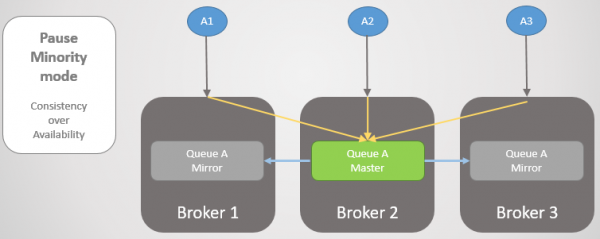
Obr. 22. Tři publishery jsou spojeny se třemi brokery. Interně cluster směruje všechny požadavky do hlavní fronty na Brokeru 2.
Poté se Brokery 1 a 2 oddělí od Brokera 3. Místo aby zvýšil své zrcadlo na master, Broker 3 pozastaví provoz a stane se nedostupným.
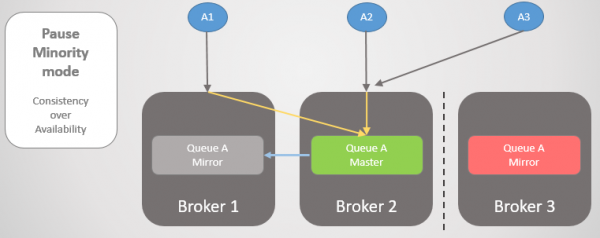
Obr. 23. Broker 3 zastavuje provoz, odpojuje všechny klienty a odmítá požadavky na připojení.
Jakmile je konektivita obnovena, vrací se do clusteru.
Podívejme se na jiný příklad, kde je hlavní fronta na Brokeru 3.
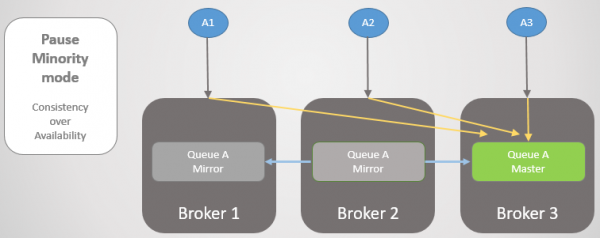
Obr. 24. Hlavní fronta na Brokeru 3.
Pak dochází ke stejné ztrátě konektivity. Broker 3 se zastavuje, protože je na menší straně. Na druhé straně uzly vidí, že Broker 3 vypadl, takže starší zrcadlo z Brokerů 1 a 2 se zvyšuje na master.
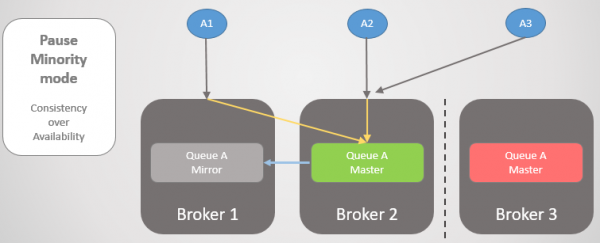
Obr. 25. Přechod na Brokera 2 při nedostupnosti Brokera 3.
Když je konektivita obnovena, Broker 3 se přidá do clusteru.

Obr. 26. Cluster se vrátil do normálního provozu.
Je důležité pochopit, že získáváme konzistenci, ale také můžeme dosáhnout dostupnosti, pokud úspěšně převedeme klienty na větší část sekce. Pro většinu situací bych osobně zvolil režim Pause Minority, ale to skutečně závisí na konkrétním případu.
Pro zajištění dostupnosti je důležité se ujistit, že se klienti úspěšně připojují k uzlu. Podívejme se na naše možnosti.
Zajištění konektivity klientů
Máme několik možností, jak po ztrátě konektivity nasměrovat klienty na hlavní část clusteru nebo na funkční uzly (po selhání jednoho uzlu). Nejprve si připomeňme, že konkrétní fronta je umístěna na určitém uzlu, ale směrování a politiky se replikují na všech uzlech. Klienti se mohou připojit k libovolnému uzlu a vnitřní směrování je nasměruje tam, kam potřebují. Pokud je však uzel pozastaven, odmítá připojení, a proto se klienti musí připojit k jinému uzlu. Pokud uzel vypadne, může toho udělat jen málo.
Naše možnosti:
- Přístup k clusteru je zajištěn pomocí vyvažovače zátěže, který prostě cyklicky prochází uzly, a klienti provádějí opakované pokusy o připojení, dokud nedojde k úspěšnému spojení. Pokud uzel nefunguje nebo je pozastaven, pokusy o připojení k tomuto uzlu skončí neúspěchem, ale následující pokusy budou směřovat na jiné servery (v cyklickém režimu). To je vhodné pro krátkodobou ztrátu konektivity nebo selhání serveru, které bude rychle obnoveno.
- Přístup k clusteru přes vyvažovač zátěže a odstranění pozastavených/selhávajících uzlů ze seznamu, jakmile jsou zjištěny. Pokud se to udělá rychle, a pokud jsou klienti schopni provádět opakované pokusy o připojení, zajistíme tím trvalou dostupnost.
- Poskytnout každému klientovi seznam všech uzlů, přičemž se klient při připojení náhodně vybírá jeden z nich. Pokud při pokusu o připojení dostane chybu, přejde na další uzel v seznamu, dokud se nepřipojí.
- Odebrání provozu od selhávajícího/pozastaveného uzlu pomocí DNS. To se provádí pomocí malé TTL.
Závěry
Klastry RabbitMQ mají své výhody a nevýhody. Nejzávažnější nevýhody spočívají v tom, že:
- při připojení k clustru uzly ztrácí svá data;
- blokující synchronizace vede k nedostupnosti fronty.
Všechna obtížná rozhodnutí vycházejí z těchto dvou charakteristik architektury. Kdyby RabbitMQ mohl uchovávat data při opětovném připojení k clustru, synchronizace by probíhala rychleji. Kdyby byl schopen nebloční synchronizace, lépe by podporoval velké fronty. Odstranění těchto dvou problémů by vážně zlepšilo vlastnosti RabbitMQ jako spolehlivé a vysoce dostupné technologie pro výměnu zpráv. Doporučovat RabbitMQ s clusteringem bych se neodvážil v následujících situacích:
- Nespolehlivá síť.
- Nespolehlivé úložiště.
- Velmi velké fronty.
Pokud jde o nastavení pro vysokou dostupnost, zvažte následující:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(neboautoheal)- odolné zprávy
- ujistěte se, že klienti se připojují k aktivnímu uzlu, když nějaký uzel selže
Pro soulad (bezpečnost dat) zvažte následující nastavení:
- Publisher Confirms a Manual Acknowledgements na straně spotřebitele
ha-promote-on-failure=when-synced, pokud mohou vydavatelé retry později a pokud máte velmi spolehlivé úložiště! Jinak nastavte=always.ha-sync-mode=automatic(ale pro velké neaktivní fronty může být potřeba ruční režim; navíc zvažte, zda nedostupnost nevede ke ztrátě zpráv)- režim Pause Minority
- odolné zprávy
Neprobrali jsme ještě všechny otázky spolehlivosti a vysoké dostupnosti; například jak bezpečně provádět administrativní úkony (jako jsou rolling updates). Je třeba probrat také federaci a plugin Shovel.
Pokud jsem ještě něco opomenul, dejte mi prosím vědět.
Viz také můj , kde provádím chaos v clustru RabbitMQ pomocí Dockeru a Blockade k testování některých scénářů ztráty zpráv popsaných v tomto článku.
Předchozí články série:
č. 1 —
č. 2 —
č. 3 —
Zdroj: habr.com
