

TL; DR: JSONB může výrazně zjednodušit návrh databázových schémat bez ohrožení výkonu dotazů.
Úvod
Uvedeme klasický příklad, pravděpodobně jednoho z nejstarších použití v oblasti relačních databází (DB): máme entitu a je třeba uložit určité vlastnosti (atributy) této entity. Ale ne všechny instance mohou mít stejnou sadu vlastností, navíc v budoucnu může být potřeba přidat další vlastnosti.
Nejjednodušší cesta, jak tento problém vyřešit, je vytvoření sloupce v tabulce DB pro každou hodnotu vlastnosti a jednoduše vyplnit ty, které jsou potřebné pro konkrétní instanci entity. Skvělé! Problém vyřešen… do chvíle, kdy vaše tabulka bude obsahovat miliony záznamů a vy budete potřebovat přidat nový záznam.
Podíváme se na EAV vzor (), který se vyskytuje docela často. Jedna tabulka obsahuje entity (záznamy), druhá tabulka obsahuje názvy vlastností (atributů) a třetí tabulka propojuje entity s jejich atributy a obsahuje hodnoty těchto atributů pro aktuální entitu. To vám umožňuje mít různé sady vlastností pro různé objekty a také přidávat vlastnosti "na místě", aniž byste měnili strukturu DB.
Nicméně, nepíšu tuto poznámku, pokud by zde nebyly nevýhody spojené s použitím EAV. Například ke získání jedné nebo několika entit, které mají jednu vlastnost, jsou potřeba 2 joiny (sjednocení) v dotazu: první spojení s tabulkou atributů, druhé s tabulkou hodnot. Pokud entita má 2 atributy, potřebujete už 4 joiny! Kromě toho, všechny atributy jsou obvykle uloženy jako řetězce, což vede k nutnosti provádět převody typů jak pro výsledek, tak pro podmínku WHERE. Pokud píšete mnoho dotazů, je to dost plýtvání, pokud jde o využití zdrojů.
I přes tyto očividné nevýhody se EAV již dlouho používá k řešení podobných problémů. Bylo to nevyhnutelné, a lepší alternativa zkrátka neexistovala.
Ale pak v PostgreSQL přišla nová „technologie“…
Od verze PostgreSQL 9.4 byl přidán datový typ JSONB pro ukládání binárních dat JSON. Ačkoli ukládání JSON v tomto formátu obvykle zabírá o něco více místa a času než prostý textový JSON, provádění operací s ním je výrazně rychlejší. JSONB také podporuje indexování, což činí dotazy na něj ještě rychlejšími.
Datový typ JSONB nám umožňuje nahradit objemný vzor EAV přidáním pouhého jednoho sloupce JSONB do naší tabulky entit, což výrazně zjednodušuje návrh databáze. Mnozí však tvrdí, že to by mělo být spojeno se snížením výkonu… Z tohoto důvodu vznikl tento článek.
Nastavení testovací databáze
Pro toto srovnání jsem vytvořil databázi na nové instalaci PostgreSQL 9.5 na 80dolarové sestavě Ubuntu 14.04. Po nastavení některých parametrů v postgresql.conf jsem spustil skript pomocí psql. Pro prezentaci dat ve formátu EAV byly vytvořeny následující tabulky:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Níže je uvedena tabulka, kde budou uložena stejná data, ale s atributy ve sloupci typu JSONB – >, nebo je lze definovat prostřednictvím systémové vlastnosti.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Vypadá to mnohem jednodušeji, že? Poté bylo do tabulek entit (entity && entity_jsonb) vloženo 10 milionů záznamů a odpovídajícím způsobem byla vyplněna stejná data v tabulkách, kde se používá vzor EAV a přístup s JSONB sloupcem – entity_jsonb.properties. Tímto způsobem jsme získali několik různých typů dat mezi celým souborem vlastností. Příklad dat:
{
  id:          1
  name:        "Entity1"
  description: "Testovací entita č. 1"
  properties:  {
    color:        "červená"
    length:       120
    width:        3.1882420
    hasSomething: true
    country:      "Belgie"
  }
}
Tak, nyní máme stejná data pro dvě varianty. Pojďme začít porovnávat implementace v praxi!
Zjednodušení návrhu
Jak již bylo zmíněno, návrh DB byl výrazně zjednodušen: jedna tabulka, díky použití sloupce JSONB pro vlastnosti, namísto použití tří tabulek pro EAV. Jak se to však odráží v dotazech? Aktualizace jednoho atributu entity vypadá následovně:
-- EAV
UPDATE entity_attribute_value
SET value = 'modrá'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"modrá"')
WHERE id = 120;
Jak vidíme, poslední dotaz nevypadá jednoduše. Abychom aktualizovali hodnotu vlastnosti v objektu JSONB, musíme použít funkci , a musíme předat naši novou hodnotu jako objekt JSONB. Nicméně nemusíme znát žádný identifikátor předem. Podívejme se na příklad s EAV, potřebujeme znát jak entity_id, tak entity_attribute_id, abychom mohli provést aktualizaci. Pokud chcete aktualizovat vlastnost ve sloupci JSONB na základě názvu objektu, – to vše se dělá jedním jednoduchým řádkem.
Teď si vyberme tu entitu, kterou jsme právě aktualizovali, podle podmínky její nové barvy:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'modrá';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'modrá';
Myslím, že se můžeme shodnout na tom, že druhé je kratší (bez join!), a tedy i čitelnější. Tady vyhrává JSONB! Používáme operátor JSON ->>, abychom získali barvu jako textovou hodnotu z objektu JSONB. Existuje také druhý způsob, jak dosáhnout stejného výsledku v modelu JSONB pomocí operátoru @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "modrá"}';
To je trochu složitější: kontrolujeme, zda objekt JSON ve sloupci vlastností obsahuje objekt, který je napravo od operátoru @>. Méně čitelné, ale výkonější (viz dále).
Zjednodušíme používání JSONB ještě více, když potřebujete vybrat několik vlastností současně. Zde se skutečně hodí přístup JSONB: prostě vybíráme vlastnosti jako další sloupce v našem výsledkovém souboru bez nutnosti spojení:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
S EAV budete potřebovat 2 spojení pro každou vlastnost, kterou chcete dotazovat. Podle mého názoru uvedené dotazy ukazují velké zjednodušení designu databáze. Další příklady, jak psát dotazy na JSONB, lze také najít v příspěvku.
Teď je čas promluvit o výkonu.
Výkon
Abych porovnal výkon, použil jsem v dotazech, pro výpočet doby trvání. Každý dotaz byl proveden alespoň třikrát, protože při prvním provedení dotazu plánovač dotazů potřebuje více času. Nejprve jsem provedl dotazy bez jakýchkoli indexů. To očividně sloužilo k výhodě JSONB, protože spojení potřebná pro EAV nemohla využívat indexy (pole cizího klíče nebyla indexována). Poté jsem vytvořil index pro 2 sloupce cizích klíčů v tabulce hodnot EAV, stejně jako index pro sloupec JSONB.
Aktualizace dat ukázala následující výsledky ohledně času (v ms). Vezměte na vědomí, že měřítko je logaritmické:
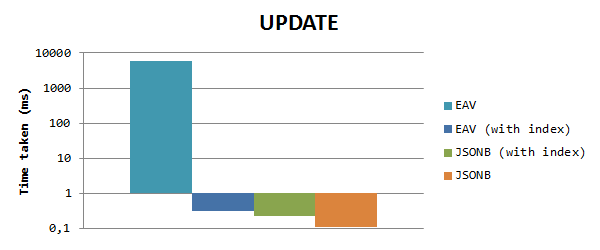
Vidíme, že JSONB je mnohem (> 50000-x) rychlejší než EAV, pokud nejsou použity indexy, kvůli výše uvedenému důvodu. Když indexujeme sloupce s primárními klíči, rozdíl se téměř vytrácí, ale JSONB je stále 1,3krát rychlejší než EAV. Všimněte si, že index ve sloupci JSONB zde nemá žádný vliv, protože sloupec vlastností nepoužíváme v hodnotících kritériích.
Pro výběr dat na základě hodnoty vlastnosti dostáváme následující výsledky (běžné měřítko):
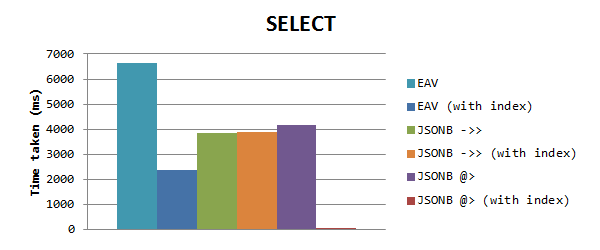
Můžeme si všimnout, že JSONB opět pracuje rychleji než EAV bez indexů, ale když EAV má indexy – přesto funguje rychleji než JSONB. Poté jsem viděl, že čas pro dotazy JSONB byl stejný, což mě přivedlo k tomu, že index GIN nefungoval. Očitě, když používáte index GIN pro sloupec s vyplněnými vlastnostmi, funguje pouze při použití operátoru zahrnutí @>. Použil jsem to v novém testu, což mělo obrovský vliv na čas: pouhých 0,153 ms! To je 15000krát rychlejší než EAV a 25000krát rychlejší než operátor ->.
Myslím, že to bylo dost rychlé!
Velikost tabulek DB
Pojďme porovnat velikosti tabulek při obou přístupech. V psql můžeme ukázat velikost všech tabulek a indexů pomocí příkazu dti+
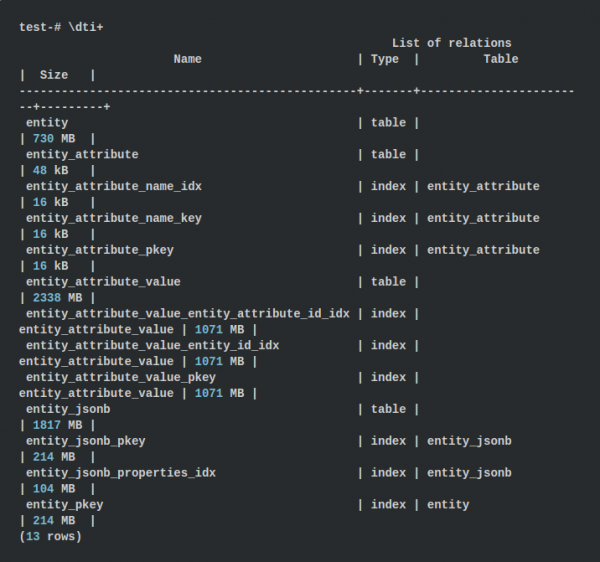
Pro přístup EAV mají velikosti tabulek kolem 3068 MB, a indexy až 3427 MB, což celkem dává 6,43 GB. Při použití přístupu s JSONB se používá 1817 MB pro tabulku a 318 MB pro indexy, což činí 2,08 GB. To je třikrát méně! Tento fakt mě trochu překvapil, protože ukládáme názvy vlastností v každém objektu JSONB.
Ale přesto čísla mluví sama za sebe: v EAV uchováváme 2 celočíselné cizí klíče na hodnotu atributu, čímž získáme 8 bajtů dodatečných dat. Kromě toho jsou v EAV všechny hodnoty vlastností uchovávány jako text, zatímco JSONB využívá číselné a logické hodnoty tam, kde je to možné, což vede k menšímu objemu.
Závěry
Celkově si myslím, že uchovávání vlastností entit ve formátu JSONB může zásadně zjednodušit návrh a údržbu vaší databáze. Pokud provádíte mnoho dotazů, pak všechno, co je uloženo v jedné tabulce s entitou, skutečně funguje efektivněji. A skutečnost, že to zjednodušuje interakci mezi daty, je již výhoda, ale také výsledná databáze je 3krát menší.
Také podle provedených testů lze dojít k závěru, že ztráty výkonu jsou velmi nepatrné. V některých případech dokonce JSONB funguje rychleji než EAV, což ho dělá ještě lepším. Tento referenční test však samozřejmě nezahrnuje všechny aspekty (například entity s velmi velkým množstvím vlastností, výrazné zvýšení počtu vlastností existujících dat,…), proto, pokud máte nějaké návrhy na jejich zlepšení, neváhejte zanechat komentář!
Zdroj: habr.com
