

Ahoj, Habr! V Dodo Pizza Engineering máme velmi rádi data (kdo je dnes nemá rád?). Nyní vám řekneme příběh o tom, jak shromáždit všechna data světa Dodo Pizza a poskytnout každému zaměstnanci firmy pohodlný přístup k tomuto obrovskému datovému souboru. Úkol s hvězdičkou: zachovat nervy týmu Data Engineering.
Jako praví Pliškinové shromažďujeme různé informace o provozu našich pizzerií:
- pamatujeme si všechny objednávky zákazníků;
- víme, kolik času zabralo vyrobení první pizzy v Syktyvkaře;
- vidíme, kolik času pizza aktuálně chladne na hřejivé polici ve Voroněži;
- uchováváme data o úbytku produktů;
- a mnohé další.
Za práci s daty v Dodo Pizza nyní odpovídá několik týmů, jedním z nich je tým Data Engineering. Aktuálně máme před sebou úkol: poskytnout každému zaměstnanci firmy pohodlný přístup k tomuto datovému souboru.
Když jsme začali přemýšlet o tom, jak to udělat, a začali diskutovat o úkolu, našli jsme velmi zajímavý přístup k řízení dat – (v odkazu najdete obrovský skvělý článek). Jeho myšlenky se velmi dobře hodily k našemu pojetí toho, jak chceme vybudovat náš systém. Dále v článku najdete naše přemýšlení o přístupu a to, jak vidíme jeho implementaci v Dodo Pizza Engineering.
Co máme na mysli pod "daty"
Nejprve si definujme, co rozumíme daty v Dodo Pizza Engineering:
- Události, které posílají služby (máme společnou sběrnici postavenou pomocí RabbitMQ);
- Záznamy v databázi (pro nás je to MySQL a CosmosDB);
- Stream kliknutí z mobilní aplikace a webu.
Aby mohl podnik Dodo Pizza tato data využívat a spoléhat se na ně, je důležité, aby byla splněna následující kritéria:
- Musí být integrovaná. Musíme si být jisti, že nedochází k úpravě dat během jejich zpracování, ukládání a zobrazení. Pokud si podnik nebude moci důvěřovat našim datům, nebudou mít žádnou hodnotu.
- Musí mít časovou značku a nesmí být přepisována. To znamená, že chceme mít kdykoliv možnost vrátit se zpět a podívat se na data z daného časového úseku. Například zjistit, kolik pizz bylo prodáno 8. července 2018.
- Musí být spolehlivá. Při sběru a ukládání dat musíme zachovat nejen integritu, ale i spolehlivost. Nemůžeme ztrácet data a časové segmenty, protože s nimi ztrácíme důvěru našich zákazníků (jak externích, tak interních).
- Musí mít stabilní schéma – píšeme dotazy na tato data. Opravdu bychom nechtěli, aby se se změnou kódu aplikace, s refaktoringem, změnily natolik, že naše dotazy přestanou fungovat. Ten, kdo píše dotazy, se nikdy nedozví, že jste provedli refaktoring, dokud to všechno nezhavaruje. Nechtěli bychom se o tom dozvědět od klientů.
S ohledem na všechny tyto požadavky jsme dospěli k závěru, že data v Dodo jsou produktem. Stejně jako veřejné API služby. Odpovídajícím způsobem by měla vlastnit data stejná tým, který vlastní službu. Také změny datového schématu by vždy měly být zpětně kompatibilní.
Tradiční přístup – Data Lake
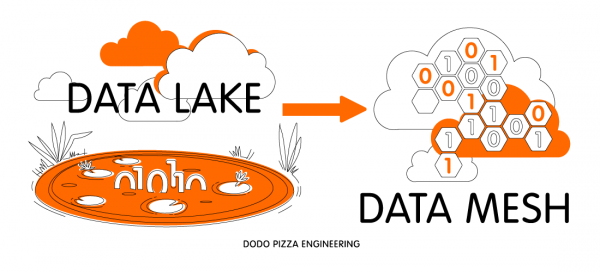
Pro řešení úloh spolehlivého ukládání a zpracování velkých dat existuje tradiční přístup, který je přijat v mnoha společnostech pracujících s takovým množstvím informací – Data Lake. V rámci tohoto přístupu shromažďují datoví inženýři informace ze všech komponent systému a ukládají je do jednoho velkého úložiště (to může být například Hadoop, Azure Kusto, Apache Cassandra nebo dokonce MySQL replikace, pokud se do ní data vejdou).
Dále tito stejní inženýři píší dotazy na takové úložiště. Realizace tohoto přístupu v Dodo Pizza Engineering předpokládá, že tým Data Engineering bude vlastnit datové schéma v analytickém úložišti.
V této variantě se tým stává velmi smutnými kočičkami a to z následujících důvodů:
- Musí sledovat změny ve VŠECH službách v rámci společnosti. A těch je hodně a změn je také velmi mnoho (průměrně slučujeme ~100 pull requestů týdně, přičemž mnohé služby vůbec neprovádějí pull requesty).
- Při změně datového schématu musí produktový vlastník a tým, který mění datové schéma, čekat, až Datové inženýrství napíše kód potřebný k tomu, aby změny byly podporovány. Přitom máme už dlouho zařazené funkce a situace, kdy jeden tým čeká na druhý, je velmi vzácná. A nechceme, aby se to stalo "normální" součástí vývojového procesu.
- Musí být ponořený do CELÉ firemní byznys. Síť pizzerií se zdá jako jednoduchý byznys, ale to je jen zdání. Je velmi obtížné shromáždit v jednom týmu dostatek kompetencí pro vybudování adekvátní datové modelu pro celou firmu.
- Je to jediný bod selhání. Každýkrát, když je potřeba změnit data, která služba vrací, nebo napsat dotaz, všechny tyto úkoly spadnou na tým Data Engineering. V důsledku toho má tým přeplněný backlog.
Takže tým se nachází v bodu, kde se křižují obrovské množství potřeb a pravděpodobně je nebude schopen uspokojit. Přitom bude neustále ve stresu a časovém presu. To si moc nepřejeme. Proto musíme přemýšlet, jak tyto problémy vyřešit a přitom získat možnost analyzovat data.
Přechod od Data Lake k Data Mesh
Naštěstí si tuto otázku kladli nejen my. Ve skutečnosti se podobný problém již v průmyslu řešil (haleluja!). Jen v jiné oblasti: nasazení aplikací. Ano, mluvím o přístupu DevOps, kde tým určuje, jak by měl nasadit produkt, který vytvářejí.
Podobný přístup k řešení problémů Data Lake navrhla Zhamak Dehghani, konzultantka v ThoughtWorks. Sledujíc, jak podobné úkoly řeší Netflix a Spotify, napsala úžasný článek (odkaz na něj byl na začátku článku). Hlavní myšlenky, které jsme si z něj odnesli:
- Rozdělit velký Data Lake na domény dat, které jsou velmi podobné doménám orientovaným na doménu design. Každá doména je malý bounded context.
- Feature Týmy, které jsou odpovědné za DDD domény, jsou odpovědné také za odpovídající domény dat. Ukládají schéma, provádějí v něm změny, načítají data. Přitom všechno vědí: jak změnit načítání dat a nic neporušit, když se aplikace změní. Znalosti nikam nezmizí. Aby otevřeli data, nemusí chodit nikam. Samotný tým provádí celý cyklus vývoje od změny provozních dat po poskytování analytických dat třetím stranám. Jeden tým vlastní vše, co se týká domény (jak byznysové domény, tak domény dat).
- Data Engineer – role uvnitř Feature Týmu. Není nutně nutné, aby to byla samostatná osoba, ale tým musí mít tuto kompetenci.
A zatímco tým Data Engineering…
Pokud bychom si představili, že se to vše uskuteční mávnutím ruky, zbývá odpovědět na dvě otázky:
Čemu se nyní bude věnovat tým Data Engineering? V Dodo Pizza Engineering již existuje tým platformy/SRE. Jeho úkolem je poskytnout vývojářům nástroje pro snadné nasazení služeb. Tým Data Engineering bude vykonávat stejnou roli, pouze pro data.
Transformace operačních dat na analytická je složitý proces. Udělat analytická data dostupná pro celou společnost je ještě složitější. Právě řešením těchto problémů se bude tým Data Engineering zabývat.
Chceme poskytnout Feature Team pohodlnou sadu nástrojů a praktik, pomocí kterých budou moci publikovat data ze svých služeb pro zbytek společnosti. Také budeme odpovědní za společné infrastrukturní části data pipeline (fronty, spolehlivé úložiště, clustery pro provádění transformací nad daty).
Jak se dovednosti Data Engineer objeví uvnitř Feature Team? S Feature Team je to složitější. Samozřejmě, mohli bychom se pokusit najmout po jednom Data Engineerovi do každého našeho týmu. Ale to je velmi obtížné. Najít osobu s dobrým zázemím v zpracování dat a přesvědčit ji, aby pracovala uvnitř produktového týmu, je těžké.
Velkým plusem Doda je, že máme rádi interní školení. Takže teď máme takový plán: tým Data Engineering začíná publikovat data některých služeb, pláče, bodá se, ale stále jí kaktus. Jakmile pochopíme, že máme hotový proces pro publikaci, začneme o něm informovat Feature Team.
Máme několik způsobů, jak to udělat:
- , kde vysvětlíme, jak vypadá proces, který jsme vytvořili, jaké jsou dostupné nástroje a jak je nejefektivněji používat.
- Prezentace na DevForum nám pomůže získat zpětnou vazbu od produktových vývojářů. Poté se budeme moci připojit k produktovým týmům a pomáhat jim řešit úkoly spojené s publikováním dat, organizovat školení pro týmy.
Spotřeba dat
Nyní jsem hodně mluvil o publikaci dat. Ale je tu ještě spotřeba. Co k tomu říkáte?
Máme skvělý tým BI, který vytváří velmi složité zprávy pro naši řídící společnost. Uvnitř Dodo IS je mnoho zpráv pro naše partnery, které jim pomáhají spravovat pizzerie. V naší nové modelu z nich uvažujeme jako o spotřebitelích dat, kteří mají své vlastní domény dat. A právě spotřebitelé budou mít na starosti své vlastní domény. Někdy může být doména spotřebitele popsána jediným dotazem v analytickém úložišti – a to je v pořádku. Ale uvědomujeme si, že to nebude vždy fungovat. Proto chceme, aby platforma, kterou vytvoříme pro produktové týmy, mohla být také používána spotřebiteli dat (protože v případě zpráv uvnitř Dodo IS to budou stejné týmy).
Takhle vidíme práci s daty v Dodo Pizza Engineering. Rádi si přečteme vaše názory na toto téma v komentářích.
Zdroj: habr.com
