

S databází Apache Cassandra a potřebou jejího provozování v rámci infrastruktury založené na Kubernetes se setkáváme pravidelně. V tomto materiálu se podělíme o své vize potřebných kroků, kritérií a existujících řešení (včetně přehledu operátorů) pro migraci Cassandry do K8s.
„Kdo může řídit ženu, poradí si i s državou“
Kdo je vlastně Cassandra? Je to distribuovaný systém ukládání, určený pro správu velkých objemů dat, přičemž zajišťuje vysokou dostupnost bez jednoho bodu selhání. Projekt pravděpodobně nevyžaduje dlouhé představení, proto uvedu jen hlavní rysy Cassandry, které budou relevantní v kontextu konkrétního článku:
- Cassandra je napsána v Javě.
- Topologie Cassandry zahrnuje několik úrovní:
- Node — jeden nasazený exemplář Cassandry;
- Rack — skupina exemplářů Cassandry, které jsou spojeny podle nějakého kritéria a nacházejí se v jednom datacentru;
- Datacenter — soubor všech skupin exemplářů Cassandry, které se nacházejí v jednom datacentru;
- Cluster — soubor všech datacenter.
- Pro identifikaci uzlu Cassandra používá IP adresu.
- Pro urychlení operací zápisu a čtení část dat Cassandra uchovává v paměti.
Nyní k samotnému potenciálnímu přesunu do Kubernetes.
Check-list pro přesun
Pokud mluvíme o migraci Cassandry do Kubernetes, doufáme, že s přestěhováním bude její správa pohodlnější. Co k tomu bude potřeba, co v tom pomůže?
1. Úložiště pro data
Jak už bylo uvedeno, část dat Cassanda uchovává v paměti — v Memtable. Ale existuje i jiná část dat, která se ukládá na disk, — ve formě SSTable. K těmto datům se přidává entita Commit Log — záznamy o všech transakcích, které jsou také uchovávány na disku.
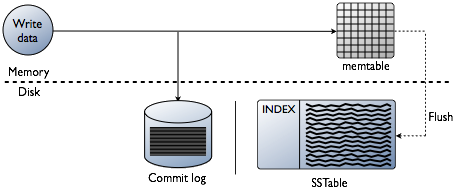
Schéma transakcí zápisu v Cassandře
V Kubernetes můžeme použít pro ukládání dat PersistentVolume. Díky osvědčeným mechanizmům je práce s daty v Kubernetes rok od roku stále jednodušší.
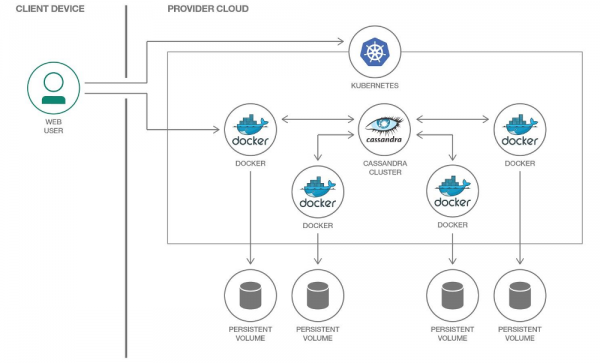
Každému podu s Cassandrou přidělíme svůj PersistentVolume.
Je důležité poznamenat, že Cassandra sama o sobě zahrnuje replikaci dat a nabízí pro to vestavěné mechanismy. Proto, pokud vytváříte cluster Cassandra z velkého počtu uzlů, není nutné používat pro ukládání dat distribuované systémy jako Ceph nebo GlusterFS. V tomto případě by bylo logické ukládat data na disku uzlu pomocí nebo montáží hostPath.
Druhý případ nastává, pokud chcete vytvořit zvláštní prostředí pro každou feature-větvičku pro vývojáře. V tomto případě bude správným přístupem spustit jeden uzel Cassandra a uchovávat data v distribuovaném úložišti, tj. zmíněné Ceph a GlusterFS se stanou vaší možností. Tak bude vývojář mít jistotu, že neztratí testovací data ani při ztrátě jednoho z uzlů Kubernetes-clusteru.
2. Monitoring
Praxe bezalternativního výběru pro implementaci monitorování v Kubernetes je Prometheus (podrobně jsme o tom hovořili v ). Jak je na tom Cassandra s exportéry metrik pro Prometheus? A co je ještě důležitější, s vhodnými dashboardy pro Grafana?
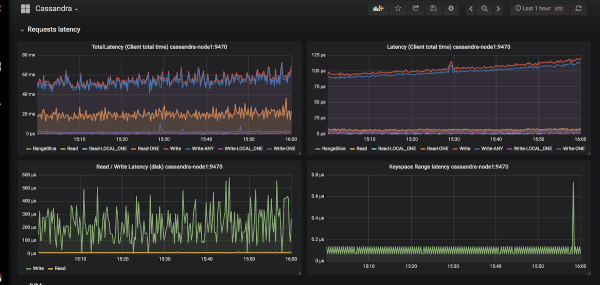
Příklad vzhledu grafů v Grafana pro Cassandru
Existují pouze dva exportéři: a .
Vybrali jsme si první, protože:
- JMX Exporter roste a vyvíjí se, zatímco Cassandra Exporter nedostal potřebnou podporu komunity. Cassandra Exporter dosud nepodporuje většinu verzí Cassandry.
- Lze jej spustit jako javaagent přidáním příznaku
-javaagent:<plugin-dir-name>/cassandra-exporter.jar=--listen=:9180. - Pro něj existuje , který není kompatibilní s Cassandra Exporter.
3. Výběr primitivů Kubernetes
Na základě výše uvedené struktury clusteru Cassandra se pokusíme převést všechno, co je tam popsáno, do terminologie Kubernetes:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → pool pod StatefulSets
- Cassandra Cluster → ???
Získáváme, že nám chybí nějaká další entita, aby bylo možné spravovat celý cluster Cassandra najednou. Ale pokud něco chybí, můžeme to vytvořit! V Kubernetes k tomu slouží mechanismus definování vlastních zdrojů — .
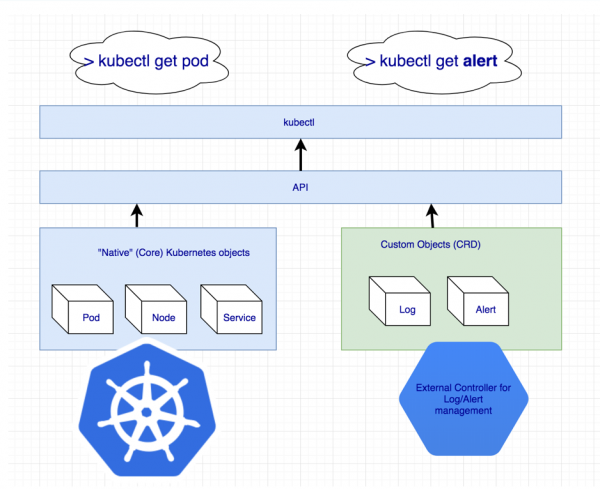
Vyhlášení dodatečných zdrojů pro logy a upozornění
Ale samotná Custom Resource nic neznamená: pro ni je potřeba ovladač. Možná bude potřeba obrátit se na …
4. Identifikace podů
V předchozím bodě jsme se dohodli, že jeden uzel Cassandra se rovná jednomu podu v Kubernetes. Ale IP adresy podů budou pokaždé různé. A identifikace uzlu v Cassandře probíhá právě na základě IP adresy… Výsledkem je, že po každém odstranění podu klastr Cassandra přidá nový uzel.
Existuje řešení, a dokonce ne jedno:
- Můžeme sledovat identifikátory hostitelů (UUID, které jednoznačně identifikují instance Cassandry) nebo IP adresy a uchovávat to vše v nějakých strukturách/tabulkách. Tato metoda má dvě hlavní nevýhody:
- Riziko vzniku závodní podmínky, pokud selžou dva uzly současně. Po restartu se uzly Cassandry snaží současně získat IP adresu z tabulky a soutěží o stejný zdroj.
- Pokud uzel Cassandra ztratí svá data, již ho nebudeme schopni identifikovat.
- Druhé řešení se zdá být malým hackem, ale přesto: můžeme vytvořit Service s ClusterIP pro každý uzel Cassandry. Problémy této implementace:
- Pokud je v klastru Cassandra velmi mnoho uzlů, budeme muset vytvořit velmi mnoho Service.
- Možnost ClusterIP je realizována prostřednictvím iptables. To může být problém, pokud je v klastru Cassandra mnoho (1000… nebo dokonce 100?) uzlů. Ačkoli dokáže tento problém vyřešit.
- Třetí řešení — použít pro uzly Cassandry síť uzlů místo vyhrazené sítě podů tím, že aktivujeme nastavení
hostNetwork: true. Tato metoda klade určitá omezení:- Na výměnu uzlů. Nový uzel musí mít stejnou IP adresu jako předchozí (v cloudových službách jako AWS, GCP je to téměř nemožné);
- Použitím sítě uzlů klastru začínáme soutěžit o síťové zdroje. To znamená, že je problematické mít více než jeden pod Cassandry na jeden uzel klastru.
5. Zálohy
Chceme pravidelně zálohovat úplnou verzi dat jednoho uzlu Cassandry. Kubernetes poskytuje pohodlnou možnost pomocí , ale zde nám Cassandra plete plány.
Připomínám, že část dat Cassandra ukládá do paměti. Abychom provedli kompletní zálohu, musíme přesunout data z paměti (Memtables) na disk (SSTables). V tomto okamžiku uzel Cassandra přestává přijímat spojení, úplně se odpojuje od práce klastru.
Poté se provede záloha (snapshot) a schéma se uloží (keyspace). A tady se ukazuje, že prostá záloha nám nic nedává: je nutné uchovat identifikátory dat, za která odpovídal uzel Cassandra — to jsou speciální tokeny.
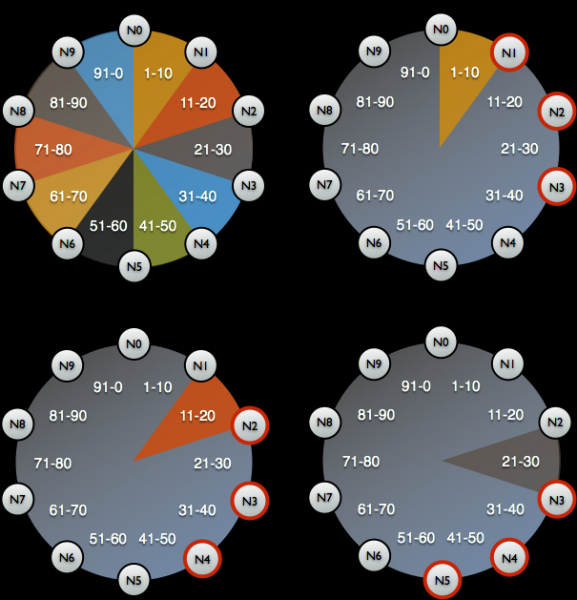
Rozdělení tokenů pro identifikaci, za které údaje odpovídají uzly Cassandra
Příklad skriptu pro zálohování Cassandry od Google v Kubernetes lze najít na . Jediný moment, který skript nezohledňuje, je resetování dat na uzlu před pořízením snapshotu. To znamená, že záloha se provádí ne pro aktuální stav, ale pro stav o něco dříve. To však pomáhá nevyřazovat uzel z provozu, což se jeví jako velmi logické.
set -eu

if [[ -z "$1" ]]; then
  info "Prosím, zadejte keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Chyba při vytváření snapshotu"
  exit 1
fi

timestamp=$(echo "$result" | awk '/Snapshot directory: / { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Příklad bash-skriptu pro zálohování z jednoho uzlu Cassandra
Hotová řešení pro Cassandu v Kubernetes
Co se v současnosti používá pro nasazení Cassandry v Kubernetes a co z toho nejlépe vyhovuje zadaným požadavkům?
1. Řešení založená na StatefulSet nebo Helm chartech
Použít základní funkce StatefulSets pro spuštění klastru Cassandra je dobrá varianta. Pomocí Helm chartu a šablon Go můžeme poskytnout uživateli flexibilní rozhraní pro nasazení Cassandry.
Obvykle to funguje dobře… dokud se nestane něco nepředvídaného — například selhání uzlu. Standardní nástroje Kubernetes prostě nemohou zohlednit všechny výše popsané zvláštnosti. Dále tento přístup je velmi omezený v tom, jak může být rozšířen pro složitější použití: výměny uzlů, zálohování, obnovování, monitorování atd.
Zástupci:
- ;
- .
Oba cloudy jsou stejně dobré, ale přesto náchylné k výše popsaným problémům.
2. Řešení založená na Kubernetes Operator
Tyto možnosti jsou zajímavější, protože poskytují široké možnosti správy klastru. Pro návrh operátora Cassandry, jako u každé jiné databáze, vypadá dobrý vzor jako Sidecar Controller CRD:
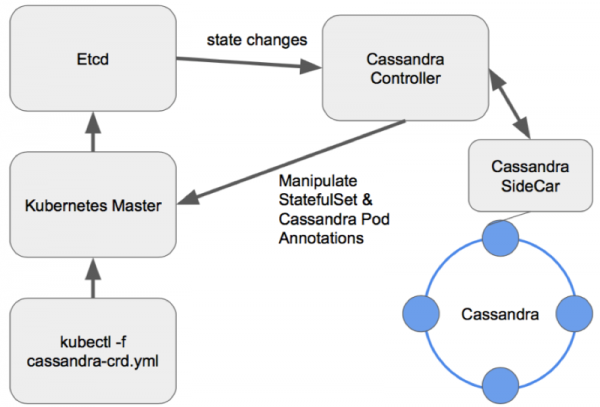
Schéma správy uzlů správně navrženého operátora Cassandry
Zvažme existující operátory.
1. Cassandra-operator od Instaclustr
- Stav: Alpha
- Licence: Apache 2.0
- Realizováno na: Java
Toto je skutečně velmi slibný a aktivně se rozvíjející projekt od společnosti, která nabízí spravované nasazení Cassandra. Používá, jak bylo uvedeno výše, konteiner sidecar, který přijímá příkazy přes HTTP. Je napsán v Javě, a proto mu někdy chybí pokročilejší funkce knihovny client-go. Také operátor nepodporuje různé Racks pro jedno Datacenter.
Na druhou stranu má operátor výhody, jako je podpora monitorování, vysokou úroveň správy clustera pomocí CRD a dokonce i dokumentaci pro vytváření záloh.
2. Navigator od Jetstack
- Stav: Alpha
- Licence: Apache 2.0
- Realizováno na: Golang
Operátor určený pro nasazení DB-as-a-Service. V současné době podporuje dvě databáze: Elasticsearch a Cassandra. Obsahuje zajímavá řešení, jako je kontrola přístupu k databázi prostřednictvím RBAC (pro tento účel se spouští jeho vlastní oddělený navigator-apiserver). Zajímavý projekt, na který by stálo za to se podívat, nicméně poslední commit byl proveden před více než rokem a půl, což výrazně snižuje jeho potenciál.
3. Cassandra-operator od vgkowski
- Stav: Alpha
- Licence: Apache 2.0
- Realizováno na: Golang
Nebylo by vhodné ho brát "vážně", protože poslední commit do repozitáře byl před více než rokem. Vývoj operátoru byl opuštěn: poslední verze Kubernetes, kterou prohlásili za podporovanou, je 1.9.
4. Cassandra-operator od Rook
- Stav: Alpha
- Licence: Apache 2.0
- Realizováno na: Golang
Operátor, jehož vývoj postupuje pomaleji, než bychom si přáli. Má promyšlenou strukturu CRD pro správu clustera, řeší problém s identifikací uzlů pomocí služby se ClusterIP (ten známý "hack")… ale to je zatím všechno. Momentálně není k dispozici monitorování a zálohování (mimochodem, o monitorování jsme ). Zajímavá poznámka, že pomocí tohoto operátoru lze také nasadit ScyllaDB.
NB: Tento operátor jsme s malými úpravami použili v jednom z našich projektů. Během celé doby používání (~4 měsíce provozu) nebyly žádné problémy s prací operátoru.
5. CassKop od Orange
- Stav: Alpha
- Licence: Apache 2.0
- Realizováno na: Golang
Nejmladší operátor na seznamu: první commit byl proveden 23. května 2019. Již nyní má ve svém arzenálu množství funkcí z našeho seznamu, s nimiž se můžete podrobně seznámit v repozitáři projektu. Operátor je postaven na populárním operator-sdk. Podporuje monitoring "out of the box". Hlavním rozdílem od ostatních operátorů je použití , realizovaného v Pythonu a používaného pro komunikaci mezi uzly Cassandra.
Závěry
Počet přístupů a možných variant migrace Cassandra do Kubernetes mluví sám za sebe: téma je poptávané.
V této fázi můžete vyzkoušet něco z výše uvedeného na vlastní nebezpečí: žádný z vývojářů nezaručuje 100% funkčnost svého řešení v produkčním prostředí. Ale už nyní mnoho produktů vypadá slibně, aby je bylo možné použít v prostředí pro vývoj.
Myslím, že v budoucnu se tato žena na lodi bude hodit!
P.S.
Přečtěte si také náš blog:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
